
باختصار
تُرجع OpenAI Decisions API وTypeSafe Jev قرارات محدودة مدعومة باحتمالات، لا نصًا مولدًا عاديًا. تستخدم OpenAI نموذج GPT-6 Luna عبر نقطة نهاية مخصصة؛ بينما Jev هو نموذج System One متخصص. Jev أرخص وفق أسعار رموز الإدخال المنشورة ($0.042 مقابل $0.10 لكل مليون)، في حين أن OpenAI تدعم الصور أصيلًا. الأرقام التي قدّمها المورّدان هنا لا تثبت فائزًا من حيث الدقة أو السرعة وجهاً لوجه.
أهم النقاط
- التسعير: Jev أرخص بنسبة 58% لكل رمز إدخال وفق الأسعار الأساسية المنشورة.
- المعمارية: OpenAI Decisions API تستخدم GPT-6 Luna؛ Jev مُصمم خصيصًا لمعالجة القرارات.
- الوسائط: OpenAI تدعم النصوص والصور؛ Jev يركّز على النصوص والمدخلات المهيكلة.
- المعايير: ادعاءات السرعة لدى المورّدين تعتمد خطوط أساس مختلفة؛ قارن على مجموعة بيانات معنونة واحدة.
- الاختيار: فضّل دعم تعدد الوسائط والتكامل مع OpenAI، أو معدل معالجة النصوص فقط والتكلفة، وفقًا لتطبيقك.
نظرة سريعة: OpenAI Decisions API مقابل Jev
يقارن العرض أدناه نقاط نهاية القرارات الموثّقة والأسعار الأساسية المنشورة، وتم التحقق منها في 12 أكتوبر 2026. يجب التحقق من الوصول إلى النماذج والحدود وشروط الخدمة لحساب النشر.
| الميزة | OpenAI Decisions API | TypeSafe Jev |
|---|---|---|
| المزوّد | OpenAI | TypeSafe AI |
| المحرّك | GPT-6 Luna | Jev System One |
| نقطة النهاية | POST /v1/decisions | POST /v1/systemone |
| معرّف النموذج | gpt-6-luna | jev-1.13.0 / jev-latest |
| المدخلات | نص + صور | نص / نص مُهيكل |
| أنواع الأسئلة | predicate (احتمالية الشرط)، choice (فئة)، score (محك) | Noul (احتمالية الشرط)، choice (فئة)، score (مستويات) |
| الأسئلة في الطلب | مصفوفة بأسماء | كائن بمفاتيح هي المعرّفات |
| حد السياق | غير مذكور في دليل Decisions المرتبط | 64K إجمالي؛ الحالة + أطول سؤال ≤ 32K |
| تكلفة الإدخال الأساسية / 1M | USD 0.10 | USD 0.042 |
| تكلفة رموز الإخراج | لا توجد رسوم | لا توجد رسوم |
| بيان السرعة من المورّد | أسرع بنحو 10× من Responses API | 70–500 مللي ثانية طرفًا لطرف |
| الإتاحة | تجريبي عام | وصول مبكر في إعلان الإطلاق؛ تحقق من وصول حسابك الحالي |
| ميزة فارقة | قرارات تعتمد على الصور | تكلفة إدخال منشورة أقل |
| الاستدلال التوليدي/الترميز | ليس جزءًا من عقد مخرجات نقطة النهاية هذه | ليس جزءًا من عقد مخرجات نقطة النهاية هذه |
تحتاج العديد من تدفقات عمل الذكاء الاصطناعي إلى فئة أو احتمال أو درجة — لا إلى فقرة. فبطاقة دعم تحتاج إلى توجيه، ووكيل يحتاج لاختيار إجراء معتمد، وطابور مراجعة يحتاج لتحديد المدخلات غير المؤكدة. كلا المنتجين يجعلان مثل هذه القرارات مخرجات API من الدرجة الأولى.
أصدرت OpenAI Decisions API تجريبيًا في 6 أكتوبر 2026. وتقبل نقطة GPT-6 Luna النصوص والصور. Jev هو نموذج System One المتخصص من TypeSafe AI للتقييم غير التوليدي، مع نهج تدريب موصوف باسم Reinforcement Learning for Calibrated Decisions (RLCD).
تغطي أنواع الأسئلة في الجدول ثلاث مهام مشتركة. تقدّر predicate لدى OpenAI وnoul لدى Jev ما إذا كان الشرط صحيحًا، مثل نية الاسترداد أو الأهلية. تقوم choice بالاختيار من فئات محددة مسبقًا، مثل Billing وTechnical وShipping، لأغراض التوجيه. تقوم score بتقييم الإدخال وفق محك أو مستويات، مثل الإلحاح أو الأولوية. هذه الأوصاف تلخّص نظرتي المنتجين؛ أما مخططات الطلب ودلالات الاحتمالات فما تزال تتطلب معالجة خاصة بكل مزوّد.
ما هي OpenAI Decisions API وJev؟
تعد كل من OpenAI Decisions API وTypeSafe Jev خدمات ذكاء اصطناعي مُركّزة على اتخاذ القرار، ومصممة لتحويل البيانات المدخلة إلى مخرجات منظمة ومحدودة بدلاً من نص مفتوح. وعلى خلاف النماذج اللغوية الكبيرة التقليدية التي تولد تفسيرات أو ردودًا محادثية، تقوم هذه الواجهات بتقييم أسئلة محددة مسبقًا وترجع قرارات أو احتمالات أو درجات. وهذا يجعلها مفيدة بشكل خاص لأتمتة تدفقات العمل مثل توجيه طلبات العملاء، وتصنيف المحتوى، وتقييم المخاطر، واختيار أدوات الوكلاء، حيث تكون المخرجات المتوقعة والمعالجة الفعّالة ضرورية.
OpenAI Decisions API تعمل بواسطة GPT-6 Luna وتعمل عبر نقطة النهاية /v1/decisions. تدعم النصوص والصور، مع ثلاثة أنواع قرارات: predicate وchoice وscore. وتتمثّل ميزتها الأساسية في دمج الفهم السياقي لنموذج عام الغرض مع واجهة قرار مخصصة، ما يجعلها مناسبة للتصنيف متعدد الوسائط وللتطبيقات المتكاملة أصلًا مع منظومة OpenAI.
أما TypeSafe Jev، فهو نموذج قرار متخصص يتم الوصول إليه عبر نقطة النهاية /v1/systemone. يركّز على التقييم القائم على النص باستخدام ثلاثة أنواع أسئلة: noul وchoice وscore. يؤكد Jev على استدلال فعّال، وتنبؤات منظمة، ومعايرة الاحتمالات، ما يجعله خيارًا جذابًا للتصنيف عالي الحجم وخطوط قرارات مؤتمتة. وعلى الرغم من أن الخدمتين تعالجان مشكلات متشابهة، فإن اختلافاتهما في المعمارية وقدرات الإدخال والتسعير وتصميم API قد تؤثر بشكل كبير على الملاءمة لتطبيق معين.
نهج النموذج، حدود الإدخال، والنطاق
تتعلق المقارنة بسلوك API الموثّق وتموضع المنتج. تكشف OpenAI عن GPT-6 Luna عبر نقطة قرار، بينما تضع TypeSafe Jev كنموذج System One متخصص. هذه الأوصاف وحدها لا تُثبت أفضلية في الدقة ولا تكشف جميع التفاصيل التنفيذية.
يسمح Jev بـ64K رمز عبر الطلب الكامل، مع حد منفصل 32K للحالة مضافًا إلى أطول سؤال. احسب تعليمات السؤال والمعايير إلى جانب الإدخال المشترك. لا يذكر دليل OpenAI Decisions المرتبط حدًا رقميًا منفصلًا للسياق لهذه النقطة؛ تحقّق من الحدود المعمول بها بدلًا من افتراض انطباق نافذة سياق نموذج عام كما هي.
اختبارات الاستدلال التوليدي والترميز خارج نطاق نقاط النهاية المحدودة هذه. من أجل توليد التفسيرات أو الشيفرة، قيّم نقطة توليد مناسبة على حدة. نتائج النموذج العام الغرض لا تثبت أداء نقطة Decisions.
الدقة والزمنية
لا تقدم المواد المقتبسة من المورّدين اختبارًا متطابقًا وجهاً لوجه يثبت فائزًا من حيث الدقة أو الزمنية. يُقارن تصريح السرعة بنحو 10× لدى OpenAI بين Decisions وResponses API الخاصة بها. وتذكر TypeSafe زمنية 70–500 مللي ثانية طرفًا لطرف وتقول إن تقييماتها المنشورة عمومًا أُجريت من حاسوب محمول في غرب الولايات المتحدة.
| المقياس | OpenAI Decisions API | Jev | التقييم |
|---|---|---|---|
| دقة وجهاً لوجه | لا اختبار متطابق في المصادر المذكورة | لا اختبار متطابق في المصادر المذكورة | لا فائز |
| السرعة | ادعاء نسبي من المورّد | نطاق مطلق من المورّد | غير قابل للمقارنة مباشرة |
| المعايرة | احتمالات؛ ثقة منفصلة لـ choice/score | احتمالات؛ ثقة مشتقة لـ choice/score | اختبر المعايرة فعليًا |
| تصنيف نصي | مدعوم | مدعوم | كلاهما صالح |
| تصنيف بصري | صور أصلية | لا صور أصلية | أفضلية OpenAI |
معايرة الاحتمالات وعتبات المراجعة
قد يكون النموذج دقيقًا لكنه ضعيف المعايرة. من بين التنبؤات المعطاة باحتمال 0.90 للفئة المختارة، ينبغي أن يكون نحو 90% صحيحًا إذا كان هذا الاحتمال مُعايرًا على توزيع التقييم. لا تستبدل حقلًا في API يسمى confidence بهذا الاحتمال من دون التحقق من تعريفه. يشتق Jev قيمة الثقة في choice من توزيع الاحتمالات: confidence = (p_max − 1/n) / (1 − 1/n)، حيث n هو عدد الاختيارات. نتيجة Noul لا تحوي حقل ثقة منفصل. قم بقياس ECE وBrier score من الاحتمالات المناسبة، جنبًا إلى جنب مع الدقة والاسترجاع وF1 الكلي؛ واختر عتبات المراجعة من أمثلة معنونة.
التسعير وتكلفة القرار المقبول
تُدرج OpenAI سعر $0.10 لكل مليون رمز إدخال لـ /v1/decisions؛ ويُدرج Jev سعر $0.042 لكل مليون رمز إدخال. ويُذكر لدى الخدمتين عدم وجود رسوم على رموز الإخراج لهذه الخدمات. وفق هذه الأسعار الأساسية، Jev أرخص بنسبة 58% لكل رمز إدخال. قد تنطبق زيادات إقليمية لدى OpenAI ومضاعِفات السياق الطويل؛ وقد تُضيف إعادة المحاولة والمعالجة المسبقة والمراجعة تكاليف للعملية.
افترض أن كل طلب يستخدم 500 رمز إدخال خاضع للفوترة على الخدمتين. هذه حسابات توضيحية وليست فواتير.
| القرارات الشهرية | رموز الإدخال | تكلفة OpenAI | تكلفة Jev | الفارق |
|---|---|---|---|---|
| 10,000 | 5M | $0.50 | $0.21 | $0.29 |
| 100,000 | 50M | $5.00 | $2.10 | $2.90 |
| 1,000,000 | 500M | $50 | $21 | $29 |
| 10,000,000 | 5B | $500 | $210 | $290 |
| 100,000,000 | 50B | $5,000 | $2,100 | $2,900 |
تكلفة كل قرار صحيح مقبول = (إنفاق API + إنفاق إعادة المحاولة + إنفاق المراجعة البشرية) / عدد القرارات الصحيحة المقبولة. قد تُعوّض نسبة رموز منخفضة التكلفة بمعدل أعلى من حالات التوجيه الخاطئ أو التصعيد.
بالنسبة لتدفق عمل GPT-6 Luna التقليدي، يسرد جدول تسعير نماذج CometAPI أسعار USD التالية لكل مليون رمز، تم التحقق في 12 أكتوبر 2026. هذه أسعار نقطة نهاية النموذج؛ تعرض الصفحة المرتبطة مثال Responses API ولا تُثبت دعم /v1/decisions الأصلي أو تسعيره.
| الشريحة المنشورة | الإدخال / 1M رموز | الإخراج / 1M رموز |
|---|---|---|
| سياق قصير (شرط الصفحة: ≤272,000 رمز) | $0.08 | $0.40 |
| سياق طويل (كما هو مذكور في الصفحة) | $0.16 | $0.60 |
تُحتسب رموز الإخراج لنموذج GPT-6 Luna العادي لدى CometAPI. أبقِ هذا التقدير منفصلًا عن خدمتي القرار أعلاه، اللتين لا تفرضان رسومًا على رموز الإخراج وفق المنشور. على سبيل المثال، 500 رمز إدخال زائد 20 رمز إخراج تكلّف $0.000048 لكل طلب سياق قصير، أو $48 لكل مليون طلب، قبل الرسوم الأخرى. أكّد الشريحة المعمول بها وسعر الحساب في كتالوج النماذج المباشر قبل وضع الميزانية.
تدفقات عمل الوكلاء ومفاضلات الوسائط
يمكن لكليهما توجيه استدعاء أداة، أو تقييم ما إذا كان شرط الحراسة مستوفيًا، أو تسجيل إجراء. لا يُغني أي منهما عن التفويض والتحقق من المدخلات أو أذونات الأدوات الصريحة. لأتمتة تعتمد على الرؤية، تُبسّط OpenAI المسار بفضل دعم الصور الأصيل؛ وللتوجيه النصي البحت، قد يكون انخفاض التكلفة الأساسية لدى Jev جذابًا.
تختلف معالجة المخرجات عند حدود الاستجابة. تعيد OpenAI مصفوفة answers، مع أسماء تحدد الأسئلة؛ بينما يعيد Jev كائن answers بمفاتيح هي معرّفات الأسئلة. طبّق تطبيعًا لهذه البنى قبل تطبيق قواعد الأعمال المشتركة. يشتق Jev حقل confidence من توزيع الاحتمالات؛ لا تفترض أن الحقول المتطابقة اسمًا لها معانٍ متكافئة عبر المورّدين. تحقّق من العلامات ومعاير عتبات المراجعة على بيانات التطبيق.
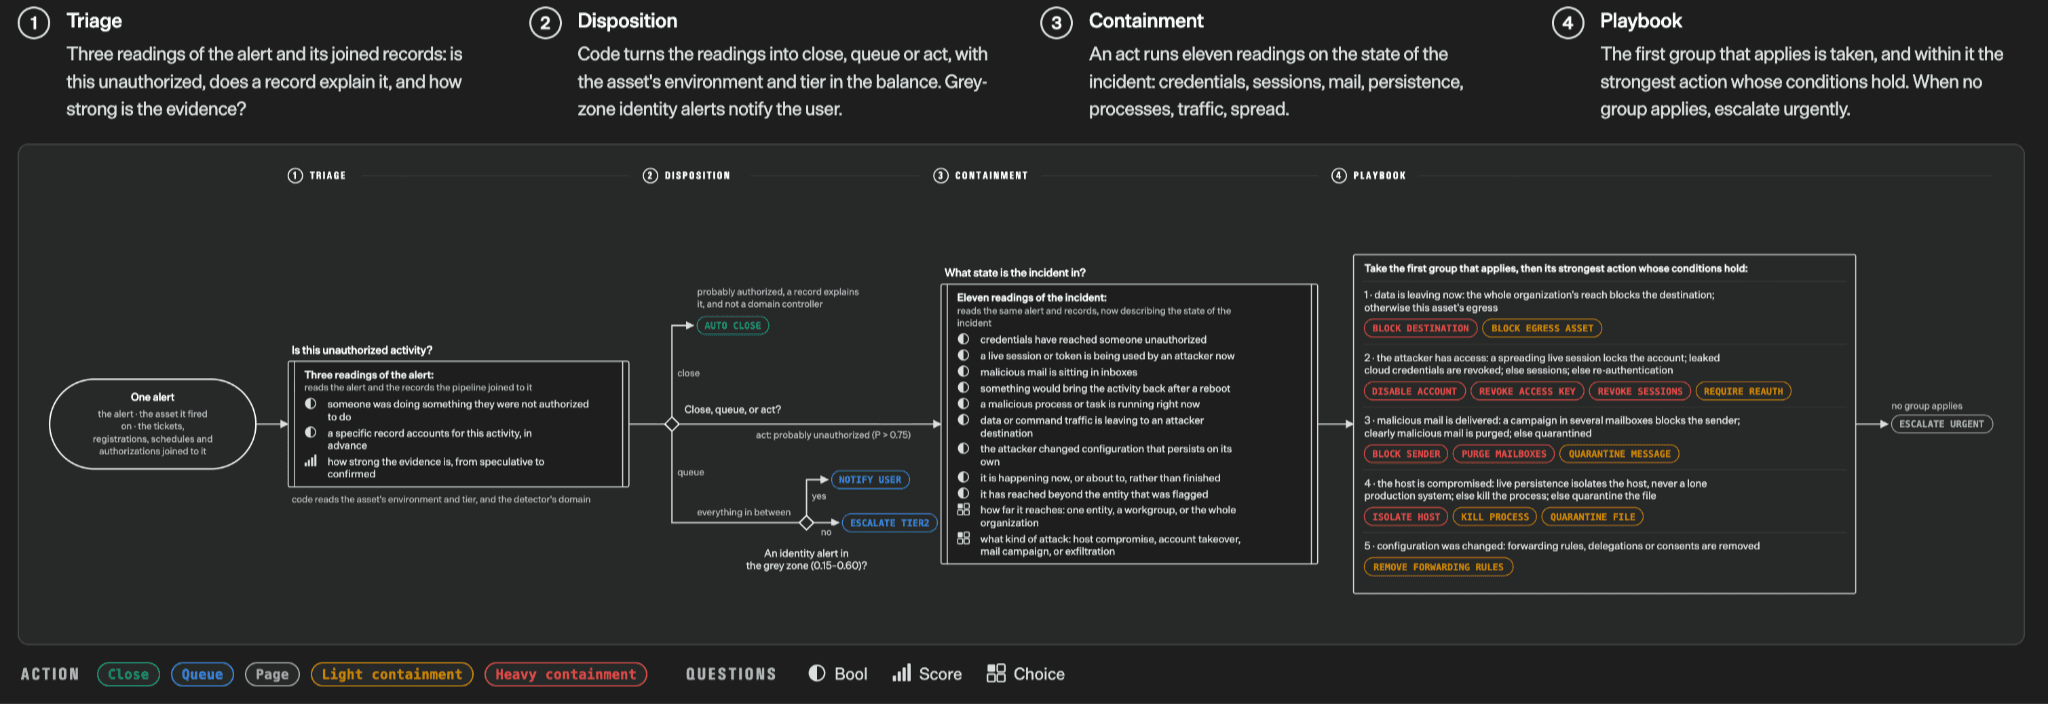
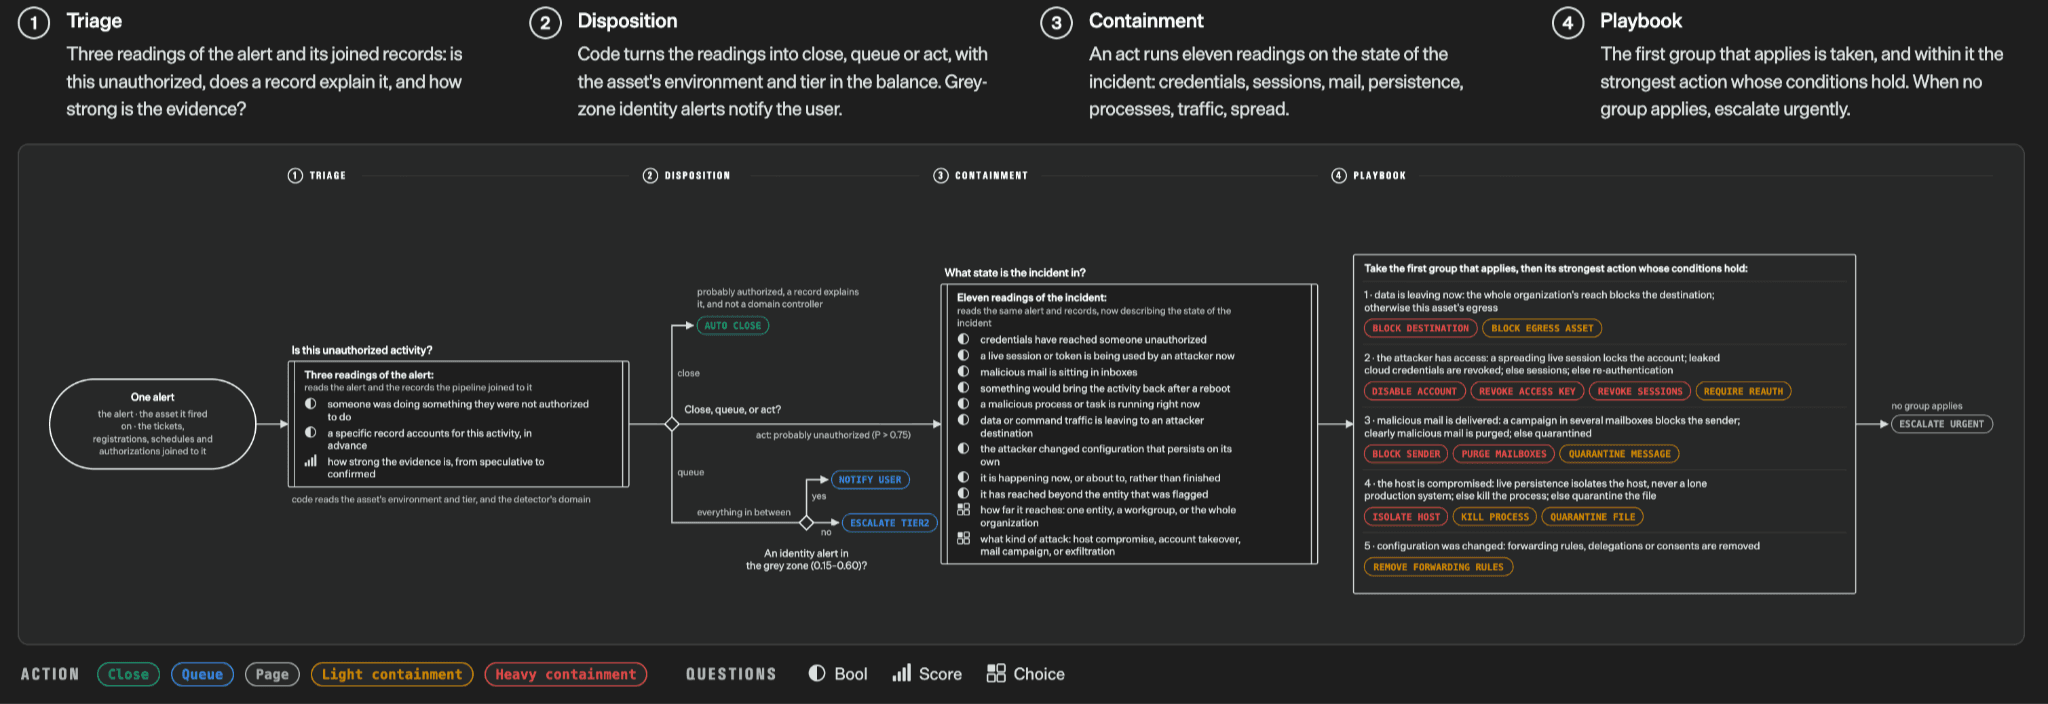
المصدر: تقديم System One Models وJev؛ الصورة الأصلية. يوضّح هذا تركيب سير العمل، وليس معيارًا متطابقًا مقابل OpenAI Decisions API.
كيف يختلف استخدام API: OpenAI Decisions API مقابل Jev
يجب إعداد الوصول لكل مزوّد على حدة: يستخدم كل مثال أدناه مضيفه ومفتاح API الخاص به. توثق OpenAI Decisions كنقطة واجهة تجريبية عامة. بالنسبة إلى Jev، أكّد الوصول والاعتمادات الحالية مع TypeSafe قبل النشر. ولأي خدمة، تحقّق من أذونات الحساب والتوافر الإقليمي والحصص وشروط الخدمة؛ المثال لا يضمن وصولًا إنتاجيًا. الوصول عبر طرف ثالث إلى نموذج توليدي لا يؤكّد بحد ذاته دعم نقطة القرار الأصلية.
كيفية استخدام OpenAI Decisions API
تتداخل المفاهيم، لكن مخططات الطلب تختلف. ترسل OpenAI input ومصفوفة من الأسئلة المسماة؛ بينما يستخدم Jev state وكائنًا للأسئلة بمفاتيح هي معرف السؤال. نفّذ محولًا خاصًا بالمورّد قبل تطبيق سياسة قرار مشتركة.
توجيه بطاقة دعم باستخدام OpenAI Decisions API.
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [{
      "type": "choice", "name": "department",
      "instructions": "Which team should handle this?",
      "choices": [
        {"value":"billing","description":"Charges and refunds"},
        {"value":"technical","description":"Product errors"},
        {"value":"other","description":"Other requests"}
      ]
    }]
  }'
كيفية استخدام Jev API
يستخدم طلب cURL التالي نقطة نظام System One لدى Jev لتصنيف بطاقة دعم. عيّن TYPESAFE_API_KEY في بيئتك، وضع البطاقة في state، وعرّف department داخل كائن questions. تسرد خريطة criteria تسميات التوجيه المسموح بها ووصفها. بعد نجاح الطلب، اقرأ الإدخال department في answers وحقّق من التسمية المختارة قبل توجيه البطاقة. أكّد أن معرّف النموذج متاح لحسابك.
توجيه بطاقة دعم باستخدام TypeSafe Jev.
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-1.13.0",
    "state": "I was charged twice for my order.",
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "billing":"Charges and refunds",
          "technical":"Product errors",
          "other":"Other requests"
        }
      }
    }
  }'
| عنصر التكامل | OpenAI | Jev |
|---|---|---|
| الإدخال | input | state |
| الأسئلة | Array | Keyed object |
| معرّف السؤال | name | Object key |
| سؤال ثنائي | predicate | noul |
| الخيارات | choices | criteria |
| شكل الإجابة | answers array | answers object |
سياسة مراجعة مشتركة لاحتمالات الفئة المختارة
طبّق عتبة مُعايَرة صراحة على احتمال الفئة المختارة.
from dataclasses import dataclass
from math import isfinite

@dataclass
class NormalizedDecision:
    label: str | None
    selected_probability: float | None
    provider: str
    needs_review: bool

def apply_review_policy(label, selected_probability, provider, threshold):
    if not isfinite(threshold) or not 0.0 <= threshold <= 1.0:
        raise ValueError("threshold must be between 0 and 1")
    valid_probability = (
        selected_probability is not None
        and isfinite(selected_probability)
        and 0.0 <= selected_probability <= 1.0
    )
    return NormalizedDecision(
        label=label,
        selected_probability=selected_probability,
        provider=provider,
        needs_review=(
            not label
            or not valid_probability
            or selected_probability < threshold
        ),
    )
يمثل مثال Python 3.10+ هذا طبقة سياسة تطبيق، وليس محلل استجابة API. يجب على كل محول خاص بالمورّد التحقق من الاستجابة واستخراج احتمال الفئة المختارة. لا تمُرِّر حقل confidence الخام لدى Jev على أنه selected_probability. زوّد عتبة مُعايَرة لذلك المزوّد والسؤال ومجموعة التقييم؛ وتعامل مع حالات الرفض وأخطاء النقل قبل استدعاء السياسة.
OpenAI Decisions API مقابل Jev: كيفية الاختيار
اختر على مرحلتين. أولًا، افحص متطلبات النشر: إدخال الصور، وصول الحساب، حدود الإدخال، وجهد التكامل. بعدها اختبر الخدمات المؤهلة على عبء عمل معنّون نفسه. للتوجيه النصي فقط، اختبر ما إذا كان السعر المنشور المنخفض في Jev يترجم إلى تكلفة أقل إجمالًا؛ وللقرارات المعتمدة على الصور، قيّم المسار الأصلي للصور لدى OpenAI. قارن أخطاء التوجيه والمعايرة وزمنية الذيل وإعادة المحاولات والمراجعة البشرية عند هدف جودة متّفق عليه. الجدول أدناه قائمة أولية، وليس دليلًا على فائز شامل في الأداء.
| حالة الاستخدام | OpenAI Decisions API | Jev | التوصية العملية |
|---|---|---|---|
| توجيه الدعم | مدعوم | مدعوم | اختبر Jev أولًا للتكلفة |
| تصنيف نصي | مدعوم | مدعوم | قارن المعايرة |
| فحص لقطات الشاشة | أصيل | يتطلب معالجة رؤية مسبقة | OpenAI |
| اختيار أدوات الوكيل | مدعوم | مدعوم | قِس النتائج طرفًا لطرف |
| ضبط متعدد الوسائط | نص وصور | نص فقط | OpenAI |
| بيئة OpenAI قائمة | أصيل | تكامل جديد | OpenAI |
بالنسبة لأتمتة الأعمال عالية الحجم، مثل توجيه الدعم والتصنيف النصي، يستحق Jev الأولوية حين تكون تكلفة الإدخال ومعدل المعالجة من الاهتمامات الأساسية. للتطبيقات متعددة الوسائط، بما يشمل فحص لقطات الشاشة والمراجعة البصرية والقرارات المعتمدة على الصور، يعد OpenAI Decisions API الخيار الأكثر عملية بسبب دعمه الأصيل للصور. بالنسبة لوكلاء الذكاء الاصطناعي وتدفقات عمل المؤسسات، يعتمد الاختيار على البنية الحالية وتعقيد التكامل وعواقب القرارات الخاطئة. قد تقدّم OpenAI مسار نشر أنعم للفرق التي تستخدم منظومتها أصلًا، بينما يستحق Jev النظر فيه للأعباء النصية واسعة النطاق. في جميع السيناريوهات، ينبغي أن يستند القرار النهائي إلى الدقة المقاسة، ومعايرة الاحتمالات، والزمنية، والتكلفة التشغيلية الكلية، لا على أسعار العناوين وحدها.
كيف ينبغي أن تختبر OpenAI Decisions API مقابل Jev؟
شغّل كلتا الخدمتين على المدخلات الواقعية المُعنونة نفسها، مع تعريفات أسئلة متطابقة ومناطق عميل متطابقة. تتبّع الدقة وF1 الكلي وECE وBrier score وزمنية p50/p95/p99 وحالات المهلة والرفض ومعدل المراجعة وتكلفة الدولار لكل قرار صحيح مقبول.
| البعد | المقاييس الموصى بها | لماذا يهم |
|---|---|---|
| التصنيف | الدقة، الدقة الإيجابية، الاسترجاع، F1 كلي | جودة العلامات |
| المعايرة | ECE، Brier score | موثوقية الاحتمالات |
| الزمنية | p50 / p95 / p99 | الاستجابة التشغيلية |
| الاعتمادية | معدل 429 / المهلات / الرفض | السلوك في الإنتاج |
| الاقتصاديات | تكلفة القرار الصحيح المقبول | المصروف التشغيلي الحقيقي |
الإجراء المقترح: ابنِ مجموعة بيانات مُعنونة ممثلة؛ ضمّن الحالات الملتبسة وخارج التوزيع؛ أرسل مهام متطابقة دلاليًا؛ كرر الطلبات بما يكفي لقياس التباين؛ عايِر عتبات كل نظام مستقلًا؛ وقارن التكلفة طرفًا لطرف بما يشمل التصعيد وإعادة المحاولات.
الخلاصة
اختر OpenAI Decisions API عندما يعتمد القرار على دليل صوري أو عندما يقلّل التكامل القائم مع OpenAI من جهد النشر. قيّم Jev لأعباء قرارات نصية فقط حيث قد يُخفض سعر رمز الإدخال المنشور تكاليف الاستدلال. قِس جودة العلامات ومعايرة الاحتمالات وزمنية الذيل وحجم المراجعة على بيانات التطبيق نفسها قبل الاختيار.
لدى Jev سعر أساس أقل لرموز الإدخال المنشورة؛ ولدى OpenAI Decisions API إدخال صور أصيل. الأرقام المقتبسة من المورّدين لا تثبت فائزًا شاملًا في الدقة أو السرعة. يعتمد الخيار الأفضل على تكلفة وجودة القرارات المقبولة ضمن سير العمل الكامل.
يمكن للمطورين استخدام GPT-6 Luna API في CometAPI لعمل نماذج أولية لتصنيف خفيف ضمن سير عمل متعدد النماذج أوسع. توفر صفحة النموذج المرتبطة مثال Responses API. لا يثبت الوصول إلى تلك النقطة التوليدية دعم نقطة /v1/decisions المخصصة بحد ذاتها. هذا نموذج أولي تقليدي لتوليد النص. لا يرجع مخطط إجابات Decisions الأصلي ولا توزيع احتمال مُعاير للفئة. تحقّق من التسمية المرجعة مقابل الفئات المسموح بها وتعامَل مع أخطاء API قبل ربطها بإجراءات لاحقة. أكّد دعم /v1/decisions الأصلي على حدة إذا كانت تلك النقطة مطلوبة.