
TL;DR
Muse Ember هو أصغر نموذج استدلال متعدد الوسائط لدى Meta، مبني لمهام الوكلاء عالية الحجم مثل التوجيه، الاستخلاص، استدعاء الأدوات، والبرمجة المركزة. قدمت Meta Muse Ember في 9 نوفمبر 2026.
تستوعب نافذة السياق ذات حجم 1,048,576 رمزًا مواد مصدرية ضخمة. توفر Meta الوصول عبر Model API وMuse Code؛ يسرد CometAPI النموذج باسم muse-ember، مع حالة التفعيل مغطاة أدناه. ابدأ بمهمة متكررة يمكن التحقق من مخرجاتها، ثم قارن التكلفة لكل نتيجة ناجحة، بما يشمل الاستدلال، الأدوات، والمحاولات المعاد تشغيلها.
أهم النقاط
- الدور: بُني Muse Ember لتنفيذ الوكلاء المتكرر، بما في ذلك التصنيف، والاستخلاص، واستدعاء الأدوات، ومهام البرمجة المحدودة.
- المدخلات والسعة: يقبل Muse Ember النصوص، والصور، والصوت، والفيديو، مع نافذة سياق 1M رمز وحتى 512K رمز خرج.
- الأداء: نتائج Meta ترجح Muse Ember على عدة مقاييس للوكلاء، بينما تُظهر اختبارات التحليلات المستقلة أن انخفاض أسعار الرموز لا ينتج دائمًا أقل تكلفة للمهمة.
- التسعير: الطلبات التي تتجاوز 200K من رموز الإدخال تنتقل إلى شريحة سعر أعلى؛ تعتمد التكلفة الإجمالية للمهمة أيضًا على الاستدلال واستخدام الأدوات.
- الوصول: يتوفر عبر Meta Model API وMuse Code؛ يسجّل CometAPI النموذج على أنه Coming soon حاليًا.
ما أفضل استخدامات Muse Ember؟
يتولى Muse Ember خطوات التنفيذ في سير عمل الوكيل بينما يدير نموذج أكبر التخطيط. يناسب المهام عالية الحجم ذات المدخلات الواضحة والنطاق المحدود ونتيجة يمكن لتطبيقك التحقق منها. مهامه الأساسية:
- التصنيف والتوجيه: وسم الطلبات وإرسالها إلى قائمة الانتظار أو الخدمة المناسبة.
- الاستخلاص: تحويل المستندات والوسائط إلى حقول مُهيكلة مع أدلة مصدرية.
- استدعاء الأدوات: اختيار دالة وتزويد الوسائط (arguments) التي ينفذها تطبيقك.
- المعالجة الدُفعية: تطبيق إجراء قابل لإعادة الاستخدام على ملفات أو سجلات.
توجيه تذاكر الدعم
يمكن لسير عمل دعم عملي أن يطلب من Ember استخراج مرجع الطلب، وتعيين فئة، ووضع علامة على المعلومات الناقصة. يمكن لتطبيقك التحقق من المرجع مقابل سجلاته قبل توجيه التذكرة. أبقِ عمليات الاسترداد وتغييرات الحساب وغيرها من الإجراءات ذات العواقب خلف ضوابط تفويض التطبيق نفسه.
استخلاص المستندات مع الأدلة
في معالجة الفواتير أو العقود، اطلب كلًا من القيمة المستخرجة والصفحة أو المقطع الذي يدعمها. اعتبر الحقول الغائبة وغير المقروءة نتائج صريحة بدلًا من دعوة النموذج للتخمين. هذا ينتج سجلات يمكن للمراجعين فحصها دون إعادة قراءة كل مستند.
عمل برمجي مركّز
امنح عامل الترميز حدود ملكية صغيرة: الملفات التي يجوز له تغييرها، السلوك الذي يجب الحفاظ عليه، والاختبارات التي تحدد الاكتمال. يوضح مثال الترحيل المتوازي للشيفرة لدى Meta هذا التقسيم للعمل. الوكيل المحيط يشغّل الأوامر ويتحقق من النتائج؛ استجابة النموذج وحدها ليست دليلًا على أن التغيير اجتاز اختباراته.
يرافق الصورة المرئية لإطلاق Muse Ember دليل Meta لدمج نموذج تنفيذ مع نموذج تخطيط أكبر.
تقول Meta إن Muse Ember هو أول نموذج تم تدريبه باستخدام Muse Wonder Full، مما يمدد استراتيجيتها في استخدام نماذج أكبر لتطوير نماذج متخصصة.
مواصفات Muse Ember
| المواصفة | Muse Ember |
|---|---|
| المطوّر | Meta Superintelligence Labs |
| تاريخ الإعلان | November 9, 2026 |
| فئة النموذج | Multimodal reasoning and agent execution |
| نافذة السياق | 1,048,576 tokens |
| الحد الأقصى للخرج | 524,288 tokens |
| وسائط الإدخال | Text, images, audio, video |
| إدخال الملفات | Supported through the Responses API |
| وسيط الخرج | Text |
| جهد الاستدلال | Minimal, Low, Medium, High, XHigh, Max |
| جهد الاستدلال الافتراضي | Max |
| استدعاء الأدوات | Supported |
| الخرج المهيكل | Supported |
| الإرساء على البحث | Supported through the Model API |
لم تُصدر Meta أوزان Muse Ember ولم تكشف عن عدد معاييره. قيود الطلب والرموز تنطبق لكل فريق، وتتشارك جميع مفاتيح API ضمن الفريق حصة النموذج.
السياق ومدخلات متعددة الوسائط
لأتمتة ملفات PDF، تستخرج Meta نصًا من أول 100 صفحة وصورًا من أول 50 صفحة، لذا قسّم الملفات الأطول قبل المعالجة. أرسل المواد اللازمة للمهمة؛ تتشارك رموز الاستدلال حد الخرج البالغ 524,288 رمزًا مع الإجابة النهائية.
استخدم لقطات الشاشة عندما تهم البنية، والمسح الضوئي لاستخلاص المستندات، والصوت لتحليل الاجتماعات، والفيديو للأحداث التي تتكشف مع الزمن. يكفي نص مفرغ لملخص نصي فقط. يتم دعم الملفات عبر Responses API، وتُعاد النتائج كنص.
جهد استدلال قابل للضبط
يوفر Muse Ember ستة مستويات للاستدلال: Minimal وLow وMedium وHigh وXHigh وMax. الإعداد الافتراضي لدى Meta هو Max؛ أي قيمة غير مدعومة تُرجع HTTP 400. ابدأ التوجيه والتصنيف الروتيني بمستوى أدنى، ثم ارفعه فقط عندما يبرر تحسن معدل الإجابات المقبولة الزيادة في زمن الاستجابة وتكلفة رموز الخرج.
استدعاء الأدوات والخرج المهيكل
يدعم Muse Ember استدعاء الأدوات والخرج المهيكل. تربط استدعاءات الأدوات قرارات النموذج بدوال التطبيق، بينما يجعل الخرج المهيكل الحقول المستخرجة أسهل للتحقق والتمرير إلى الخطوة التالية.
يعطي هذا الناتج التوضيحي لتذكرة دعم تطبيقَ التوجيه فئة وأولوية وعَلَم مراجعة:
{
  "category": "billing",
  "priority": "high",
  "requires_human_review": true
}
يدعم Meta Model API أيضًا الإرساء على البحث وسير عمل استخدام الحاسوب. التطبيق المتصل يوفر الأدوات، ينفذ الإجراءات، ويتحكم في الأذونات.
كيف يؤدي Muse Ember على المقاييس القياسية؟
تستخدم نتائج الإطلاق من Meta أقصى جهد استدلال. يغطي Agents’ Last Exam مجموعة Linux في تقييم Meta الداخلي، بينما يستخدم Terminal-Bench أفضل آلية تنفيذ منشورة لكل نموذج. تجمع هذه النتائج بين نتائج Artificial Analysis المنشورة خارجيًا وتقييمات Meta الداخلية؛ Personal Superintelligence Index هو مركب داخلي لدى Meta، وليس لوحة ترتيب مستقلة منفصلة.
نتائج مقاييس Muse Ember
| المقياس | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| AutomationBench-AA | 37.8 | 13.9 | 20.2 |
| Agents' Last Exam | 61.6 | 57.0 | 57.1 |
| Personal Superintelligence Index | 46.8 | 36.1 | 37.0 |
| Terminal-Bench 4.0 | 40.9 | 39.2 | 16.4 |
| Coding Agent Index-AA | 46 | 37 | 31 |
| FrontierCode 2.0-AA | 27.2 | 34.9 | 25.2 |
| GDP.pdf-AA | 22.8 | 20.8 | 22.8 |
| OSWorld 2.1 (partial score) | 69.5 | 68.9 | 50.5 |
| OSWorld 2.1 (binary score) | 33.8 | 27.8 | 17.0 |
| PerceptionBench (with tools) | 80.6 | 78.6 | 62.8 |
| Artificial Analysis Intelligence Index | 36 | 36 | 28 |
يستخدم Terminal-Bench 4.0 mini-swe-agent مع Muse Ember، وClaude Code مع Haiku 5.5، وCodex مع GPT-6 Luna. هذه ليست بيئات تنفيذ متماثلة. يقدّم OSWorld 2.1 درجات بنقاط جزئية وثنائية، بينما يتضمن PerceptionBench أدوات. نتائج Artificial Analysis Intelligence Index من الإصدار 5 كما نُشرت في 9 نوفمبر 2026.
تحليل مقاييس Muse Ember
قوة Muse Ember الأساسية هي تنفيذ الوكلاء.
على AutomationBench-AA، يسجل Muse Ember 37.8 مقارنة بـ 13.9 لـ Haiku 5.5 و20.2 لـ GPT-6 Luna. يدعم هذا تموضع Meta لـ Muse Ember كنموذج لسير عمل الأعمال من طرف إلى طرف وعمليات الوكلاء المتكررة.
أداء الترميز تنافسي، لكنه ليس متفوقًا عالميًا.
يسجل Muse Ember 40.9 على Terminal-Bench 4.0 و46 على Coding Agent Index-AA. لكنه يسجل 27.2 على FrontierCode 2.0-AA، دون مستوى 34.9 لدى Haiku 5.5. يشير هذا إلى أن Muse Ember مرشح مفيد للمهام الفرعية البرمجية المحدودة، بينما يجب اختبار العمل الهندسي الأصعب مقابل بدائل أقوى.
نتائج الوسائط المتعددة واستخدام الحاسوب واعدة.
يسجل Muse Ember 80.6 على PerceptionBench مع الأدوات و69.5 على OSWorld 2.1 بدرجات النقاط الجزئية. تدعم هذه النتائج تموضعه لسير عمل يتضمن الفهم البصري والتفاعل مع الحاسوب.
الذكاء العام قابل للمقارنة مع Haiku 5.5.
يسجل كل من Muse Ember وHaiku 5.5 قيمة 36 تقريبًا على Artificial Analysis Intelligence Index، متقدمين على GPT-6 Luna عند 28. لقرار الاختيار، قرّن تلك المقارنة العامة بالنتائج الخاصة بالمهمة أعلاه.
ذكاء Muse Ember مقابل التكلفة لكل مهمة
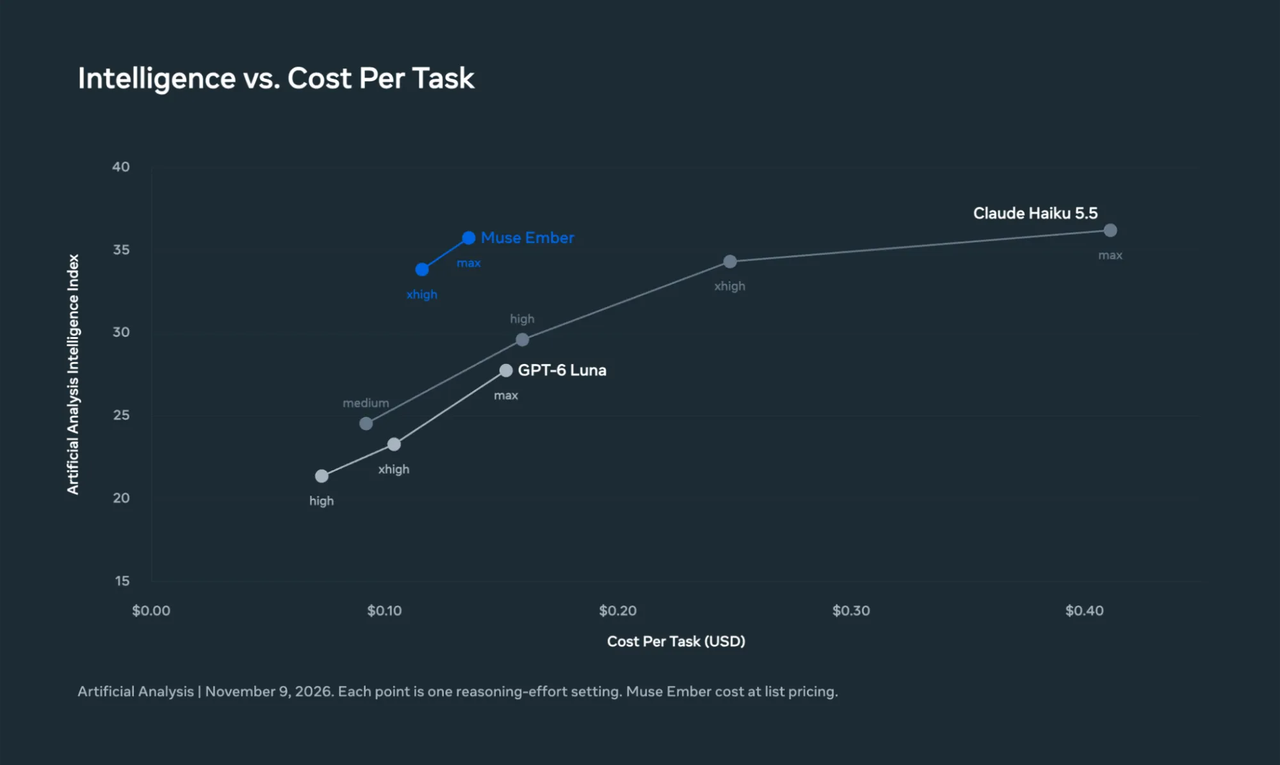
تقارن مخططات Meta درجات Artificial Analysis Intelligence Index مع التكلفة المقدّرة لكل مهمة عند مستويات جهد استدلال مختلفة.
عند أقصى جهد استدلال، يسجل Muse Ember 35.8 على Artificial Analysis Intelligence Index بتكلفة مقدّرة 0.136$ لكل مهمة. يسجل Haiku 5.5 قيمة 36.2 عند 0.411$، بينما يسجل GPT-6 Luna قيمة 27.8 عند 0.152$. على هذا المعيار، يقترب Ember من درجة Haiku مقابل نحو ثلث تكلفة المهمة ويتجاوز درجة Luna بتكلفة أقل قليلًا.
تستخدم هذه التقديرات استهلاك الرموز في المعيار وأسعار القائمة. يظهر التقييم التالي سبب أهمية نشاط الأدوات عند اختيار نموذج لسير عمل محدد.
نتائج مستقلة لتحليلات البيانات
اختبر تقييم تحليلات البيانات لشركة Plotly في 10 نوفمبر 2026 43 سؤالًا في Plotly Studio Embedded مقابل مجموعة بيانات صناعية لطاقة الرياح. استُخدم Muse Ember عبر OpenRouter؛ تستخدم التكاليف المبلغ عنها الأسعار المتاحة عند تشغيل كل نموذج. هذه نتائج خاصة بعبء عمل محدد، وليست اختبار فوترة عبر API الأصلي لـ Meta.
| مقياس التقييم | Muse Ember | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|
| الأسئلة المجتازة | 38/43 | 38/43 | 37/43 |
| تكلفة الاختبار الكاملة | $1.04 | $0.13 | $0.38 |
| الوسيط الزمني لكل سؤال | 28 seconds | 18 seconds | 14 seconds |
لهذا عبء عمل تحليلات البيانات، قدّم GPT-6 Luna نفس نتيجة 38/43 التي حققها Ember مقابل ثُمن التكلفة الإجمالية، وبزمن استجابة وسطي أقل. كان Haiku الأسرع عند 14 ثانية لكل سؤال، مع 37/43 إجابات صحيحة. يُعد Luna مرشح بداية أقوى لسير عمل تحليلات حساس للتكلفة مشابه؛ سعر الرموز المنخفض لدى Ember وحده لا يجعله الخيار الأرخص.
وجدت Plotly أن Muse Ember أجرى متوسط 78 استعلامًا في الأسئلة التي تتضمن أنماطًا مخفية، مقارنة بوسيط 25 عبر النماذج المختبرة. زاد نشاط الأدوات الإضافي من استهلاك الرموز والتكلفة الإجمالية.
أظهر الاختبار أيضًا نقاط قوة: أجاب Muse Ember عن جميع الأسئلة العشرين المحددة بوضوح، وجميع الأسئلة الخمسة المبهمة، وجميع الطلبات الخمسة المستحيلة، وجميع فحوصات جودة البيانات الثلاثة بشكل صحيح. واجه صعوبة أكبر مع الأنماط المخفية في البيانات.
شغّلت Plotly كل نموذج مرة واحدة ولاحظت تباينًا يصل إلى ثلاثة أسئلة عند تكرار نماذج أخرى. اعتبر نتائج 38 مقابل 37 متقاربة؛ الفرق الأوضح هنا هو استخدام الأدوات والتكلفة الإجمالية.
Muse Ember مقابل Muse Wonder مقابل Muse Spark
اختر نموذج Muse بناءً على المسؤولية التي سيتحملها: التخطيط، الحلقة الرئيسية للوكيل، أم التنفيذ المتكرر.
| البُعد | Muse Wonder | Muse Spark 1.3 | Muse Ember |
|---|---|---|---|
| الدور الأساسي | Frontier reasoning and complex engineering | Main coding and agent model | High-volume execution |
| القوة الرئيسية | التخطيط، المهام الطويلة، البرمجة المعقدة | الترميز وسير عمل الوكلاء | المهام المتكررة واستدعاءات الأدوات |
| عبء العمل النموذجي | هندسة على مستوى المستودعات | تنفيذ الوكيل الرئيسي | التصنيف، التوجيه، الاستخلاص |
| معرّف نموذج API | muse-wonder-1.0 | muse-spark-1.3 | muse-ember-1.0 |
| نافذة السياق | 1M tokens | 1M tokens | 1M tokens |
| الاستدلال الافتراضي | Max | High | Max |
| سعر الإدخال القياسي/1M | $4.00 | $1.25 | $0.10 |
| سعر الخرج القياسي/1M | $20.00 | $4.25 | $0.50 |
تستخدم الجدول أسعار رموز وضع Standard لدى Meta. تنطبق أسعار Ember هنا على الطلبات حتى 200K من رموز الإدخال؛ لا يحمل Wonder وSpark علاوة السياق الطويل الخاصة بـ Ember.
اختيار نموذج Muse
اختر Wonder للتخطيط الصعب، والهندسة على مستوى المستودع، والتعافي عبر تسلسلات طويلة من الخطوات. اختر Spark لتشغيل الحلقة الرئيسية للترميز أو الوكيل. اختر Ember للمهام المتكررة ذات المخرجات القابلة للتحقق بشكل مستقل، مثل التوجيه، والاستخلاص، والتغييرات المستهدفة في الملفات.
على سبيل المثال، يمكن أن يُسند ترحيل مستودع تحليل الاعتمادات إلى نموذج أكبر وتغييرًا محدود النطاق في ملف إلى Ember. يجب أن تسمّي عملية التسليم الملفات والسلوك المتوقع وفحوصات القبول. يكون هذا التقسيم مفيدًا فقط عندما تكون كلفة تنسيق المهام الأصغر ومراجعتها أقل من إتمام العمل بأكمله مع النموذج الرئيسي.
للاختيار بينها، شغّل نفس المهام التمثيلية عبر مرشحيك مع نفس فحوصات القبول. ارفض أولًا التكوينات التي تفشل في بلوغ معدل النجاح المطلوب أو هدف الكمون. من بين من يجتاز ذلك، قارن الإنفاق الإجمالي مقسومًا على النتائج المقبولة، بما يشمل المحاولات وإجراءات الأدوات. أسند إلى Ember أنواع المهام التي تخفض تلك التكلفة، ووجّه الحالات غير المحسومة عائدًا إلى Spark أو Wonder.
كم يكلف Muse Ember؟
يقترن الجدول بـ أسعار Meta الرسمية مع تقدير خصم 20% عبر CometAPI، بالدولار لكل مليون رمز. يعرض كل حقل سعر Meta / التقدير المخفض. لا ينشر CometAPI بعدُ تعرفة حية؛ استخدم الأرقام المخفضة للتخطيط للميزانية.
| الاستخدام لكل 1M رموز (Meta / تقدير خصم 20%) | حتى 200K من رموز الإدخال | أكثر من 200K من رموز الإدخال |
|---|---|---|
| الإدخال | $0.10 / $0.08 | $0.30 / $0.24 |
| الإدخال المُخبّأ | $0.004 / $0.0032 | $0.012 / $0.0096 |
| الخرج | $0.50 / $0.40 | $1.50 / $1.20 |
تحدد رموز الإدخال الإجمالية للطلب، بما في ذلك الإدخال المُخبّأ، الشريحة. يستخدم الطلب الذي يتجاوز 200K من رموز الإدخال الأسعار الأعلى للطلب بأكمله، بما في ذلك الخرج. مع previous_response_id من Meta، تُحتسب محفوظات المحادثة المخزنة ضمن إجمالي الإدخال.
تكاليف طلبات Muse Ember النموذجية
مع إدخال غير مخبّأ و20K من رموز الخرج المفوترة، بما يشمل الاستدلال، فإن طلب إدخال 200K يكلف 0.0300$ وفق أسعار Meta، أو 0.0240$ في سيناريو خصم 20%. زيادة الإدخال إلى 220K تنقل الطلب بأكمله إلى الشريحة الأعلى: نفس 20K من الخرج يرفع الإجمالي إلى 0.0960$ بأسعار Meta، أو تقديريًا 0.0768$ مع الخصم. تستبعد هذه الأمثلة رسوم الأدوات المنفصلة. الحفاظ على السياق ذي الصلة ضمن الشريحة الأدنى قد يوفر أكثر من الخصم وحده.
| السيناريو | رموز الإدخال | رموز الخرج المفوترة | تكلفة Meta | تكلفة CometAPI |
|---|---|---|---|---|
| طلب قياسي | 200K | 20K | $0.0300 | $0.0240 |
| طلب سياق طويل | 220K | 20K | $0.0960 | $0.0768 |
تُحتسب رموز الاستدلال كخرج مفوتر. لواجهة Meta الأصلية، تكلف إرساء البحث على الويب مبلغ 2.50$ إضافي لكل 1,000 استعلام، ولا يملك Ember نسخة Contributor-mode. لا يطبق مقارنة أسعار الرموز أعلاه خصم 20% على رسوم الأدوات المنفصلة.
كيفية الوصول إلى Muse Ember
قائمة CometAPI: صفحة النموذج تحدد النموذج باسم muse-ember، لكن حالة الكتالوج هي Coming soon اعتبارًا من 16 نوفمبر 2026. تابع تلك الصفحة للتفعيل والتسعير؛ للوصول الآن، استخدم Meta Model API أو Muse Code.
عبر Meta Model API: استخدم muse-ember-1.0 مع https://api.meta.ai/v1. يدعم API الأصلي صيغ Responses وChat Completions وMessages. تستخدم الملفات صيغة Responses. حافظ على نقطة نهاية كل مزوّد ومعرّف النموذج معًا عند تهيئة عميلك.
حدود API الأصلية ومسارات وصول أخرى: تسرد Meta 3,000 طلب في الدقيقة و4,000,000 رمز في الدقيقة لكل فريق، يتشاركها مفاتيح API الخاصة بالفريق. يتوفر Muse Ember أيضًا في Muse Code. تحقّق من حدود المسار الذي تختاره عند تحجيم دفعة، واستخدم دليل تكامل Meta لإعداد API الأصلي.
ما هي قيود Muse Ember؟
ثلاثة عوامل تحدد ما إذا كان Ember مناسبًا لسير عملك التالي:
- تبقى الهندسة المعقدة معتمدة على عبء العمل. يتأخر Ember وراء Haiku 5.5 على FrontierCode 2.0-AA رغم نتيجته الأقوى في Terminal-Bench. فوز ضيق في الترميز لا يثبت الملاءمة لكل تغيير على مستوى المستودع.
- السياق الطويل والأسعار المنخفضة للرموز لا يضمنان تكلفة منخفضة للمهمة. تنقل الطلبات الكبيرة إلى شريحة سعر أعلى، ويمكن لاستخدام الأدوات المتكرر أن يستهلك من الرموز ما يكفي لتجاوز معدل السعر المنخفض لكل رمز.
- دعم الأدوات لا يزال يتطلب تطبيقًا. ينفذ النظام المحيط الاستدعاءات، ويسيطر على الأذونات، ويتحقق من النتائج. قدرة النموذج على طلب إجراء لا توفر بمفردها سير عمل موثوقًا.
الخلاصة
اعتمد Ember حيث تكون معايير القبول واضحة بما يكفي للقياس. نشر أول مفيد هو خطوة عالية الحجم ذات نتيجة معروفة مسبقًا، مثل توجيه التذاكر المعلّمة أو استخلاص الحقول من مستندات مُراجَعة. قارن تكلفة المهمة المقبولة، ومعدلات الأخطاء، والكمون مقابل نموذجك الحالي قبل توسيع دوره. ستخبرك تلك الأدلة ما إذا كان Ember يخفض تكلفة سير عملك مع الحفاظ على الجودة المطلوبة.
الأسئلة الشائعة
كيف ينبغي التحقق من نتائج الاستخلاص لدى Muse Ember؟
ابنِ مجموعة مرجعية من المستندات بإجابات مفحوصة بشريًا، بما في ذلك الحقول المفقودة، والمسوح غير المقروءة، والقيم المتضاربة. قِس الدقة على مستوى الحقل بدلًا من اعتبار كل استجابة JSON صالحة نجاحًا. تحقق مما إذا كانت كل قيمة مستخرجة مدعومة بالمقطع المصدر المذكور، وأرسل حالات عدم التطابق للمراجعة. هذا يفصل بين موثوقية التنسيق وموثوقية الحقائق.
متى يجب أن تعود مهمة فرعية لدى Muse Ember إلى الوكيل الرئيسي؟
حدد شروط التصعيد قبل التنفيذ: ملف مطلوب خارج النطاق المحدد، المصادر تتعارض، فشل فحص القبول بشكل متكرر، أو تتطلب المهمة قرارًا لم يُخوّل العامل لاتخاذه. أعِد الأدلة والخطوات المُحاوَلة والسؤال غير المحسوم إلى الوكيل الرئيسي. عملية تسليم واضحة أكثر فائدة من السماح للعامل بتوسيع تكليفه إلى ما لا نهاية.
ما الذي ينبغي تسجيله عند اختبار Muse Ember في بيئة الإنتاج؟
سجّل مزود الخدمة ومعرّف النموذج بالضبط، إعداد الاستدلال، رموز الإدخال ورموز الخرج المفوترة، الرموز المُخبّأة، عدد استدعاءات الأدوات، المحاولات، الكمون، ونتيجة القبول النهائية. احتفظ بنتيجة التحقق إلى جانب سجل الاستخدام كي تحسب التكلفة لكل مهمة مقبولة. قارن أنواع المهام المتشابهة بشكل منفصل؛ قد يخفي المتوسط عبر التوجيه والترميز والعمل على المستندات الطويلة المواضع التي يساعد فيها النموذج أو يضيف تكلفة.
كيف يمكنك منع الإجراءات المكررة في سير عمل Muse Ember؟
اجعل التطبيق مسؤولًا عن هوية الإجراء وحالة إكماله. لعملية مثل إنشاء تذكرة، خصص مفتاح عملية ثابتًا، وتحقق مما إذا كانت قد اكتملت بالفعل، واستخدم دعم المعرفية (idempotency) لدى واجهة برمجة التطبيقات الوجهة عندما يكون متاحًا. بعد انتهاء المهلة، افحص حالة الإجراء قبل إعادة المحاولة. هذا التصميم يتجنب التعامل مع استجابة غير مؤكدة كدليل على أن الإجراء الأصلي لم يحدث.