
Kurzfassung
Claude Fable 5.1 hat den stärkeren Benchmark-Nachweis für schwieriges autonomes Coding und langhorizontige Aufgaben. GPT-5.6 Sol bietet niedrigere gewöhnliche Token-Kosten, ein breites natives Tool-Portfolio und eine geringere Zeit bis zum ersten Token im unabhängigen Maximalaufwands-Vergleich. Die richtige Voreinstellung hängt von den Kosten eines fehlgeschlagenen Tasks ab, nicht nur vom höchsten Benchmark-Score.
Im Intelligence Index-Snapshot vom 8. September 2026 erzielt Fable 5.1 einen Wert von 53, gegenüber 47 für GPT-5.6 Sol. Der Ausgabedurchsatz ist mit 69.9 gegenüber 69.8 Tokens/s praktisch gleichauf. Diese Ergebnisse stützen eine Qualitäts-gegen-Kosten-Entscheidung; sie etablieren keinen universellen Sieger bei der Geschwindigkeit.
Zentrale Erkenntnisse
- Wählen Sie Fable 5.1 für die härtesten autonomen Aufgaben, wenn Ihre eigenen Evaluierungen den höheren Preis rechtfertigen.
- Beginnen Sie mit GPT-5.6 Sol für kostensensitive Frontier-Inferenz und Anwendungen, die von seinen integrierten Tools profitieren.
- Vergleichen Sie Startverzögerung separat von Ausgabegeschwindigkeit: GPT-5.6 Sol hat eine geringere gemessene Zeit bis zum ersten Token, während der Durchsatz nahezu gleich ist.
- Modellieren Sie Cache-Schreibvorgänge, -Lesevorgänge, -Retention und Long-Context-Raten separat. Headline-Input/Output-Preise beschreiben nicht jede Agent-Workload.
Daten geprüft am 8. September 2026. Unabhängige Ergebnisse nutzen GPT-5.6 Sol mit maximalem Aufwand und Fable 5.1 mit Adaptive Reasoning, Max Effort, Default Fallback. Anbieterbenchmarks und unabhängige Benchmarks verwenden unterschiedliche Evaluierungs-Setups. Preise sind USD pro Million Tokens (MTok), sofern nicht anders angegeben.
GPT-5.6 Sol vs Fable 5.1: Kurzfazit
| Dimension | GPT-5.6 Sol | Claude Fable 5.1 | Bessere Wahl |
|---|---|---|---|
| Independent Intelligence Index v4.3 (Sep 8) | 47 | 53 | Fable 5.1 |
| Independent Terminal-Bench 4.0 (Sep 7) | 39.9% | 52.0% | Fable 5.1 |
| Anthropic-run Terminal-Bench 4.0 | 37.3% | 55.8% | Fable 5.1 |
| Context window | 1.05M | 1M | Praktisch gleich |
| Maximum output | 128K | 128K | Gleichstand |
| Text/image input | Yes | Yes | Gleichstand |
| Official input price / MTok | $4 | $10 | Sol |
| Official output price / MTok | $20 | $50 | Sol |
| Official cache read / MTok | $0.40 | $0.25 | Fable 5.1 |
| Independent output speed (Sep 8) | 69.8 tok/s | 69.9 tok/s | Praktisch gleich |
| API tool breadth | Very broad | Strong | Sol |
| Long-running autonomous work | Excellent | Core strength | Fable 5.1 |
| Cost-sensitive production | Better default | Premium escalation | Sol |
Eine sinnvolle Start-Policy ist Sol für routinemäßige Frontier-Arbeit, mit Fable 5.1 als Eskalationsroute, wenn eine Aufgabe Ihre Qualitäts- oder Autonomieschwelle nicht erreicht. Validieren Sie diese Policy anhand der Kosten pro erfolgreichem Task.
GPT-5.6 Sol bietet sechs Reasoning-Aufwandsstufen, von none bis max, mit medium als Standard. Fable 5.1 verwendet always-on adaptive thinking; der Effort steuert die Reasoning-Tiefe, Standard ist high.
Die zusätzlichen 50.000 Tokens im Kontext von GPT-5.6 Sol dürften in den wenigsten Architekturen ausschlaggebend sein. Abrechnung und Cache-Wiederverwendung werden relevanter, je näher eine Anfrage an eine Million Tokens heranrückt; der Long-Context-Abschnitt unten zeigt warum.
Was ist GPT-5.6 Sol?
GPT-5.6 Sol ist eine leistungsstarke Stufe in OpenAI’s GPT-5.6-Familie für anspruchsvolles Coding, Recherche, Planung und Agent-Workflows. Sein Hauptreiz in diesem Vergleich ist die Kombination aus Reasoning-Kontrollen und dem umgebenden Ausführungsumfeld.
Über die Responses API unterstützt GPT-5.6 Sol ein breites natives Tool-Portfolio: web search, file search, code interpreter, hosted shell, apply patch, computer use, MCP, skills und tool search. Dies kann die Anzahl separater Laufzeitkomponenten reduzieren, die eine Anwendung integrieren muss.
OpenAI beschreibt außerdem programmatic tool calling und Multi-Agent-Ausführung für die Familie. Diese Plattformfunktionen sind wichtig, wenn ein Modell Arbeit über Tools hinweg koordinieren muss, statt nur eine einzelne Antwort zurückzugeben.
Was ist Claude Fable 5.1?
Claude Fable 5.1 zielt auf anspruchsvolles Coding, professionelle Wissensarbeit, Forschung und langlaufende Agenten. Seine direkten Benchmark-Ergebnisse machen es zu einem starken Kandidaten für Aufgaben, bei denen Wiederherstellung, Persistenz und erfolgreiches Abschließen wichtiger sind als eine kurze Antwort.
Anthropic betont sustained autonomous execution in Anwendungen, einschließlich Planung, Erholung von Fehlsteps und Fortschrittskommunikation. Behandeln Sie diese Positionierung als Grund, längere Aufgaben zu testen, nicht als Garantie, dass jeder Workflow korrekt endet.
Fable 5.1 unterscheidet sich auch im API-Verhalten von GPT-5.6 Sol: seine erzwungenen tool_choice-Beschränkungen sind relevant für Workflows, die erfordern, dass das Modell ein spezifisches Tool aufruft. Prüfen Sie die unterstützten tool_choice-Modi beim Migrieren einer deterministischen Agentenschleife.
Die Integrationsfrage ist daher praktisch: Kann Ihre Anwendung eine autonomere Reasoning-Schleife tolerieren, oder benötigt sie feinere Kontrolle über jeden Schritt? Testen Sie das genaue Tool-Verhalten, bevor Sie sich für einen Weg entscheiden.
Benchmark-Vergleich: Fable 5.1 hat die stärkeren direkten Belege
Benchmark-Vergleiche zwischen konkurrierenden Anbietern lassen sich leicht missbrauchen. OpenAI’s ursprüngliche GPT-5.6-Launch-Evaluierungen gehen Fable 5.1 zeitlich voraus, während Anthropic’s Fable 5.1-Release neuere direkte Vergleiche mit GPT-5.6 Sol enthält.
Die sauberste Lesart der Belege erfolgt daher in drei Schichten: Anthropic’s direkter Vergleich, aktuelle unabhängige Tests und OpenAI’s eigenes Capability-Profil von GPT-5.6 Sol.
Anthropic’s direkte Fable 5.1 vs GPT-5.6 Sol Ergebnisse
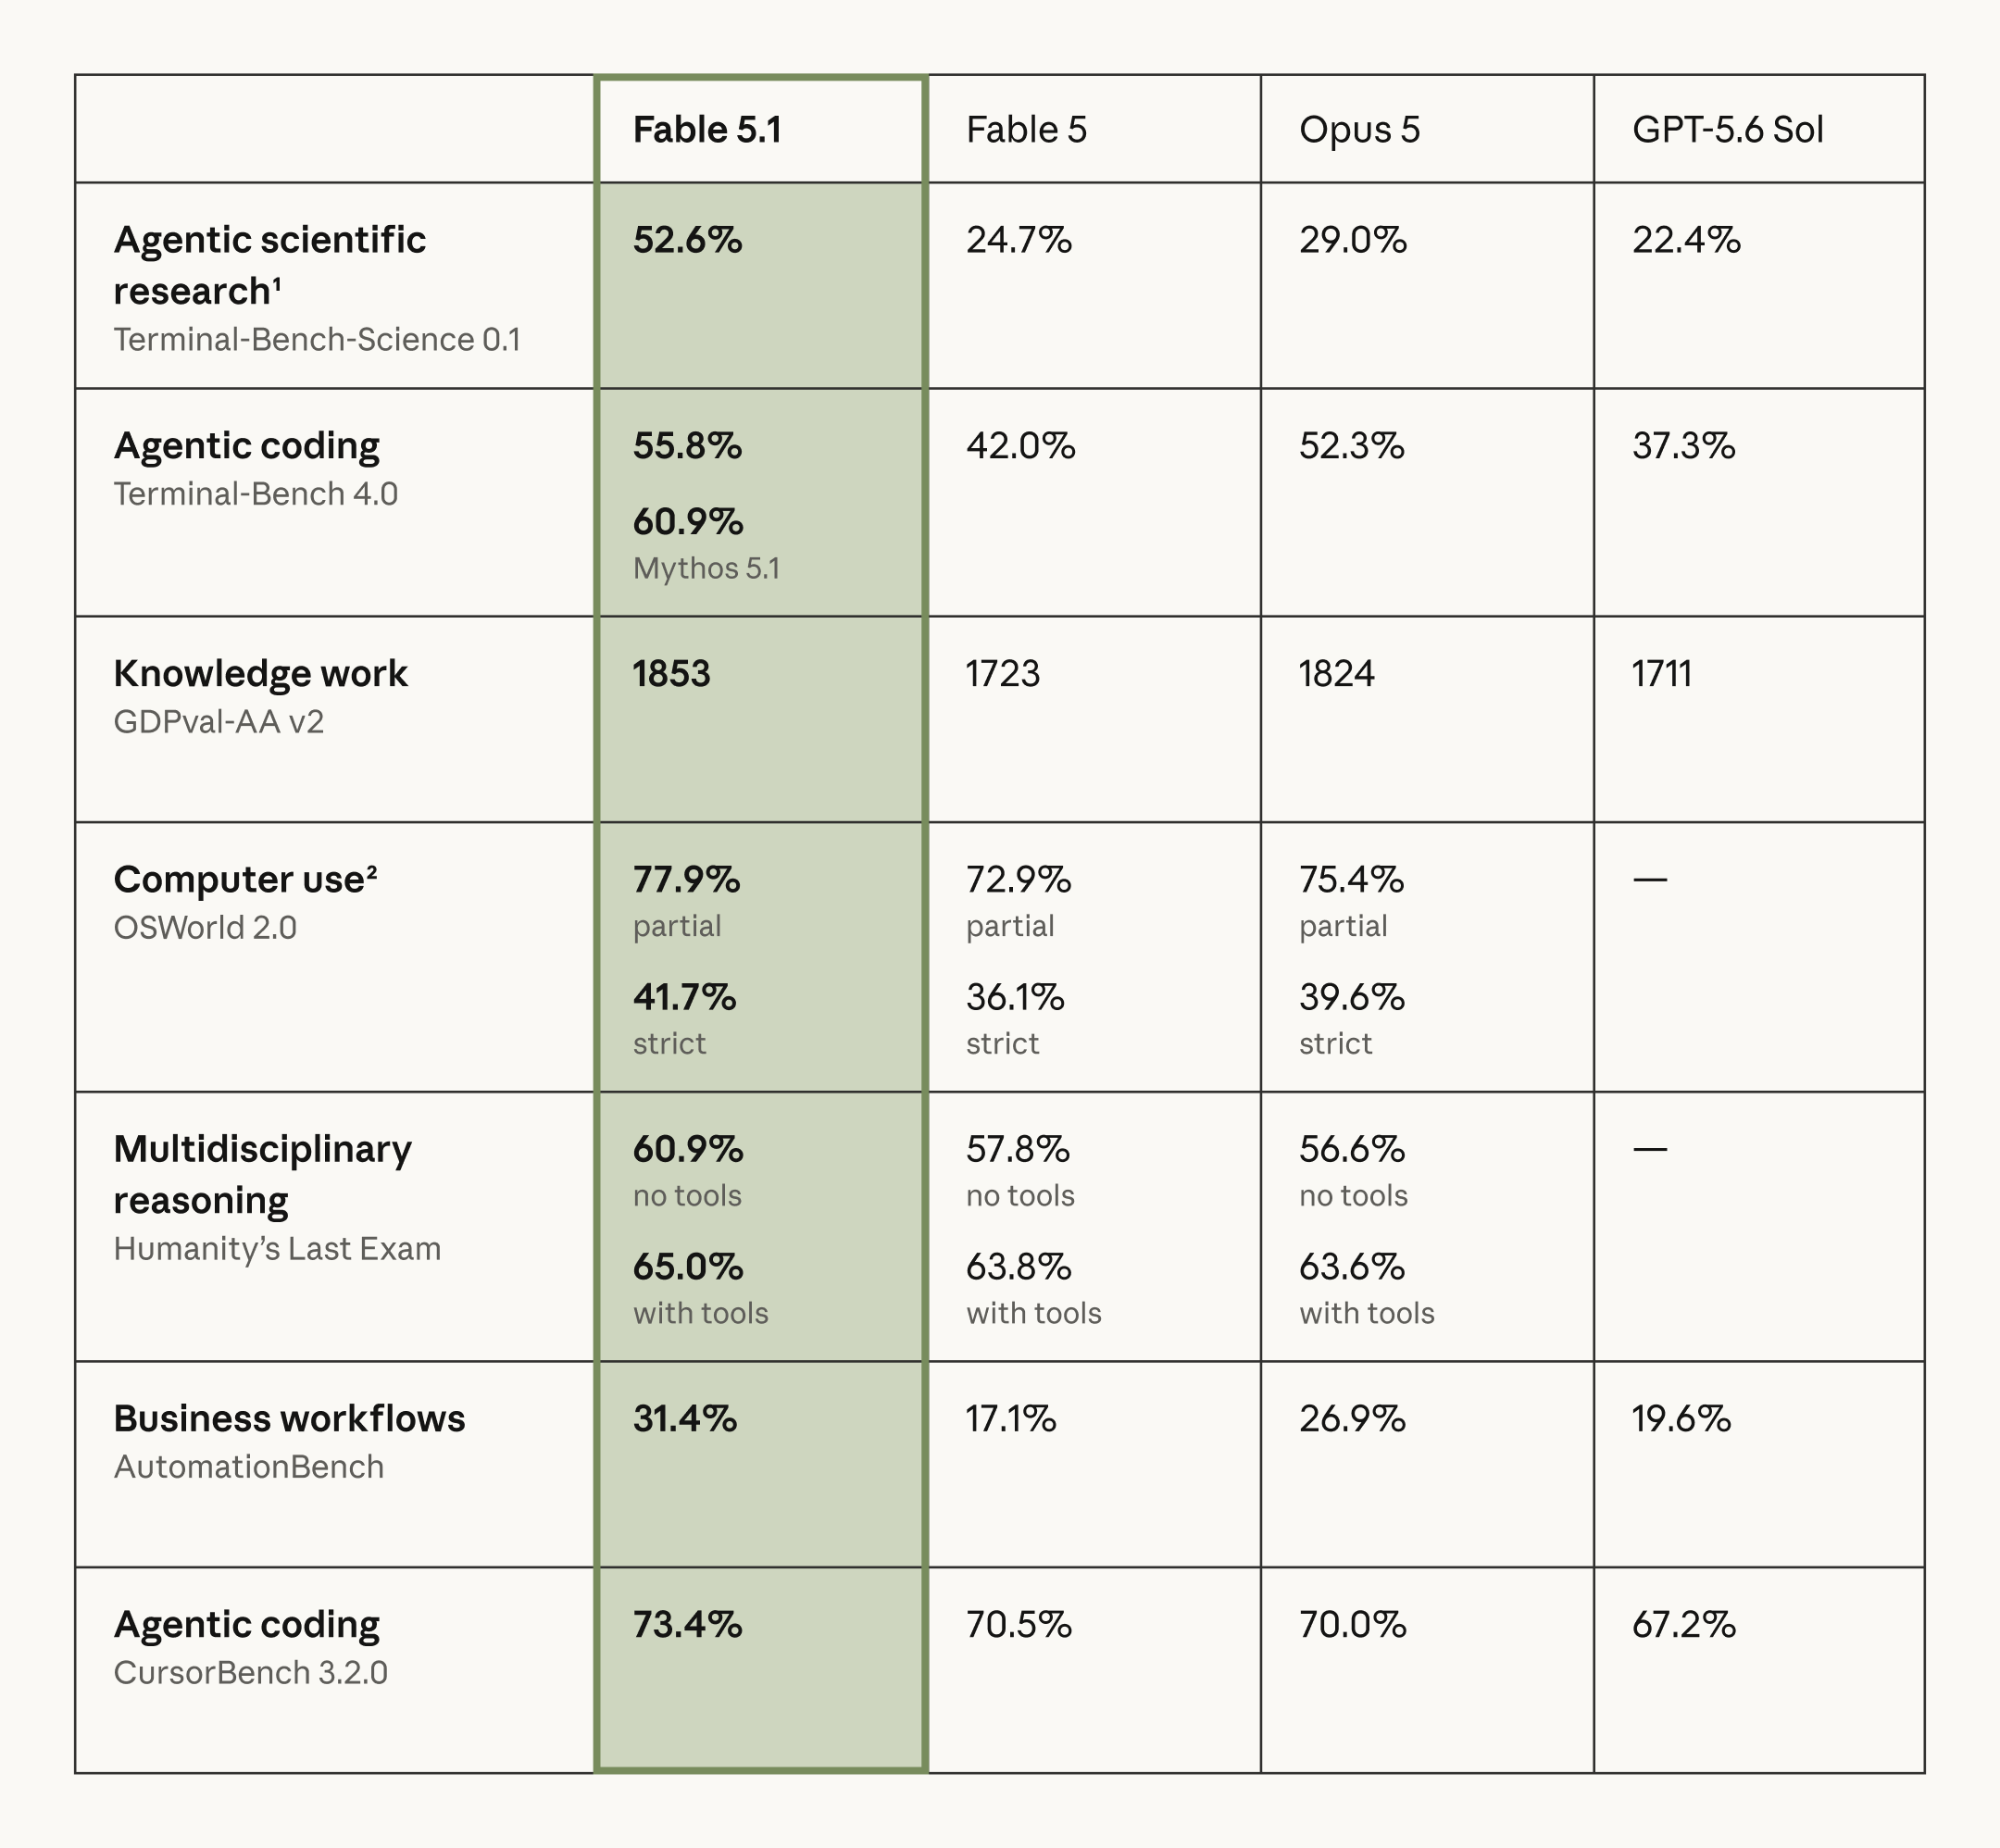
Die offiziellen Benchmark-Ergebnisse umfassen fünf Aufgaben mit gemeldeten Werten für beide Modelle. Prozentpunkt- und Elo-Differenzen unten sind aus diesen veröffentlichten Werten berechnet.
| Benchmark | GPT-5.6 Sol | Claude Fable 5.1 | Fable 5.1 Vorsprung |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 22.4% | 52.6% | +30.2 Pkt |
| Terminal-Bench 4.0 | 37.3% | 55.8% | +18.5 Pkt |
| GDPval-AA v2 | 1711 Elo | 1853 Elo | +142 Elo |
| AutomationBench | 19.6% | 31.4% | +11.8 Pkt |
| CursorBench 3.2.0 | 67.2% | 73.4% | +6.2 Pkt |
Das Ergebnis ist ungewöhnlich konsistent: Fable 5.1 liegt in jeder von Anthropic veröffentlichten direkten Zeile vor GPT-5.6 Sol. Die größten Unterschiede erscheinen in agentischer wissenschaftlicher Forschung und terminalbasiertem Coding, nicht in gewöhnlichem Kurzform-Reasoning.
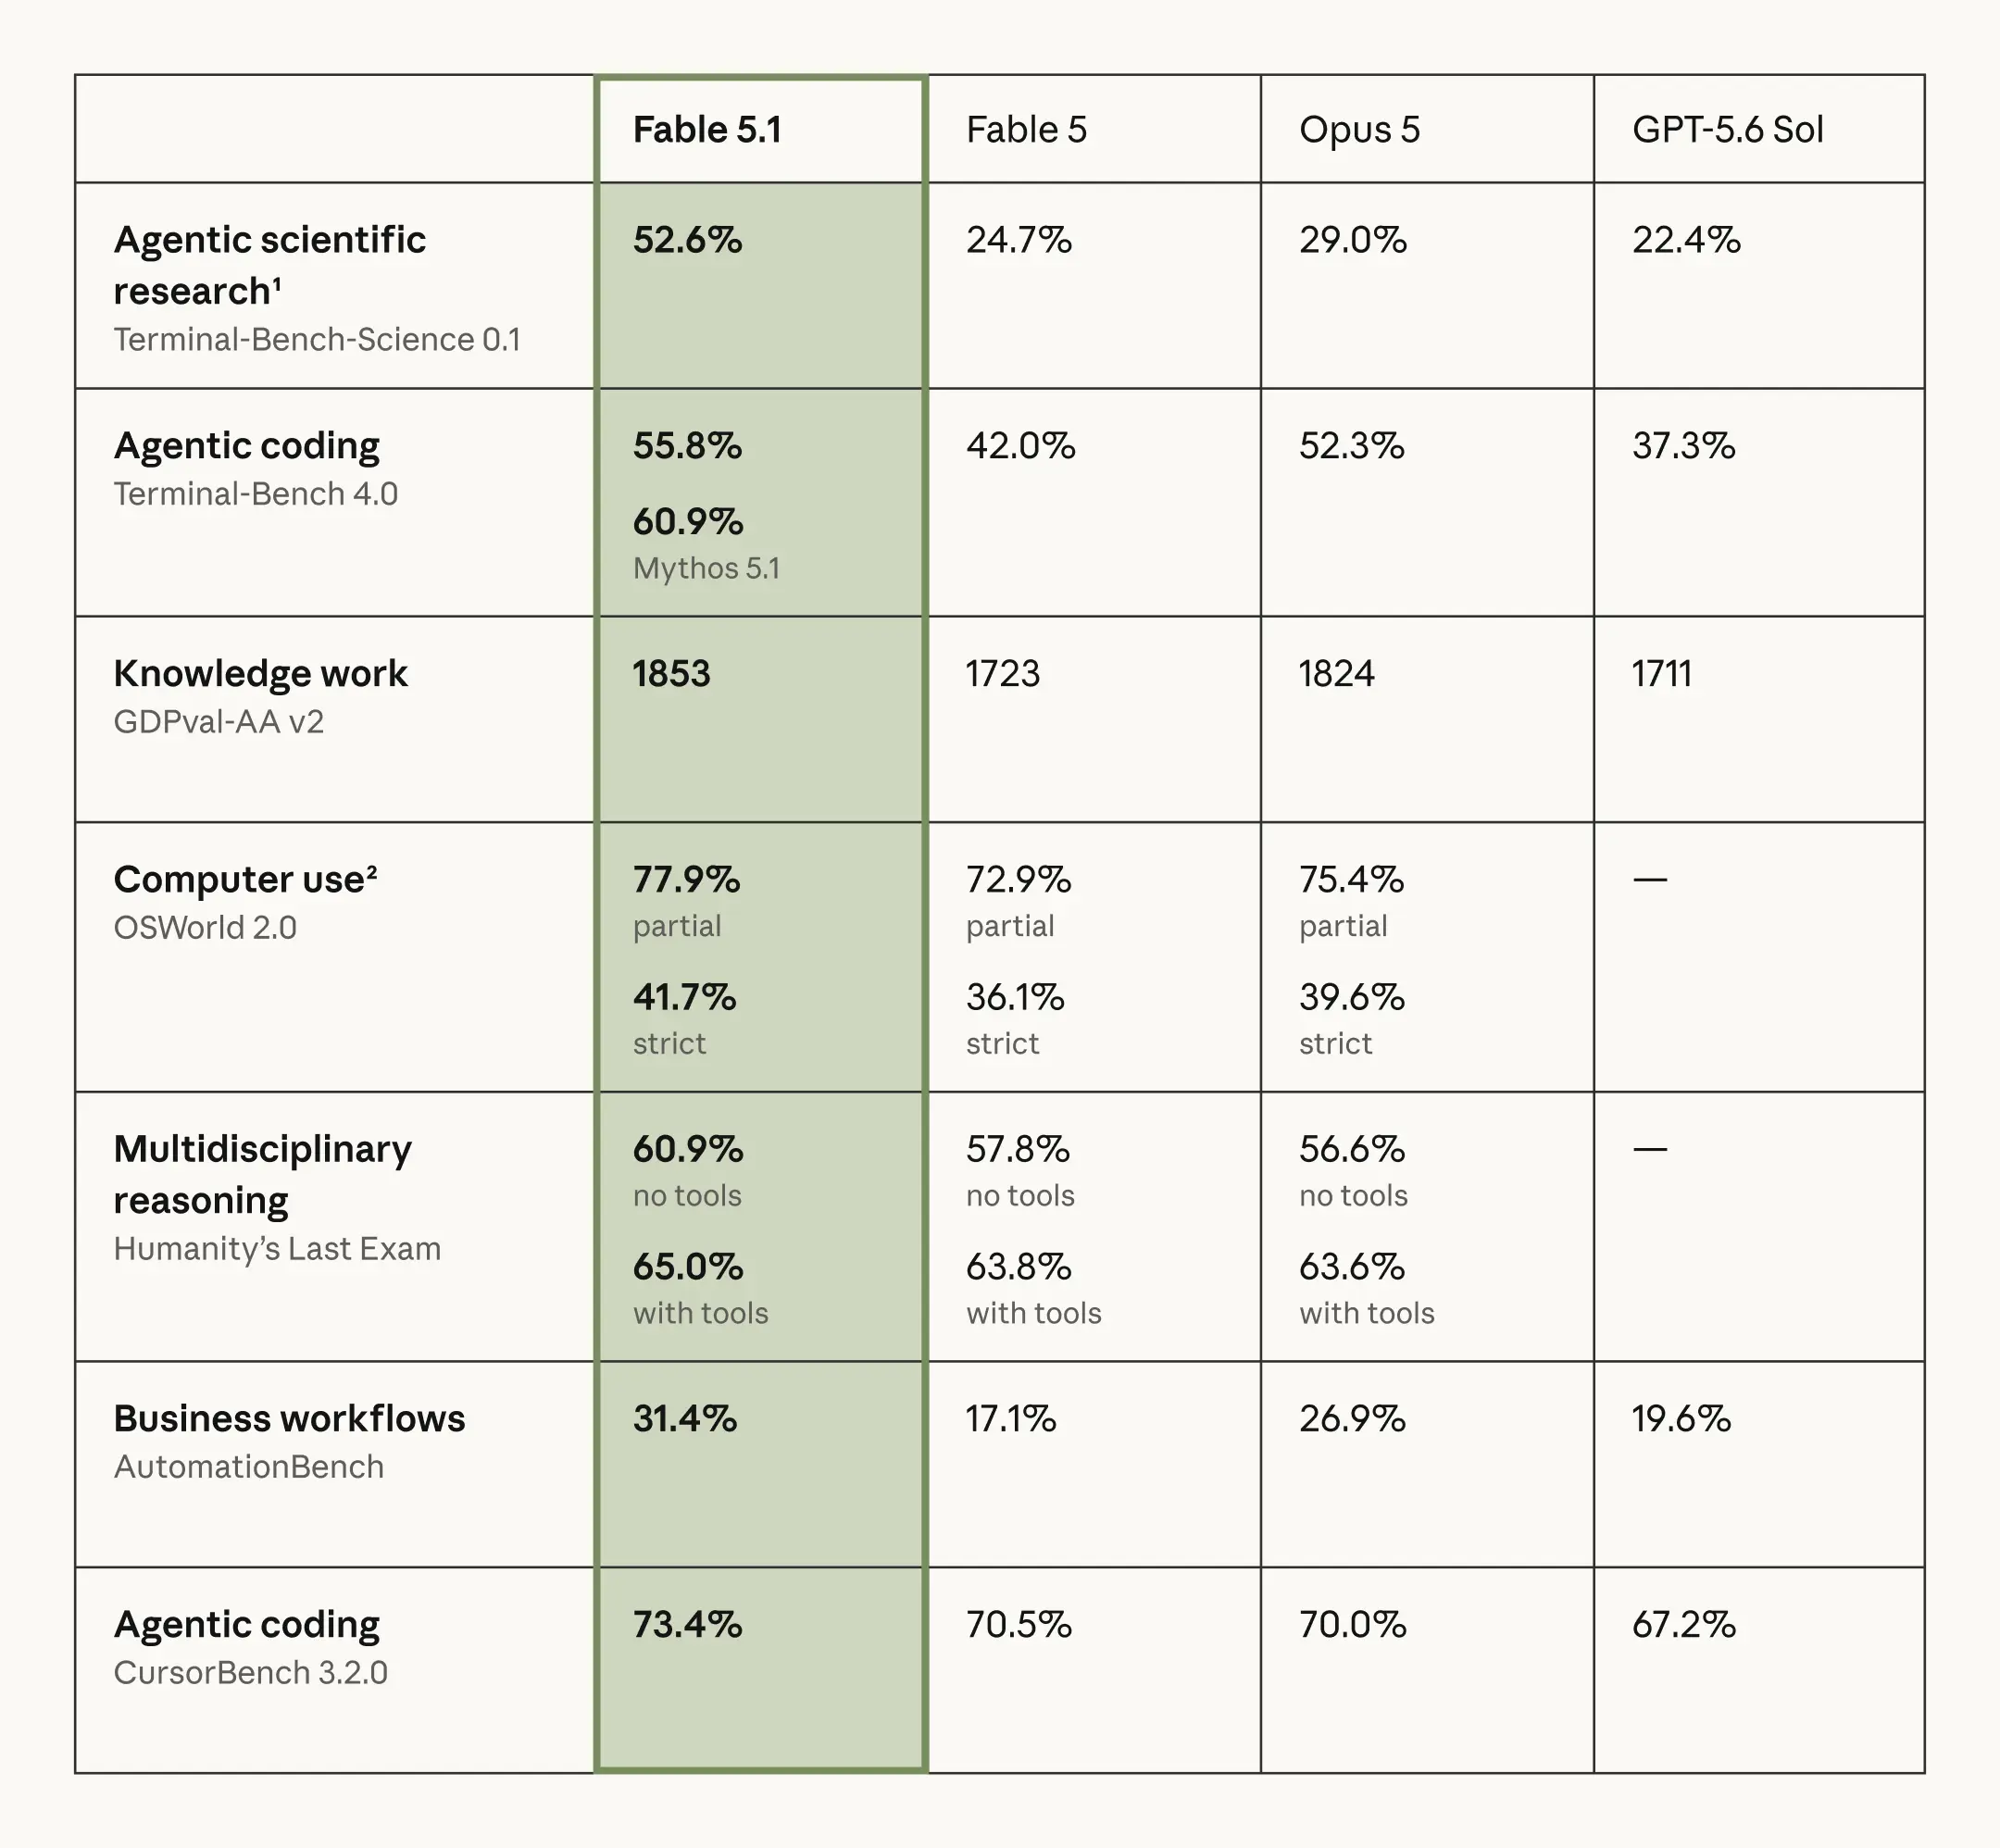
Quelle: Anthropic — Original-Benchmark-Grafik.
Dies sind vom Anbieter durchgeführte Bewertungen: Anthropic testete sowohl sein eigenes Modell als auch das konkurrierende Modell. Sie liefern direkte Vergleichsbelege, sind aber keine unabhängigen Tests. Anthropic meldet eine Standardabweichung von ±3.5–4.5 Prozentpunkten pro Modell bei Terminal-Bench-Science; die obige Tabelle zeigt Punktschätzungen, nicht Konfidenzintervalle.
Die Anbieterergebnisse begünstigen Fable 5.1, aber die unabhängigen Belege benötigen eigene Daten und Konfigurationen.
Unabhängige Benchmarks: datierte Ergebnisse getrennt von Live-Messungen
Artificial Analysis führte am 7. September den Intelligence Index v4.3 ein, ersetzte Terminal-Bench 2.1 durch Terminal-Bench 4.0 und ergänzte AutomationBench-AA. Das Release berichtete 53 für Fable 5.1 und 47 für GPT-5.6 Sol, entsprechend den gerundeten Werten in der Vergleichstabelle vom 8. September. Die Tabelle unterscheidet die Terminal-Ergebnisse des Releases vom späteren Performance-Snapshot.
| Unabhängige AA-Metrik / v4.3-Release | GPT-5.6 Sol (max) | Claude Fable 5.1 (max) | Ergebnis |
|---|---|---|---|
| Intelligence Index v4.3 (Sep 8) | 47 | 53 | Fable |
| Terminal-Bench 4.0 (Sep 7 release) | 39.9% | 52.0% | Fable |
| OSWorld 2.0 | 62.6% | 41.7% | |
| Output speed (Sep 8) | 69.8 tok/s | 69.9 tok/s | Praktisch gleich |
| Time to first token (Sep 8) | 132.10 s | 277.47 s | Sol |
| AA normalized token-mix price / MTok | $3.08 | $7.175 | Sol |
Snapshot: 8. September 2026, außer der explizit datierten Terminal-Bench-Zeile vom 7. September. Fable 5.1 nutzt Adaptive Reasoning, Max Effort, Default Fallback; Sol nutzt max. Live-Messungen können sich ändern. Der normalisierte Token-Mix-Preis von AA verwendet ein 7:2:1-Verhältnis für Cache-Hit/Eingabe/Ausgabe; er ist nicht die Kostenbasis jeder API-Anfrage.
OSWorld 2.0 ist der größte gemeldete Vorteil für Sol in diesem Vergleich: 62.6% gegenüber 41.7% für Fable 5.1, ein Vorsprung von 20.9 Punkten. Dies gleicht die stärkeren Fable-Ergebnisse beim Intelligence Index und Terminal-Bench aus.
Die Belege stützen einen spezifischen Trade-off: Fable 5.1 hat den höheren Intelligence Index, während Sol eine geringere Zeit bis zum ersten Token und einen niedrigeren normalisierten Preis aufweist. Der Ausgabedurchsatz ist praktisch gleich. Diese Messungen stützen unterschiedliche Entscheidungen für qualitätssensitive Batch-Arbeit und interaktive Anwendungen.
Der datierte unabhängige Terminal-Bench-Vergleich zeigt in dieselbe Richtung wie der Test von Anthropic: 52.0% gegenüber 39.9%, verglichen mit 55.8% gegenüber 37.3% beim Anbieter. Die beiden Lücken sind nicht austauschbar, da sich die Evaluierungs-Setups unterscheiden.
Was OpenAI’s Benchmarks weiterhin über GPT-5.6 Sol aussagen
OpenAI’s Launch-Evaluierungen liefern zusätzlichen Kontext zu den Fähigkeiten von GPT-5.6 Sol. Sie gehen den neueren Head-to-Head-Ergebnissen voraus, daher sollten sie nicht als direkter Vergleich mit Fable 5.1 verwendet werden.
OpenAI berichtet 88.8% auf Terminal-Bench 2.1 für GPT-5.6 Sol. Das ist ein Beleg für starke agentische Coding-Fähigkeiten unter dem Launch-Setup; die ältere Benchmark-Version sollte nicht numerisch mit Terminal-Bench 4.0-Scores verglichen werden.
GPT-5.6 Sol vs Fable 5.1 fürs Coding
Für straightforward Code-Generierung sind beide Modelle für viele Produktions-Workloads überqualifiziert. Die Trennung wird deutlicher, wenn Coding zur agentischen Softwareentwicklung wird: ein großes Repository inspizieren, mehrere Dateien bearbeiten, Befehle ausführen, Fehler diagnostizieren, Tests schreiben und iterieren, bis die Aufgabe besteht.
Hier hat Claude Fable 5.1 den stärkeren aktuellen Benchmark-Nachweis. Es führt sowohl die vom Anbieter durchgeführten als auch die unabhängigen Terminal-Bench 4.0-Vergleiche an, und Anthropic’s CursorBench-Ergebnis bevorzugt es ebenfalls mit 73.4% zu 67.2%.
Für eine praktische Coding-Evaluierung sollten repositoryweite Änderungen, Tests, Review und Performance-Arbeit enthalten sein. Ein erfolgreicher kurzer Code-Schnipsel ist ein schwacher Proxy für das Abschließen einer Aufgabe, die mehrere Dateien und fehlgeschlagene Versuche umfasst.
GPT-5.6 Sol bleibt attraktiv, wenn das umgebende Ausführungsumfeld genauso wichtig ist wie die reine Modellqualität. Native Unterstützung für shell execution, apply-patch, code interpreter, file search, computer use und MCP kann die Menge an Orchestrierungsinfrastruktur reduzieren, die Sie selbst bauen müssen.
Coding-Fazit: Wählen Sie Fable 5.1, wenn Ihre Evals die härteste autonome Repository-Arbeit betonen. Wählen Sie GPT-5.6 Sol, wenn ein etwas niedrigerer Benchmark-Wert im Austausch für geringere Kosten und einen breiten integrierten Ausführungsstack akzeptabel ist.
Reasoning-Kontrollen und Developer Experience
Die beiden APIs exponieren Intelligenz unterschiedlich.
Sols Spanne von none bis max erlaubt es Teams, Qualität und Verzögerung bei mehreren Einstellungen zu testen. Niedrigerer Aufwand kann die Reasoning-Arbeit reduzieren, aber die richtige Einstellung hängt von den Ausfallkosten des Tasks ab.
Fables stets aktive adaptive Denkprozesse machen das Tuning des Aufwands zu einer anderen Übung. Vergleichen Sie Einstellungen, die Ihre Anwendung tatsächlich einsetzt, statt identische Effort-Labels als identische Compute-Budgets zu behandeln.
Folglich gibt es keinen universell fairen Vergleich zwischen „Default Sol“ und „Default Fable“. Ihre Standard-Reasoning-Konfigurationen unterscheiden sich. Produktionsevaluierungen sollten entweder äquivalente Aufwandsbudgets vergleichen oder genau die Einstellungen, die Ihre Anwendung tatsächlich bereitstellt.
GPT-5.6 Sol vs Fable 5.1: Welches ist besser für AI-Agenten?
Die Wahl hängt davon ab, ob der Engpass schwieriges Reasoning oder die umgebende Laufzeit ist.
Fables Vorsprung in den zitierten Terminal-, Automations- und Professional-Work-Benchmarks macht es zu einem sinnvollen Kandidaten für die schwierigsten Aufgaben. Messen Sie Abschlussrate und Erholung von Fehlsteps, bevor Sie diesen Vorsprung auf Ihren Agenten verallgemeinern.
Das dokumentierte Responses-Tool-Portfolio von GPT-5.6 Sol macht es attraktiv für Anwendungen, die um search, files, shell execution und patches herum gebaut sind. Das ist ein Integrationsvorteil, der neben der Task-Genauigkeit bewertet werden sollte, kein Ersatz dafür.
| Agent-Anforderung | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|
| Hartes langfristiges Reasoning | Excellent | Best fit |
| Terminal-/Repository-Autonomie | Excellent | Stärkere Belege |
| Natives integriertes Tool-Portfolio | Stärker | Stark |
| Erzwungene Tool-Auswahl | Unterstützt; API prüfen | Beschränkt; tool_choice-Modi prüfen |
| Multi-Agent-Plattformintegration | Starker Vorteil | Über Agent-Architektur verfügbar |
| Fortschrittskommunikation bei langen Jobs | Gut | Kernverhalten |
| Kostensensitive High-Volume-Agenten | Besser | Premium |
| Wiederholt massiver gecachter Kontext | Gut | Potenziell sehr attraktiv |
Die Nutzung beider kann wirtschaftlich sein, wenn nur ein kleiner Anteil der Tasks eskaliert werden muss. Messen Sie, ob die zusätzlichen erfolgreichen Abschlüsse den höheren Preis und die Startverzögerung des zweiten Modells ausgleichen.
Long Context: 1.05M vs 1M ist nicht der entscheidende Unterschied
Die Headline-Zahlen wirken fast identisch: GPT-5.6 Sol bietet 1.05M Tokens und Fable 1M. Ein Kapazitätsunterschied von 5% wird selten darüber entscheiden, ob Sie ein großes Repository, einen juristischen Korpus, ein Forschungsarchiv oder eine mehrstündige Agent-Historie analysieren können. Beide liegen bereits in der Million-Token-Klasse.
Bei GPT-5.6 Sol lösen Eingaben über 272K höhere Long-Context-Tarife für die Anfrage aus: $8/MTok Input, $0.80/MTok gecachter Input und $30/MTok Output. Cache-Writes steigen ebenfalls von $5 auf $10/MTok.
Fable 5.1 behält seine Standardtarife für 1M-Kontext: $10/MTok Input, $50/MTok Output und $0.25/MTok Cache-Reads. Es gibt keine separate Prämie über 272K in dieser dokumentierten Konfiguration.
Betrachten Sie eine Runde mit 100K nicht gecachten Input-Tokens, 900K Cache-Read-Tokens und 20K insgesamt berechneten Output-Tokens. GPT-5.6 Sol kostet 0.1 × $8 + 0.9 × $0.80 + 0.02 × $30 = $2.12. Fable 5.1 kostet 0.1 × $10 + 0.9 × $0.25 + 0.02 × $50 = $2.225.
Diese cachelastige Runde schließt die Preislücke fast, da Fable günstigere Cache-Reads hat. Das Ergebnis hängt vom Token-Mix der Workload ab; es bedeutet nicht, dass beide Modelle für eine komplette Agent-Session gleich viel kosten.
Kostenannahmen: Das 900K-Token-Präfix ist bereits gecached, und der 100K frische Input wird nicht als neuer Cache-Write berechnet. Die Schätzung schließt den initialen Cache-Write und Tool-Gebühren aus. Die 20K Output-Zulage umfasst allen berechneten Output, einschließlich etwaiger berechneter Reasoning-Tokens.
Preisgestaltung: Sol gewinnt bei gewöhnlichen Workloads, Fable bei einer wichtigen Cache-Metrik
Zu den geprüften Tarifen kostet Sol $4 Input / $20 Output pro MTok, mit $0.40 Cache-Reads. Fable 5.1 kostet $10 Input, $50 Output und $0.25 Cache-Reads. Die Tabelle trennt Anbieterpreise von den GPT-5.6 Sol API in CometAPI- und Claude Fable 5.1 API in CometAPI-Tarifen.
| Preiskomponente | GPT-5.6 Sol Offizielle Preise | Claude Fable 5.1 Offizielle Preise |
|---|---|---|
| Offizieller Input / MTok | $4.00 | $10.00 |
| Offizieller Output / MTok | $20.00 | $50.00 |
| Offizieller Cache-Read / MTok | $0.40 | $0.25 |
| Offizieller Cache-Write / MTok | $5.00 (30 Minuten) | $12.50 (5 Minuten) |
| Über 272K Input: Input / Cache-Read / Cache-Write / Output | $8 / $0.80 / $10 / $30 | Gleiche dokumentierte Basistarife |
| CometAPI Input / MTok | $3.20 | $8.00 |
| CometAPI Output / MTok | $16.00 | $40.00 |
Cache-Write-Dauern unterscheiden sich: Sol verwendet eine 30-minütige Standard-Retention, während der Fable 5.1-Tarif eine 5-minütige Write-Dauer zeigt. Prüfen Sie Cache-Erstellung, -Aktualisierung und -Ablaufverhalten für den Anbieter und die Route, die Sie tatsächlich nutzen.
Zu den geprüften Direktanbieterpreisen kostet Fable 5.1 für nicht gecachten Input ($10 vs $4/MTok) und Output ($50 vs $20/MTok) 2.5× so viel wie Sol. Behandeln Sie diese geprüften Tarife als datierten Vergleich, da Anbieteraktionen und Gateway-Preise sich ändern können.
Eine Kurzkontext-Anfrage mit 100K Input und 10K insgesamt berechnetem Output kostet etwa $0.60 mit Sol oder $1.50 mit Fable zu Direktanbieterpreisen. Zu den oben genannten CometAPI-Tarifen kostet derselbe Mix $0.48 bzw. $1.20. Diese Beispiele schließen Cache-Writes und Tool-Gebühren aus.
Fables Kurzkontext-Cache-Read-Rate ist um 37.5% niedriger: ($0.40 − $0.25) ÷ $0.40. Das kann bei Agenten mit großem stabilem Präfix wichtig sein, aber die Gesamtersparnis hängt weiterhin von frischem Input, Schreibfrequenz und Output-Volumen ab.
Preisfazit: Sol ist der günstigere Ausgangspunkt für frischen Kontext-Traffic. Fable wird wettbewerbsfähiger, je höher der Anteil der Cache-Reads ist; vergleichen Sie die Gesamtkosten der Session, einschließlich Erstellung und Auffrischung des Caches.
Geschwindigkeit und Latenz
Tests mit maximalem Aufwand können vor dem ersten sichtbaren Token beträchtliche Reasoning-Zeit verbringen.
Die Messungen zu Durchsatz und Latenz vom 8. September zeigen 69.9 Output-Tokens/s für Fable und 69.8 für Sol. Die Zeit bis zum ersten Token liegt bei 277.47 Sekunden versus 132.10 Sekunden. Der Ausgabedurchsatz ist praktisch gleich; Sol beginnt in dieser Konfiguration früher mit der sichtbaren Ausgabe.
Dies sind Maximum-Effort-Benchmark-Messungen, keine zugesicherte Latenz für jede API. Prompt-Länge, Reasoning-Konfiguration, Provider-Auslastung, Tools und Cache-Zustand können das Ergebnis verändern. Zeit bis zum ersten Token und vollständige Antwortzeit sind unterschiedliche Metriken.
Für interaktive Arbeit kann die niedrigere beobachtete Startverzögerung Sol begünstigen. Für asynchrone Recherche oder nächtliche Repository-Arbeit kann erfolgreiches Abschließen wichtiger sein als das Warten auf den ersten Token. Benchmarken Sie beide Modelle mit den Einstellungen und der Parallelität, die Sie einsetzen möchten.
Schutzmaßnahmen sind ein Produktionsunterschied
Beide Modelle wenden stärkere Schutzmaßnahmen an, da ihre Fähigkeiten in sensible Cybersecurity- und wissenschaftliche Domänen hineinreichen, implementieren diese aber unterschiedlich.
OpenAI beschreibt geschichtete Schutzmechanismen und Monitoring für die GPT-5.6-Familie. Anwendungen in sensiblen Domänen sollten die relevanten Schutzmaßnahmen als Teil ihres Deployments evaluieren.
Anthropic’s Rerouting- und Aufbewahrungsbedingungen beschreiben das Routing mancher sensibler Cybersecurity- oder Biologie-Anfragen auf weniger fähige Modelle, ohne den Fable-Tarif für diese gerouteten Anfragen zu berechnen. Die Standarddatenaufbewahrung beträgt 30 Tage, mit Ausnahmen für geeignete Enterprise-Vereinbarungen.
Für gewöhnliches Coding und Wissensarbeit können diese Unterschiede nie auffallen. Für Security-Produkte, regulierte Workloads oder datenschutzsensitive Deployments gehören sie auf die Evaluierungsliste neben Benchmark-Qualität und Preis.
Welches Modell sollten Sie wählen?
Der Gesamtvergleich lässt sich auf die Workload-Form reduzieren.
| Workload | GPT-5.6 Sol | Claude Fable 5.1 | Empfehlung |
|---|---|---|---|
| Schwieriges autonomes Coding | Excellent | Stärkere aktuelle Benchmarks | Fable 5.1 |
| Langhorizontige Recherche | Excellent | Kernstärke | Fable 5.1 |
| High-Volume Frontier-API | Viel günstiger | Teuer | Sol |
| Interaktiver Coding-Assistent | Niedrigere gemessene TTFT (max) | Höhere gemessene TTFT (max) | Deploy-Einstellungen testen |
| Tool-lastiger API-Agent | Breiteres natives Tool-Stack | Stark | Sol |
| Million-Token gecachter Agent | Wettbewerbsfähig | Sehr niedriger Cache-Read-Preis | Beide testen |
| Maximale Reasoning-Qualität | Excellent | Unabhängige Führung | Fable 5.1 |
| Kosten pro gewöhnlicher Request | Klarer Vorteil | Premium | Sol |
| Bild-/Dokumenten-Reasoning | Stark | Stark | Auf Workload testen |
| Single-Provider OpenAI-Stack | Natürliche Passform | Erfordert Migration/Gateway | Sol |
| Modellunabhängiges Routing | Stark | Stark | Beide über CometAPI |
Eine Routing-Policy sollte ihre Komplexität verdienen. Vergleichen Sie eine Single-Model-Basis mit einer Sol-first-Policy, die schwierige Tasks auf Fable 5.1 eskaliert, und behalten Sie den Router nur, wenn er die Kosten pro erfolgreichem Task bei der erforderlichen Qualität verbessert.
Wie vergleicht man GPT-5.6 Sol und Fable 5.1 über CometAPI
CometAPI integriert GPT-5.6 Sol und Claude Fable 5.1 bereits. Greifen Sie auf beide Modelle mit ihren nativen Request-Formaten zu, senden Sie denselben Evaluierungssatz und vergleichen Sie die zurückgegebenen Ergebnisse unter abgestimmten Einstellungen.
Verwenden Sie Requests im nativen Format für jedes Modell und halten Sie Prompts, Datensätze, Aufwands-Einstellungen, Parallelität und Bewertungsregeln konstant. Wiederholen Sie die Läufe; eine einzelne sequentielle Request pro Modell reicht nicht aus, um verlässliche Latenz oder Qualität zu schätzen.
Für eine Produktionsevaluierung verwenden Sie einen festen Prompt-Satz, wiederholen Läufe in alternierender Reihenfolge, zeichnen die Aufwands-Einstellung auf und bewerten Korrektheit, Test-Passrate, Tool-Erfolg, Retries, Token-Nutzung, verstrichene Zeit und Gesamtkosten pro erfolgreichem Task. Tunen Sie jedes Modell nach der gemeinsamen Basis separat.
Abschließendes Urteil: GPT-5.6 Sol oder Claude Fable 5.1?
Fable 5.1 hat den stärkeren direkten Beleg für die härtesten autonomen Coding- und langhorizontigen Aufgaben. Es führt die fünf gemeinsamen Anbieter-Benchmark-Zeilen und den datierten unabhängigen Terminal-Vergleich an. Das macht es zu einem starken Eskalationskandidaten, vorbehaltlich der Validierung an Ihren eigenen Tasks.
Sol hat niedrigere gewöhnliche Tokenpreise, feinere Reasoning-Kontrollen und ein breites natives Tool-Stack. In der geprüften unabhängigen Maximum-Effort-Konfiguration weist es zudem eine geringere Zeit bis zum ersten Token auf; der Ausgabedurchsatz ist praktisch gleich.
Priorisieren Sie Fable 5.1, wenn die schwierigsten autonomen Aufgaben Ihre Erfolgsquote bestimmen. Beginnen Sie mit Sol für kostensensible Frontier-Inferenz oder toollastige Anwendungen. Testen Sie für interaktive Workloads die eingesetzten Aufwands-Einstellungen, um zu bestätigen, ob der beobachtete Startverzögerungsvorteil bestehen bleibt.
Wählen Sie ein einzelnes Modell, wenn es Ihre Anforderungen schlicht erfüllt. Fügen Sie Routing hinzu, wenn Evaluierungsergebnisse zeigen, dass der Wechsel zwischen beiden Qualität oder Kosten pro erfolgreichem Task verbessert.
FAQ
Ist Claude Fable 5.1 besser als GPT-5.6 Sol?
Es hat im Snapshot vom 8. September den höheren unabhängigen Intelligence Index: 53 gegenüber 47 für Sol. Es führt auch den datierten unabhängigen Terminal-Test an. Das stützt einen Qualitätsvorteil in diesen Evaluierungen, ist aber kein Anspruch, für jede Workload besser zu sein.
Ist GPT-5.6 Sol günstiger als Claude Fable 5.1?
Für gewöhnlichen nicht gecachten API-Traffic ja: die geprüften Direktanbieter-Input/Output-Tarife betragen $4/$20 pro MTok für Sol und $10/$50 für Fable 5.1. Cache-lastige Workloads können diese Lücke verengen, da Fables Cache-Read-Rate niedriger ist. Beziehen Sie Write- und Ablaufverhalten in die Schätzung ein.
Welches Modell ist besser fürs Coding?
Fable 5.1 hat in diesem Vergleich den stärkeren Benchmark-Nachweis für autonomes Coding. Sol bleibt attraktiv für günstigere Workflows und seine integrierten Ausführungstools. Verwenden Sie Repository-Aufgaben mit ausführbaren Tests, um zu entscheiden, ob die gemessene Fähigkeitslücke für Ihre Anwendung relevant ist.
Welches Modell hat das größere Kontextfenster?
Sol führt technisch mit 1.05M gegenüber 1M Tokens bei Fable 5.1, während beide bis zu 128K Output erlauben. In der Praxis sind Sols >272K-Preisschwelle und Fables günstige Cache-Reads meist wichtiger als der Kapazitätsunterschied von 50K Tokens.
Kann ich auf beide Modelle über CometAPI zugreifen?
Ja. Die GPT-5.6 Sol API in CometAPI und die Claude Fable 5.1 API in CometAPI bieten einen gemeinsamen Ausgangspunkt für Text-Evaluierungen. Prüfen Sie route-spezifisches Reasoning, Caching und Tool-Unterstützung, bevor Sie die Basis auf einen Produktionsagenten erweitern.