
TLDR Geleakte Benchmarks und Stealth-Tests auf Arena.ai Mitte September 2026 positionieren Googles unveröffentlichtes Gemini 4 Pro als neuen Frontier-Spitzenreiter und setzen es vor GPT-6 Astra und Claude Fable 5.1 in Software-Engineering, agentischen Aufgaben, Wissensarbeit, Reasoning und multimodalen Benchmarks.
Zentrale Erkenntnisse
- Gemini 4 Pro führt geleakte Auswertungen an auf DeepSWE v1.1 (88.7%), GDPval-AA v2 (2064 Elo), Terminal-bench 2.1 (95.3%), OSWorld-2.0 (86.8%) und mehreren weiteren Agentik-/Reasoning-Suites.
- Es unterbietet GPT-6 Astra ($12/$60) und Claude Fable 5.1 ($10/$50) bei den Listenpreisen und erreicht dabei gleichwertige oder größere Kontextfenster der 1M-Klasse.
- Stealth-Tests auf Arena.ai unter Platzhalternamen (z. B. gemini-3.8-flash) haben herausragende SVG-, Three.js- und agentische Coding-Demos hervorgebracht.
- RSI (rekursive Selbstverbesserung)-Gerüchte kursieren, es fehlt jedoch an öffentlichen Belegen für Closed-Loop-autonome Modellverbesserung bei Gemini 4 selbst.
- Google hat erhebliche Investitionen in ein größeres Gemini 4-Basismodell bestätigt; der öffentliche Launch-Termin ist weiterhin inoffiziell.
- Plattformen wie CometAPI aggregieren bereits Gemini, GPT-6 Astra, Claude Fable/Opus und Hunderte weitere Modelle hinter einem OpenAI-kompatiblen Endpunkt zu wettbewerbsfähigen Preisen – ideal, um die neue Frontier zu benchmarken, sobald sie erscheint.
What Do We Know About Gemini 4 ? (Leaks, Sources, and Verified Context)
Stand 20. September 2026 hat Gemini 4 Pro weder eine offizielle Google-Ankündigung, noch eine Model Card oder eine öffentliche API. Alles jenseits von Googles früheren Aussagen über Investitionen in ein „größeres Gemini 4 Basismodell“ (Quartalszahlen Juli 2026) stammt aus Community-Leaks, Blindtests auf Arena.ai und kursierenden Benchmark-Tabellen.
Wichtige Quellen und Behauptungen:
- Leaker Pankaj Kumar und spätere Posts (Anfang bis Mitte September) verwiesen auf einen internen Pro-Checkpoint mit erwartetem öffentlichem Release im Oktober und einer möglichen Flash-Lite-Variante früher.
- Mehrere Entwickler berichteten, auf Arena.ai ein leistungsfähiges Modell mit der Bezeichnung „gemini-3.8-flash“ (oder ähnlichen Platzhaltern) abgefragt zu haben. Die Outputs umfassten komplexe SVG-Generierung (z. B. Pelikan auf einem Fahrrad, mechanische Schmetterlinge in Three.js), lange nicht-repetitive JSON-Generierung und starkes agentisches Verhalten. Einige Nutzer behaupteten Backend-Details wie mehrmillionige Kontextfenster, 256k-Ausgabeobergrenzen, sitzungsübergreifenden Speicher und native Tool-/Internet-Fähigkeiten.
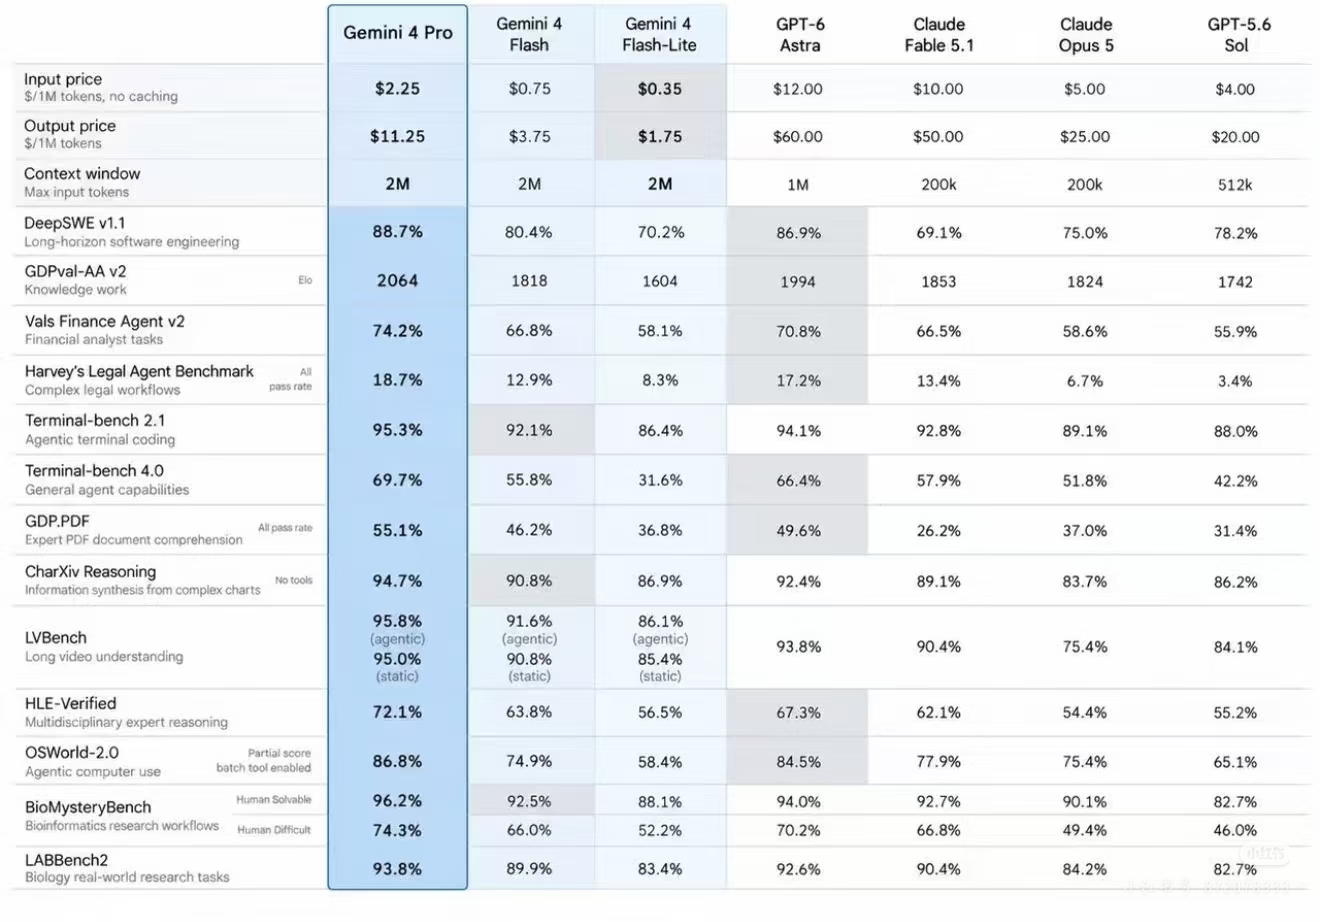
- Eine viel geteilte Vergleichstabelle listet Gemini 4 Pro neben Gemini 4 Flash, Gemini 4 Flash-Lite, GPT-6 Astra, Claude Fable 5.1, Claude Opus 5 und GPT-5.6 Sol.
- Google hat die Arena-Tests oder die Tabelle nicht bestätigt. Historisch zeigt sich, dass das Unternehmen oft Wochen vor formalen Launches Stealth-Evaluierungen auf öffentlichen Plattformen durchführt.
Kontextfenster
Die geleakte Tabelle zeigt 2M maximale Input-Token für die Gemini 4-Familie – doppelt so viel wie die 1M von GPT-6 Astra und deutlich über den 200k der Claude Fable/Opus 5-Linie (einige Claude-Varianten boten über andere Mechanismen größere effektive Fenster). Separate Ghost-Routing-Behauptungen kolportierten 10M-Obergrenzen; diese sind unbestätigt.
Preis von Gemini 4 (geleakte Zahlen)
Die kursierende Tabelle nennt:
- Gemini 4 Pro: $2.25 Input / $11.25 Output pro 1M Token (kein Caching).
- Gemini 4 Flash: $0.75 / $3.75.
- Gemini 4 Flash-Lite: $0.35 / $1.75.
Diese Werte liegen deutlich unter den gemeldeten $12/$60 von GPT-6 Astra und den $10/$50 von Claude Fable 5.1 (Fable 5.1 bietet aggressive Cache-Read-Rabatte, die die effektiven Kosten für agentische Workloads senken können). Die aktuellen offiziellen Preise für Gemini 3.x Pro liegen je nach Kontextlänge bei $2–$4 Input / $12–$18 Output, daher erscheinen die geleakten Pro-Zahlen als plausible Next-Generation-Anpassung.
Die tatsächlichen öffentlichen Preise werden erst zum Launch bekannt sein. Google hat historisch wettbewerbsfähige Tokenraten und Free Tiers genutzt, um die Adoption zu fördern.
Leistung von Gemini 4 Pro: detaillierter Blick auf geleakte Benchmarks
Die kursierende Tabelle setzt Gemini 4 Pro an die Spitze fast jeder Kategorie. Diese Zahlen sind inoffiziell und nicht verifiziert durch Google oder unabhängige Dritte zum Zeitpunkt der Erstellung. Sie sollten als Richtungshinweise und nicht als definitive Ranglisten betrachtet werden.
Software-Engineering & agentisches Coding
- DeepSWE v1.1 (langfristige Softwareentwicklung): 88.7% (vs. GPT-6 Astra 86.9%, Claude Fable 5.1 69.1%, Claude Opus 5 75.0%).
- Terminal-bench 2.1 (agentisches Terminal-Coding): 95.3% (vs. Astra 94.1%, Fable 92.8%).
- Terminal-bench 4.0 (allgemeine Agentenfähigkeiten): 69.7% (größter relativer Abstand gegenüber Flash und Wettbewerbern).
Wissensarbeit & professionelle Aufgaben
- GDPval-AA v2 (Elo, Wissensarbeit): 2064 (einziges Modell über 2000; Astra 1994, Fable 1853).
- Vals Finance Agent v2: 74.2%.
- Harvey’s Legal Agent Benchmark (komplexe juristische Workflows, All-Pass-Rate): 18.7%.
Reasoning, multimodal & spezialisiert
- CharXiv Reasoning (Informationssynthese aus komplexen Charts, ohne Tools): 94.7%.
- LVBench (Langvideo-Verständnis): 95.8% agentisch / 95.0% statisch.
- HLE-Verified (multidisziplinäres Experten-Reasoning): 72.1%.
- OSWorld-2.0 (agentische Computernutzung, Teilscore, Batch-Tool aktiviert): 86.8%.
- BioMysteryBench & LABBench2 (Bioinformatik und biologische Forschungs-Workflows): führende Scores auf sowohl menschlich lösbaren als auch schwierigen Subsets.
Diese Ergebnisse, falls richtungsgetreu, zeigen besondere Stärke bei langfristigen, mehrschrittigen, toolnutzenden agentischen Workloads – genau jenem Bereich, in dem GPT-6 Astra und Claude Fable 5.1 nach ihren Releases Anfang September als führend galten.
Qualitative Arena-Tests untermauern das Bild: komplexe SVG- und Three.js-Generierungen des Stealth-Modells wurden in Community-Side-by-Side-Vergleichen als überlegen oder hochkompetitiv gegenüber Astra bewertet.
How will Gemini 4 work?
Gemini 4 (Pro) ist noch nicht veröffentlicht, daher basiert jede Beschreibung des „Wie es funktionieren wird“ notwendigerweise auf Googles offiziellen Aussagen, begrenzten Leaks zu einem frühen internen Checkpoint, der Entwicklungsrichtung der Gemini 3.x-Reihe und plausiblen technischen Schlussfolgerungen. Nichts davon sollte als bestätigte Spezifikation gelten.
Kerntraining und Skalierungsansatz
Google beschreibt Gemini 4 als seinen „ambitioniertesten Pretraining-Run bislang“, aufgebaut auf einem signifikant größeren Basismodell als zuvor. Das ausdrückliche Ziel ist, an der Frontier wettbewerbsfähig zu bleiben, insbesondere im Coding und bei autonomen Agenten.
Das impliziert:
- Höhere Parameterzahl oder effektivere Kapazität (via Mixture-of-Experts, besserer Sparsität oder dichterer Skalierung).
- Mehr Rechenaufwand im Pretraining.
- Weiterhin starke Betonung multimodaler Trainingsdaten (Text, Bild, Video, Audio, Code, Tool-Use-Trajektorien).
Das Modell dürfte als neuer High-Capability-Baseline dienen, aus der später schnellere Flash-Varianten abgeleitet werden können.
Inferenz- und Denkstil
Geleakte Beschreibungen eines frühen „argon“-Checkpoints erwähnen einen Modus mit hohem Denkaufwand, der rund 2.4 Minuten für eine einzelne Generierung benötigte und ein deutlich höheres Ausgabelimit unterstützte (gemeldet bei 256k Token gegenüber zuvor ~64k).
Das weist auf Folgendes hin:
- Optionale, rechenintensive Reasoning-Pfade (ähnlich erweiterten Denk- oder „Max-Effort“-Modi konkurrierender Modelle).
- Die Fähigkeit, vor der Antwort mehr interne Berechnung auf schwierige Probleme zu verwenden.
- Bessere Unterstützung langer, kohärenter Outputs wie vollständiger Codebasen, mehrschrittiger Pläne oder umfangreicher Reports.
Nutzer werden voraussichtlich die Abwägung zwischen Geschwindigkeit/Kosten und Denktiefe steuern können, so wie bei aktuellen Gemini Flash Modellen, die niedrige / mittlere / hohe Denkstufen bieten.
Wichtige Schwerpunktbereiche
- Coding und Software-Engineering Stärkere langfristige Performance: multifile Refactorings, Debugging über Repositories hinweg, Selbstkorrekturschleifen und höhere Abschlussraten bei realistischen Softwareaufgaben.
- Autonomes/agentisches Verhalten Verbesserte Fähigkeit zu planen, Tools zu nutzen, Zwischenergebnisse zu beobachten, sich von Fehlern zu erholen und über viele Schritte auf ein Ziel hinzuarbeiten. Baut direkt auf den Computer-Use- und Agentik-Funktionen in Gemini 3.5/3.8 Flash auf.
- Langkontext-Zuverlässigkeit Community-Berichte erwähnen Zielgrößen im Bereich 1.5 Millionen Token (oder höher). Das praktische Ziel sind nicht nur größere Fenster, sondern bessere Abruffidelity und weniger Degradation bei sehr langen Dokumenten, Codebasen oder mehrstündigen Agent-Spuren.
- Multimodales Verständnis und Generierung Native Verarbeitung von Text + Bild + Video + Audio, mit erwarteten Fortschritten in räumlichem Reasoning, Videokompetenz und Echtzeit-Voice/Agent-Interaktionen (aufbauend auf den Gemini 3.8 Live Modellen vom September 2026).
- Tool-Nutzung und strukturierte Outputs Robustere Function Calling-, Codeausführungs-, Suchgrundierungs- und strukturierte JSON/XML-Outputs für verlässliche Integration in Anwendungen und Agenten.
Unterschiede zu Gemini 3.x
- Skalierung: Explizit größeres Basismodell statt inkrementeller Verfeinerung.
- Ausgabekapazität: Geleakte höhere Tokenlimits ermöglichen längere Single-Pass-Generierungen.
- Reasoning-Tiefe: Ausgeprägtere High-Effort-Modi für schwierige Probleme.
- Agentik-Fokus: Größerer Schwerpunkt auf nachhaltiger, mehrschrittiger autonomer Arbeit statt Single-Turn- oder kurzhorizontiger Tasks.
- Positionierung: Gedacht als neues Frontier-Pro-Tier, während die Flash-Linie für Geschwindigkeit und Kosteneffizienz schnell iteriert.
Beziehung zur rekursiven Selbstverbesserung (RSI)
Google-Führungskräfte haben die großen KI-Investitionsausgaben öffentlich mit dem längerfristigen Ziel der rekursiven Selbstverbesserung verknüpft – Systeme, die sich selbst oder die Prozesse zur Entwicklung der nächsten Generation substanziell verbessern können. Verwandte Forschung (z. B. das Dream-RSI-Paper) zeigt Agenten, die ihre eigenen Explorationsstrategien verbessern, ohne Modellgewichte zu ändern.
Wird Gemini 4 Pro GPT-6 und Claude Fable 5.1 übertreffen?
| Kategorie | Gemini 4 Pro | GPT-6 Astra | Claude Fable 5.1 | Anmerkungen |
|---|---|---|---|---|
| Input-/Output-Preis | $2.25 / $11.25 | $12.00 / $60.00 | $10.00 / $50.00 | Gemini 4 Pro ~5× günstiger als Astra |
| Kontextfenster | 2M | 1M | 200k | Bedeutender Vorteil für Gemini |
| DeepSWE v1.1 | 88.7% | 86.9% | 69.1% | Starkes Coding-Lead |
| GDPval-AA v2 (Elo) | 2064 | 1994 | 1853 | Führend in Wissensarbeit |
| Terminal-bench 4.0 | 69.7% | 66.4% | 57.9% | Allgemeine Agentenfähigkeiten |
| OSWorld-2.0 | 86.8% | 84.5% | 77.9% | Computernutzung |
| HLE-Verified | 72.1% | 67.3% | 62.1% | Experten-Reasoning |
| LVBench (Video) | 95.8% / 95.0% | 93.8% | 90.4% | Multimodale Stärke |
| Bio-/LAB-Forschung | Höchste Scores | Stark | Wettbewerbsfähig | Wissenschaftliche Workflows |
Gemini 4 Pro führt jede wichtige Zeile der Tabelle an, oft mit spürbarem Abstand, während die behauptete Preisgestaltung deutlich aggressiver ist als bei GPT-6 Astra oder Claude Fable 5.1.
Wichtige Hinweise
- Diese Tabelle ist keine offizielle Google-Veröffentlichung. Stand 20. September 2026 hat Google weiterhin keine Model Card, API, Preisgestaltung oder bestätigte Benchmarks für Gemini 4 Pro publiziert. Die Zahlen stammen aus Community-Quellen / Arena-Sichtungen / Leaks zu internen Checkpoints (Codename „argon“).
- Einige früher kursierende Sheets wurden später als prognostiziert oder teilweise kopiert eingestuft. Behandle jede konkrete Prozentzahl und die Preise als unverifiziert, bis Google sie bestätigt.
- Das Kontextfenster von Claude Fable 5.1 ist hier mit 200k angegeben, was niedriger ist als die 1M-Zahl, die in der offiziellen Anthropic-Dokumentation häufig genannt wird. Dies könnte eine spezifische Evaluations-Einstellung widerspiegeln oder ein Fehler im geleakten Sheet sein.
- GPT-6 Astra und Claude Fable 5.1 sind derzeit die einzigen vollständig öffentlichen, unabhängig evaluierten Frontier-Modelle. Artificial Analysis und andere Drittanbieter-Tracker sehen sie insgesamt weiterhin als eng beieinander liegend (mit unterschiedlichen Stärken).
Aktuelle praktische Realität (20. September 2026)
| Modell | Status | Am besten geeignet für | Preisniveau |
|---|---|---|---|
| Gemini 4 Pro | Nicht veröffentlicht (angeblich stark) | Langkontext, Coding, Agenten, Multimodalität, Kosten | Sehr aggressiv (behauptet) |
| GPT-6 Astra | Veröffentlicht | Mathe, Computernutzung, Terminal, Automatisierung, Cyber | Premium |
| Claude Fable 5.1 | Veröffentlicht | Langlaufende Wissensarbeit, Reasoning, Codequalität, Cache-Effizienz | Premium |
| Gemini 4 Flash / Flash-Lite | Angebliche Geschwistermodelle | Geschwindigkeit + kostenempfindliche Workloads | Extrem niedrig |
Schnelle Erkenntnisse
- Dominant über das gesamte Spektrum: Gemini 4 Pro rangiert in jeder aufgeführten Kategorie auf Platz 1, oft mit klarer Marge.
- Besondere Stärken: Langhorizont-Coding/Agenten (DeepSWE, Terminal-bench), Wissensarbeit, Multimodalität (Video + Charts) und spezialisierte Domänen (Finanzen, Recht, Biologie, Computernutzung).
- Preissetzung: Etwa 1/5 der Kosten von GPT-6 Astra und Claude Fable 5.1 bei Input und Output bei gleichzeitig höheren Scores.
Astra betont Computernutzung, Cybersecurity-Schwellen und wissenschaftliche Entdeckungen; Fable 5.1 betont langlaufende Wissensarbeit und Coding mit verfeinerten Schutzmechanismen und niedrigen Cache-Read-Kosten. Das geleakte Profil von Gemini 4 Pro erscheint am stärksten in breitem agentischem Software-Engineering und multimodalem Reasoning.
Wie sich Entwickler vorbereiten können: Empfehlungen von CometAPI
Während man auf offiziellen Zugriff auf Gemini 4 Pro wartet, profitieren Teams von einem einheitlichen Gateway, das bereits die aktuelle Frontier unterstützt (Gemini 3.x-Serie, GPT-6 Astra, Claude Fable 5.1 / Opus 5 und 500+ weitere Modelle). CometAPI bietet genau das: einen OpenAI-kompatiblen Endpunkt, einen API-Key, Pay-as-you-go-Abrechnung typischerweise 20–40% unter Direktanbietern und die Möglichkeit, Modelle mit einer einzigen Parameteränderung zu wechseln.
Praktischer Workflow:
- Prototypisieren Sie agentische Pipelines auf den aktuellen Gemini Flash/Pro, GPT-6 Astra und Claude Fable 5.1 über CometAPI.
- Benchmarken Sie dieselben Prompts über Modelle hinweg, um Baselines zu etablieren.
- Wenn Gemini 4 Pro (und seine Flash-Varianten) im CometAPI-Katalog erscheinen – historisch nimmt die Plattform neue Google-Modelle rasch auf – tauschen Sie die Modell-ID aus und führen Sie die Evaluierungen mit minimalen Codeänderungen erneut aus.
- Nutzen Sie das Kostendashboard, um Token-Ausgaben über Anbieter hinweg zu verfolgen und leiten Sie hohes Volumen oder latenzsensitive Lasten zum wirtschaftlichsten fähigen Modell.
Dieser Ansatz eliminiert Multi-Key-Management, reduziert das Risiko von Vendor Lock-in und positioniert Teams für die Übernahme von Gemini 4 Pro am ersten Tag der öffentlichen Verfügbarkeit.
Gemini 4 Pro stellt, falls die Leaks sich als richtungsgetreu erweisen, Googles stärkstes Angebot dar, die Frontier im agentischen Software-Engineering und langkontextuellen multimodalen Reasoning zurückzuerobern. Die Kombination aus behaupteter Performance, großem Kontext und aggressiver Preisgestaltung würde es für viele Produktions-Workloads zur Standardoption machen. Bis zum offiziellen Launch und unabhängigen Evaluierungen ist der kluge Weg das kontinuierliche Benchmarking über die bestehenden Frontier-Modelle – leicht machbar über Plattformen, die den Zugriff bereits vereinheitlichen. Bleiben Sie dran für die formale Ankündigung; die nächsten Wochen werden voraussichtlich klären, wie viel des Hypes in Produktionsrealität übergeht.
FAQs
Ist Gemini 4 Pro veröffentlicht?
Nein. Laut aktuellem Katalog und Google-Aussagen (Mitte bis Ende September 2026) wurde es noch nicht öffentlich veröffentlicht oder mit einer offiziellen Modell-ID gelistet.
Wann wird Gemini 4 Pro voraussichtlich erscheinen?
Leaker deuten auf Oktober 2026 (mit einigen Spekulationen für Ende September). Google hat kein offizielles Datum genannt. Behandeln Sie dies als Zeitfenster bis zur Bestätigung via API-Katalog oder Blogpost.
Hat Google mit Gemini 4 Pro RSI erreicht?
Öffentliche Belege zeigen fortgeschrittene Nutzung agentischer Schleifen zur Modellverfeinerung und Forschung zu Strategieebene-rekursiver Verbesserung (z. B. Dream-RSI). Behauptungen über vollständige RSI als Entstehungsmechanismus des Modells sind nicht unabhängig verifiziert.
Wie schneidet es gegenüber GPT-6 Astra und Claude Fable 5.1 in Benchmarks ab?
Geleakte Community-Charts behaupten Führungen auf mehreren Agenten-/Coding-Suites. Offizielle unabhängige Scores für ein veröffentlichtes Gemini 4 Pro existieren noch nicht. Aktuelle öffentliche Daten sprechen dafür, die verfügbaren Modelle (Astra und Fable 5.1) auf Ihren Aufgaben zu evaluieren.
Sollte ich mit dem Bauen warten, bis Gemini 4 Pro erscheint?
Nein. Liefern Sie mit den heute stärksten verfügbaren Modellen (zugänglich via CometAPI oder Direkt-APIs), halten Sie Evaluationssets bereit und übernehmen Sie das neue Modell, wenn unabhängige und interne Tests den Wechsel rechtfertigen.
Wo kann ich aktuelle Frontier-Modelle einfach nutzen?
Einheitliche Anbieter wie CometAPI bieten OpenAI-kompatiblen Zugriff auf Modelle der GPT-6 Astra-Klasse, Claude Fable 5.1, aktuelle Gemini-Modelle und andere mit vereinfachter Abrechnung und einfachem Wechsel. Prüfen Sie die Live-Modellliste und Dokumentation für aktuelle IDs und Preise.