
TL;DR
Claude Haiku 5.5 y GPT-6 Luna son modelos de razonamiento de bajo costo para cargas de trabajo de API de gran volumen. Ambos comienzan en $0.10 por millón de tokens de entrada y $0.50 por millón de tokens de salida. Haiku obtiene puntuaciones más altas en las seis comparaciones publicadas en los materiales de lanzamiento de Anthropic. Luna mantiene sus tarifas base por token para prompts de hasta 272K tokens de entrada, frente al umbral de 100K de Haiku. Para los desarrolladores, las métricas clave son la tasa de aceptación, la latencia de extremo a extremo, la compatibilidad de la API y el costo por resultado aceptado: el costo total de todos los intentos dividido entre el número de salidas que superan verificaciones predefinidas.
Puntos clave
- Haiku 5.5 lidera la comparación de uso de computadora OSWorld 2.1 citada, 72.4% frente al 48.9% de Luna.
- En Terminal-Bench 4.0, los resultados citados son 39.2% para Haiku y 16.4% para Luna.
- Ambos comienzan con precios idénticos para contexto corto, pero el nivel de precio más alto de Haiku inicia más allá de 100K tokens en el prompt, frente al umbral de 272K de Luna.
- Las páginas de máximo esfuerzo de Artificial Analysis, consultadas el 9 de octubre de 2026, muestran velocidades de salida de 240.6 tokens/s para Haiku y 123.0 tokens/s para Luna; el rendimiento excluye el tiempo de espera del primer token.
- Comienza con Haiku para las tareas de uso de computadora y terminal reflejadas en los benchmarks compartidos; considera Luna para prompts grandes. Mantén tu modelo actual hasta que un piloto representativo demuestre una mejora útil.
¿Qué son Claude Haiku 5.5 y GPT-6 Luna?
Claude Haiku 5.5: Descripción general
Claude Haiku 5.5 se lanzó el 7 de octubre de 2026. Combina inferencia de bajo precio con razonamiento ajustable, uso de herramientas, contexto largo y entradas de texto e imagen. Las aplicaciones típicas incluyen extracción de documentos, consultas a bases de datos, soporte al cliente y subagentes ligeros.
GPT-6 Luna: Descripción general
GPT-6 Luna se lanzó el 22 de septiembre de 2026. Está orientado a tareas focalizadas a escala, incluyendo clasificación, extracción de información, salida estructurada, asistencia de programación y procesamiento de documentos largos. Sus ajustes flexibles de razonamiento incluyen una configuración sin razonamiento para trabajos más simples.
Especificaciones
| Especificación | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Desarrollador | Anthropic | OpenAI |
| Lanzamiento | 7 de octubre de 2026 | 22 de septiembre de 2026 |
| ID del modelo | claude-haiku-5-5 | gpt-6-luna |
| Ventana de contexto | 1,000,000 tokens | 1,050,000 tokens |
| Salida máxima (API estándar) | 128,000 tokens | 128,000 tokens |
| Entrada | Texto e imagen | Texto e imagen |
| Salida | Texto | Texto |
| Razonamiento | Ajustable, Bajo a Máximo | Ninguno a Máximo |
| Esfuerzo predeterminado | Medio | Medio |
| Corte de conocimiento | junio de 2026 | 18 de mayo de 2026 |
| Uso de herramientas | Sí | Sí |
| Salida estructurada | Sí | Sí |
| Pesos abiertos | No | No |
| Arquitectura y número de parámetros | No especificado en los materiales oficiales citados | No especificado en los materiales oficiales citados |
Las especificaciones usan la documentación estándar de modelos de API de los proveedores, consultadas el 9 de octubre de 2026: Especificaciones de API estándar de Haiku y Especificaciones de API estándar de Luna. La arquitectura y los conteos de parámetros se dejan sin especificar porque estas fuentes no los establecen.
Claude Haiku 5.5 vs GPT-6 Luna: Resultados de benchmarks
| Punto de referencia | Haiku 5.5 | GPT-6 Luna | Líder |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1,620 | 1,437 | Haiku +183 |
| AA-Briefcase v1.1 (Elo) | 1,578 | 1,336 | Haiku +242 |
| OSWorld 2.1, puntuación parcial offline | 72.4% | 48.9% | Haiku +23.5 pp |
| Terminal-Bench 4.0 | 39.2% | 16.4% | Haiku +22.8 pp |
| FrontierCode 1.1 Main | 46.4% | 42.4% | Haiku +4.0 pp |
| Chartography, sin herramientas | 46.4% | 29.1% | Haiku +17.3 pp |
Las seis filas anteriores reproducen los resultados de comparación publicados por Anthropic en el lanzamiento, consultados el 9 de octubre de 2026. Son comparaciones publicadas por Anthropic, incluyendo resultados independientes allí reproducidos, en lugar de nuevas pruebas ejecutadas para este artículo. GDPval-AA y AA-Briefcase son puntuaciones Elo; las brechas porcentuales son puntos porcentuales. Estas familias de benchmarks miden tareas diferentes y no deben promediarse para obtener un ganador universal.
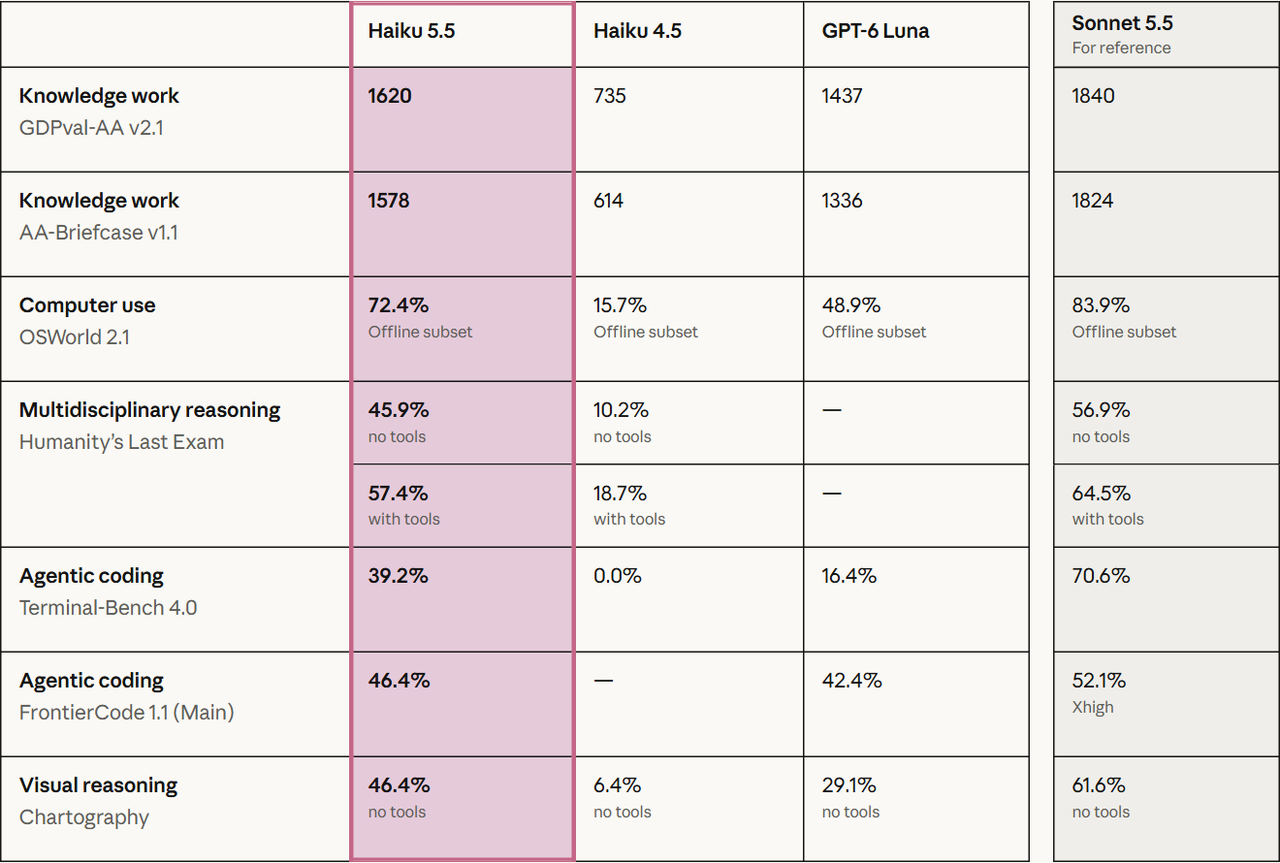
Las fortalezas relativas más destacadas de Haiku en esta tabla de lanzamiento aparecen en interacción visual con computadora y tareas basadas en terminal. Su ventaja menor en FrontierCode advierte contra extrapolar una brecha de 20 puntos a todas las situaciones de codificación. Usa estos resultados para seleccionar candidatos de piloto, luego valida tus prompts y pila de herramientas.
Esfuerzo de razonamiento y límites de evaluación
El esfuerzo de razonamiento cambia la relación precisión–costo. Compara los ajustes disponibles usando la misma carga de trabajo y arnés; nombres de ajuste iguales entre proveedores no garantizan presupuestos de tokens de razonamiento iguales. La tabla de lanzamiento reporta el subconjunto offline de OSWorld y Chartography sin herramientas. El arnés, la selección de tareas, los reintentos y el acceso a herramientas pueden cambiar los resultados. La system card de Anthropic documenta las condiciones específicas de benchmark. Lee los métodos de benchmark en la system card de Anthropic.
- OSWorld usa el subconjunto offline de 82 tareas, una máquina virtual Ubuntu, capturas 1080p, un límite de 500 acciones, esfuerzo máximo y cinco intentos por tarea. La comparación 72.4%/48.9% es puntuación de crédito parcial, no el porcentaje de tareas completadas perfectamente; la tasa de aprobación estricta de Haiku es 37.1%. Anthropic ejecutó Luna en el mismo subconjunto de tareas a través de la API de OpenAI.
- Terminal-Bench usa 66 tareas contenedorizadas; Haiku se ejecutó a esfuerzo máximo en Claude Code bare mode, sin egreso a internet ni modelo de respaldo, con un promedio de diez ensayos por tarea.
- FrontierCode Main contiene 100 tareas con cinco ejecuciones por tarea; los modelos Claude usaron Claude Code y los modelos GPT usaron Codex.
- GDPval-AA y AA-Briefcase fueron evaluados independientemente por Artificial Analysis y reproducidos en los materiales del lanzamiento. Son canalizaciones de evaluación separadas, no un único arnés de producción compartido.
Claude Haiku 5.5 vs GPT-6 Luna: Comparación de funciones
Uso de la computadora y codificación con agentes
La mayor ventaja de Haiku está en las tareas compartidas de lanzamiento que requieren interactuar con una computadora gráfica o trabajar en un terminal. La brecha de puntuación parcial de OSWorld es de 23.5 puntos porcentuales, mientras que Terminal-Bench difiere en 22.8 puntos. La menor diferencia de 4.0 puntos en FrontierCode muestra por qué la categoría más amplia de codificación no debe tratarse como una sola carga de trabajo.
Para automatización de navegador, prueba la navegación de páginas, entrada de formularios, recuperación ante fallos de herramientas y la finalización de extremo a extremo. Para codificación, prueba si un parche supera las verificaciones funcionales de tu repositorio y se mantiene dentro del alcance. Esas verificaciones de aceptación son más útiles que escoger un modelo por la brecha titular más grande.
Contexto largo y procesamiento de documentos
La diferencia del 5% en capacidad nominal de contexto es menos significativa que la fiabilidad y el precio de procesar prompts sustanciales. Ningún modelo es inherentemente superior recuperando información solo porque su ventana de contexto sea mayor.
La diferencia clave es cuándo se aplican tarifas más altas: un prompt de 150K tokens cruza el umbral de Haiku mientras permanece dentro del nivel base de Luna. Por lo tanto, Luna es el punto de partida de menor costo para esa carga de tokens. Si es mejor analista de documentos depende aún de la precisión de extracción, las citas y los reintentos necesarios para obtener una respuesta aceptable.
Controles de razonamiento
Ambos modelos exponen esfuerzo de razonamiento ajustable, con medio como predeterminado en la documentación citada. Luna también expone un ajuste none. Usa esos controles según la tarea: la extracción y el enrutamiento pueden requerir menos razonamiento que un flujo de trabajo incierto de herramientas en varios pasos. La misma etiqueta de esfuerzo no implica el mismo presupuesto de cómputo entre proveedores.
Entrada multimodal y flujos de trabajo estructurados
Ambos aceptan texto e imágenes y producen texto. Esto los convierte en candidatos para capturas de pantalla, extracción de imágenes de documentos y flujos de trabajo estructurados posteriores. Su soporte de entrada por sí solo no establece precisión igual en texto pequeño, gráficos o interfaces visuales; mide esos casos por separado.
Velocidad y economía de tareas
| Métrica independiente (esfuerzo máximo) | Haiku 5.5 — Artificial Analysis | GPT-6 Luna — Artificial Analysis |
|---|---|---|
| Intelligence Index v4.3.2 | 43 | 38 |
| Velocidad de salida | 240.6 tokens/s | 123.0 tokens/s |
| Costo ponderado por tarea de Intelligence Index | $0.21 | $0.07 |
Artificial Analysis es el editor de pruebas independiente. La tabla es una instantánea de sus páginas de modelos en esfuerzo máximo consultadas el 9 de octubre de 2026, no un rendimiento oficial del proveedor. La velocidad de salida mide los tokens recibidos tras comenzar la generación; es separada del tiempo al primer token y de la latencia total de la tarea. El costo por tarea es una métrica ponderada de Intelligence Index, no una cotización para tu tarea de producción ni un costo por resultado exitoso.
El rendimiento instantáneo de salida de Haiku es aproximadamente 1.96 veces el de Luna, mientras que el costo ponderado por tarea de evaluación de Luna es menor. Esto no establece una ventaja de 1.96 veces en el tiempo de finalización de tareas completas. Las pruebas de producción deben registrar por separado el tiempo al primer token, el tiempo de finalización, la longitud de la salida, el consumo de razonamiento y el tiempo de ejecución de herramientas.
Claude Haiku 5.5 vs GPT-6 Luna: Precios y acceso a API
Tarifas estándar oficiales
| USD por 1M de tokens | Haiku ≤100K | Haiku >100K | Luna ≤272K | Luna >272K |
|---|---|---|---|---|
| Entrada | $0.10 | $0.50 | $0.10 | $0.20 |
| Lectura en caché | $0.01 | $0.05 | $0.01 | $0.02 |
| Escritura en caché (Haiku: TTL de 5 minutos) | $0.125 | $0.625 | $0.125 | $0.25 |
| Salida | $0.50 | $2.50 | $0.50 | $0.75 |
USD por millón de tokens a tarifas de procesamiento estándar, consultadas el 9 de octubre de 2026. La tabla usa las tarifas estándar y de escritura en caché de 5 minutos de Haiku y las tarifas de contexto corto y largo de Luna. Se excluyen tarifas de herramientas, impuestos, incrementos regionales y ajustes opcionales de nivel de procesamiento. Por encima del umbral de entrada, las tarifas más altas aplican a la solicitud en su conjunto, no solo al exceso de tokens.
Haiku también ofrece escrituras en caché de 1 hora a $0.20/$1.00 por millón de tokens para prompts cortos/largos. Los mecanismos de persistencia y precios de caché difieren entre proveedores, así que compara patrones de reutilización en lugar de tratar ambas filas de escritura en caché como productos idénticos. El límite de 128K de salida de Haiku es el límite de la API estándar; su Message Batches API puede soportar 300K de salida con un encabezado beta.
Costos ilustrativos con presupuestos de tokens fijos
| Carga de trabajo | Entrada / Salida | Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| Clasificación de tickets | 2K / 200 | $0.0003 | $0.0003 |
| Informe corto | 40K / 4K | $0.006 | $0.006 |
| Análisis de repositorio | 150K / 5K | $0.0875 | $0.0175 |
| Revisión de documento grande | 300K / 10K | $0.175 | $0.0675 |
| Análisis de contexto masivo | 800K / 20K | $0.45 | $0.175 |
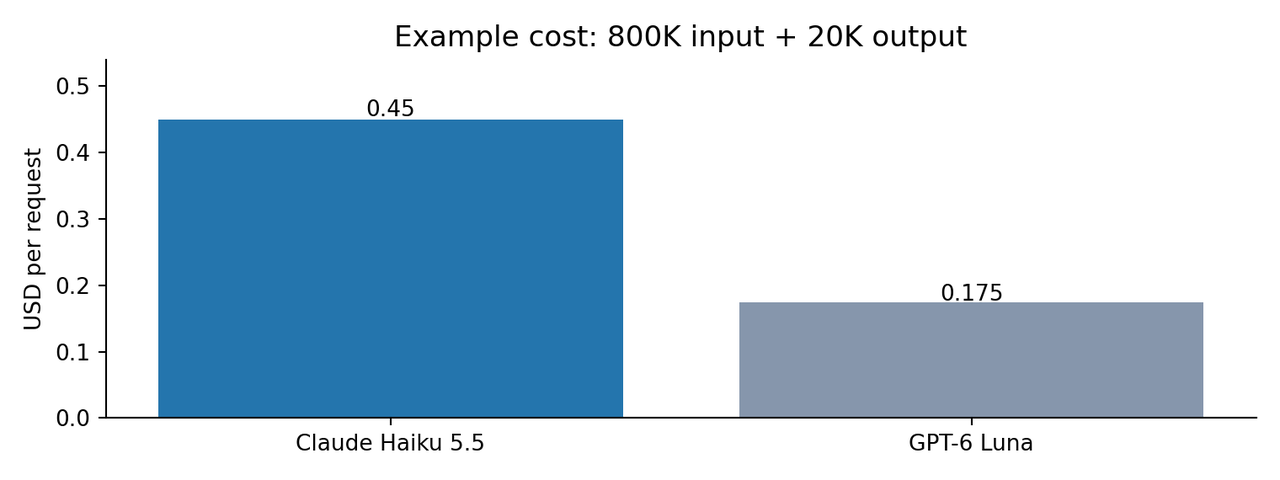
Estimación de tarifa estándar sin caché calculada por el autor: cost = input tokens × input rate / 1,000,000 + billed output tokens × output rate / 1,000,000. “Output” significa salida total facturada para esta estimación, incluyendo tokens de razonamiento cuando se cobran como salida; no es necesariamente la longitud visible de la respuesta. Se usan los mismos conteos de tokens reportados para ambos modelos, aunque los tokenizadores pueden diferir.
Un token barato no implica necesariamente un resultado exitoso barato. Los equipos deben considerar intentos repetidos, llamadas de herramientas fallidas, consumo de tokens de razonamiento y comportamientos diferentes de tokenización.
Acceso a CometAPI y restricciones de integración
CometAPI ofrece opciones de acceso para ambos modelos. Antes de compararlos o desplegarlos a través del gateway, verifica los IDs de modelo, endpoints compatibles, parámetros de solicitud, comportamiento de herramientas y reglas de facturación para cada ruta. Estos enlaces del proveedor documentan opciones de acceso; no reemplazan las fuentes técnicas o de precios estándar de los vendedores.
Para integraciones directas con OpenAI, Luna soporta herramientas integradas a través de Responses API; las llamadas a funciones de Chat Completions requieren el esfuerzo de razonamiento none. Haiku usa Messages API de Anthropic y pensamiento adaptativo. Un gateway no vuelve intercambiables los esquemas subyacentes: valida definiciones de herramientas, comportamiento de salida estructurada, eventos de streaming y contabilidad con la ruta exacta que piensas usar.
¿Cómo pueden los desarrolladores comparar Claude Haiku 5.5 y GPT-6 Luna con el mismo prompt?
Ejemplo de extracción de documentos largos
Una comparación práctica puede usar un paquete de contratos de proveedores que contenga fechas de vigencia, términos de renovación, periodos de aviso y excepciones. Mantén idénticos el paquete de documentos, las instrucciones de extracción, los campos esperados y las reglas de validación. Lo siguiente es un diseño de evaluación, no un nuevo resultado medido del modelo.
Prompt de ejemplo: Extrae para cada contrato el nombre del proveedor, fecha de vigencia, fecha de renovación, periodo de aviso de terminación y excepciones de precios. Para cada valor extraído, cita el título del documento y el pasaje exacto de respaldo. Devuelve null cuando un campo esté ausente; no infieras fechas faltantes. Señala cláusulas en conflicto y mantén la respuesta final dentro de 1,000 palabras.
| Verificación | Criterio de aceptación | Qué registrar |
|---|---|---|
| Precisión de extracción | Los campos requeridos coinciden con una clave verificada independientemente | Valores correctos, incorrectos y faltantes |
| Fundamentación | Cada campo no nulo tiene un pasaje de respaldo válido | Afirmaciones sin soporte y citas de documento incorrectas |
| Seguimiento de instrucciones | No se inventan fechas; campos ausentes devuelven null | Fallos de esquema y violaciones de restricciones |
| Economía | Calcular gasto por extracción aceptada | Entrada, salida, razonamiento facturados, reintentos y costo de respaldo |
| Latencia | Comparar la finalización del trabajo bajo la misma política de herramientas | Tiempo al primer token y tiempo de extremo a extremo |
Ejecuta más de un paquete representativo y repite los casos donde los resultados varíen. Comienza con el mismo nivel de esfuerzo disponible, luego prueba una configuración de menor costo para cada modelo. Informa el tamaño de la muestra, configuraciones, ruta, fecha y conteos de fallos antes de presentar un ganador.
Haiku 5.5 o GPT-6 Luna: ¿Cuál elegir?
| Dimensión | Punto de partida mejor respaldado | Límite de decisión |
|---|---|---|
| Interacción con GUI | Claude Haiku 5.5 | Las puntuaciones parciales compartidas de OSWorld favorecen a Haiku; verifica la finalización completa |
| Codificación en terminal | Claude Haiku 5.5 | Las puntuaciones compartidas de Terminal-Bench favorecen a Haiku; valida cambios en el repositorio |
| Prompts cortos y precios base | Probar ambos | Tarifas base idénticas; compara uso facturado y reintentos |
| Prompts por encima de 100K tokens | GPT-6 Luna con tarifas estándar | Luna mantiene el nivel base por más tiempo; la precisión puede alterar el costo total |
| Rendimiento de tokens en streaming | Claude Haiku 5.5 en la instantánea fechada | El rendimiento difiere del tiempo total de finalización |
| Extracción simple y repetida | Probar Luna con razonamiento bajo o none | Selecciona por salida aceptada válida, no solo por precio |
Elige Claude Haiku 5.5 para tareas interactivas relevantes para los benchmarks
Comienza con Haiku cuando tu aplicación se parezca a las tareas publicadas de computadora gráfica, codificación en terminal o trabajo profesional, y una mayor tasa de finalización compense el gasto adicional en razonamiento o contexto largo. Confirma esa ventaja en tu propia pila de herramientas antes de enrutar tráfico de producción.
Elige GPT-6 Luna para controlar costos en prompts grandes
Comienza con Luna cuando los prompts superen con frecuencia los 100K tokens y los costos estándar por token afecten materialmente tu presupuesto. También es candidato para extracción repetida o enrutamiento que pueda tener éxito con razonamiento bajo o nulo. Mantén la recomendación condicionada a las tasas de resultados aceptados y al uso realmente facturado.
Usar ambos cuando las cargas de trabajo tienen necesidades diferentes
Un piloto podría enrutar extracción de documentos largos a Luna y tareas de GUI o terminal a Haiku, luego validar cada elección con verificaciones de aceptación. Lanza un respaldo cuando una salida falle la validación de esquema, carezca de evidencia requerida o falle una verificación específica de la tarea, e incluye costos y latencia del respaldo en la comparación.
Validar antes de cambiar
Incluye tu modelo actual como línea base. Cambia solo cuando el candidato cumpla un objetivo de corrección predefinido y mejore el costo por resultado aceptado o la latencia de extremo a extremo lo suficiente para cubrir migración y mantenimiento. Detén el despliegue si aumentan los errores críticos de herramientas. La recomendación cambia si tu piloto muestra que la tarifa más baja de Luna se compensa con reintentos, o que las puntuaciones de benchmark más altas de Haiku no mejoran el éxito de tu tarea.
- Usa una muestra representativa de carga de trabajo y puntúa resultados correctos, incorrectos e incompletos.
- Mide latencia del primer token, tiempo total de tarea y fiabilidad de herramientas.
- Sigue por separado los conteos de tokens de entrada, caché, salida y razonamiento.
- Calcula el costo por resultado exitoso, incluyendo reintentos y respaldos.
- Compara esfuerzo de razonamiento medio y alto antes de habilitar máximos por defecto.
Conclusión
Claude Haiku 5.5 presenta evidencia de lanzamiento más sólida en las comparaciones de trabajo profesional, uso de computadora y codificación con agentes aquí tratadas. También tiene mayor rendimiento de salida en la instantánea independiente. GPT-6 Luna tiene una clara ventaja de tarifas estándar para prompts por encima del umbral de 100K de Haiku y un costo ponderado por tarea de evaluación más bajo. Ninguna de estas observaciones por sí sola determina la fiabilidad en producción o el costo por resultado exitoso.
El ganador práctico es el modelo que entrega un resultado aceptable al menor costo operativo totalmente medido. Ejecuta ambos con tus propios prompts, herramientas y reglas de reintento en lugar de tratar un solo benchmark como la respuesta.
Preguntas frecuentes
¿Por qué pueden diferir los costos de tareas cuando ambos modelos tienen los mismos precios base por token?
El mismo precio base no implica la misma factura total. Los modelos pueden usar cantidades diferentes de tokens de entrada, salida y razonamiento, y pueden necesitar números distintos de reintentos o llamadas de herramientas para producir un resultado aceptable. Las tarifas de contexto largo y el uso de caché también afectan el total. Compara el costo total de todos los intentos dividido entre el número de resultados aceptados, en lugar de solo los precios por token.
¿Las tarifas más altas de contexto largo se aplican solo a los tokens por encima del umbral?
No. Bajo la tarificación estándar descrita en este artículo, cruzar el umbral de entrada aplica las tarifas más altas a la solicitud, no solo a los tokens excedentes. Por ejemplo, una solicitud de 150K tokens de entrada cruza el umbral de 100K de Haiku pero permanece dentro del nivel base de 272K de Luna. Usa las tarifas de entrada y salida aplicables para toda la solicitud al estimar el costo.
¿Pueden Claude Haiku 5.5 y GPT-6 Luna compartir una caché de prompts?
No asumas que las entradas de caché se transfieren entre modelos o proveedores. Diseña estrategias de reutilización separadas y mide las tasas de acierto y uso facturado en cada ruta. El soporte del gateway, las reglas de retención y la estructura de la solicitud pueden afectar si la entrada repetida es elegible para caché; verifica esto antes de proyectar ahorros.
¿Qué debe cubrir una prueba de migración de Haiku a Luna?
Prueba entradas representativas de texto e imagen, campos estructurados requeridos, argumentos de herramientas, respuestas transmitidas y recuperación ante errores. Establece la tasa de aceptación de tu sistema actual antes de la migración, luego compara ambos candidatos bajo las mismas políticas de reintento y herramientas. Precios de tokens similares o categorías de modelo similares no establecen compatibilidad.
¿Deben las puntuaciones de benchmark impulsar un fallback a Haiku o Luna?
Usa las puntuaciones para elegir candidatos, luego activa respaldos ante fallos observados como argumentos de herramientas inválidos, campos requeridos faltantes o verificaciones de tarea incumplidas. Rastrea la frecuencia de respaldo y el costo total facturado. Un segundo modelo puede añadir latencia y gasto, así que verifica que mejore resultados aceptados en lugar de simplemente producir una segunda respuesta.
¿Se pueden enrutar datos sensibles a través de ambas API?
Revisa los proveedores y el gateway exactos involucrados, sus ajustes de retención actuales, ubicaciones de procesamiento, términos contractuales y la política de datos de tu organización antes de enrutar entradas sensibles. La capacidad del modelo y las tablas de precios no establecen la elegibilidad de una ruta para datos regulados o confidenciales. Usa la ruta aprobada cuando esos requisitos sean decisivos.