
TL;DR
DeepSeek V4.1 Flash sustituye a la generación anterior V4 Flash con un modelo MoE de codificador–decodificador causal de 552B parámetros, comprensión nativa de imágenes, una ventana de contexto de 1M tokens y un coste de servicio sustancialmente menor. En la comparación oficial de DeepSeek, mejora la mayoría de los benchmarks de código, terminal, seguridad y agentes frente a V4 Pro 0813, mientras que V4 Pro mantiene ventaja en GPQA Diamond y HLE sin herramientas.
La página actual de precios del API de DeepSeek vuelve a listar deepseek-flash y deepseek-v4-pro como rutas separadas, sirviendo V4.1 Flash y V4-Pro-0813 respectivamente. Tienen diferentes precios, límites de concurrencia y soporte de visión. Por tanto, las nuevas integraciones deberían seleccionar el ID de modelo que coincida con la carga prevista en lugar de confiar en el comportamiento histórico de alias.
Conclusiones clave
- V4.1 Flash y V4 Pro son actualmente opciones oficiales de API distintas: usa deepseek-flash para V4.1 Flash y deepseek-v4-pro para V4-Pro-0813.
- Las mayores ganancias comparables aparecen en tareas de terminal, agentes de código, automatización y ejecución orientada a seguridad, no en todos los benchmarks de razonamiento de libro cerrado.
- V4.1 Flash es materialmente más barato que la ruta V4 Pro actualmente listada en tokens de entrada con acierto de caché, entrada con fallo de caché y salida.
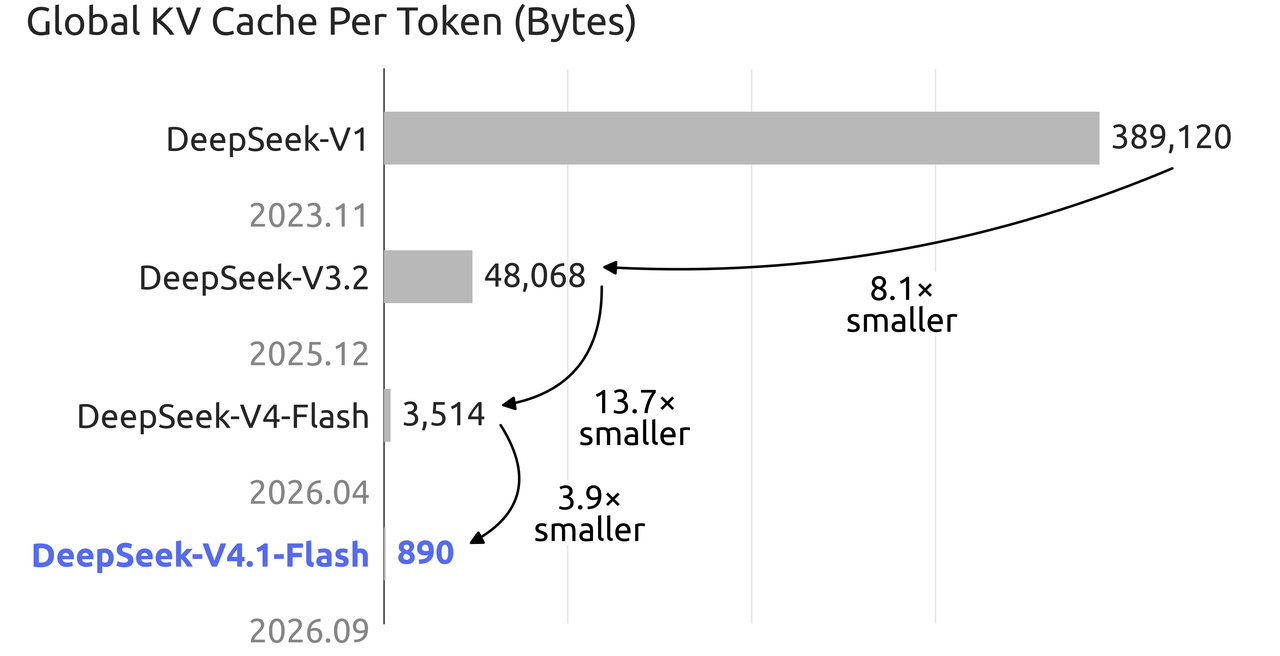
- V4.1 Flash añade visión nativa, eleva la concurrencia documentada de 500 a 2.500 y reduce el almacenamiento global del KV cache a 890 bytes por token.
- La migración debe ser explícita aunque los alias funcionen: actualiza los IDs de modelo, valida el comportamiento con y sin pensamiento, vuelve a probar llamadas a herramientas y entradas de imagen, y monitoriza el uso de tokens y la latencia.
Nota de enrutamiento actual: la página oficial de precios identifica deepseek-v4-pro como V4-Pro-0813, separada de V4.1 Flash.
¿Cómo se comparan las especificaciones de DeepSeek V4.1 Flash y V4 Pro?
La arquitectura pasó de un diseño MoE disperso muy grande en V4 Pro a un diseño asimétrico de codificador–decodificador causal en V4.1 Flash. El modelo más reciente activa menos parámetros para el procesamiento de entrada que para la generación de salida, lo que ayuda a reducir el coste de prefill preservando una mayor capacidad de generación.
| Especificación | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 |
|---|---|---|
| Arquitectura | MoE de codificador–decodificador causal | MoE disperso |
| Parámetros totales Parámetros del backbone / recuento de pesos del repositorio | 552B parámetros del backbone; Hugging Face lista un tamaño de modelo de 763B | 1,6T parámetros del backbone; Hugging Face lista aproximadamente 1,7T de tamaño de modelo |
| Parámetros activos | 8B para entrada; 16B para salida | 49B por token |
| Ventana de contexto | 1M tokens | 1M tokens |
| Salida máxima | 384K tokens | 384K tokens |
| Modos con y sin pensamiento | Compatibles | Compatibles |
| Comprensión nativa de imágenes | Compatible | No compatible |
| Concurrencia documentada | 2.500 | 500 en la configuración actual |
| Estado actual oficial del API | Activo como deepseek-flash | Activo como deepseek-v4-pro (V4-Pro-0813) |
Aclaración sobre el recuento de parámetros: la ficha del modelo V4.1 Flash de DeepSeek describe 552B parámetros del backbone, mientras que el repositorio de Hugging Face informa un tamaño de modelo de 763B. Estas cifras describen diferentes alcances contables y no deben presentarse como totales intercambiables.
Aclaración sobre la longitud de salida: la ficha del modelo V4.1 Flash recomienda max_tokens ≥ 256K para inferencia local, mientras que la página actual de precios del API de DeepSeek indica explícitamente un máximo de salida de 384K para ambos modelos del API. Una configuración recomendada de inferencia no es lo mismo que un máximo aplicado por el API.
¿Dónde mejora DeepSeek V4.1 Flash frente a V4 Pro?
La tabla de benchmarks oficial de DeepSeek muestra las mejoras más claras en cargas de trabajo con ejecución intensiva. La columna de porcentaje a continuación se calcula a partir de las puntuaciones publicadas; se omiten comparaciones porcentuales donde la métrica es una valoración o donde un porcentaje simple sería engañoso.
| Benchmark | V4.1 Flash | V4 Pro 0813 | Diferencia | Interpretación |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 90.6 | 87.9 | +2.7 puntos; +3.1% | Ejecución de terminal más fiable |
| Terminal-Bench 3.0 | 30.0 | 11.8 | +18.2 puntos; +154.2% | Gran ganancia en tareas de terminal más difíciles |
| Terminal-Bench 4.0 | 31.2 | 12.4 | +18.8 puntos; +151.6% | Gran ganancia en tareas de terminal más nuevas |
| DeepSWE v1.1 | 74.2 | 62.7 | +11.5 puntos; +18.3% | Trabajo de software a nivel de repositorio más sólido |
| ProgramBench | 20.3 | 15.5 | +4.8 puntos; +31.0% | Mejora en síntesis de programas |
| NL2Repo-Bench | 64.0 | 61.5 | +2.5 puntos; +4.1% | Mejor trabajo de lenguaje natural a repositorio |
| CyberGym | 88.1 | 83.3 | +4.8 puntos; +5.8% | Ejecución cibernética más sólida |
| HLE con herramientas | 63.9 | 60.0 | +3.9 puntos; +6.5% | Mejor razonamiento con herramientas |
| Automation-Bench | 54.8 | 43.2 | +11.6 puntos; +26.9% | Ganancia material en automatización |
| Agents’ Last Exam | 31.8 | 25.7 | +6.1 puntos; +23.7% | Comportamiento general de agentes más sólido |
| Rating de Codeforces | 3,471 | 3,348 | +123 puntos de rating | Mejora en programación competitiva |
| GPQA Diamond | 90.9 | 92.4 | −1.5 puntos | V4 Pro mantiene ventaja |
| HLE sin herramientas | 36.8; 39.1 en subconjunto de texto | 42.7 en subconjunto de texto | −3.6 puntos en el subconjunto de texto comparable | V4 Pro mantiene ventaja |

El resultado es multidimensional: V4.1 Flash es decisivamente mejor para agentes de código, operación de terminal, automatización, tareas de seguridad, uso de herramientas, visión, concurrencia y coste. La ventaja restante de V4 Pro se concentra en pruebas de razonamiento puro seleccionadas. Por tanto, las cargas de trabajo deben evaluarse por mezcla de tareas y no por una única afirmación agregada.
¿Por qué DeepSeek V4.1 Flash es más eficiente que V4 Pro?
Cómputo asimétrico de entrada y salida
V4.1 Flash activa 8B parámetros durante el procesamiento de entrada y 16B durante la generación de salida. Este diseño asimétrico se orienta a las diferentes necesidades de cómputo de prefill y decodificación, reduciendo el coste sin forzar ambas etapas a pasar por el mismo presupuesto de parámetros activos.
Huella de KV cache más pequeña
DeepSeek informa que V4.1 Flash usa un cuarto de la HBM y un octavo de la capacidad de SSD requeridas por el KV cache de la generación anterior. El gráfico publicado sitúa el KV cache global en 890 bytes por token, frente a 3.514 bytes para V4 Flash.
Entrada multimodal nativa y mayor concurrencia
V4.1 Flash puede interpretar imágenes de forma nativa y expone un límite de concurrencia documentado de 2.500, cinco veces la cifra actual de V4 Pro de 500. Estos cambios importan para agentes basados en capturas de pantalla, extracción de documentos, resolución de problemas visual y colas de producción de alto volumen.
¿Cuánto cuesta DeepSeek V4.1 Flash en comparación con V4 Pro?
El calendario oficial actual del API tarifica ambas rutas por separado. Por 1M tokens, V4.1 Flash cuesta $0.003/$0.006 para entrada con acierto de caché, $0.15/$0.30 para entrada con fallo de caché y $0.60/$1.20 para salida (fuera de pico/pico). V4 Pro cuesta $0.022/$0.044, $0.66/$1.32 y $1.98/$3.96 respectivamente. Los precios pueden cambiar, por lo que los presupuestos de producción deberían referenciar la página de precios en vivo.
¿Cómo migrar de DeepSeek V4 Pro o V4 Flash a V4.1 Flash?
Usa el ID de modelo de producción explícito
Usa deepseek-flash cuando quieras V4.1 Flash. Los nombres antiguos deepseek-v4-flash y deepseek-v4-flash-vision-exp siguen resolviendo a V4.1 Flash y se facturan al nuevo precio de Flash, pero una nomenclatura explícita facilita el monitoreo y futuras reversiones auditables. Usa deepseek-v4-pro cuando desees intencionalmente el backend V4-Pro-0813 actualmente listado.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_API_KEY",
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",  # o "deepseek-v4-pro"
    messages=[{"role": "user", "content": "Revisa este plan de migración."}],
)

print(response.choices[0].message.content)
Vuelve a probar el comportamiento, no solo la compatibilidad del endpoint
- Ejecuta prompts representativos en modos con y sin pensamiento; compara éxito de tareas, conteo de tokens y latencia.
- Vuelve a probar esquemas de herramientas, salida JSON, el comportamiento de Responses API, completado por prefijo y FIM cuando se usen.
- Añade pruebas de entrada de imagen si el producto usará la nueva capacidad visual nativa.
- Recalibra los presupuestos usando tarifas pico y fuera de pico en lugar de arrastrar supuestos de V4 Pro.
- Sigue la tasa de aciertos del caché de prompts, ya que puede dominar el coste de entrada a escala.
Elige explícitamente el backend previsto
La ruta actual deepseek-v4-pro selecciona V4-Pro-0813. Los equipos deberían registrar la versión de modelo resuelta, la fecha de evaluación, el conjunto de prompts y la ventana de precios para que las comparaciones sigan siendo reproducibles si el enrutamiento cambia de nuevo.
¿Qué cargas de trabajo se ajustan mejor a DeepSeek V4.1 Flash?
| Carga de trabajo | Elección recomendada | Motivo |
|---|---|---|
| Agentes de código y mantenimiento de repositorios | V4.1 Flash | Puntuaciones más altas en DeepSWE, ProgramBench, NL2Repo y terminal |
| Automatización impulsada por herramientas | V4.1 Flash | Puntuaciones más altas en Automation-Bench, HLE con herramientas y agentes |
| Asistentes conscientes de imágenes | V4.1 Flash | Comprensión nativa de imágenes |
| Servicio de alto rendimiento o sensible a costes | V4.1 Flash | Mayor concurrencia y precios por token mucho más bajos |
| Reproducción histórica de V4 ProAcceso y evaluación actuales de V4 Pro | V4 Pro | La ruta oficial identifica actualmente V4-Pro-0813 |
| Razonamiento puro de libro cerrado | Valida en datos de dominio | V4 Pro sigue por encima en GPQA Diamond y HLE sin herramientas |
Preguntas frecuentes: DeepSeek V4.1 Flash vs V4 Pro
¿DeepSeek V4.1 Flash es mejor que V4 Pro?
Para la mayoría de dimensiones de producción —agentes de código, tareas de terminal, automatización, uso de herramientas, visión, rendimiento y precio— sí. V4 Pro aún muestra puntuaciones publicadas más altas en GPQA Diamond y HLE sin herramientas, así que las cargas de trabajo de razonamiento puro deberían probarse con prompts específicos del dominio.
¿Todavía puedo llamar a deepseek-v4-pro?
Sí. La página actual oficial del API lista deepseek-v4-pro como V4-Pro-0813, con su propio precio y límite de concurrencia.
¿Qué ID de modelo debería usar una nueva integración?
Usa deepseek-flash para V4.1 Flash, o deepseek-v4-pro para V4-Pro-0813. No trates ambos IDs como alias.
¿Siguen funcionando los antiguos IDs de modelo V4 Flash?
DeepSeek indica que las solicitudes a deepseek-v4-flash y deepseek-v4-flash-vision-exp se enrutan automáticamente a V4.1 Flash y se facturan al nuevo precio de Flash. Aun así, se recomienda actualizar el ID de modelo configurado por claridad.
¿DeepSeek V4.1 Flash admite imágenes?
Sí. La comprensión nativa de imágenes forma parte de V4.1 Flash; el API histórico de V4 Pro no proporcionaba esta capacidad.
¿DeepSeek V4.1 Flash es más barato que el V4 Pro actual?
Sí. El calendario oficial actual lista precios más bajos para entrada con acierto de caché, entrada con fallo de caché y salida en V4.1 Flash que en V4 Pro.
¿Debo esperar salidas idénticas tras la migración?
No. La compatibilidad del endpoint no garantiza rutas de razonamiento, selección de herramientas, uso de tokens ni formato idénticos. Vuelve a ejecutar las evaluaciones de producción antes de confiar en umbrales previos.