
TL;DR
Google anunció Gemini 4 Argon el 30 de septiembre de 2026 como un modelo de frontera para flujos de trabajo complejos y de larga duración. Sus resultados publicados muestran un patrón claro: sólido rendimiento en trabajo profesional de conocimiento, tareas de largo contexto y evaluaciones seleccionadas de ingeniería de software, con resultados más débiles en algunos benchmarks de terminal y uso de computadora. Google está presentando el modelo mediante un despliegue por fases. Por separado, CometAPI informa disponibilidad en catálogo a partir del 1 de octubre; antes del despliegue, deben verificarse la elegibilidad de la cuenta y una solicitud de prueba satisfactoria. La historia de rendimiento más útil es dónde aparecen sus ganancias.
Argon obtiene 68.9% en Vals Index, 65.4% en Vals Finance Agent v2, 77.9% en DeepSWE v1.1, 91.7% en LVBench y 84.2% en GraphWalks en 256K–1M de contexto. Al mismo tiempo, queda por detrás de modelos de frontera competidores en FrontierSWE v2, Terminal-Bench 4.0, Terminal-Bench Science y OSWorld-2.0.
Los resultados favorecen una visión específica por carga de trabajo de Argon. Sus mejores puntuaciones se agrupan en torno al trabajo profesional de conocimiento, tareas de contexto muy largo y evaluaciones seleccionadas multimodales y de ingeniería de software. Otros modelos mantienen ventajas en varias pruebas de terminal y uso de computadora.
Key Takeaways
- Gemini 4 Argon es más fuerte en trabajo de conocimiento empresarial, razonamiento de largo contexto, comprensión multimodal y varias evaluaciones de codificación de horizonte largo.
- Su límite máximo de salida de 1 millón de tokens proporciona más margen de generación para trayectorias largas de razonamiento; no establece una especificación pública del contexto de entrada.
- Argon lidera varios resultados publicados de trabajo de conocimiento y contexto largo, pero GPT-6 Astra y Claude Opus 5.5 se mantienen por delante en evaluaciones seleccionadas de codificación y uso de computadora.
- Las puntuaciones de benchmark describen configuraciones particulares de modelo y agente. Las métricas, condiciones de entrada y ajustes de evaluación importan tanto como los porcentajes principales.
- El despliegue de Google y el acceso vía CometAPI son afirmaciones de disponibilidad separadas. Verifique la ruta activa, el identificador de modelo y la elegibilidad de la cuenta antes de migrar tráfico.
What Is Gemini 4 Argon?
Gemini 4 Argon es el nuevo modelo de frontera Gemini de Google DeepMind, diseñado para flujos de trabajo difíciles que requieren razonar a lo largo de muchos pasos en lugar de responder a un único prompt corto.
El posicionamiento oficial de Google enfatiza la ingeniería de software del mundo real, el trabajo empresarial de conocimiento como legal y finanzas, la ciberseguridad defensiva, la comprensión multimodal y las tareas agentizadas de larga duración.
Esta es una distinción importante respecto a los lanzamientos recientes de Flash. Gemini 3.8 Flash API en CometAPI está diseñada como un caballo de batalla de menor costo para cargas de trabajo con agentes a escala. Argon, en cambio, representa el extremo de frontera del stack de Google, priorizando la profundidad y la ejecución sostenida.
Model Specifications
| Especificación | Gemini 4 Argon |
|---|---|
| Desarrollador | Google DeepMind |
| Anunciado | 30 de septiembre de 2026 |
| Familia de modelos | Gemini 4 |
| Posicionamiento | Modelo de razonamiento de frontera y horizonte largo |
| Salida máxima | 1,000,000 tokens |
| Evaluación de contexto largo | Probado hasta 256K–1M en GraphWalks |
| Límite público de contexto de entrada | No especificado formalmente en una tabla de especificación pública de API en el lanzamiento |
| Comprensión multimodal | Sí; incluye gráficos, documentos y evaluación de video largo |
| Programación con agentes | Sí |
| Uso de computadora | Evaluado |
| Ciberseguridad | Capacidades defensivas especializadas |
| ID del modelo en la API pública de Google | No anunciado en la documentación pública inicial de Google; CometAPI usa gemini-4-argon como su identificador de catálogo. |
Output Budget and Trade-offs
Google anuncia un límite máximo de salida de 1 millón de tokens para Argon, desde el límite previo de 64K citado en su anuncio de lanzamiento. Esto proporciona margen para trayectorias de razonamiento más largas. No debe interpretarse como un presupuesto total garantizado para toda una sesión agentizada de múltiples llamadas, ni como prueba de que cada tarea mejorará.
El máximo de salida no es lo mismo que la inteligencia. Darle más tokens de salida a un modelo no lo hace automáticamente más capaz; elimina un posible cuello de botella. El modelo aún debe usar ese presupuesto de manera productiva.
También hay una compensación de costo y latencia. Un modelo que realmente consume cientos de miles de tokens generados puede ser caro y lento incluso si el precio nominal por token parece atractivo.

Resultados de benchmark seleccionados reproducidos del artículo. Compare modelos dentro de cada fila; las métricas y condiciones de evaluación difieren. Este gráfico reemplaza la obra de arte de gradiente decorativa y no representa pruebas independientes.
Un límite máximo de salida y una ventana de contexto de entrada describen capacidades diferentes. El rango de evaluación de GraphWalks aporta evidencia sobre las entradas probadas, no sustituye a una especificación pública de API.
How Does Gemini 4 Argon Perform on Benchmarks?
La tabla de rendimiento de Google DeepMind cubre flujos de trabajo de agentes, trabajo profesional de conocimiento y tareas multimodales. Los valores a continuación reproducen esa comparación publicada. Miden el desempeño en la tarea, no el caudal de tokens ni la latencia de respuesta; “—” significa que no se informa un resultado en esta comparación.
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 | Condiciones de evaluación |
|---|---|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% | Vals AI |
| AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% | Conjunto privado; clasificación de Zapier |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% | Vals AI |
| Harvey's Legal Agent | 19.6% | 5.4% | 6.7% | 3.8% | Vals AI |
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% | mini-swe harness; fuentes mixtas |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% | Proximal leaderboard |
| Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% | Vals AI leaderboard |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% | Autoevaluación / leaderboard |
| PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% | v1.1; OpenCode; 10h; one H100 |
| Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% | Verifier timeout ×6 |
| LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% | Herramientas de Linux; internet |
| RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% | Surge leaderboard |
| GraphWalks up to 128K | 99.7% | 98.7% | 91.4% | 90.6% | BFS F1; 650 elementos |
| GraphWalks 256K–1M | 84.2% | 71.8% | 65.0% | 66.8% | BFS F1; 200 elementos |
| Agent's Last Exam | 39.5% | 34.2% | — | 38.2% | Aprobación binaria; ALE-Claw; 5h |
| OSWorld-2.0 | 69.2% | 72.6% | — | — | Puntaje parcial sin conexión; mejor de 3 ejecuciones |
| Chartography | 71.6% | 71.0% | 46.2% | 66.3% | Sin herramientas; Surge leaderboard |
| LVBench | 91.7% | 87.5% | 79.7% | 83.7% | Sin herramientas; muestreo de fotogramas específico del modelo |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% | pass@1; pass@4 deshace empates |
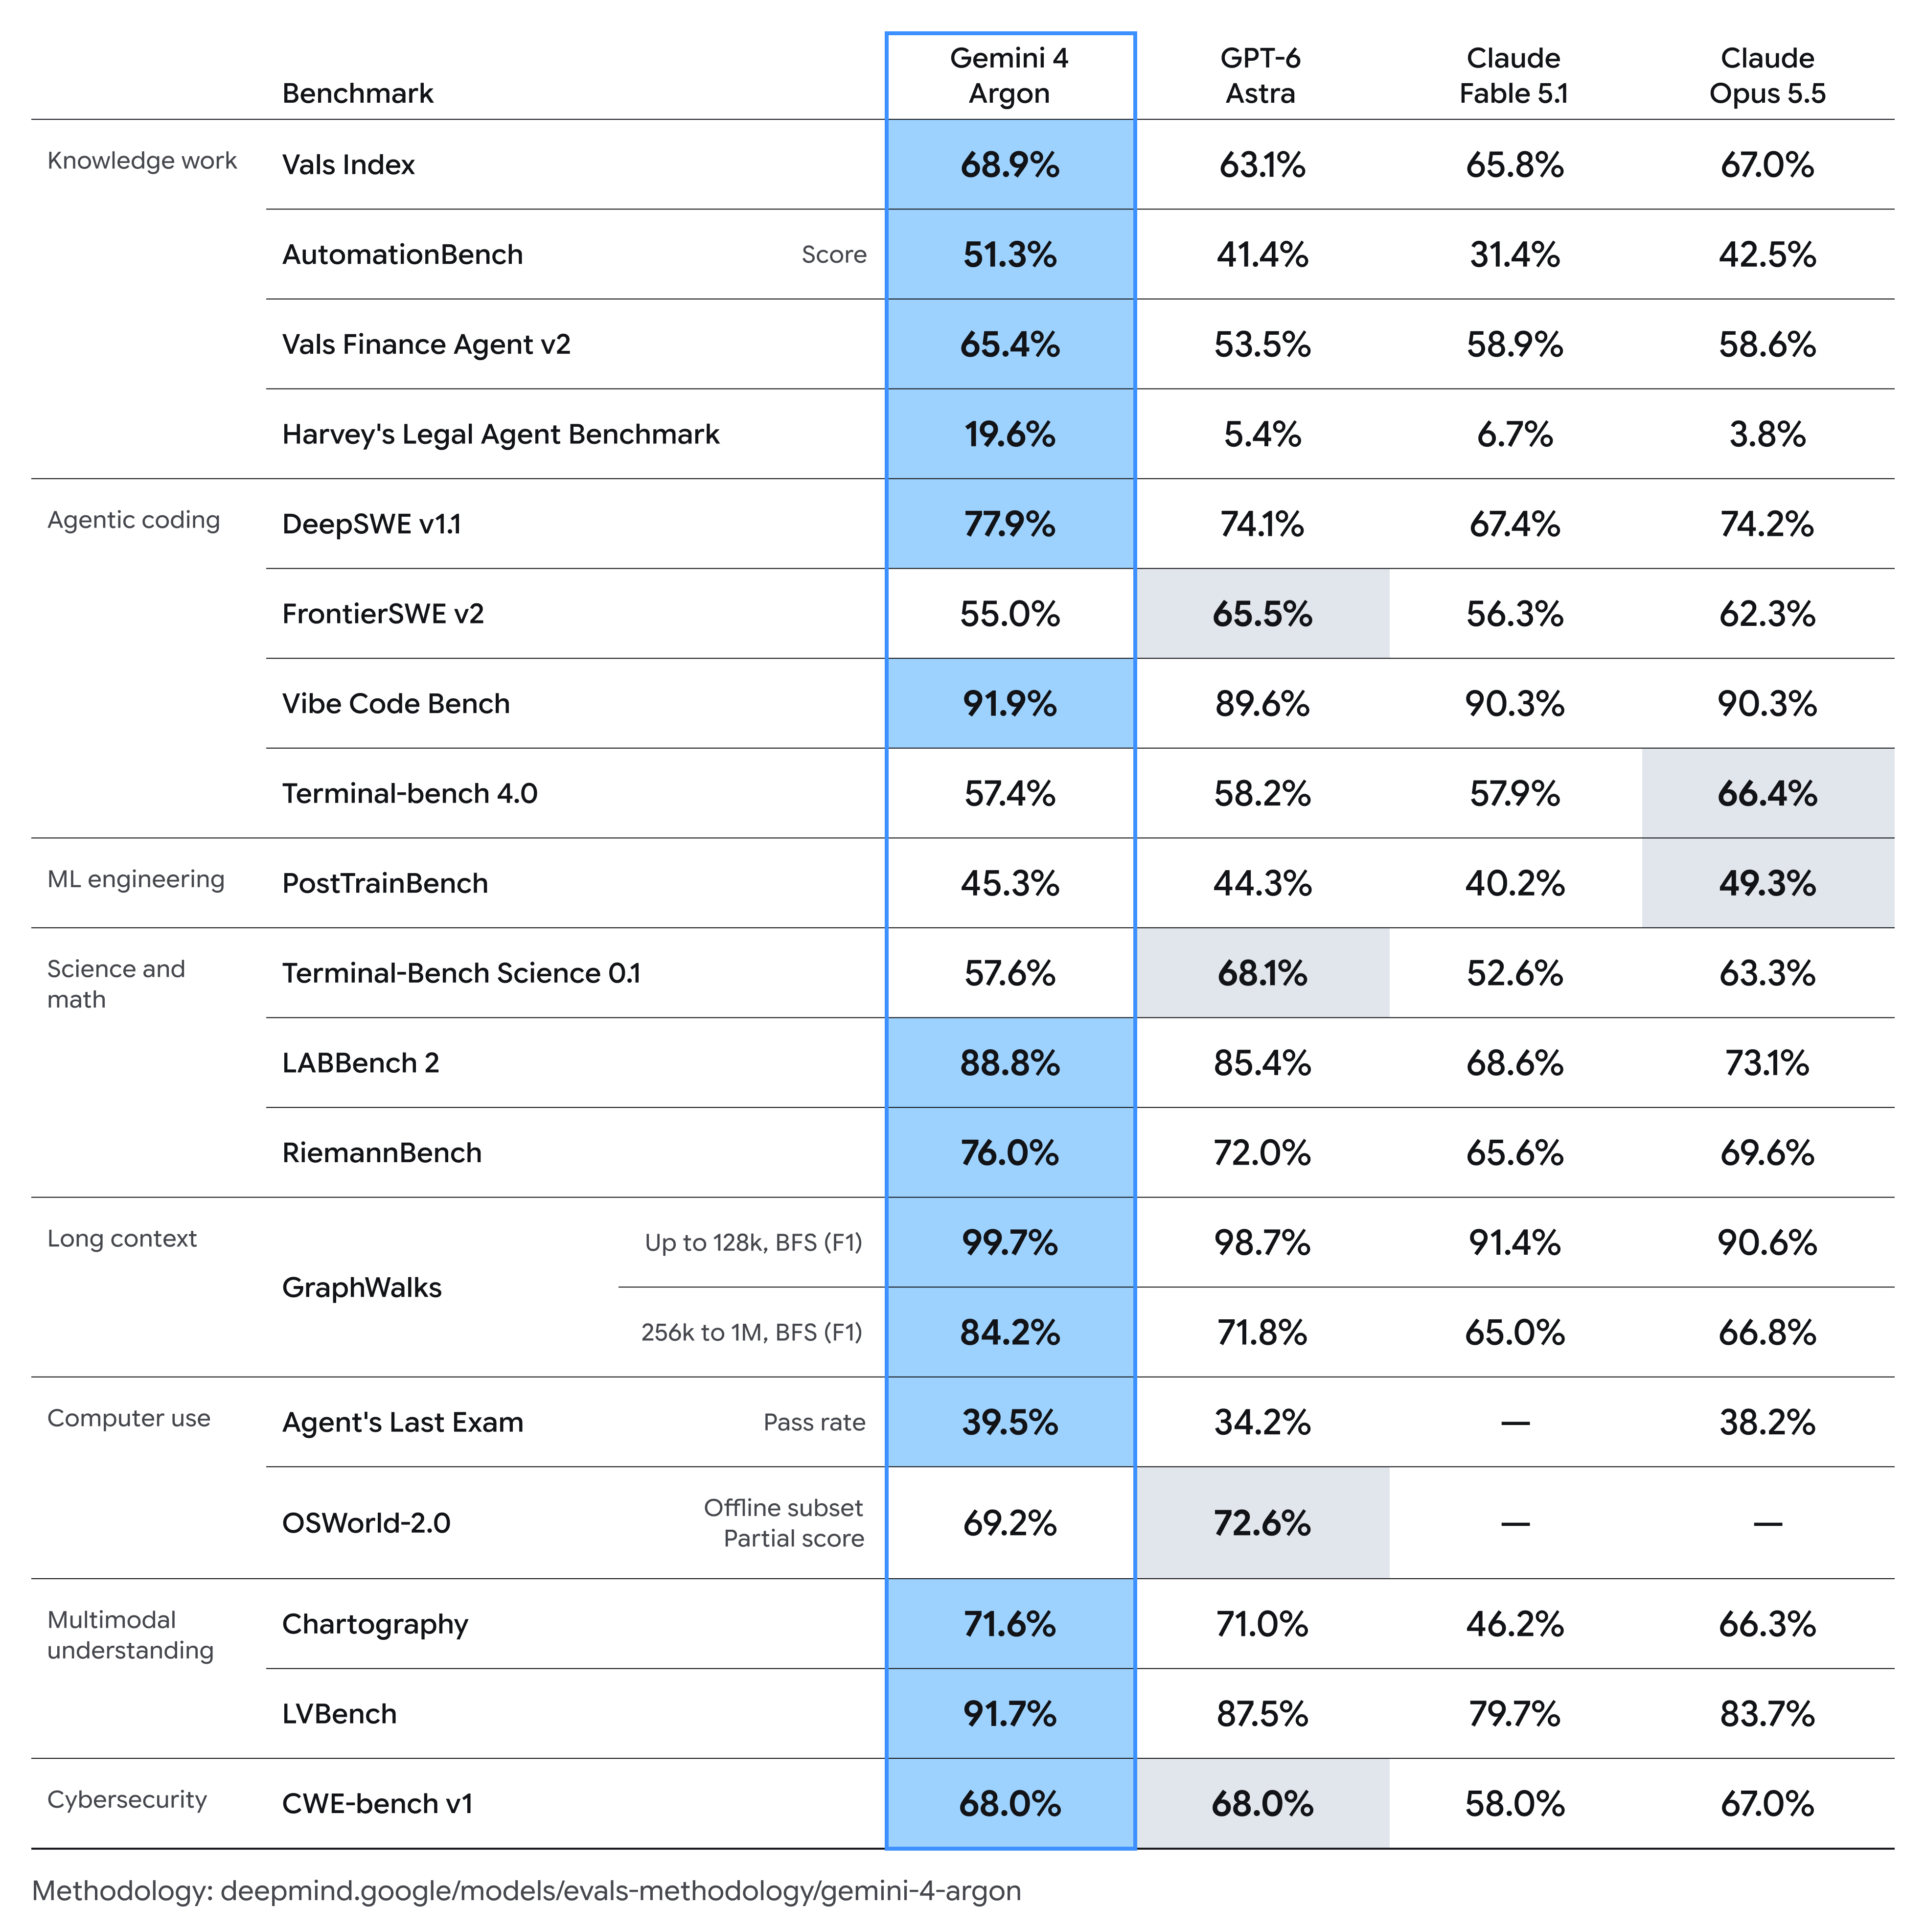
Comparación oficial de benchmarks de Gemini 4 Argon de Google
Salvo que se indique lo contrario, los resultados de Argon usan un solo intento y el ajuste de pensamiento más alto. Los resultados de otros modelos generalmente provienen de informes de los proveedores, con excepciones específicas por benchmark. LVBench usa 1 FPS para Gemini, 800 fotogramas para GPT-6 Astra, 300 para Fable 5.1 y 600 para Opus 5.5. Estas entradas no son idénticas, por lo que compare las configuraciones reportadas en lugar de tratar cada fila como una repetición controlada.
Evaluation Conditions and Limitations
La tabla es útil, pero no debe interpretarse como un ranking universal independiente.
- La selección de benchmarks es la selección de Google.
- Los ajustes específicos de evaluación por benchmark difieren entre filas, incluyendo frameworks de agentes, presupuestos de tiempo, herramientas y muestreo de entradas.
- La metodología oficial identifica los resultados de competidores reportados por los proveedores como el valor predeterminado, con excepciones de leaderboard y auto-cálculo específicas por benchmark.
- El ajuste de benchmark más alto puede no reflejar una configuración de inferencia de producción por defecto.
- Una puntuación principal de benchmark por sí sola no revela uso de tokens, llamadas a herramientas, reintentos, tiempo transcurrido ni intervención humana.
Para sistemas en producción, una métrica mejor suele ser el costo por tarea completada con éxito en lugar del precio por token o un porcentaje de benchmark.
Which Workload Is Gemini 4 Argon Best For?
Knowledge Work Performance
El patrón más claro en los resultados de Argon aparece en el trabajo profesional de conocimiento y de múltiples pasos.
En Vals Index, Argon alcanza 68.9%, frente a 67.0% de Claude Opus 5.5. La brecha numérica es modesta, pero el patrón se vuelve más evidente en flujos especializados.
- Vals Finance Agent v2: 65.4%, 6.5 puntos por encima del competidor más fuerte mostrado en la tabla de Google.
- AutomationBench: 51.3%, 8.8 puntos por encima de Claude Opus 5.5.
- Harvey's Legal Agent Benchmark: 19.6%, frente a 6.7% del siguiente modelo más alto reportado.
El perfil de rendimiento sugiere que Argon se beneficia más cuando el modelo debe recopilar información, preservar estado, razonar en varias etapas y producir un artefacto profesional en lugar de responder simplemente una pregunta cerrada.
La puntuación absoluta baja del agente legal también es importante. Un 19.6% por sí solo no revela cuántos criterios o flujos completos fallaron. La conclusión útil es que Argon muestra una gran mejora relativa en esta evaluación, mientras que el resultado no establece una automatización fiable del trabajo legal.
Long-Context Reasoning
La ventaja más llamativa de Argon puede ser la versión de 256K–1M de GraphWalks.
- Gemini 4 Argon: 84.2%
- GPT-6 Astra: 71.8%
- Claude Opus 5.5: 66.8%
- Claude Fable 5.1: 65.0%
Eso es una ventaja de 12.4 puntos sobre el modelo más cercano en la comparación publicada.
La brecha es mucho menor en longitudes de contexto más cortas: en GraphWalks hasta 128K, Argon obtiene 99.7% y GPT-6 Astra 98.7%. Esto sugiere que Argon se degrada menos bruscamente que los modelos comparados en esta evaluación particular de contexto muy largo.
Lo que Google no ha divulgado es suficiente información arquitectónica para atribuir esta diferencia a un mecanismo de atención específico, un sistema de recuperación, una receta de entrenamiento o una estrategia de inferencia. Afirmaciones como “Gemini 4 introduce una nueva arquitectura de atención” irían más allá de la evidencia pública.
Coding Performance
La tabla oficial de benchmarks no respalda un simple sí.
Argon rinde extremadamente bien en algunas formas de programación y pierde claramente en otras. En DeepSWE v1.1 alcanza 77.9%, frente a 74.2% de Claude Opus 5.5 y 74.1% de GPT-6 Astra. Su puntuación en Vibe Code Bench también es fuerte con 91.9%.
- FrontierSWE v2: 55.0% Argon vs. 65.5% GPT-6 Astra.
- Terminal-Bench 4.0: 57.4% Argon vs. 66.4% Claude Opus 5.5.
- Terminal-Bench Science 0.1: 57.6% Argon vs. 68.1% GPT-6 Astra.
Esta división es importante para desarrolladores. Argon parece especialmente fuerte cuando la programación se convierte en un flujo de ingeniería largo con contexto y planificación sustanciales, mientras que la ejecución intensiva en terminal sigue siendo más competitiva. Un benchmark de migración de repositorio y un benchmark de terminal interactivo no deben tratarse como medidas intercambiables de “capacidad de programación”.
Defensive Cybersecurity
La ciberseguridad es un área central de despliegue. El posicionamiento de ciberseguridad defensiva de Google incluye descubrimiento, validación y parcheo autónomos de vulnerabilidades. Esta es una afirmación de capacidad del proveedor; el resultado de CWE-bench a continuación mide la remediación de vulnerabilidades en su propia evaluación.
En CWE-bench v1, Argon obtiene 68%, empatado con GPT-6 Astra y ligeramente por delante de Claude Opus 5.5 con 67%.
Google también destaca salvaguardas más fuertes frente a uso indebido, inyección indirecta de prompts, comportamientos riesgosos de agentes y compromiso del entorno de ejecución. Esto convierte a Argon tanto en un lanzamiento de seguridad para agentes como en una actualización convencional del modelo.
Multimodal Understanding
Argon obtiene 71.6% en Chartography y 91.7% en LVBench para comprensión de video largo. El resultado de LVBench está 4.2 puntos porcentuales por encima de GPT-6 Astra en la tabla de Google. Dado que los modelos reciben configuraciones de muestreo de fotogramas diferentes, esta es una comparación de las configuraciones reportadas más que una ventaja puramente del modelo.
Esto importa porque muchos flujos de trabajo profesionales no son solo texto. Un agente de investigación financiera puede necesitar inspeccionar un gráfico; un asistente empresarial puede combinar informes, PDF y capturas de pantalla; un sistema de análisis de video puede necesitar preservar eventos a lo largo de una secuencia larga en lugar de procesar fotogramas individuales de forma independiente.
La combinación de percepción multimodal y razonamiento sostenido de Argon es por lo tanto más relevante que el soporte multimodal por sí solo.
Science and Mathematics Performance
Los resultados son mixtos pero generalmente sólidos. Argon alcanza 88.8% en LABBench 2 y 76.0% en RiemannBench, por delante de los modelos comparados en la tabla de Google. Sin embargo, en Terminal-Bench Science 0.1, GPT-6 Astra alcanza 68.1% frente a 57.6% de Argon.
Esa diferencia apunta a un patrón más amplio: Argon parece más fuerte al razonar sobre información científica que en todas las formas de ejecución científica impulsada por herramientas.
Computer-Use Performance
En Agent's Last Exam, Argon obtiene una tasa binaria de aprobación de 39.5%, por delante de GPT-6 Astra con 34.2% y de Claude Opus 5.5 con 38.2%. En el subconjunto sin conexión de OSWorld-2.0, su puntaje parcial es 69.2%, por debajo del 72.6% de GPT-6 Astra. El valor de OSWorld no es una tasa de éxito de tarea completa, y las entradas faltantes de Claude no implican capacidad nula.
Así que los datos actuales no muestran una ventaja generalizada en uso de computadora. Para despliegue en producción, las puntuaciones de benchmark deben complementarse con pruebas a nivel de tarea de la precisión de navegación, clics fallidos, frecuencia de reintentos, acciones no deseadas, tiempo hasta la finalización y tasa de corrección humana.
Gemini 4 Argon vs GPT-6 Astra and Claude
| Dimensión | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|
| Trabajo de conocimiento | Muy fuerte | Fuerte | Muy fuerte | Fuerte |
| Benchmark de contexto largo | Resultado publicado más fuerte | Fuerte | Moderado–fuerte | Moderado |
| Codificación de horizonte largo | Muy fuerte | Muy fuerte | Muy fuerte | Fuerte |
| Codificación en terminal | Competitivo | Fuerte | Más fuerte en prueba seleccionada | Competitivo |
| Agentes científicos en terminal | Competitivo | Más fuerte en prueba seleccionada | Fuerte | Competitivo |
| Comprensión multimodal | Muy fuerte | Muy fuerte | Fuerte | Competitivo |
| Uso de computadora | Competitivo | Fuerte | Mixto / comparación limitada | Comparación limitada |
| Ciberseguridad | Empatado en la cima en CWE-bench v1 | Empatado en la cima | Muy cercano | Inferior |
Argon destaca en esta comparación por el trabajo agentizado de contexto largo, pesado en documentos y profesional. Los desarrolladores pueden compararlo con GPT-6 Astra, Claude Opus 5.5 y Claude Fable 5.1 a través de CometAPI.
Performance-based selection
Las etiquetas cualitativas anteriores resumen la tabla de benchmarks seleccionada, no un ranking universal. Favorezca Argon para un piloto cuando el trabajo se parezca a sus evaluaciones líderes; pruebe Astra y Opus en cargas de trabajo intensivas en terminal antes de seleccionar un valor por defecto.
Specifications and deployment constraints
Esta comparación de rendimiento no establece una ventaja de arquitectura ni un ganador general en precio-rendimiento. El conteo de parámetros y la arquitectura de Argon no están especificados en los materiales de lanzamiento revisados de Google. Su límite público de contexto de entrada requiere documentación oficial de la API. CometAPI informa una ruta gemini-4-argon; confirme sus parámetros soportados y el acceso de la cuenta de forma independiente al despliegue más amplio de Google. Compare los límites de cada ruta y los costos reales por tarea antes de desplegar.
How Can Developers Access Gemini 4 Argon Through CometAPI?
CometAPI informa que el modelo está disponible bajo gemini-4-argon. Use el panel de la cuenta para crear una clave de API, seleccione ese identificador en el playground y ejecute una solicitud de prueba antes de la integración. Su ejemplo compatible con OpenAI usa la URL base https://api.cometapi.com/v1. Confirme el endpoint y los parámetros soportados del modelo en la documentación de la cuenta; una insignia de catálogo por sí sola no verifica una llamada exitosa.
- Cree una cuenta en CometAPI y genere una clave de API en el panel.
- Elija gemini-4-argon y valide una solicitud representativa en el playground.
- Configure el cliente compatible con la URL base de CometAPI, su clave y el identificador del modelo; confirme el esquema de solicitud soportado y la facturación antes del despliegue.
CometAPI y precios oficiales
Google anunció un precio introductorio de $2 por millón de tokens de entrada y $10 por millón de tokens de salida, con entrada en caché al 95% de descuento sobre la tarifa de entrada. Tras el periodo introductorio, las tarifas anunciadas son $4 de entrada y $20 de salida por millón de tokens. Estas son tarifas anunciadas por Google, no precios de CometAPI ni confirmación de acceso general inmediato a la API.
| Base de facturación | API de Gemini 4 Argon en CometAPI | Anuncio oficial de Google | Comparación |
|---|---|---|---|
| Entrada / 1M de tokens | $3.20 | $4.00 tras el periodo introductorio | 20% por debajo de la tarifa anunciada posterior al periodo introductorio |
| Salida / 1M de tokens | $16.00 | $20.00 tras el periodo introductorio | 20% por debajo de la tarifa anunciada posterior al periodo introductorio |
Conclusion
El perfil de benchmarks de Gemini 4 Argon es más interesante que una simple afirmación de tabla de posiciones.
Los resultados más fuertes en esta comparación se agrupan en torno al trabajo profesional de conocimiento, el contexto largo y la ejecución agentizada sostenida. Este patrón es útil para seleccionar cargas de trabajo, pero no identifica la arquitectura subyacente ni prueba qué mecanismo causó las ganancias.
Los resultados reportados en finanzas, legal, video largo e ingeniería de software respaldan un piloto enfocado para esas cargas. Que la misma ventaja persista en producción depende de la mezcla de entradas, el framework de agentes, los ajustes de inferencia y los requisitos de verificación.
Al mismo tiempo, los resultados muestran que el rendimiento de los modelos de frontera se está volviendo cada vez más especializado. Argon puede liderar DeepSWE mientras queda por detrás en FrontierSWE; liderar Agent's Last Exam mientras queda por detrás en OSWorld; y liderar LABBench mientras queda por detrás en Terminal-Bench Science. Estos benchmarks estresan partes diferentes de un sistema de agentes.
Para los desarrolladores, la lección más importante es que la selección de modelos necesita ocurrir cada vez más a nivel de carga de trabajo en lugar de a nivel de marca o familia.
FAQ
How should developers validate Gemini 4 Argon on their own workloads?
Construya un conjunto de tareas representativo con criterios de aceptación explícitos. Mantenga comparables entre modelos las herramientas, límites de tiempo, preparación de entradas y políticas de reintento. Registre tareas completadas, tokens totales, tiempo transcurrido y corrección humana. Comience con un piloto pequeño y examine los casos de fallo antes de enrutar tráfico de producción.
Can Gemini 4 Argon's benchmark percentages be averaged into one score?
No. La tabla combina métricas diferentes, incluyendo F1, tasas de aprobación y puntajes parciales. Use criterios específicos por tarea en lugar de promediar todos los porcentajes.
Should a Gemini 4 Argon agent always use its full output budget?
No. Elija el presupuesto más pequeño probado que cumpla sus requisitos de calidad y fiabilidad. El límite máximo de salida es un techo, no un objetivo.
How should teams evaluate Gemini 4 Argon access through CometAPI?
Comience con una verificación de disponibilidad a nivel de cuenta y una pequeña solicitud usando la ruta documentada de CometAPI. Mida la calidad de la respuesta, la latencia, los límites y los tokens facturados, luego aplique las mismas pruebas de aceptación usadas para modelos alternativos. Trate la afirmación de acceso de CometAPI por separado del despliegue más amplio de Google y mantenga el enrutamiento configurable hasta que la ruta cumpla sus requisitos.