
Resumen
Empiece con GPT-6.1 Sol si ya usa las herramientas Responses de OpenAI o necesita su escala explícita de esfuerzo de razonamiento; pruebe Claude Sonnet 5.5 para iteración de código bien delimitada y entregables profesionales guiados por plantillas. Estas son prioridades de evaluación, no un ranking de calidad probado. Ambos parten de $2/M de entrada y $10/M de salida y cobran $0.10/M por lecturas de caché base. Con aproximadamente 1M de contexto y 128K de salida máxima estándar, las diferencias prácticas son la integración, el comportamiento de la tarea, la retención de caché y la facturación de contexto largo, más que un descuento en la lectura de caché base.
La disyuntiva clave es el comportamiento de la tarea y las condiciones de facturación. GPT-6.1 Sol usa cinco niveles de esfuerzo y requiere Responses para llamadas a herramientas; Sonnet 5.5 usa pensamiento adaptativo. Por encima de 272K tokens de entrada, GPT-6.1 Sol aplica tarifas más altas a toda la solicitud. Las fuentes revisadas aquí no establecen un ganador con versiones exactas y emparejadas, así que seleccione el modelo que cumpla sus criterios de aceptación con el costo total de flujo de trabajo más bajo.
Puntos clave
- Precios base iguales: ambos modelos cobran $2/M de entrada, $10/M de salida y $0.10/M por lecturas de caché. Compare escrituras de caché, retención, niveles de contexto largo y uso realmente facturado.
- El contexto es similar: 1.05M frente a 1M tokens; ambos admiten 128K de salida máxima estándar.
- La integración difiere: GPT-6.1 Sol requiere Responses para llamadas a herramientas y no acepta none o minimal effort; Sonnet 5.5 usa pensamiento adaptativo y restricciones de herramientas específicas del modelo.
- Mantenga la evidencia específica de versión: las puntuaciones de GPT-6 Sol no pueden etiquetarse como resultados de GPT-6.1 Sol.
- Elija por trabajo completado: mida calidad, latencia, reintentos, escrituras y lecturas de caché, tarifas de herramientas y corrección humana.
GPT-6.1 Sol vs Claude Sonnet 5.5 de un vistazo
| Factor de decisión / especificación | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| Proveedor | OpenAI | Anthropic |
| Fecha de lanzamiento | September 29, 2026 | September 28, 2026 |
| ID del modelo | gpt-6.1-sol | claude-sonnet-5-5 |
| Contexto / salida máxima estándar | 1,050,000 / 128,000 tokens | 1,000,000 / 128,000 tokens |
| Entrada → salida | Texto e imágenes → texto | Texto e imágenes → texto |
| Controles de razonamiento | low, medium, high, xhigh, max; medium por defecto | Pensamiento adaptativo; high por defecto en Claude Platform |
| Esfuerzo por defecto | medium | high en Claude Platform |
| Fecha de corte de conocimiento | April 30, 2026 | June 2026 |
| Precio base oficial entrada/salida por 1M | $2 / $10; solicitudes Standard con hasta 272K tokens de entrada | $2 / $10 |
| Lecturas de caché base oficiales por 1M | $0.10 | $0.10 |
| Escrituras de caché base oficiales por 1M | $2.50 | $2.50 por 5 minutos; $4.00 por 1 hora |
| Facturación de contexto largo | Por encima de 272K de entrada: $4 entrada, $0.20 lectura de caché, $5 escritura de caché, $15 salida por 1M; aplica a toda la solicitud Standard | No hay recargo equivalente indicado en la sinopsis del modelo citada |
| Posicionamiento principal | Programación compleja, uso de computadora y trabajo profesional | Iteración de código rápida y flujos de trabajo profesionales |
| Probar primero cuando | Ya usa herramientas Responses o necesita controles explícitos de esfuerzo | Su trabajo se centra en código, documentos, diapositivas o hojas de cálculo |
| Límite de evidencia y decisión | Capacidades documentadas; aquí no se establece un ganador numérico de versión exacta emparejada | Resultados publicados en código y trabajo de conocimiento; no es una victoria controlada sobre GPT-6.1 Sol |
Panorama de GPT-6.1 Sol
GPT-6.1 Sol es la versión Sol de OpenAI del 29 de septiembre de 2026 para programación compleja, uso de computadoras y trabajo profesional. OpenAI lo describe como rendimiento cercano a Astra a menor costo; ese posicionamiento debe validarse en sus tareas. Su gran contexto y razonamiento ajustable lo convierten en candidato para agentes de repositorios y flujos profesionales de múltiples pasos.
Sus restricciones operativas importan tanto como su posicionamiento: medium es el esfuerzo por defecto, low es el nivel mínimo admitido, y las llamadas a herramientas requieren Responses. Un flujo de trabajo basado en una ruta sin razonamiento o en herramientas de Chat Completions necesita trabajo de migración antes de usar este modelo de forma fiable.
Panorama de Claude Sonnet 5.5
Claude Sonnet 5.5 es la versión de Anthropic del 28 de septiembre de 2026 para programación cotidiana bien delimitada, agentes y trabajo profesional. Su sinopsis del modelo documenta pensamiento adaptativo, esfuerzo por defecto alto en Claude Platform, entrada de texto e imagen y 128K de salida máxima estándar. Anthropic enfatiza corrección de bugs, documentos claros, diapositivas pulidas e iteración eficiente.
Para un equipo de desarrollo, eso convierte a Sonnet en un candidato útil para ciclos repetidos de implementación y revisión. Para un flujo de oficina, evalúe su calidad de primer borrador y adherencia a plantillas. La afirmación de velocidad del proveedor compara Sonnet 5.5 con Sonnet 5; no establece una ventaja de velocidad sobre GPT-6.1 Sol.
GPT-6.1 Sol vs Claude Sonnet 5.5: Rendimiento
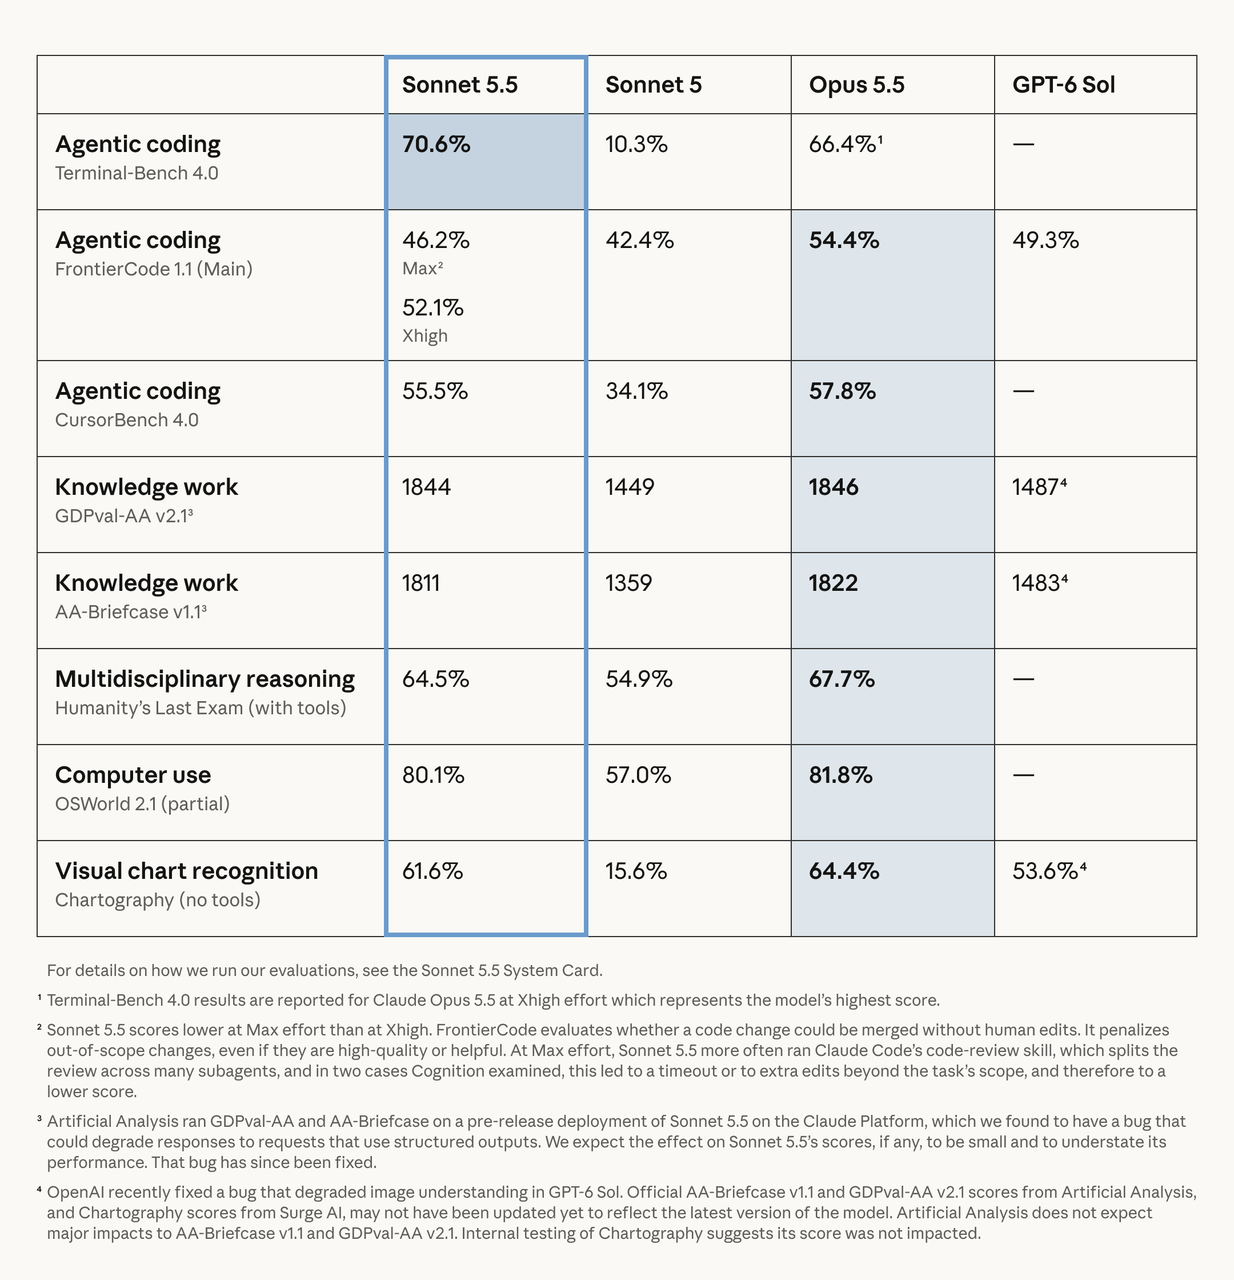
Los resultados de lanzamiento de Sonnet 5.5 de Anthropic brindan un conjunto útil de señales de carga de trabajo. Su comparación incluye el anterior GPT-6 Sol, por lo que esos valores de la columna de OpenAI se excluyen de la tabla de modelo actual a continuación. “No establecido aquí” significa que las fuentes citadas no respaldan una puntuación con versión exacta para esta comparación; no significa cero rendimiento.
| Benchmark / condiciones | GPT-6.1 Sol | Claude Sonnet 5.5 | Qué mide |
|---|---|---|---|
| Terminal-Bench 4.0 | No establecido aquí | 70.6% | Tareas de terminal de programación |
| FrontierCode 1.1 Main | No establecido aquí | 52.1% Xhigh; 46.2% Max | Cambios mergeables en repositorios |
| CursorBench 4.0 | No establecido aquí | 55.5% | Desarrollo agentico en tareas de Cursor |
| GDPval-AA v2.1 | No establecido aquí | 1844 | Trabajo profesional de conocimiento |
| AA-Briefcase v1.1 | No establecido aquí | 1811 | Trabajo de conocimiento de largo horizonte |
| Humanity’s Last Exam, tools | No establecido aquí | 64.5% | Razonamiento multidisciplinario |
| OSWorld 2.1, partial | No establecido aquí | 80.1% | Recompensa parcial de uso de computadora |
| Chartography, no tools | No establecido aquí | 61.6% | Reconocimiento visual de gráficos |
Condiciones de prueba: el esfuerzo y el harness del agente afectan los resultados de programación. GDPval-AA y AA-Briefcase son evaluaciones de Artificial Analysis, mientras que los resultados de Chartography provienen de Surge AI. Anthropic señala un bug posterior corregido de salida estructurada en el despliegue previo de Sonnet que pudo haber subestimado ligeramente sus resultados de trabajo profesional. Use el enlace de la System Card del anuncio para entornos de prueba y metodología completa; no combine métricas dispares en un único ranking general.
La imagen original de Anthropic a continuación incluye sus notas de evaluación. Su columna de GPT-6 Sol es solo contexto histórico y no informa el rendimiento de GPT-6.1 Sol.
Programación basada en agentes e ingeniería de software
Sonnet 5.5 tiene evidencia reportada en programación de terminal, cambios de código mergeables y tareas de agente estilo IDE. GPT-6.1 Sol está documentado para programación compleja y se integra con el ecosistema de herramientas de OpenAI. Ni el posicionamiento del producto ni la puntuación de un predecesor establecen un ganador de programación actual. Para una evaluación útil, elija cambios reales con pruebas de regresión y pida a los revisores que evalúen alcance, mantenibilidad y preparación para hacer merge.
Trabajo de conocimiento, razonamiento, matemáticas y ciencia
Los resultados de GDPval-AA y AA-Briefcase de Sonnet convierten informes, análisis y entregables de oficina en objetivos de evaluación sensatos. GPT-6.1 Sol también se orienta al trabajo profesional, pero las fuentes usadas aquí no brindan una comparación emparejada entre estos modelos. Use sus propias plantillas de documentos, hojas de cálculo y presentaciones. Las afirmaciones de matemáticas avanzadas y ciencias requieren evidencia específica por tarea, en lugar de extrapolación a partir de controles generales de razonamiento.
Uso de computadora, automatización del navegador y flujos multimodales
Ambos modelos aceptan imágenes, lo que respalda depuración con capturas de pantalla y análisis visual. Los resultados de OSWorld y Chartography de Sonnet son evidencia para esas evaluaciones particulares. GPT-6.1 Sol documenta uso de computadora mediante herramientas de Responses. Pruebe el flujo completo: precisión de navegación, recuperación tras una llamada de herramienta fallida, corrección de la salida y tiempo hasta la finalización. La entrada de texto e imagen no garantiza por sí sola una integración de uso de computadora idéntica.
Evaluación independiente y calidad de la evidencia
Una tabla publicada por un proveedor puede contener resultados de terceros sin convertirse en un experimento controlado único. Para cualquier comparación independiente, registre los IDs exactos de modelo, fechas de despliegue, esfuerzo, herramientas, salvaguardas, tiempo de espera, política de reintento y reglas de parada. Un índice de inteligencia agregado, una tasa de éxito de programación y una puntuación de recompensa parcial de uso de computadora responden a preguntas diferentes. Las fuentes revisadas no establecen un conjunto completo de resultados independientes emparejados para este par exacto.
GPT-6.1 Sol vs Claude Sonnet 5.5: Costo
Precios oficiales de API
| Métrica de precios | Tarifas oficiales de GPT-6.1 Sol | Tarifas oficiales de Claude Sonnet 5.5 |
|---|---|---|
| Entrada / 1M tokens, base Standard | $2.00 | $2.00 |
| Salida / 1M tokens, base Standard | $10.00 | $10.00 |
| Lectura de caché / 1M tokens, base | $0.10 | $0.10 |
| Escritura de caché / 1M tokens, base | $2.50 | $2.50 por 5m; $4.00 por 1h |
| Procesamiento por lotes | 50% por debajo de Standard | 50% de descuento en entrada/salida |
| Entrada por encima de 272K, solicitud Standard completa | $4 entrada / $0.20 lectura de caché / $5 escritura de caché / $15 salida | No hay recargo equivalente indicado en la sinopsis citada |
Todas las tarifas son USD por millón de tokens. Las lecturas de caché base de GPT-6.1 Sol cuestan $0.10/M y las lecturas de caché de Sonnet 5.5 también cuestan $0.10/M. La condición de Sol por encima de 272K de entrada eleva las tarifas para toda la solicitud Standard, no solo los tokens excedentes. Compare escrituras de caché, retención, niveles de contexto largo, procesamiento regional y niveles de servicio; el precio base de lectura por sí solo no da ventaja a ninguno.
Costo por tarea completada
Costo por resultado aceptado = costo total en todas las tareas intentadas / número de resultados aceptados. El costo total incluye entrada nueva facturada, lecturas y escrituras de caché, salida (incluidos tokens de razonamiento facturados cuando corresponda), llamadas a herramientas pagadas y revisión o corrección humana. Los costos de reintento se cuentan según su uso real, no se suman de nuevo como un cargo duplicado.
Para un millón de tokens de lectura de caché facturados completamente a la tarifa base, cualquiera de los modelos cuesta $0.10; la diferencia de precio de lectura base es $0.00. Esto es una ilustración de tarifa, no una solicitud de Sol de un millón de tokens de entrada con precio en el nivel base. El costo real de la sesión también incluye entrada nueva, escrituras de caché, salida, herramientas y reintentos. Compare sesiones en frío y calientes bajo el nivel de contexto aplicable y reporte la tasa de resultados aceptados junto al uso facturado.
Precios de CometAPI
| Nivel publicado de CometAPI | API de GPT-6.1 Sol en CometAPI | API de Claude Sonnet 5.5 en CometAPI |
|---|---|---|
| Entrada/salida base por 1M | $1.60 / $8.00 | $1.60 / $8.00 |
| Descuento base vs proveedor | 20% | 20% |
| Entrada/salida de contexto largo GPT | $3.20 / $12.00 | Verifique términos específicos de la ruta actual |
| Lecturas de caché GPT, base/largo | $0.08 / $0.16 | No especificado en la tabla básica citada |
Estos son los precios publicados por ruta de modelo verificados para esta revisión, separados de las tarifas del proveedor. La tarificación de CometAPI para GPT-6.1 Sol distingue contexto corto y largo. La tabla básica citada de Sonnet lista entrada y salida, por lo que no justifica asumir una política de caché de gateway idéntica. Verifique los términos de facturación actuales de la ruta seleccionada antes de estimar una sesión de producción.
¿Cómo se comparan las ventanas de contexto, la velocidad y las especificaciones técnicas?
GPT-6.1 Sol admite 1.05M tokens, mientras que Claude Sonnet 5.5 admite 1M tokens. La diferencia nominal es de solo ~5%, por lo que la capacidad de contexto por sí sola es poco probable que decida la mayoría de despliegues.
La escala de esfuerzo de GPT-6.1 Sol es low, medium, high, xhigh y max; medium es el valor por defecto. Sonnet 5.5 usa pensamiento adaptativo con high como valor por defecto en Claude Platform. Esos nombres no implican presupuestos de razonamiento iguales. A requisitos de calidad iguales, mida el tiempo hasta el primer token, el throughput de salida, la latencia del bucle de herramientas y la finalización de extremo a extremo por separado.
Anthropic reporta más de 30% de generación de salida más rápida para Sonnet 5.5 que para Sonnet 5. Trátelo como una comparación con el predecesor. La evidencia de este artículo no establece un número universal de latencia para GPT-6.1 Sol ni un ganador directo de velocidad entre los modelos actuales. Para cargas interactivas, pruebe ajustes de esfuerzo más bajos con el mismo criterio de aceptación en lugar de asumir que max es la mejor configuración de despliegue.
¿Qué importa para seguridad, alineación y despliegue?
Las decisiones de despliegue deben distinguir el comportamiento documentado del modelo de los controles de la aplicación. Una comparación de modelos por sí sola no puede establecer qué despliegue cumple con los requisitos de manejo de datos o acceso de su organización. Evalúe el proveedor o gateway que realmente usa, incluyendo registro de solicitudes, residencia de datos, permisos de herramientas y manejo de fallos.
- Migración de razonamiento: GPT-6.1 Sol no admite none o minimal. La guía de migración de OpenAI dirige los flujos de trabajo con llamadas a herramientas a Responses.
- Comportamiento de herramientas en Claude: los cambios de compatibilidad documentados de Sonnet 5.5 incluyen modos de herramienta forzada no admitidos y bloques de pensamiento ligados a la conversación. Pruebe estas rutas antes del despliegue.
- Controles operativos: proporcione a los agentes solo las herramientas necesarias para la tarea, registre las llamadas fallidas y mantenga revisión humana para acciones externas de consecuencia. Estas son decisiones de diseño de aplicación, no ventajas medidas de ninguno de los modelos.
GPT-6.1 Sol vs Claude Sonnet 5.5: ¿Cuál debería elegir?
Pruebe primero GPT-6.1 Sol cuando ya use herramientas Responses o necesite una escala de esfuerzo predecible. Pruebe Sonnet 5.5 para iteración de código bien delimitada, diapositivas, hojas de cálculo y flujos de documentos donde su evidencia reportada coincida con sus tareas. Para sesiones con prefijos cacheados, pruebe ambos: sus tarifas base de lectura de caché son iguales, mientras que los costos de escritura, retención, niveles de contexto largo y éxito de la tarea pueden cambiar la factura total. Enrute el trabajo solo después de que evaluaciones representativas establezcan una diferencia útil en calidad, costo o latencia.
Selección basada en carga de trabajo
| Carga de trabajo | Punto de partida | Qué verificar |
|---|---|---|
| Agente OpenAI Responses existente | GPT-6.1 Sol | Compatibilidad de herramientas y cambios de esfuerzo |
| Iteración de código / corrección de bugs | Sonnet 5.5, luego compare con Sol | Preparación para merge, latencia y reintentos |
| Diapositivas / hojas / informes | Sonnet 5.5, luego compare con Sol | Adherencia a plantillas y tiempo de edición humana |
| Sesiones con prefijo estable en caché | Ambos; tarifas base iguales de lectura de caché | Tasa de acierto, escrituras, nivel de contexto y calidad aceptada |
| Solicitudes completas >272K entrada | Ambos | Factura real de contexto largo y calidad de recuperación |
| Automatización de computadora/navegador | Ambos | Recuperación, finalización de tareas y permisos |
| Matemáticas / análisis científico | Ambos en pruebas específicas | Corrección con respuestas verificables |
| Producción sensible a costos | Ambos | Costo total por resultado aceptado |
Una comparación en producción debe mantener constante el sistema circundante. Use los mismos prompts, repositorios o documentos, permisos de herramientas, tiempos de espera, política de reintentos y criterio de aceptación de salida.
Registre entrada nueva, escrituras y lecturas de caché, uso de salida, llamadas a herramientas pagadas, reintentos, tiempo de revisión humana, éxito de tareas y latencia de extremo a extremo. Una primera respuesta más barata aún puede producir un resultado aceptado más caro.
¿Cómo puede acceder a GPT-6.1 Sol y Claude Sonnet 5.5?
Los desarrolladores pueden acceder a la API de GPT-6.1 Sol en CometAPI y a la API de Claude Sonnet 5.5 en CometAPI a través de las rutas de modelo documentadas. Cree una clave de API, guárdela de forma segura y verifique el acceso al modelo y la facturación específica de la ruta antes del uso en producción.
Acceso a GPT-6.1 Sol
Para Sol, use la ruta Responses documentada cuando se requieran llamadas a herramientas. Seleccione gpt-6.1-sol y un nivel de esfuerzo admitido, con medium como valor por defecto. Pase la entrada de la tarea, configure solo las herramientas necesarias y valide el texto devuelto, las llamadas a herramientas, los errores y el uso. Confirme la compatibilidad del gateway con las funciones específicas del proveedor en lugar de asumir que toda opción de OpenAI está disponible.
Acceso a Claude Sonnet 5.5
Para Sonnet, seleccione claude-sonnet-5-5 en una interfaz compatible documentada y envíe la tarea como mensajes de conversación con un presupuesto de salida apropiado. Confirme cómo esa ruta maneja el pensamiento nativo y los parámetros de herramientas; los campos de razonamiento de OpenAI no son automáticamente intercambiables con las opciones de Claude. Valide la continuación de la conversación y el manejo de errores antes del despliegue de agentes.
Una verificación de endpoint confirma conectividad, no rendimiento comparativo. Para la evaluación, alinee prompts, presupuestos efectivos de salida y razonamiento, herramientas, reintentos, tiempos de espera y criterios de aceptación; luego compare trabajo aceptado, latencia y costo total facturado.
Conclusión
GPT-6.1 Sol y Claude Sonnet 5.5 comparten las mismas tarifas base de entrada, salida y lectura de caché, con capacidad de contexto similar. Sol es un candidato natural para agentes Responses existentes y controles explícitos de esfuerzo. El pensamiento adaptativo de Sonnet y sus resultados reportados en programación y trabajo profesional lo hacen un candidato útil para entregables cotidianos. Los flujos pesados en caché requieren una comparación de sesión completa: tarifas de lectura base iguales no garantizan costos iguales de escritura, retención, contexto largo o tarea completada.
Elija el modelo que complete su trabajo real dentro de requisitos de calidad, latencia y costo. Mantenga separadas las puntuaciones de predecesores de la evidencia del modelo actual, calcule el nivel de contexto que usa su carga de trabajo y compare ambas rutas antes de adoptar un predeterminado.
Preguntas frecuentes
¿Pueden GPT-6.1 Sol y Sonnet 5.5 compartir un único esquema de herramienta?
Un esquema JSON común de herramienta puede ser un punto de partida, pero el soporte del endpoint, el comportamiento de herramienta forzada, los bloques de pensamiento y el manejo de respuestas difieren. Valide las llamadas a herramientas de cada modelo con pruebas de contrato para argumentos, rutas de fallo y continuación de conversación. Mantenga adaptadores específicos del modelo para opciones no admitidas en lugar de asumir que una solicitud de texto exitosa prueba compatibilidad de agentes.
¿Cómo debería igualarse el esfuerzo de razonamiento entre ambos modelos?
No trate configuraciones con nombres idénticos como presupuestos de cómputo iguales. Defina un criterio de aceptación y un límite de costo o un objetivo de latencia, luego explore los niveles de esfuerzo para cada modelo. Compare la mejor configuración que cumpla la misma restricción operativa, incluidos reintentos y corrección humana, en lugar de comparar solo los niveles más altos de ambos modelos.
¿Cuándo debería un flujo con contexto de 1M usar recuperación en su lugar?
Use recuperación cuando una tarea necesite una parte pequeña e identificable de un corpus grande y sus pruebas de recuperación muestren que el material relevante se recupera de forma consistente. Pruebe solicitudes de contexto completo cuando la evidencia esté distribuida o importen las relaciones entre archivos. Compare corrección de la respuesta, cobertura de citas, costo de entrada y latencia; un gran límite de contexto por sí solo no establece que llenar toda la ventana sea económico o fiable.
¿Cómo pueden los equipos evitar una comparación engañosa de costos de caché?
Mida ejecuciones con caché fría y caliente por separado, registre escrituras de caché además de lecturas y aplique la ventana de retención correcta y el nivel de contexto largo. Mantenga estables los prefijos compartidos y compare sesiones realistas repetidas, no solo una solicitud con descuento. Informe la tasa de aciertos y el uso total facturado para que un aparente ahorro pueda reproducirse.
¿Qué debería desencadenar una nueva evaluación de GPT-6.1 Sol vs Sonnet 5.5?
Vuelva a ejecutar el conjunto de tareas afectadas tras una actualización de despliegue, corrección de bug del proveedor, cambio de enrutamiento, cambio de herramienta o prompt, o una revisión material de precios. Registre la fecha de evaluación, ID del modelo, endpoint, esfuerzo y versión del harness. Conserve la ejecución anterior como línea base para que los cambios de calidad o latencia no se confundan con cambios en el sistema circundante.