Resumen
GPT-6.1 Sol no es un reemplazo con mayor contexto ni más caro para GPT-6 Sol. Mantiene la misma ventana de contexto de 1.05 millones de tokens, salida máxima de 128K y precios estándar de la API de $2/$10, mientras mejora la programación, el uso del ordenador, los flujos de trabajo profesionales, la fiabilidad factual y el comportamiento como agente. El cambio de precio más claro es la caché de prompts: la entrada en caché baja de $0.20 a $0.10 por millón de tokens.
El resultado práctico es que GPT-6.1 Sol no busca cambiar la forma de la API, sino obtener mucho más trabajo útil con aproximadamente el mismo presupuesto de tokens.
Puntos clave
- GPT-6.1 Sol es una actualización de capacidades de GPT-6 Sol, con la misma ventana de contexto de 1,050,000 tokens y techo de salida de 128,000 tokens.
- Los precios estándar de entrada y salida de la API se mantienen en $2/M y $10/M; la entrada en caché baja de $0.20/M a $0.10/M.
- Evaluaciones oficiales muestran mejoras en programación, uso del ordenador, automatización empresarial y flujos científicos; los resultados dependen del benchmark y del ajuste de razonamiento.
- La migración requiere revisar tanto el esfuerzo de razonamiento como la compatibilidad del endpoint: GPT-6.1 Sol no elimina ninguno y requiere Responses API para llamadas a herramientas.
- Valida el éxito de la tarea, la latencia, los aciertos reales de caché y el coste extremo a extremo antes de reemplazar un despliegue estable de GPT-6 Sol.
¿Qué es GPT-6.1 Sol y por qué llegó tan pronto después de GPT-6 Sol?
OpenAI presentó GPT-6 Sol el 22 de septiembre de 2026. Una semana después, su apéndice de system-card del 29 de septiembre anunció GPT-6.1 Sol. OpenAI presenta la nueva versión como una actualización de GPT-6 Sol en lugar de una capa de precios separada.
El breve intervalo de lanzamiento importa porque GPT-6.1 Sol no se posiciona como un nuevo nivel de producto. OpenAI mantuvo el nivel de precios Sol y centró la actualización en la capacidad para tareas difíciles, la eficiencia de costes y la fiabilidad de los agentes.
OpenAI posiciona GPT-6.1 Sol en torno a programación agentizada, uso del ordenador y trabajo profesional. La comparación importante es el éxito de la tarea a un coste dado, más que el nombre del modelo. El resumen oficial de benchmarks a continuación separa las ganancias de capacidad de las especificaciones de API no cambiadas.
Esto hace que la comparación sea inusualmente directa: GPT-6.1 Sol es principalmente una actualización de capacidad y eficiencia, más que una actualización de ventana de contexto o de precio base.
GPT-6.1 Sol vs. GPT-6 Sol: ¿Qué se mantiene igual?
Ambos modelos conservan la misma capacidad principal, las modalidades de entrada/salida admitidas y los precios estándar de entrada/salida. La tabla también registra diferencias en fechas de corte, opciones de razonamiento, llamadas a herramientas y tarifas de entradas en caché; esas diferencias no deben confundirse con especificaciones compartidas.
Especificaciones compartidas y diferencias de compatibilidad
| Especificación | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Model ID | gpt-6.1-sol | gpt-6-sol |
| Release date | Sep. 29, 2026 | Sep. 22, 2026 |
| Context window | 1,050,000 tokens | 1,050,000 tokens |
| Maximum output | 128,000 tokens | 128,000 tokens |
| Knowledge cutoff | Apr. 30, 2026 | Apr. 20, 2026 |
| Text input / output | Yes / Yes | Yes / Yes |
| Image input | Yes | Yes |
| Standard input price | $2.00 / 1M | $2.00 / 1M |
| Cached input | $0.10 / 1M | $0.20 / 1M |
| Cache write | $2.50 / 1M | $2.50 / 1M |
| Output price | $10.00 / 1M | $10.00 / 1M |
| Reasoning effort | low, medium, high, xhigh, max | none, low, medium, high, xhigh, max |
| Structured outputs | Yes | Yes |
| Function calling | Yes through Responses API; unavailable through Chat Completions | Yes through Responses API; Chat Completions only with reasoning_effort=none |
| Fine-tuning | No | No |
| Audio / video input | Not supported | Not supported |
| Native image output | Not supported; image generation is a separate tool | Not supported; image generation is a separate tool |
Las dos columnas oficiales anteriores documentan los mismos límites de contexto y salida. Estos números describen capacidad; no establecen igual precisión de recuperación ni latencia en todos los trabajos de contexto largo.
El cutoff de conocimiento avanza ligeramente, del 20 de abril al 30 de abril de 2026. Más importante, GPT-6.1 Sol ya no admite reasoning.effort="none"; sus ajustes disponibles de razonamiento empiezan en low.
Para quienes dependen de un comportamiento de latencia mínima, este detalle de compatibilidad merece pruebas porque GPT-6 Sol aún admite reasoning effort none.
Arquitectura: qué permanece sin divulgar
Ninguna de las páginas de modelo usadas para esta comparación proporciona un recuento de parámetros ni un desglose detallado de la arquitectura. El apéndice de system-card oficial dice que GPT-6.1 Sol utiliza los mismos tipos de datos y entrenamiento que Astra; esa afirmación no prueba que Sol y Astra tengan arquitecturas idénticas. Por tanto, las diferencias de arquitectura y de escala de parámetros permanecen sin divulgar en el material citado.
La tarifa base no cambia; las lecturas en caché son más baratas
Para tokens ordinarios sin caché, no. Las tarifas estándar de entrada y salida no cambian. La mejora principal de precios es la entrada en caché.
| Precios oficiales de la API — USD por 1M de tokens | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Input / 1M tokens | $2.00 | $2.00 |
| Cached input / 1M | $0.10 | $0.20 |
| Cache write / 1M | $2.50 | $2.50 |
| Output / 1M tokens | $10.00 | $10.00 |
GPT-6.1 Sol reduce la entrada en caché a $0.10 por millón de tokens, o el 5% de la tarifa de entrada sin caché.
Por ejemplo, reutilizar 100 millones de tokens de entrada en caché cuesta unos $10 en GPT-6.1 Sol frente a $20 en GPT-6 Sol. La diferencia es modesta para prompts aislados, pero más significativa para agentes de alto volumen con prefijos de prompt estables.
También aplican las condiciones oficiales de precios mostradas en la documentación del modelo: las solicitudes por encima de 272K tokens de entrada usan tarifas 2x de entrada y caché y 1.5x de salida para toda la solicitud. El modo Fast de GPT-6.1 Sol es 2x el Standard; Batch y Flex están 50% por debajo de Standard. El procesamiento regional añade un 10% donde esté disponible, y Fast no está disponible con residencia de datos en la UE. Pueden aplicarse cargos separados por herramientas. Presupuesta según el modo de procesamiento seleccionado, la región y los aciertos reales de caché.
¿Qué ha mejorado en GPT-6.1 Sol?
La mejora se evalúa mejor en programación, flujos de agentes, documentos profesionales, ciencia, factualidad y recuperación ante fallos. Las secciones siguientes agrupan esas mejoras manteniendo las condiciones y limitaciones originales de los benchmarks.
Visión general de benchmarks: mejoras reportadas y condiciones de evaluación
El argumento más sólido para GPT-6.1 Sol proviene del rendimiento a nivel de tareas más que de especificaciones brutas. OpenAI reporta mejoras en ingeniería de software, automatización empresarial, interacción con ordenador, flujos científicos, factualidad y alineación de agentes.
| Resultados oficiales de benchmarks / evaluaciones | GPT-6.1 Sol vs. GPT-6 Sol | Qué significa el cambio |
|---|---|---|
| DeepSWE v1.1 | +6.4 puntos porcentuales sobre el mejor resultado de GPT-6 Sol, con menor esfuerzo de razonamiento y coste por tarea; comparación no igualada por esfuerzo | Ingeniería de software de largo horizonte más sólida |
| AutomationBench 1.0.6 | +4.8 puntos a medium effort para ambos Sol; +2.2 puntos sobre Opus 5.5 a medium effort | Mejor ejecución de agentes de negocio multietapa |
| OSWorld 2.0 offline | +7 puntos a max effort; recompensa parcial en el set offline, release v2026.08.08; menos de la mitad del coste por tarea | Mejores flujos de uso del ordenador |
| Terminal-Bench Science 0.1 | Más del doble de la puntuación de GPT-6 Sol a max effort, con menos de la mitad del coste por tarea | Gran avance en flujos científicos de agente |
| Evaluación de factualidad difícil | A low effort, respuestas con errores caen de 11.4% a 7.7%; evaluación seleccionada de prompts difíciles | Menos errores factuales en prompts difíciles |
| Prueba de alineación con búsqueda rota | A maximum effort, la falta de divulgación de búsqueda rota baja de 4.9% a 2.1%; tareas deliberadamente adversarias | Mejor reconocimiento de fallos de herramientas |
Estos son resultados reportados por OpenAI, no mediciones independientes de CometAPI. OpenAI evaluó sus modelos en su entorno de investigación o a través de su API; el comportamiento en producción puede diferir con prompts de sistema y herramientas disponibles. Las cifras de competidores provienen de informes públicos. El coste por tarea refleja la configuración probada y no es lo mismo que el precio por token. No deben inferirse detalles no reportados como presupuestos por ejecución o andamiajes.
El resultado oficial en la tabla compara GPT-6.1 Sol con un menor esfuerzo de razonamiento frente a la mejor puntuación de GPT-6 Sol. No debe describirse como una comparación controlada e igualada por esfuerzo. DeepSWE v1.1 evalúa tareas originales de ingeniería de software de largo horizonte en bases de código reales.
Como contexto, el lanzamiento original de GPT-6 Sol reportó 68.8% a esfuerzo máximo en DeepSWE v1.1.
Programación: ingeniería de software de largo horizonte más sólida
La programación es probablemente la mejora más clara. DeepSWE v1.1 evalúa agentes en tareas originales de ingeniería de software en bases de código reales que requieren trabajo sostenido y multietapa.
La mejora de DeepSWE resumida arriba es relevante cuando un agente debe inspeccionar un repositorio, planificar cambios, usar herramientas y reparar fallos a lo largo de muchos pasos. Los desarrolladores pueden comparar esta mejora con la API de GPT-6 Astra en CometAPI al decidir si las tareas más difíciles justifican un modelo de mayor coste.
Esto importa más que un benchmark corto de código porque los agentes de programación de larga duración acumulan coste con razonamientos repetidos, llamadas a herramientas, lecturas de archivos, parches y reutilización de contexto. GPT-6.1 Sol mejora tanto la finalización de tareas como la economía de contexto repetido sin subir la tarifa estándar de $2/$10 por token.
La API de GPT-6 Sol en CometAPI sigue siendo útil para despliegues existentes y proporciona una ruta compatible con OpenAI para cargas de trabajo de programación y agentes.
Agentes de IA y flujos empresariales: automatización y uso del ordenador
Sí, y la mejora va más allá de la programación. AutomationBench evalúa si un agente puede completar flujos de trabajo extremo a extremo usando muchas herramientas en ventas, marketing, operaciones, soporte, finanzas y RR. HH.
El resultado a medium effort comparado en el resumen de benchmarks es relevante para flujos de negocio con muchas herramientas. Sigue siendo un resultado de benchmark, no una garantía de éxito en el propio stack de herramientas de una empresa. La comparación también incluye la API Claude Opus 5.5 en CometAPI; evalúa todos los candidatos con las mismas herramientas y criterios de éxito antes de seleccionar uno.
Para uso del ordenador, el resultado de OSWorld anterior usa el set offline y recompensa parcial. Una mayor puntuación de recompensa parcial no significa necesariamente que cada tarea se completara de extremo a extremo. El estado del navegador, los permisos, el comportamiento de recuperación y la calidad de la integración de herramientas siguen afectando los resultados de despliegue.
Documentos profesionales y ciencia: mayor capacidad para tareas complejas
GPT-6.1 Sol también empuja el nivel Sol más hacia el trabajo profesional del conocimiento. OpenAI evalúa la comprensión de documentos complejos con GDP.pdf, donde los modelos responden preguntas realistas basadas en PDFs con tablas, gráficos, diagramas, formato denso y letra pequeña en campos como finanzas, salud y derecho.
GDP.pdf aporta evidencia para análisis profesional de PDFs más allá de preguntas y respuestas sólo de texto. Considera su resultado en el anuncio de lanzamiento como una evaluación de comprensión de documentos, no una garantía de que cada gráfico, nota al pie o página escaneada será interpretado correctamente.
El resultado en Terminal-Bench Science del resumen oficial cubre flujos como análisis de datos, simulación y demostración de teoremas. Una evaluación local útil debería puntuar la corrección y reproducibilidad de la salida final, mientras mide el coste total de herramientas y modelo.
Esto no significa que GPT-6.1 Sol reemplace universalmente a Astra. OpenAI sigue posicionando a Astra como su modelo de mayor capacidad para el trabajo extremo a extremo más difícil. El cambio importante es que la brecha de rendimiento entre Sol y Astra se estrecha, mientras su brecha de precio por token sigue siendo grande.
Factualidad y fiabilidad del agente: menos errores y mejor manejo de fallos
Los datos de factualidad de OpenAI apuntan en esa dirección, aunque la evaluación no debe interpretarse como una tasa universal de alucinaciones.
El anuncio oficial reporta directamente una mejora de factualidad a bajo esfuerzo: las respuestas con errores bajan de 11.4% con GPT-6 Sol a 7.7% con GPT-6.1 Sol, una disminución de 3.7 puntos porcentuales, o aproximadamente un 32% de reducción relativa. Estas conversaciones seleccionadas previamente disparaban errores; las cifras no son una tasa universal de alucinaciones.
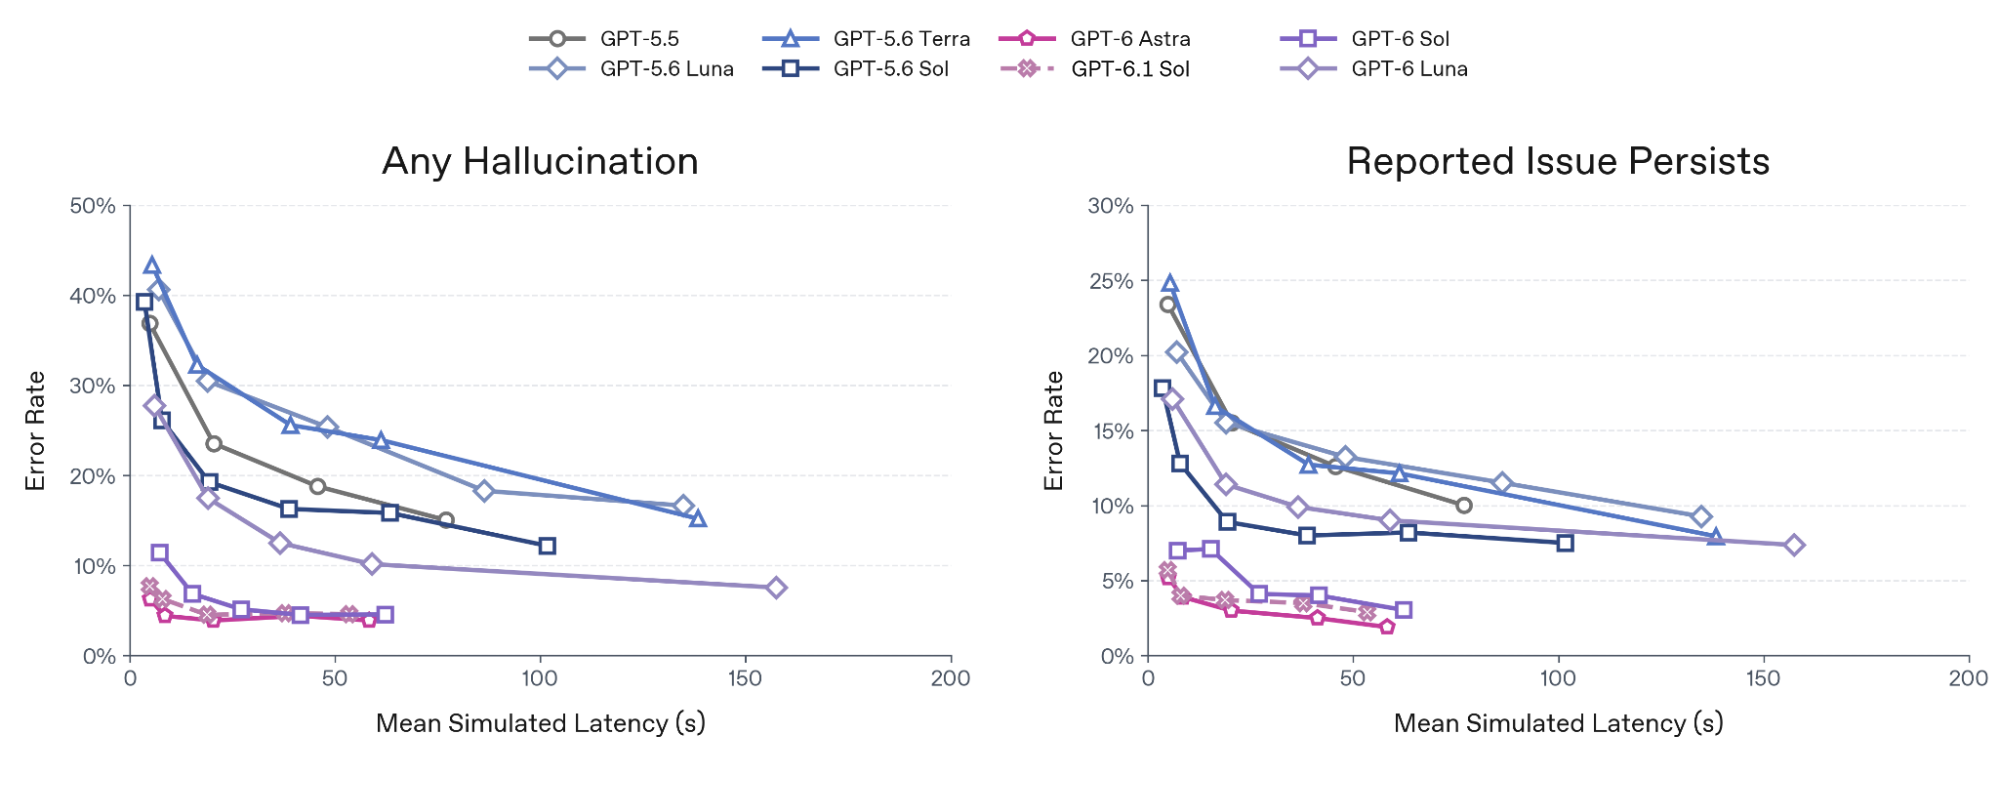
El gráfico original anterior se extrae directamente del PDF de la system-card de OpenAI sin redibujar. Traza evaluaciones seleccionadas de conversaciones difíciles frente a latencia simulada; los dos paneles miden cualquier alucinación y la persistencia del problema reportado. No debe leerse como una estimación de errores a nivel de producción.
| Modelo | Tasa de fallo con búsqueda rota — maximum effort |
|---|---|
| GPT-6.1 Sol | 2.1% |
| GPT-6 Sol | 4.9% |
| GPT-6 Astra | 1.5% |
| GPT-6 Luna | 28.7% |
La API GPT-6 Luna en CometAPI es otra opción orientada a coste, pero su resultado aquí en búsqueda rota ilustra por qué un agente debe probarse tanto en manejo de fallos como en ejecución exitosa de herramientas.
Son evaluaciones deliberadamente adversarias más que tasas representativas de fallos en producción. Son útiles como evidencia de que GPT-6.1 Sol reconoce mejor cuando las herramientas no están disponibles o están rotas, en lugar de continuar con afirmaciones no sustentadas.
GPT-6.1 Sol vs. GPT-6 Sol: ¿deberías actualizar?
Para un nuevo flujo de trabajo complejo, GPT-6.1 Sol es un fuerte candidato de evaluación. Para un despliegue estable de GPT-6 Sol, actualiza sólo cuando las ganancias medidas justifican la migración. El límite de contexto compartido y los precios base por token permiten una comparación justa, pero los benchmarks públicos no pueden decidir si tu propia aplicación será más rápida, más fiable o más barata.
Cuándo vale la pena probar la actualización
Prioriza una prueba cuando la programación a escala de repositorio, la automatización empresarial multietapa, el uso del ordenador o el análisis de documentos difíciles representen una parte sustancial de tu carga de trabajo. Las mejoras reportadas en la sección anterior son relevantes para estos casos. Trátalas como motivos para probar, no como garantía de que tu tasa de éxito en producción subirá en la misma medida.
Las aplicaciones con contexto repetido son otro caso útil. La menor tarifa de lectura en caché puede reducir la parte de entrada de la factura cuando las solicitudes realmente reutilizan un prefijo estable. Si la mayor parte del gasto proviene de tokens generados, herramientas o intentos fallidos, un descuento de caché por sí solo puede tener poco efecto. Compara el coste total por resultado aceptado, incluyendo reintentos y tiempo de revisión.
Cuándo es razonable mantener GPT-6 Sol
Conserva GPT-6 Sol cuando ya cumple tus objetivos de calidad, latencia y presupuesto y el modelo más nuevo no produce un beneficio material en una evaluación representativa. Una integración que funciona también tiene valor: evita reemplazar una ruta estable sólo porque el nombre del modelo sea más nuevo.
La compatibilidad puede ser decisiva. GPT-6 Sol admite razonamiento none; GPT-6.1 Sol comienza en low. Una aplicación que usa función de llamadas en Chat Completions de Sol con none debe mover su bucle de herramientas a Responses para usar 6.1 Sol. También audita parámetros de muestreo y el parseo de respuestas. Estos son cambios de migración, no un simple intercambio de ID de modelo. Consulta la guía de migración de OpenAI.
Cómo tomar la decisión de actualizar
Crea un conjunto fijo de evaluación con tareas rutinarias, casos difíciles y fallos de herramientas de tu flujo de trabajo previsto. Mantén constantes las definiciones de tareas, permisos de herramientas y criterios de aceptación. Compara una línea base de Sol validada con una configuración válida de 6.1 Sol; registra explícitamente los ajustes de razonamiento en lugar de fingir que none y low son equivalentes.
- Calidad: mide completados aceptados, correcciones factuales, llamadas a herramientas inválidas y esfuerzo de revisión humana.
- Velocidad: compara latencias p50/p95 extremo a extremo, incluyendo reintentos y esperas de herramientas.
- Coste: registra entrada sin caché, lecturas en caché, escrituras de caché, tokens de salida/razonamiento, cargos de herramientas y esfuerzo de ingeniería.
- Despliegue: comienza con un pequeño porcentaje de tráfico, conserva un fallback a Sol y expande sólo cuando se cumplan umbrales predefinidos.
Recomendación práctica: elige GPT-6.1 Sol cuando la prueba entregue mejores economías por tarea aceptada o un aumento de capacidad necesario sin regresiones inaceptables. Mantén GPT-6 Sol para rutas donde la compatibilidad y resultados probados pesan más que el beneficio medido. Un despliegue mixto es razonable cuando sólo mejoran algunas clases de tareas. Son recomendaciones basadas en carga de trabajo, no una afirmación de que uno u otro gane universalmente.
¿Cómo migras de GPT-6 Sol a GPT-6.1 Sol?
En el nivel más simple, el identificador del modelo cambia de gpt-6-sol a gpt-6.1-sol.
Una solicitud Responses API puede verse así:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Analiza este repositorio e identifica la causa de las pruebas fallidas."
)

print(response.output_text)
Cambiar el identificador del modelo es sólo el primer paso. GPT-6.1 Sol admite low, medium, high, xhigh y max, mientras que GPT-6 Sol admite además none. Elimina cualquier ajuste explícito none y elige un esfuerzo permitido. Las aplicaciones que usan herramientas también necesitan Responses API: GPT-6.1 Sol en Chat Completions no admite llamadas a herramientas, mientras que GPT-6 Sol en Chat Completions admite function calling sólo con none. Las columnas de modelo oficiales en la tabla de especificaciones documentan estas restricciones de endpoint.
Los equipos deben volver a probar flujos sensibles a la latencia, llamadas a herramientas, caché de prompts, comportamiento en contexto largo y cualquier lógica que envíe explícitamente reasoning.effort="none".
Este ejemplo apunta directamente a OpenAI usando OPENAI_API_KEY; no es un ejemplo verificado de endpoint de CometAPI. Mantén tu ruta con GPT-6 Sol disponible durante un despliegue escalonado, registra el éxito de las tareas y la latencia p95 y revierte si no se cumplen los criterios de aceptación de tu aplicación.
¿Qué cargas de trabajo se benefician más con GPT-6.1 Sol?
| Carga de trabajo | Ventaja de GPT-6.1 Sol |
|---|---|
| Agentes de programación | Mayor rendimiento en DeepSWE |
| Depuración a escala repo | Mejor ingeniería de software de largo horizonte |
| Agentes de navegador/PC | +7 puntos en OSWorld 2.0 |
| Automatización empresarial | Mayor rendimiento en AutomationBench |
| Agentes con contexto repetido | Lectura en caché 50% más barata |
| Análisis complejo de PDFs | Rendimiento cercano a Astra en documentos profesionales |
| Flujos científicos | Más del doble de la puntuación de GPT-6 Sol en la evaluación Terminal-Bench Science de OpenAI |
| Flujos sensibles a hechos | Menor tasa de error en prompts difíciles |
| Agentes con muchas herramientas | Mejor comportamiento cuando fallan las herramientas |
GPT-6 Sol sigue siendo útil donde las integraciones existentes ya son estables o donde los desarrolladores necesitan específicamente el ajuste none de razonamiento. Para nuevos despliegues centrados en agentes, programación, uso del ordenador o flujos con contexto repetido, GPT-6.1 Sol cambia la ecuación coste-rendimiento sin cambiar el precio normal de tokens de entrada/salida.
¿Cómo puede CometAPI ayudarte a actualizar de GPT-6 Sol a GPT-6.1 Sol?
Para desarrolladores que ya usan la API GPT-6 Sol en CometAPI, actualizar a GPT-6.1 Sol puede manejarse como una migración relativamente pequeña en lugar de una reescritura completa de la integración.
GPT-6.1 Sol ya está disponible a través de CometAPI con el identificador de modelo gpt-6.1-sol. CometAPI actualmente muestra un precio inicial de entrada en contexto corto de $1.60 por millón de tokens, comparado con la tarifa oficial de $2.00 de OpenAI, mientras que el precio de salida comienza en $8.00 por millón de tokens. Esto mantiene el modelo Sol más nuevo en la misma estructura de precios con descuento que GPT-6 Sol, al tiempo que da a los desarrolladores acceso a su mayor rendimiento en programación, agentes y uso del ordenador.
Debido a que CometAPI proporciona una interfaz compatible con OpenAI, las aplicaciones existentes de GPT-6 Sol suelen poder mantener la misma estructura de SDK y flujo de solicitudes cambiando el ID del modelo a gpt-6.1-sol. CometAPI también ofrece herramientas para comparar modelos, probar prompts, estimar costes de carga de trabajo e inspeccionar el comportamiento de migración antes del despliegue en producción.
Un proceso de actualización más seguro es ejecutar los mismos prompts representativos contra GPT-6 Sol y GPT-6.1 Sol primero, luego comparar calidad de salida, latencia, comportamiento de herramientas y coste total. Esto es especialmente importante para aplicaciones que dependen de ajustes de razonamiento, salidas estructuradas, llamadas a herramientas o agentes de larga ejecución, porque la compatibilidad del modelo no garantiza un comportamiento idéntico en todas las cargas.
Para equipos con cargas de contexto repetido o muy centradas en agentes, la nueva ruta también puede mejorar la economía. CometAPI actualmente fija las lecturas de caché en contexto corto de GPT-6.1 Sol en $0.08 por millón de tokens, frente a los $0.10 oficiales de OpenAI, mientras que las tarifas de entrada y salida en contexto corto figuran 20% por debajo del precio oficial.
En la práctica, CometAPI puede hacer la transición GPT-6 Sol → GPT-6.1 Sol en tres pasos:
- Reemplaza
gpt-6-solporgpt-6.1-sol. - Evalúa los mismos prompts de producción y flujos de agente antes de cambiar el tráfico.
- Mueve cargas gradualmente una vez que calidad de salida, comportamiento de herramientas, latencia y coste cumplen tus requisitos.
Este enfoque permite adoptar GPT-6.1 Sol sin reconstruir la aplicación alrededor de un nuevo stack de API, validando a la vez las diferencias de comportamiento introducidas por el modelo más nuevo.
Conclusión
GPT-6 Sol no está técnicamente obsoleto. Conserva la misma ventana de contexto de 1.05M, techo de salida de 128K, salidas estructuradas, entrada de imágenes y precios Standard de $2/$10. Su opción de razonamiento none también puede importar para integraciones existentes. La decisión de actualizar debe basarse en resultados medidos de tareas y compatibilidad, no sólo en el número de versión.
Sin embargo, la documentación de GPT-6 Sol de OpenAI ahora dirige a los desarrolladores a GPT-6.1 Sol como el modelo Sol más nuevo.
Para la mayoría de cargas complejas, la pregunta clave no es si GPT-6.1 Sol tiene una ventana de contexto mayor o una tarifa por token más alta—no la tiene. La pregunta es si mayor éxito por tarea, lecturas de caché más baratas, factualidad mejorada y comportamiento de agente más sólido justifican cambiar el identificador del modelo y volver a probar la carga de trabajo.
Preguntas frecuentes
¿Cómo migras de GPT-6 Sol a GPT-6.1 Sol con llamadas a herramientas?
No. Primero audita el endpoint y los campos de la solicitud, luego mueve el bucle de herramientas a Responses API y prueba el parseo de llamadas, validación de argumentos, reintentos y manejo de errores. Ejecuta un canario con tareas representativas antes de aumentar el tráfico; una solicitud sólo de texto exitosa no verifica un bucle de herramientas funcionando.
¿Es GPT-6.1 Sol más barato en cargas reales?
Registra tokens de entrada en caché y sin caché, escrituras de caché, tokens de razonamiento y salida, modo de procesamiento y cargos por herramientas. Compara el coste por tarea aceptada en lugar del precio de tokens en caché por sí solo. Los prefijos estables ayudan sólo cuando las solicitudes realmente aciertan la caché, y bucles de herramientas más largos o intentos fallidos pueden compensar los ahorros de caché.
¿Cómo debes probar GPT-6.1 Sol antes de cambiar desde GPT-6 Sol?
Usa un conjunto fijo de tareas similares a producción y registra completados exitosos, correcciones factuales, llamadas a herramientas inválidas, latencia p50/p95 y coste total. Define umbrales aceptables antes de probar. Mantén una ruta de rollback de modelos y expande el tráfico sólo después de que la nueva configuración cumpla esos umbrales.
¿Cómo probar GPT-6.1 Sol con PDFs?
Crea un pequeño corpus con tablas densas, notas al pie, gráficos y páginas escaneadas representativas del flujo previsto. Haz preguntas con respuestas verificables y exige evidencia de página o tabla. Puntúa por separado exactitud de cálculos, cautelas omitidas y respuestas no sustentadas; conserva revisión humana para salidas cuyos errores tengan consecuencias materiales.