Construye con CometAPI¿Necesitas una sola API para varios modelos?Prueba el flujo en el Playground y luego crea una clave de API cuando el modelo y el costo encajen con tu caso de uso.
Cómo ejecutar MiniMax M3.1 Flash localmente: guía de GPU, vLLM y SGLang
Aprende a ejecutar MiniMax M3.1 Flash localmente. Explora su arquitectura MoE de 428B/23B, los requisitos de GPU, la configuración con vLLM y SGLang, las pruebas de referencia y las alternativas de API.
Deon GoodwinEquipo de investigación de modelos de IA y API
MiniMax M3.1 Flash lleva pesos abiertos de IA a flujos de trabajo exigentes de programación y agentes, pero ejecutarlo localmente requiere hardware serio. Su arquitectura MoE de 428B parámetros activa solo 23B parámetros por token, reduciendo la computación sin eliminar la necesidad de almacenar el modelo completo. Los desarrolladores con sistemas multi‑GPU compatibles pueden desplegarlo usando vLLM o SGLang. Para quienes quieren evitar la gestión de infraestructura, la MiniMax M3.1 Flash API en CometAPI ofrece una forma más simple de empezar.
Puntos clave
Las configuraciones publicadas de vLLM usan cuatro GPUs Blackwell o AMD MI355X compatibles, u ocho GPUs H100/H200.
Revisado para mayor claridad, atribución de fuentes y terminología API actual.
El hardware es la mayor barrera.
El contexto largo tiene costes de memoria. El modelo admite hasta un millón de tokens, pero los límites de servicio prácticos dependen de la memoria GPU disponible y la concurrencia.
El despliegue es específico del hardware. Usa un motor de inferencia, formato de cuantización y configuración de acelerador compatibles en lugar de un comando de instalación genérico.
Los benchmarks son solo un punto de partida. Evalúa la precisión en programación, la finalización de tareas de agente, la latencia y el rendimiento bajo tus propias cargas.
La inferencia local y hospedada cubren necesidades distintas. El auto‑hosting ofrece mayor control de infraestructura, mientras que el acceso vía API reduce la complejidad de configuración y el mantenimiento.
¿Qué es MiniMax M3.1 Flash?
MiniMax M3.1 Flash acepta texto, imágenes y video y genera texto. Está diseñado para flujos de programación, automatización, interacción con computadoras y seguridad. Los pesos se distribuyen bajo la MiniMax Community License. Antes de ofrecer un servicio comercial, lee la licencia suministrada con el checkpoint y verifica las condiciones aplicables a tu uso.
Especificaciones de MiniMax M3.1 Flash
Especificación
MiniMax M3.1 Flash
Desarrollador
MiniMax
Familia de modelo
MoE multimodal nativo
Parámetros totales
Aproximadamente 428B
Parámetros activos
Aproximadamente 23B por token
Contexto máximo
1,048,576 tokens (capacidad del modelo)
Tipos de entrada
Texto, imágenes y video (dependiente de la ruta)
Salida
Texto
Atención
MiniMax Sparse Attention en cada capa
Cuantización
Capas densas MXFP8 / expertos NVFP4
Decodificación de borrador
DSpark integrated draft head
Esfuerzo de razonamiento
low, medium, high, xhigh, max
Velocidad de salida reportada
200+ tokens/s en condiciones favorables; P50 170+ tokens/s
Licencia
MiniMax Community License
Inferencia documentada
vLLM, SGLang
Topología típica
4 GPUs Blackwell o MI355X compatibles; 8 GPUs H100/H200
¿Cómo usa MiniMax M3.1 Flash su arquitectura 428B/23B?
Un modelo Mixture‑of‑Experts (MoE) enruta cada token a expertos seleccionados. En MiniMax M3.1 Flash, aproximadamente 23B parámetros están activos por token, mientras que el conjunto completo de parámetros es aproximadamente 428B. La activación dispersa reduce la computación; no convierte el checkpoint en un modelo denso de 23B.
¿Qué cambió en MiniMax M3.1 Flash?
Atención dispersa: Aplicada en todo el modelo para reducir el trabajo de atención en entradas largas; el beneficio depende de los kernels de servicio y el prompt.
Pesos de precisión mixta: Los componentes densos MXFP8 y los expertos NVFP4 reducen las demandas de almacenamiento y cómputo, pero aún requieren hardware y kernels compatibles.
Decodificación DSpark: Un cabezal de borrador integrado puede acelerar la generación en recetas compatibles; los resultados dependen de la aceptación de tokens y la carga.
Servicio consciente de energía: La planificación a nivel de infraestructura puede mejorar la utilización, pero no es una función que obtienes automáticamente al descargar los pesos.
¿Qué hardware se necesita para MiniMax M3.1 Flash?
Planifica la memoria GPU en cuatro partes: pesos del checkpoint, caché de clave‑valor (KV) para tokens previos, buffers de runtime y margen para la carga. Las estimaciones siguientes cubren solo el almacenamiento bruto de parámetros. La precisión mixta, las escalas de cuantización, los componentes multimodales y la sobrecarga de servicio cambian el requisito real.
Topologías de GPU validadas
Aceleradores
Topología publicada
Notas
NVIDIA GB200/GB300/B200/B300
4 GPUs, paralelismo de tensores
Ruta NVFP4 nativa para Blackwell
NVIDIA H100/H200
8 GPUs, paralelismo de tensores
Cachés FP8 y ruta MoE de Marlin
AMD MI355X
4 GPUs, paralelismo de tensores
Requiere ROCm y ajustes AITER compatibles
GPU de consumo 24–32 GB
Sin receta de referencia de checkpoint completo
No suficiente para carga simple en una sola GPU
Estación de trabajo solo CPU
Sin implementación práctica validada
Los experimentos de offloading no son guía de producción
Estimación de memoria: El almacenamiento bruto para 428B parámetros es aproximadamente 856 GB en BF16, 428 GB en 8 bits, o 214 GB en un 4 bits idealizado. El checkpoint oficial mezcla formatos, por lo que estas cifras no son requisitos de VRAM en tiempo de ejecución. Ten en cuenta las escalas de cuantización, la caché KV, los buffers de runtime y la concurrencia; usa los archivos del checkpoint reales y la receta para tu GPU para dimensionar el sistema.
Reserva espacio NVMe para el checkpoint, descargas temporales y una copia de reversión.
¿Qué método de despliegue deberías elegir?
Para un clúster local compatible, vLLM es un punto de partida práctico con configuraciones de referencia e integración de API familiar; SGLang se adapta a equipos que exploran personalización del servicio tras comprobar compatibilidad, mientras que CometAPI ofrece una vía hospedada para prototipado y cambio de modelo.
Requisito
vLLM local
SGLang local
CometAPI
Pesos y GPUs
Descargar pesos; operar GPUs compatibles
Descargar pesos; operar GPUs compatibles
Inferencia gestionada por el proveedor; sin pesos locales
Blackwell / AMD MI355X
Recetas específicas de hardware
Recetas específicas de hardware
Hardware gestionado por el proveedor
H100/H200
Receta documentada de ocho GPUs
Consulta la matriz de soporte actual
Hardware gestionado por el proveedor
Decodificación y paralelismo
DSpark en rutas compatibles; servicio tensor y distribuido
Decodificación específica de hardware; paralelismo de tensores y expertos
Limitado a las opciones expuestas por la ruta
Control y procesamiento de datos
Tu entorno; tú gestionas el escalado
Tu entorno; tú gestionas el escalado
Proveedor externo; el proveedor gestiona el escalado
Elige el framework con una receta validada para tu hardware, luego compara latencia y rendimiento usando los mismos prompts, precisión y concurrencia.
¿Cómo ejecutar MiniMax M3.1 Flash localmente con vLLM?
Los pasos siguientes asumen un host Linux equipado con cuatro GPUs NVIDIA Blackwell compatibles, un entorno de driver/CUDA soportado y acceso al checkpoint oficial. Usa una build validada de vLLM; una instalación ordinaria en hardware GPU no soportado puede fallar incluso si la instalación del paquete funciona.
Asegúrate de que la rueda instalada y el runtime de CUDA coincidan con tu familia de GPU. Si se requiere una build de desarrollo específica del proyecto, sigue las notas de instalación de referencia antes de usar los argumentos de lanzamiento.
Usa un token de acceso adecuado de Hugging Face si es necesario, conserva la estructura de directorios y verifica la descarga completa de los shards antes de iniciar el servidor.
Espera a que el servidor termine de cargar y reporte que está listo antes de enviar una solicitud. El comando anterior limita el contexto a 32,768 tokens y las secuencias concurrentes a cuatro para una prueba inicial. Estos límites reducidos no son ajustes de benchmark; ajústalos tras medir uso de memoria y comportamiento de solicitudes en tu hardware.
Si el identificador servido difiere del nombre de directorio, llama a /v1/models y usa el ID exacto devuelto. Una respuesta de texto exitosa valida solo la inferencia básica; prueba visión, llamadas a herramientas, concurrencia y contexto largo por separado.
Paso 5: Integra con un cliente de Python compatible con OpenAI
El ejemplo escucha en 127.0.0.1 para pruebas locales. Antes de conectar clientes remotos, pon controles de acceso delante del endpoint y configura timeouts del cliente, reintentos acotados y monitoreo.
Variante H100/H200: usa la receta Hopper de ocho GPUs
En ocho GPUs H100/H200, usa la ruta específica de Hopper con caché FP8 y Marlin MoE en lugar de la configuración NVFP4 de Blackwell. El comando siguiente sigue la receta oficial de vLLM para Hopper con el contexto y la concurrencia reducidos a 32K y cuatro secuencias para una prueba inicial. Deshabilita la entrada de video conforme a esa receta. Mantén este endpoint detrás de tus controles de acceso existentes.
SGLang ofrece recetas de despliegue de M3.1 específicas de hardware y servicio compatible con OpenAI. En el snapshot del 23 de octubre, la documentación incluye imágenes de contenedor de desarrollo dedicadas, por lo que no debe asumirse que una instalación genérica de SGLang contenga todo el soporte específico del modelo.
Extrae la imagen de contenedor dedicada
# NVIDIA development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash

# AMD MI350X/MI355X development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash-mi35x
A continuación, sigue el cookbook de MiniMax M3.1 de SGLang para tu acelerador. Extraer una imagen solo descarga el runtime; aún necesitas iniciar un contenedor con acceso a GPU y lanzar la configuración de servicio correspondiente dentro de él. Usa el comando completo específico del hardware del cookbook, espera a la disponibilidad, luego consulta la lista de modelos del endpoint antes de enviar una solicitud de prueba. Las rutas documentadas de NVIDIA y AMD usan dependencias diferentes y deben configurarse por separado.
¿Cómo se compara MiniMax M3.1 Flash en benchmarks?
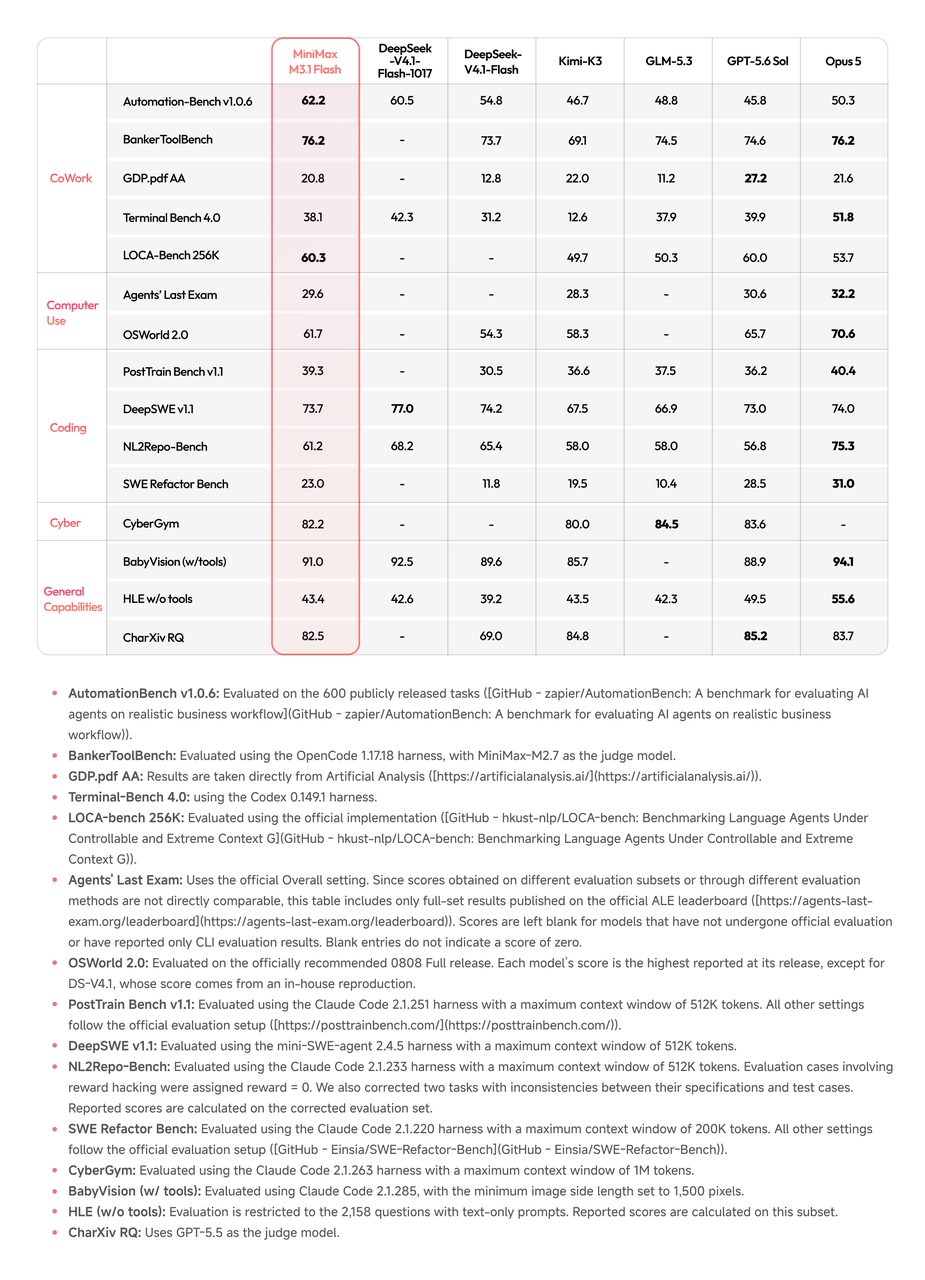
Una vez que tu endpoint pasa las comprobaciones básicas, usa benchmarks publicados para decidir qué cargas probar a continuación. Las cifras siguientes son evaluaciones publicadas por el proveedor, no mediciones de tu despliegue local.
Benchmark
M3.1 Flash
DeepSeek V4.1 Flash 1017
Kimi K3
Automation-Bench v1.0.6
62.8
60.5
46.7
DeepSWE v1.1
73.7
77.0
67.5
Terminal Bench 4.0
38.1
42.3
12.6
OSWorld 2.0
61.7
N/D
58.3
NL2Repo-Bench
61.2
68.2
58.0
BabyVision with tools
91.0
92.5
85.7
En esta comparación, MiniMax lidera los modelos listados en Automation‑Bench, mientras que DeepSeek lidera varios benchmarks de programación. Lee la model card y los ajustes de evaluación antes de sacar conclusiones, y prueba los prompts y herramientas que tu aplicación realmente usa. Las puntuaciones de diferentes versiones o configuraciones de benchmark no son directamente comparables.
¿Cómo optimizar el rendimiento de MiniMax M3.1 Flash?
Controla contexto y concurrencia
Tras la primera solicitud exitosa, aumenta una variable de carga a la vez: longitud de entrada, longitud de salida o solicitudes concurrentes. Registra la memoria pico y la latencia de respuesta para cada ejecución. Conserva los últimos ajustes estables como tu punto de reversión, de modo que un experimento fallido no se convierta en tu nuevo baseline.
Elige deliberadamente el esfuerzo de razonamiento
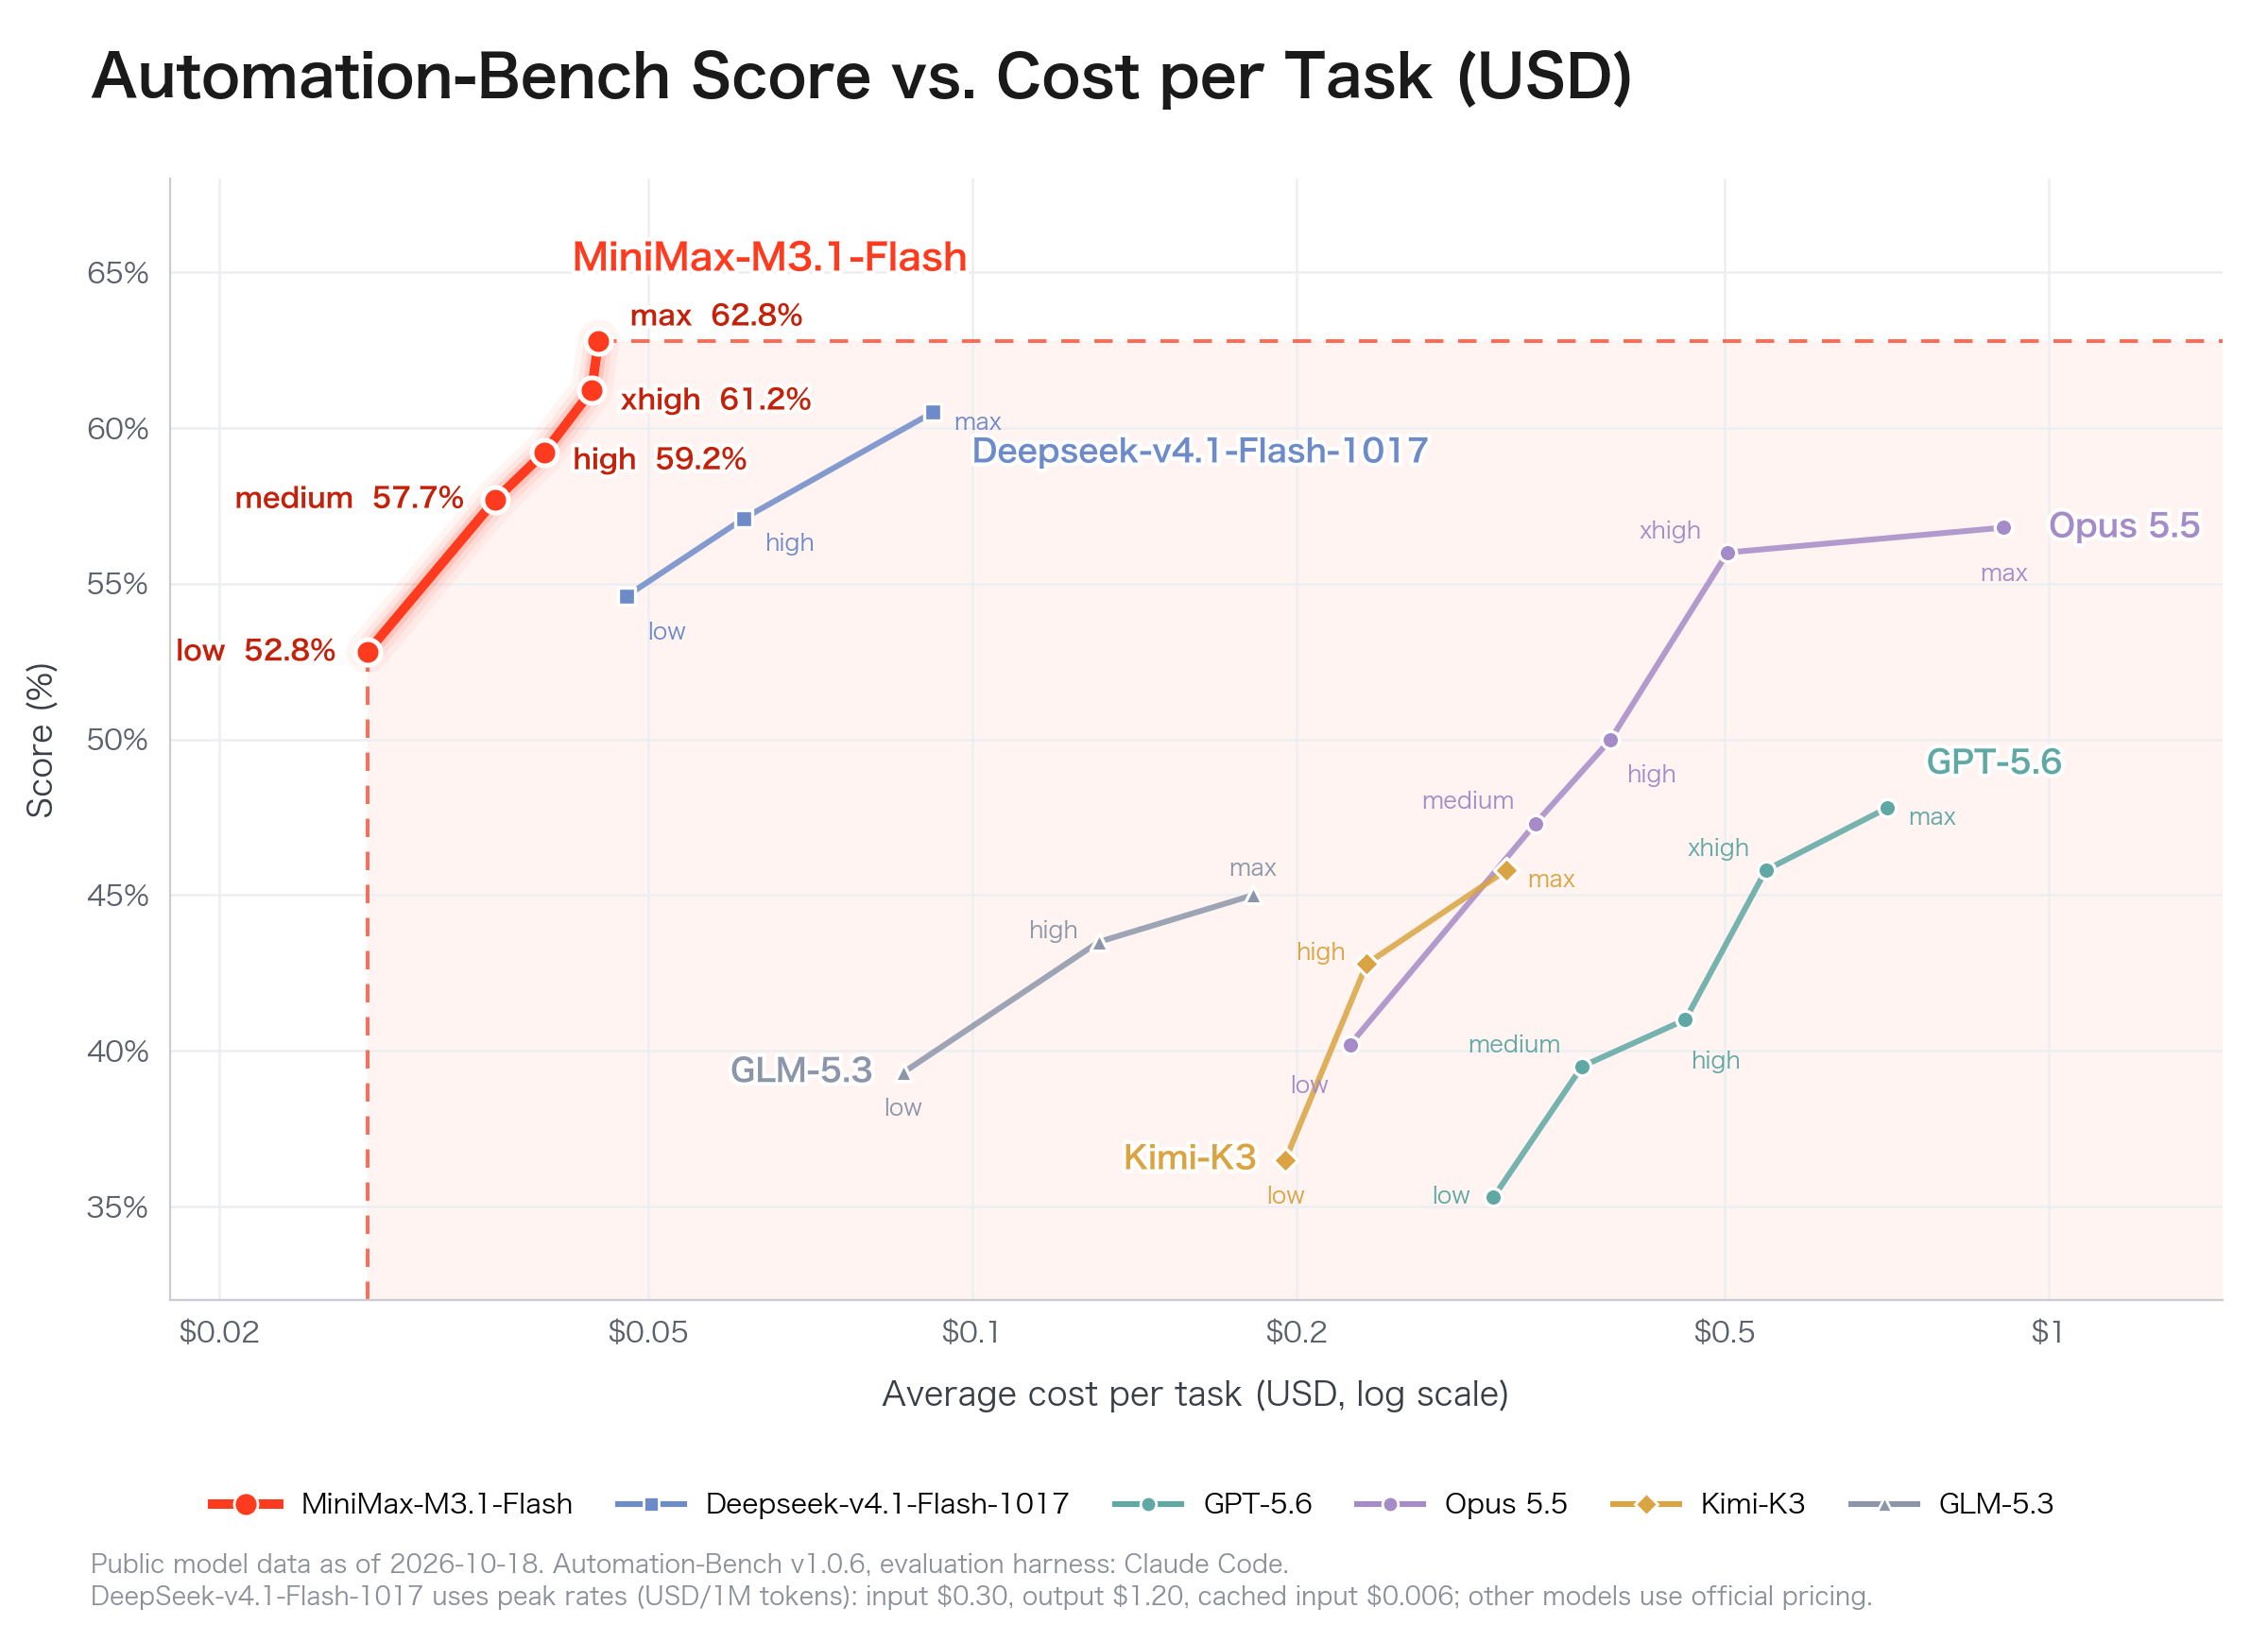
M3.1 Flash admite low, medium, high, xhigh y max. Ajustes más altos pueden mejorar puntuaciones en tareas exigentes pero suelen requerir más tokens de razonamiento y mayor latencia. Usa la calidad de finalización de tareas y el coste computacional transcurrido conjuntamente.
Para solicitudes locales en vLLM, la receta muestra ajustes de razonamiento bajo chat_template_kwargs. Verifica tanto la respuesta final como cualquier campo de razonamiento devuelto por separado al validar tu cliente, ya que endpoints hospedados y locales pueden exponer estos campos de forma distinta.
Rastrea el coste por tarea completada
Para agentes, los tokens por segundo no son suficientes. Registra tiempo hasta el primer token, tasa de salida, tasa de aceptación para decodificación especulativa, rendimiento concurrente, fallos de llamadas a herramientas, utilización de memoria y coste por tarea completada. Una respuesta más lenta con menos herramientas fallidas puede ofrecer una economía mejor en conjunto.
¿Cómo usar la MiniMax M3.1 Flash API en CometAPI?
Los equipos que no necesitan infraestructura dedicada de aceleradores pueden usar un endpoint hospedado compatible con OpenAI. Esto elimina la descarga del checkpoint y las operaciones de GPU, pero mueve el procesamiento de solicitudes fuera del entorno auto‑hospedado.
export COMETAPI_KEY="YOUR_COMETAPI_KEY"

curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-m3.1-flash",
    "messages": [{"role":"user","content":"Review this Python function for edge cases."}],
    "max_tokens": 2048
  }'
Confirma el identificador del modelo en tu consola de CometAPI antes de ejecutar este ejemplo. Usa el gateway cuando una API común entre proveedores beneficie tu aplicación; compara su tarifa vigente con el acceso directo para tu uso previsto.
Precios de la MiniMax M3.1 Flash API
Precio por millón de tokens
MiniMax official API
CometAPI
Entrada
$0.15
$0.80
Salida
$0.60
$3.20
Entrada en caché
$0.015
Confirme la tarifa vigente de la ruta
Las tarifas directas de la API de MiniMax en el anuncio de lanzamiento del 19 de octubre de 2026 son $0.15 entrada, $0.60 salida y $0.015 entrada en caché por millón de tokens. Para CometAPI, consulta la ruta de modelo activa, tarifas de entrada/salida, reglas de caché y cualquier descuento de cuenta antes de estimar el gasto. Compara el coste total para tu mezcla de tokens prevista y reintentos.
¿Qué problemas pueden ocurrir al ejecutar MiniMax M3.1 Flash?
Falta de memoria durante la carga o las solicitudes
Si los pesos no se cargan: Revisa la etapa que falla en el log de inicio, confirma que el checkpoint está completo y verifica que la topología de GPU y el backend de cuantización coincidan con la receta. Si los pesos exceden la memoria disponible, usa una configuración con capacidad suficiente; acortar una solicitud no arregla un fallo de carga de pesos.
Si los pesos cargan pero la asignación de caché falla al inicio: Revisa los ajustes de caché y la memoria disponible, luego reduce el contexto configurado o la concurrencia según corresponda a la receta.
Si el servidor inicia pero una solicitud se queda sin memoria: Reintenta con un prompt corto y una solicitud a la vez, luego aumenta longitud de entrada, longitud de salida y concurrencia por separado mientras monitoreas la memoria.
Cuantización o kernels de atención incompatibles
La ejecución NVFP4 difiere entre hardware Blackwell, Hopper y AMD. Alinea versiones del motor de inferencia, backends de cuantización, versiones de CUDA/ROCm y familias de aceleradores en lugar de reutilizar flags indiscriminadamente.
Configuración de caché para atención dispersa
Si el inicio reporta un layout de caché no soportado, compara la configuración completa de caché con la receta específica de hardware. La receta actual de vLLM requiere --block-size 128 para la caché dispersa/de índice MSA. Si el inicio reporta un error de layout de caché o block‑size, compara la configuración completa con la receta para tu hardware.
Identificadores de modelo inesperados
Una ruta local y un nombre de modelo de un gateway remoto no son necesariamente idénticos. Consulta la respuesta /v1/models local y evita suposiciones codificadas de otro endpoint.
Rendimiento observado pobre
Separa el procesamiento lento del prompt de la generación lenta de tokens. Compara ejecuciones con la misma longitud de entrada y límite de salida, luego revisa la utilización de GPU y el comportamiento del interconector antes de aumentar el tamaño de lote. Una cifra de velocidad hospedada por un proveedor no es un baseline para tu clúster local.
Conclusión
Elige tu primera ruta de despliegue según el hardware que puedas operar hoy. Usa la guía de vLLM para un clúster local compatible, el cookbook específico de hardware de SGLang para una pila de servicio alternativa, o una API hospedada cuando quieras centrarte en la integración de la aplicación. Conserva la configuración que cumple tus objetivos de calidad de tareas y latencia a un coste operativo sostenible.
La forma más fiable de seleccionar un método de servicio es optimizar por trabajo correcto completado por dólar y por minuto, no solo por picos de tokens por segundo.
FAQ
¿Cómo hago reproducible un despliegue tras actualizar el runtime?
Fija la revisión del checkpoint, las versiones de la imagen de runtime o paquetes, la pila de drivers y los ajustes de lanzamiento. Ejecuta el mismo conjunto pequeño de aceptación antes de cada actualización y mantén disponible la configuración anterior que funcionaba para poder revertir.
¿Cómo debo manejar los reintentos cuando un agente llama herramientas?
Separa el reintento del modelo de la repetición de una acción de herramienta. Usa claves de idempotencia para acciones que cambian datos, verifica si el primer intento tuvo éxito y valida los argumentos completos de la herramienta antes de la ejecución.
¿Puedo cambiar entre un endpoint local y CometAPI sin cambiar el comportamiento de la aplicación?
Mantén configurables el endpoint, las credenciales y el ID del modelo. Prueba streaming, llamadas a herramientas, campos de razonamiento y entradas multimodales en ambas rutas, y confirma tus requisitos de enrutamiento de datos antes de habilitar el fallback.
¿Qué debo probar antes de aceptar entradas multimodales?
Prueba imágenes y videos representativos, incluyendo archivos de baja calidad y no soportados. Revisa preprocesamiento, límites de tamaño, calidad de respuesta y timeouts por separado; una solicitud de texto exitosa no valida la ruta multimodal.
¿Cómo sé si un despliegue está listo para usuarios reales?
Establece objetivos para éxito en tareas, llamadas a herramientas válidas, latencia, errores y coste. Prueba tráfico realista, verifica monitoreo y comportamiento de fallback, luego amplía desde un despliegue pequeño solo mientras se cumplan esos objetivos.