
TL;DR Claude Haiku 5.5 lo presenta como el modelo pequeño más barato, rápido y capaz que ha lanzado. Diseñado para cargas de trabajo de alto volumen y sensibles a la latencia, como clasificación, extracción, enrutamiento, resumen y tareas de subagentes, ofrece una ventana de contexto de 1 millón de tokens, hasta 128K tokens de salida y pensamiento adaptativo con niveles de esfuerzo ajustables.
En promedio, cuesta alrededor de un 75% menos ejecutar que Haiku 4.5, a la vez que logra grandes mejoras en benchmarks de agentes y uso de computadoras. Los desarrolladores pueden acceder a él a través de la Claude API oficial (claude-haiku-5-5), Amazon Bedrock, Google Cloud, Microsoft Foundry, o gateways optimizados en costo como CometAPI (desde $0.08 / $0.40).
Puntos clave
- Lanzamiento y posicionamiento: Lanzado el 7 de octubre de 2026 como el modelo pequeño y de alto rendimiento de la familia Claude 5.5, ideal para soporte en tiempo real, procesamiento de documentos y pasos delegados de agentes.
- Especificaciones básicas: Contexto de 1M tokens, salida máxima de 128K (300K mediante Batch API beta), pensamiento adaptativo (esfuerzo predeterminado medio), entrada de texto + imagen → salida de texto, límite de conocimiento junio de 2026.
- Ventaja de precios: $0.10 entrada / $0.50 salida por millón de tokens para prompts de hasta 100K (≈90% más barato que Haiku 4.5 en la mayoría de las solicitudes); nivel superior por encima de 100K. Lecturas de caché desde $0.01. CometAPI ofrece tarifas Estándar ≈20% más bajas.
- Salto de rendimiento: Grandes avances frente a Haiku 4.5 (p. ej., OSWorld 72.4% vs 15.7%, Terminal-Bench 39.2% vs 0%, GDPval-AA 1620 vs 735 Elo), manteniéndose competitivo con o por delante de GPT-6 Luna en muchas pruebas.
- Funciones para desarrolladores: Parámetro de effort (
low–max), caché de prompts, Batch API (50% de descuento), uso de computadora/navegador (soporte SDK beta). Temperature/top_p/top_k deben omitirse o se producirá un error 400.
Qué es Claude Haiku 5.5 y por qué importa en 2026
Claude Haiku 5.5 es la última incorporación de Anthropic a la categoría ligera de la familia Claude. A diferencia de los modelos más costosos Opus 5.5 y Sonnet 5.5, optimizados para razonamiento complejo y agentes de horizonte largo, Haiku 5.5 está diseñado específicamente para cargas de trabajo de alto volumen, sensibles a costos y críticas en latencia. Anthropic lo describe como “el modelo pequeño más barato, rápido y capaz que hemos lanzado”.
Usos típicos en producción incluyen:
- Clasificación y enrutamiento de tickets en soporte al cliente
- Extracción de campos y resumen de documentos largos
- Compactación del historial de conversación para modelos más grandes
- Consultas tipo base de datos y tareas de datos estructurados
- Subagentes rápidos que manejan pasos acotados de código, uso de herramientas o navegador mientras un modelo más fuerte orquesta
Dado que es notablemente más barato y rápido que su predecesor, a la vez que cierra gran parte de la brecha de calidad en tareas prácticas de agentes, muchos equipos están re-arquitecturando sus pipelines para que Haiku 5.5 gestione la mayoría de las solicitudes y solo escale los casos difíciles a Sonnet u Opus. Los primeros comentarios de clientes como Asana, HubSpot, Box y otros destacan reducciones de latencia del 30%+ y mejoras medibles de precisión en evaluaciones internas de alto volumen.
Especificaciones técnicas de Claude Haiku 5.5
| Especificación | Valor | Notas |
|---|---|---|
| ID de modelo (Claude API) | claude-haiku-5-5 | Sin sufijo de fecha |
| Amazon Bedrock | anthropic.claude-haiku-5-5 (o perfiles global/us/eu/au/jp) | |
| Ventana de contexto | 1,000,000 tokens | ≈555k palabras con el nuevo tokenizador |
| Salida máx. (Messages API) | 128,000 tokens | 300K con Batch API + encabezado beta |
| Modalidades de entrada | Texto + imágenes | |
| Modalidad de salida | Texto | |
| Thinking | Adaptativo (activado por defecto) | Controlado vía effort |
| Esfuerzo predeterminado | medium | Opciones: low, medium, high, xhigh, max |
| Límite de conocimiento | Junio de 2026 | |
| Compromiso de retiro | No antes del 7 de octubre de 2027 | |
| Tokenizador | Más nuevo (misma familia que Claude 4.7+) | El mismo texto ≈30% más tokens que 4.5 |
Fuente: resumen del modelo de Anthropic y documentación de la plataforma.
El mayor contexto y límites de salida, combinados con pensamiento adaptativo, hacen que Haiku 5.5 sea mucho más utilizable en sistemas de producción reales que los modelos pequeños anteriores que requerían truncación agresiva o presupuestos de pensamiento fijos.
Respuestas y comprobaciones de finalización
Lea los bloques de contenido por tipo, en lugar de asumir que content[0] es la respuesta visible. Inspeccione stop_reason antes de aceptar la salida: max_tokens indica una generación truncada y refusal requiere una respuesta explícita de la aplicación. Para solicitudes con herramientas habilitadas, procese los bloques de tool-use y devuelva los resultados de la herramienta en formato nativo en lugar de tratarlos como una respuesta de texto completada.
¿Qué cambió con respecto a la API de Claude Haiku 4.5?
Cambios de capacidad, comportamiento y precios
| Dimensión | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| Ventana de contexto | 200K | 1M | 1M |
| Salida máxima | 64K | 128K | 128K |
| Esfuerzo adaptativo | No | Sí | Sí |
| Entrada Anthropic / MTok | $1.00 | $0.10 | $2.00 |
| Salida Anthropic / MTok | $5.00 | $0.50 | $10.00 |
| Posicionamiento | Modelo rápido heredado | Trabajo rutinario a escala | Tareas complejas más difíciles |
Los precios de Haiku 5.5 en esta comparación aplican a prompts de hasta 100,000 tokens; prompts más grandes cuestan más. Estas son tarifas Estándar de Anthropic, no tarifas de CometAPI. La comparación es un punto de partida para el enrutamiento, no una afirmación de que los modelos rindan idénticamente.
Para integraciones de Haiku 4.5, los cambios clave de implementación son pensamiento adaptativo en lugar de un presupuesto manual, controles de effort, análisis selectivo de bloques de contenido y recuentos de tokens actualizados. El mismo texto puede utilizar aproximadamente un 30% más de tokens de entrada. Recuente prompts representativos en lugar de reutilizar estimaciones de tokens de Haiku 4.5. La sección de migración convierte estos cambios en una lista de verificación de despliegue.
Mejoras reportadas en benchmarks
| Benchmark | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| OSWorld 2.1 (subset offline; crédito parcial) | 15.7% | 72.4% | 83.9% |
| Terminal-Bench 4.0 | 0.0% | 39.2% | 70.6% |
| Humanity’s Last Exam (sin herramientas) | 10.2% | 45.9% | 56.9% |
| Chartography (sin herramientas) | 6.4% | 46.4% | 61.6% |
| GDPval-AA v2.1 (Elo) | 735 | 1,620 | 1,840 |
Anthropic reporta las puntuaciones anteriores en su resumen de benchmarks de lanzamiento. Son resultados de evaluaciones reportadas, no pruebas en vivo de los ejemplos de CometAPI en esta guía. El 72.4% de OSWorld es crédito parcial, no una tasa estricta de finalización de tareas.
La Haiku 5.5 system card describe las condiciones de evaluación. Las evaluaciones estándar de Haiku 5.5 usan pensamiento adaptativo en effort max y muestreo por defecto salvo que se indique; el valor predeterminado del producto es medium. OSWorld usa 82 tareas offline, sin acceso a internet, resolución 1080p y un límite de 500 acciones. Terminal-Bench 4.0 usa Claude Code en modo bare, sin egreso a internet y 10 ensayos por tarea para Haiku 5.5; la configuración de Sonnet difiere. HLE y Chartography arriba son sin herramientas. GDPval-AA reporta una calificación Elo de evaluaciones de Artificial Analysis. Haga coincidir el harness, effort y configuraciones de herramientas relevantes al comparar resultados.
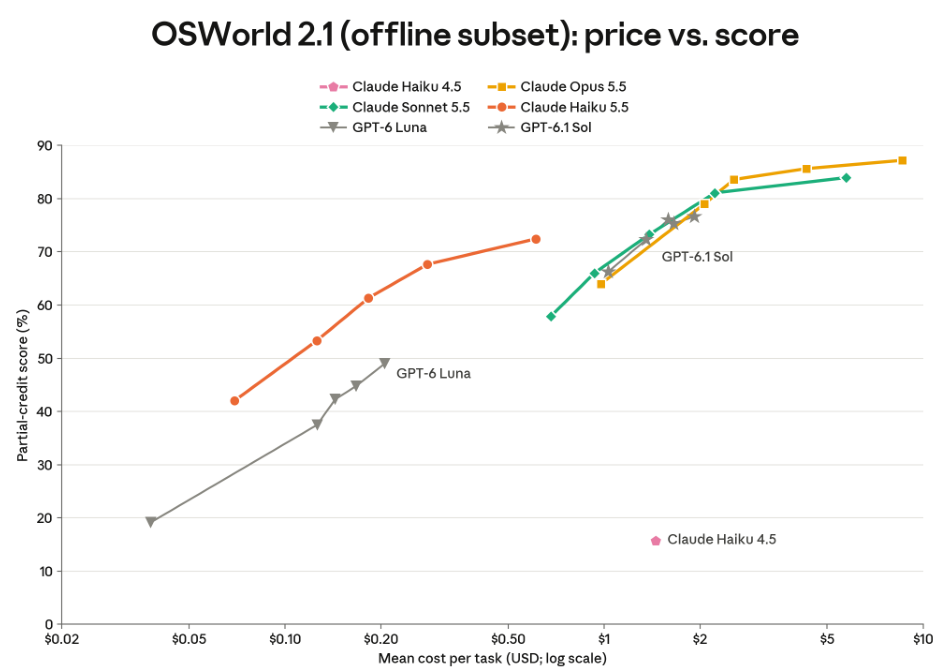
El gráfico original de OSWorld de Anthropic muestra la relación entre effort, costo por tarea y puntuación de crédito parcial. No mide la latencia de la API ni garantiza el mismo rendimiento en su carga de trabajo.
Las puntuaciones indican un desempeño mucho más sólido en uso de computadoras y tareas generales que Haiku 4.5, pero no garantizan los mismos resultados en su aplicación. Ejecute un conjunto de evaluación representativo antes de comprometer tráfico de producción.
La tabla de benchmarks y el gráfico proporcionado se mantienen como comparaciones de modelos. Son evaluaciones reportadas en lugar de pruebas en vivo de los ejemplos de CometAPI. Use la misma distribución de tareas, effort y configuraciones de herramientas al evaluar una aplicación; una puntuación de benchmark no establece la latencia del gateway ni su propia tasa de éxito.
Cómo usar la API de Claude Haiku 5.5 a través de CometAPI
Cree una clave y elija la ruta nativa
Cree una cuenta en CometAPI, confirme el acceso a claude-haiku-5-5 y genere una clave de API del lado del servidor. Defina COMETAPI_KEY en su entorno. Mantenga la clave fuera del control de versiones y del código del navegador. Las claves de Anthropic y CometAPI pertenecen a proveedores diferentes; use la clave de CometAPI para cada ejemplo en esta guía revisada.
export COMETAPI_KEY="your_cometapi_api_key"
pip install --upgrade anthropic
$env:COMETAPI_KEY="your_cometapi_api_key"
| Integración | SDK base URL | Request path | Credencial |
|---|---|---|---|
| Anthropic-compatible Messages | https://api.cometapi.com | /v1/messages | COMETAPI_KEY |
| OpenAI-compatible Chat Completions | https://api.cometapi.com/v1 | /chat/completions | COMETAPI_KEY |
CometAPI soporta el formato nativo de Messages y content-block de Claude. Use el SDK de Anthropic con la raíz base URL de CometAPI. Native Messages es la ruta preferida en esta guía para el thinking específico de Claude y los content blocks. La ruta compatible de Chat Completions es una opción para una aplicación ya estilo OpenAI. Confirme el soporte de campos avanzados en la ruta exacta del gateway.
Envíe una solicitud mínima y verifique el resultado
curl https://api.cometapi.com/v1/messages \
  -H "Content-Type: application/json" \
  -H "x-api-key: $COMETAPI_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -d '{
    "model": "claude-haiku-5-5",
    "max_tokens": 2048,
    "output_config": {"effort": "low"},
    "messages": [{"role": "user", "content": "Summarize three AI uses in customer support."}]
  }'
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",
    timeout=60.0,
    max_retries=2,
)

response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket: I cannot log in."}],
)
if response.stop_reason != "end_turn":
    raise RuntimeError(f"Unaccepted completion: {response.stop_reason}")
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
Guarde el ejemplo en Python como example.py y ejecute python example.py. Un checkpoint exitoso es una respuesta completada con texto visible y campos de usage. Un error de autenticación indica que la clave debe verificarse; un error de modelo/ruta indica que se deben verificar el ID del modelo, el endpoint o el acceso a la cuenta.
Use el mismo formato nativo desde JavaScript
npm install @anthropic-ai/sdk
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com",
  timeout: 60_000,
  maxRetries: 2,
});
const response = await client.messages.create({
  model: "claude-haiku-5-5",
  max_tokens: 2048,
  output_config: {effort: "low"},
  messages: [{role: "user", content: "Extract product, quantity and price: 3 laptops at $900 each."}],
});
if (response.stop_reason !== "end_turn") {
  throw new Error("Unaccepted completion: " + response.stop_reason);
}
for (const block of response.content) {
  if (block.type === "text") console.log(block.text);
}
Use una versión de Node.js compatible. Guarde el archivo como example.mjs, defina COMETAPI_KEY y ejecute node example.mjs. Registre la versión del SDK que valide para el despliegue.
Adapte una aplicación existente compatible con OpenAI
Si su aplicación ya usa Chat Completions, instale el paquete openai y configure el cliente separado a continuación. Esta ruta devuelve choices en lugar de content blocks nativos. Mantenga el análisis específico de la ruta separado y pruebe thinking, imágenes y herramientas antes de confiar en la traducción del gateway.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    messages=[
        {"role": "system", "content": "Be concise and helpful."},
        {"role": "user", "content": "Explain API rate limits."},
    ],
)
print(response.choices[0].message.content)
Envío de imágenes a la API de Claude Haiku 5.5
Use una imagen junto con una instrucción que especifique la evidencia y la salida que necesita. La interfaz oficial de visión acepta bloques de contenido de imagen con datos base64, una URL de imagen o una referencia de archivo subido compatible. Este ejemplo lee un PNG local, coloca la imagen antes de la pregunta y solicita valores que se pueden verificar frente a la fuente.
Analice un PNG local real mediante la API nativa Anthropic Messages.
import os
import base64
from pathlib import Path
import anthropic

# Replace dashboard.png with a real PNG file you are authorized to analyze.
image_data = base64.b64encode(Path("dashboard.png").read_bytes()).decode("ascii")
anthropic_client = anthropic.Anthropic(api_key=os.environ["ANTHROPIC_API_KEY"])
response = anthropic_client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    output_config={"effort": "low"},
    messages=[{
        "role": "user",
        "content": [
            {"type": "image", "source": {
                "type": "base64", "media_type": "image/png", "data": image_data
            }},
            {"type": "text", "text": (
                "Read the visible dashboard metrics. List anomalies with their "
                "labels and values, and state when text is unreadable."
            )},
        ],
    }],
)
for block in response.content:
    if block.type == "text":
        print(block.text)
Use el tipo MIME que coincida con el archivo real. Verifique legibilidad, dimensiones de imagen y límites de tamaño de solicitud antes de enviarla; evite enviar medios de alta resolución que no ayuden a la tarea. Para CometAPI, cambie la clave y la base URL raíz como se muestra en su ejemplo de Messages y verifique el soporte de imágenes en la ruta exacta.
Control del razonamiento de Claude Haiku 5.5
Haiku 5.5 usa pensamiento adaptativo por defecto. La configuración oficial de thinking explica cuándo se acepta disabled y cómo se devuelven los bloques de thinking. Establezca el effort mediante output_config.effort; no reutilice el legacy budget_tokens.
| Esfuerzo | Caso de uso inicial recomendado | Compensación |
|---|---|---|
| low | Clasificación corta, extracción simple | Uso de tokens y latencia típicamente menor |
| medium | Respuestas de soporte, trabajo rutinario de agentes | Equilibrio predeterminado |
| high | Análisis de documentos multi-paso | Potencialmente más razonamiento |
| xhigh | Evaluaciones difíciles | Más procesamiento y costo |
| max | Casos intensivos en razonamiento | Máximo gasto potencial de razonamiento |
Configure el pensamiento adaptativo con effort low.
import osimport anthropicanthropic_client = anthropic.Anthropic( api_key=os.environ["ANTHROPIC_API_KEY"],)response = anthropic_client.messages.create( model="claude-haiku-5-5", max_tokens=4096, thinking={"type": "adaptive"}, output_config={"effort": "low"}, messages=[{"role": "user", "content": "Classify as billing, technical, or account: cannot log in."}],)for block in response.content: if block.type == "text": print(block.text)
Los desarrolladores pueden desactivar thinking en low, medium y high, pero no en xhigh o max. Thinking consume tokens de salida facturados y el presupuesto de max_tokens incluso cuando su texto está oculto. Un campo thinking vacío aún puede llevar una firma; no prueba que no haya ocurrido razonamiento. Mantenga los bloques de contenido devueltos sin cambios al continuar conversaciones con herramientas.
Ejemplo de solicitud con thinking desactivado
Envíe un cuerpo de solicitud nativo con thinking desactivado.
{ "model": "claude-haiku-5-5", "max_tokens": 1024, "thinking": {"type": "disabled"}, "output_config": {"effort": "low"}, "messages": [ {"role": "user", "content": "Return sentiment only: positive, neutral, negative."} ]}
Streaming de respuestas de Claude Haiku 5.5
El streaming entrega texto visible de forma incremental y mejora la capacidad de respuesta en aplicaciones interactivas. Trate el texto transmitido como provisional hasta que la solicitud se complete correctamente.
Transmita texto visible con el SDK de Anthropic para Python.
import osimport anthropicanthropic_client = anthropic.Anthropic( api_key=os.environ["ANTHROPIC_API_KEY"],)with anthropic_client.messages.stream( model="claude-haiku-5-5", max_tokens=4096, output_config={"effort": "low"}, messages=[{"role": "user", "content": "Explain API caching."}],) as stream: for text in stream.text_stream: print(text, end="", flush=True)
Precios de la API de Claude Haiku 5.5
Compare tarifas por tokens y bandas de longitud de prompt
Tarifas verificadas el 8 de octubre de 2026. La tabla compara las tarifas Estándar de Anthropic con las tarifas publicadas de CometAPI, en USD por millón de tokens. La banda está determinada por la longitud del prompt: hasta 100,000 tokens frente a más de 100,000. Las solicitudes más largas usan las tarifas de la banda superior aplicable, no simplemente un recargo sobre los tokens excedentes. La facturación de la cuenta, el uso de caché y las herramientas opcionales deben conciliarse por separado.
| Categoría de tokens | Anthropic ≤100K | CometAPI ≤100K | Anthropic >100K | CometAPI >100K |
|---|---|---|---|---|
| Entrada | $0.10 | $0.08 | $0.50 | $0.40 |
| Salida | $0.50 | $0.40 | $2.50 | $2.00 |
| Lectura de caché | $0.01 | $0.008 | $0.05 | $0.04 |
| Escritura caché 5-min | $0.125 | $0.10 | $0.625 | $0.50 |
| Escritura caché 1-h | $0.20 | $0.16 | $1.00 | $0.80 |
El snapshot de tarifas del artículo original se mantiene arriba. Revise el listado actual de CometAPI y la facturación de la cuenta antes de comprar o desplegar; la tarifa de entrada inicial del listado no es una cotización completa para cada banda de longitud de prompt, operación de caché o herramienta opcional.
Ejemplo: costo de 100,000 solicitudes de soporte
Suponga 100,000 solicitudes mensuales, cada una con 2,000 tokens de entrada y 300 tokens de salida facturados, incluyendo cualquier thinking generado. Cada prompt califica para la banda de hasta 100K. Excluya caché, cargos por herramientas y reintentos.
| Componente | Uso | Anthropic | CometAPI |
|---|---|---|---|
| Entrada | 200M tokens | $20.00 | $16.00 |
| Salida | 30M tokens | $15.00 | $12.00 |
| Total | 100,000 solicitudes | $35.00 | $28.00 |
Bajo estos supuestos, la diferencia ilustrativa es de $7 por mes, o 20%. Los costos de producción dependen de las longitudes de las solicitudes, thinking oculto, caché y comportamiento de reintentos.
Use los recuentos de tokens actuales del modelo en el cálculo. Costo = tokens de entrada × tarifa de entrada aplicable / 1,000,000 + tokens de salida facturados × tarifa de salida aplicable / 1,000,000, más cargos de caché, herramientas y reintentos aplicables por separado. Los tokens de thinking forman parte de la salida facturada.
Reduzca costos sin perder calidad de tareas aceptadas
| Optimización | Acción | Beneficio |
|---|---|---|
| Ajuste de effort | Use low donde la calidad lo permita | Menor sobrecarga de razonamiento |
| Reducción de prompt | Elimine historial redundante | Menos tokens de entrada |
| Caché de prompts | Mantenga un prefijo reutilizado | Menor costo en entradas repetidas |
| Streaming | Renderice tokens conforme llegan | Mejor respuesta percibida |
| Validación de esquema | Rechace registros malformados temprano | Menos retrabajo posterior |
| Enrutamiento de modelos | Escale tareas complejas | Mejor equilibrio costo-calidad |
| Procesamiento por lotes | Lotee solicitudes offline elegibles | Posibles ahorros adicionales |
No seleccione automáticamente el effort más bajo. Una llamada más barata puede aumentar los costos totales si produce más reintentos. Evalúe precisión, latencia p50/p95, uso de tokens y costo por tarea exitosa.
Para caché de prompts, reutilice un prefijo estable e inspeccione la creación de caché y el uso de lecturas de caché en lugar de asumir un hit. Haiku 5.5 tiene un mínimo de 512 tokens cacheables en la API de Claude documentada. Cambiar el effort puede invalidar prefijos en caché; mantenga configuraciones estables dentro de una conversación. Una ventana de contexto de 1M es un techo de capacidad, no una recomendación para enviar cada documento en cada turno.
Mantenga un prefijo reutilizable estable para el caché, acorte entradas innecesarias y evalúe cambios de effort. El streaming mejora la respuesta percibida, no reduce automáticamente el uso facturado. Compare el costo por tarea aceptada a lo largo de todo el flujo, incluyendo reintentos y llamadas a herramientas.
Guía de migración de Claude Haiku 4.5 a Haiku 5.5
Actualice la integración y el formato de solicitud
| Área | Acción de migración |
|---|---|
| Model ID | Reemplace por claude-haiku-5-5 |
| Thinking | Reemplace budget_tokens manual por pensamiento adaptativo |
| Effort | Use output_config.effort si es necesario |
| Sampling | Omita temperature, top_p y top_k; cualquier valor de top_k no es compatible |
| Response parser | Maneje múltiples tipos de content-block |
| Output budget | Permita suficiente espacio para razonamiento y salida final |
| Prefill | Elimine el assistant prefilling no compatible |
| Caching | Repruebe prompts al cambiar effort |
| Tool integrations | Verifique versiones de herramientas soportadas |
Para la ruta de CometAPI usada aquí, mantenga COMETAPI_KEY y la base URL nativa mientras cambia el ID de modelo y la configuración de la solicitud. Reemplace thinking legacy habilitado con un presupuesto por pensamiento adaptativo y effort. Elimine el assistant prefilling y omita parámetros de muestreo. Preserve la distinción entre el arreglo nativo de contenido de Claude y la respuesta de choices de la ruta compatible.
Preserve el estado y recalcule presupuestos
La guía de migración oficial de Haiku 5.5 reporta aproximadamente un 30% más de tokens de entrada para texto idéntico que Haiku 4.5. Recuente prompts representativos y retune límites antes de mover tráfico. Los bloques de thinking devueltos funcionan solo en la cuenta que los generó o una cuenta vinculada; un cambio de cuenta puede eliminar silenciosamente esos bloques. Preserve un prefijo de conversación de solo anexado en lugar de modificar mensajes anteriores después de la generación. Inspeccione stop_reason, incluyendo max_tokens y refusal, y manéjelos explícitamente antes de aceptar la salida.
Recuente prompts representativos con el modelo objetivo y ajuste max_tokens, límites de latencia y estimaciones de costo de la solicitud. Pruebe conversaciones almacenadas contra la cuenta y la ruta del gateway que las reproducirá; no asuma que los bloques de thinking firmados son portables entre cuentas no relacionadas o prefijos de conversación reescritos.
Conclusión
Claude Haiku 5.5 representa un verdadero punto de inflexión para la IA eficiente en costo y de alto rendimiento. Al ofrecer un rendimiento de agentes y uso de computadora dramáticamente mejor a aproximadamente una décima parte del precio de Haiku anterior en la mayoría de las solicitudes, Anthropic ha hecho viable el despliegue a gran escala de modelos pequeños capaces. Ya sea llamando a la API oficial, enrutando a través de Amazon Bedrock, o usando un gateway unificado como CometAPI para mayores ahorros y simplicidad operativa, la combinación de velocidad, capacidad y precio abre nuevas posibilidades de producto que antes eran antieconómicas.