
La forma más rápida de usar la API de GLM-5.3 Flash es llamar al modelo a través del endpoint de chat-completions compatible con OpenAI de CometAPI. Los detalles de conexión están consolidados en la tabla de especificaciones de API a continuación; mantén la clave de API en el servidor.
Respuesta primero: crea una clave de CometAPI, instala un SDK compatible con OpenAI, envía una solicitud POST a /v1/chat/completions y añade streaming, visión, salida JSON o herramientas solo después de que la solicitud básica funcione.
¿Qué es la API de GLM-5.3 Flash?
GLM-5.3 Flash es el modelo multimodal nativo de Z.ai con prioridad en la eficiencia dentro de la familia GLM-5. Expone capacidades de razonamiento, contexto largo, comprensión visual y orientación a agentes a través de una API de chat. El modelo contiene 320B parámetros totales pero activa 18B por token (https://docs.z.ai/guides/vlm/glm-5.3-flash); esa arquitectura es importante para el costo, pero los desarrolladores principalmente lo perciben como un modelo que puede permanecer activo a lo largo de prompts largos y llamadas de herramientas repetidas.
Esta guía reduce deliberadamente la cobertura de arquitectura y benchmarks. El artículo complementario de descripción del modelo (https://www.cometapi.com/what-is-glm-5-3-flash/) ya explica el diseño de atención híbrida, pesos abiertos, la matriz completa de benchmarks de lanzamiento, el contexto de precios y la comparación de familias de modelos. Aquí, el enfoque está en el comportamiento de integración y decisiones de producción.
Especificaciones de API que afectan la integración
| Especificación de la API | Valor | Significado práctico |
|---|---|---|
| Base URL | https://api.cometapi.com/v1 | Configúralo una vez en el cliente del lado del servidor. |
| Endpoint | POST /v1/chat/completions | Usa la ruta de chat-completions compatible con OpenAI. |
| SDK compatibles | Clientes de Python y JavaScript compatibles con OpenAI | Reutiliza patrones de cliente familiares con la base URL de CometAPI. |
| Autenticación | Clave de API Bearer | Mantén la clave en una variable de entorno del servidor o un gestor de secretos. |
| Código de modelo | glm-5.3-flash | Usa este valor exacto en el cuerpo de la solicitud. |
| Ventana de contexto | 1,048,576 tokens | Adecuada para repositorios grandes, paquetes de documentos e historiales largos de agentes. |
| Salida máxima | Hasta 131,072 tokens | Establece un límite inferior específico de la aplicación para controlar costo y latencia. |
| Entradas nativas | Text, image, video, file | El soporte de rutas alojadas puede variar; valida la ruta exacta de CometAPI antes de depender de cada modalidad. |
| Salida | Text | El modelo interpreta medios pero no devuelve directamente imágenes o video generados. |
| Reasoning | low, high, max | Usa niveles de esfuerzo para intercambiar latencia y consumo de tokens por profundidad. |
| Thinking | Always enabled | No envíes un parámetro que intente desactivar el pensamiento. |
| Funciones para dev | Streaming, function calling, caching, structured output | Útiles para apps interactivas, agentes y canalizaciones legibles por máquina. |
La capacidad del modelo y la capacidad de la pasarela no son idénticas. Trata la página del modelo en vivo de CometAPI y el esquema de la API como el contrato de la ruta que realmente llamas, especialmente para video, archivos, JSON Schema estricto y campos de pensamiento específicos del proveedor.
Contexto breve de rendimiento
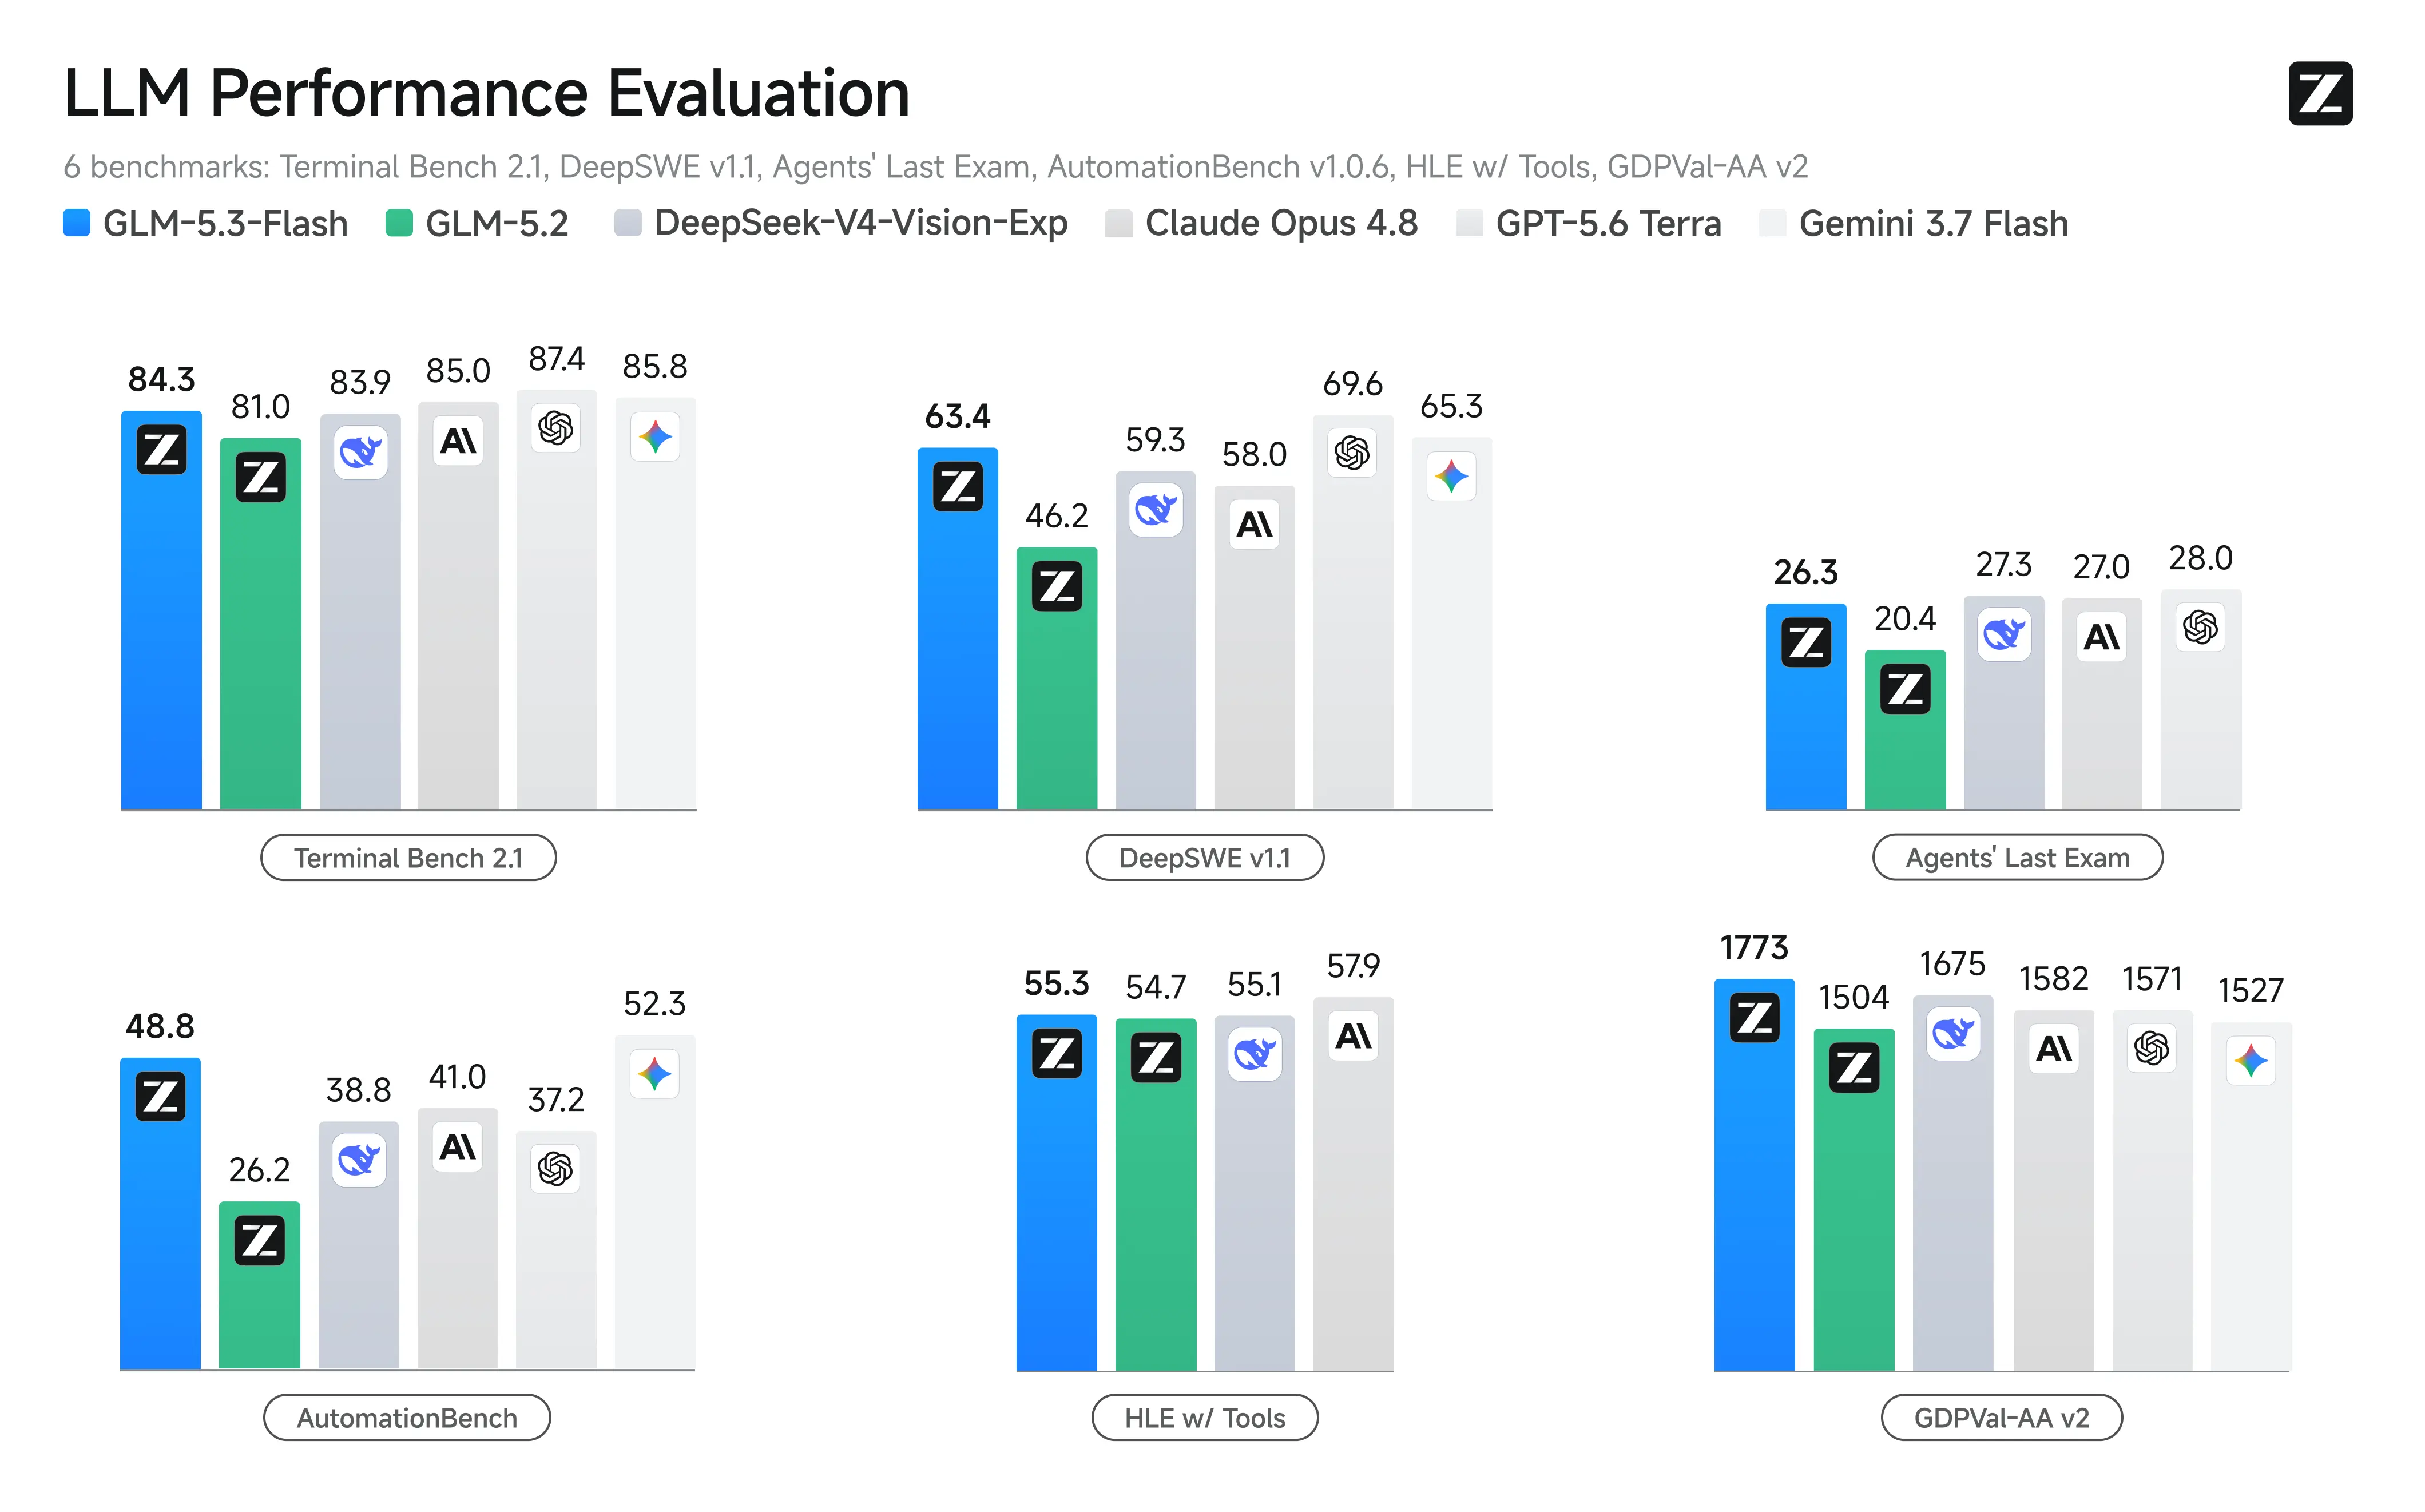
Z.ai reporta sólidos resultados de lanzamiento (https://z.ai/blog/glm-5.3-flash) en tareas que importan a quienes construyen con API: trabajo en terminal, ingeniería de software, uso de herramientas y automatización. Son puntuaciones reportadas por el proveedor obtenidas con harnesses y políticas de herramientas específicas, por lo que ayudan a identificar fortalezas probables más que a establecer un ranking universal.
| Benchmark | GLM-5.3 Flash | Lo que sugiere para cargas en API |
|---|---|---|
| Terminal-Bench 2.1 | 84.3 | Gran ajuste para agentes de codificación en terminal. |
| DeepSWE v1.1 | 63.4 | Prometedor para ingeniería de software a escala de repositorio. |
| Toolathlon Verified | 78.4 | Fuerte señal de selección y uso de herramientas. |
| AutomationBench | 48.8 | Mejor automatización de múltiples pasos vs. el predecesor. |
La implicación práctica es más estrecha que la tabla de benchmarks: GLM-5.3 Flash es un candidato sólido cuando el flujo de trabajo combina contexto largo con herramientas o retroalimentación visual. Para una comparación completa de modelos, usa la descripción general existente (https://www.cometapi.com/what-is-glm-5-3-flash/) en lugar de duplicarla aquí.
Fuente: Gráfico oficial de benchmarks de Z.ai
El gráfico oficial de benchmarks compara el rendimiento de GLM-5.3 Flash entre modelos y configuraciones de esfuerzo. Para esta guía de API, ofrece un contexto conciso de rendimiento en lugar de repetir toda la matriz de lanzamiento. Las aplicaciones aún deben medir el éxito de la tarea, la latencia de extremo a extremo y el uso total de tokens con sus propios prompts.
¿Por qué usar GLM-5.3 Flash a través de CometAPI?
CometAPI (https://www.cometapi.com/) expone GLM-5.3 Flash mediante una interfaz compatible con OpenAI. Eso permite a un equipo reutilizar patrones de SDK conocidos, centralizar credenciales y facturación, y cambiar de modelo sin reconstruir toda la capa de solicitudes.
• Un único patrón de integración. El mismo cliente base puede llamar a distintos modelos soportados cambiando el ID del modelo.
• Visibilidad centralizada de uso. Los equipos pueden revisar uso y costo sin mantener un panel separado para cada proveedor.
• Evaluación más rápida. Un único arnés de solicitudes puede comparar calidad de respuesta, latencia y errores entre modelos candidatos.
• Diseño de fallback más simple. Las aplicaciones pueden mantener la lógica de reintentos y enrutamiento en una sola capa de pasarela.
• Precio de ruta listado más bajo. La página actual del modelo indica $0.06 por millón de tokens de entrada (https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) y $0.20 por millón de tokens de salida (https://www.cometapi.com/models/zhipuai/glm-5-3-flash/); verifica la página en vivo antes de presupuestar.
Antes de comenzar
Necesitas una cuenta de CometAPI, una clave de API y uno de los siguientes entornos locales:
• Python 3.9 o posterior con pip
• Node.js 18 o posterior con npm
• cURL para una prueba mínima en la línea de comandos
Nunca coloques una clave de CometAPI de producción en JavaScript del navegador, una aplicación móvil, un repositorio público, una captura de pantalla o registros del lado del cliente. Llama a CometAPI desde un servidor confiable y guarda la clave en una variable de entorno o gestor de secretos.
Cómo usar la API de GLM-5.3 Flash con CometAPI
Paso 1: Crea una clave de API de CometAPI
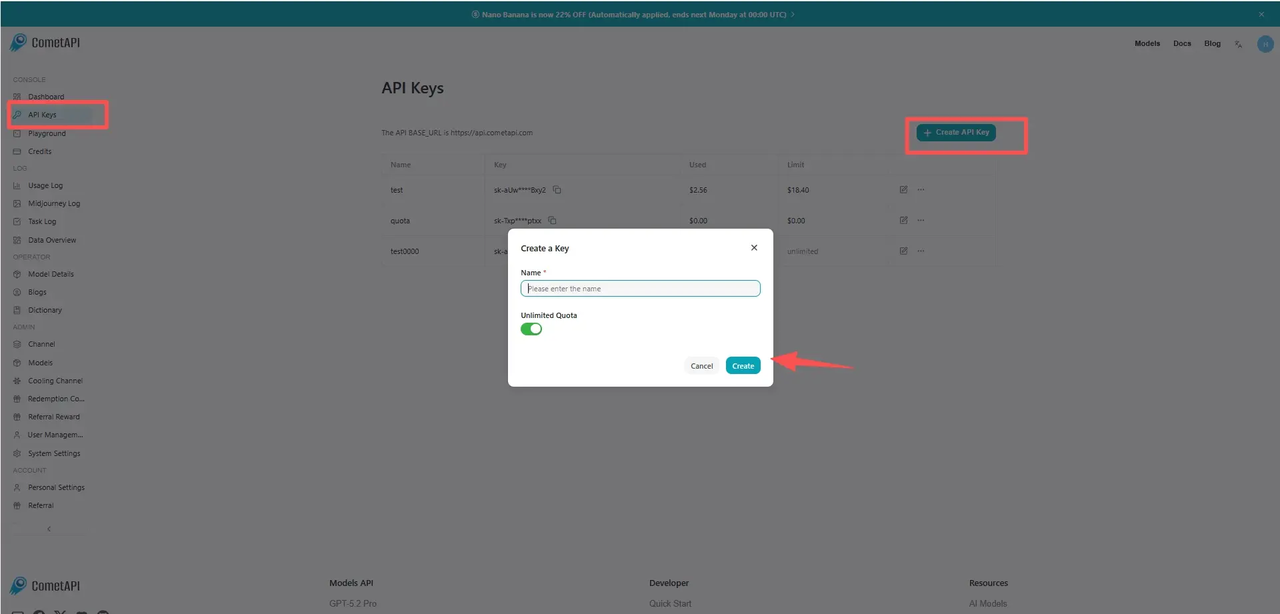
Inicia sesión en CometAPI, abre la consola de claves de API (https://www.cometapi.com/console/token), crea una clave y cópiala una vez en tu flujo de trabajo de gestión de secretos. Usa una clave separada para desarrollo y producción para poder rotar o revocar un entorno sin interrumpir el otro.
Fuente: Imagen oficial de la guía de claves de API de CometAPI
Paso 2: Almacena la clave como variable de entorno
$env:COMETAPI_KEY = "your_cometapi_key_here"
export COMETAPI_KEY="your_cometapi_key_here"
Para producción, reemplaza el historial de shell con un secreto de despliegue, secreto de contenedor o bóveda gestionada.

### Paso 3: Instala un SDK compatible con OpenAI
python -m pip install --upgrade openai
npm install openai
```

### Paso 4: Realiza la primera solicitud con cURL

```
curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {
        "role": "system",
        "content": "You are a precise technical assistant."
      },
      {
        "role": "user",
        "content": "Explain three practical uses of a one-million-token context window."
      }
    ],
    "max_completion_tokens": 800
  }'
```

Una respuesta exitosa contiene un mensaje del asistente en choices\[0].message.content más metadatos de uso cuando la ruta los devuelve. Comienza con esta solicitud pequeña antes de agregar parámetros opcionales.

### Paso 5: Llama a la API desde Python

```
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
    timeout=60.0,
    max_retries=2,
)

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "You are a precise technical assistant.",
        },
        {
            "role": "user",
            "content": "Review this migration plan and list the top five risks.",
        },
    ],
    max_completion_tokens=1200,
)

print(completion.choices[0].message.content)
print(completion.usage)
```

### Paso 6: Llama a la API desde JavaScript

```
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
  timeout: 60_000,
  maxRetries: 2,
});

const completion = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "system", content: "You are a precise technical assistant." },
    { role: "user", content: "Draft a safe rollout checklist for this API." },
  ],
  max_completion_tokens: 1200,
});

console.log(completion.choices[0].message.content);
console.log(completion.usage);
```

## Cómo controlar el esfuerzo de razonamiento

La documentación oficial del modelo (https://docs.z.ai/guides/vlm/glm-5.3-flash) soporta low, high y max como niveles de esfuerzo de razonamiento (https://docs.z.ai/guides/vlm/glm-5.3-flash). El pensamiento permanece activado (https://docs.z.ai/guides/vlm/glm-5.3-flash); la configuración de esfuerzo cambia cuánto presupuesto de razonamiento puede usar el modelo.

| Esfuerzo | Cargas iniciales recomendadas                   | Compensación                                          |
| -------- | ----------------------------------------------- | ----------------------------------------------------- |
| low      | Clasificación, reescritura, extracción corta    | Menor latencia y uso de tokens de salida; menos profundidad. |
| high     | Revisión de código, planificación, análisis de documentos | Predeterminado equilibrado para muchas tareas de producción. |
| max      | Depuración compleja, agentes con herramientas, razonamiento difícil | Mayor profundidad; potencialmente más latencia y costo. |

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": "Find hidden failure modes in this distributed rollout plan.",
        }
    ],
    max_completion_tokens=1800,
    extra_body={"reasoning_effort": "high"},
)

print(completion.choices[0].message.content)
```

Si el SDK instalado expone reasoning_effort como un argumento de primer nivel, puedes pasarlo directamente. Si la ruta de CometAPI rechaza un campo específico del proveedor, elimínalo y usa el valor predeterminado de la ruta. No intentes desactivar el pensamiento.

## Cómo transmitir respuestas

El streaming es útil para chat, asistentes de codificación y análisis largo porque permite que la interfaz muestre la salida a medida que llega. No reduce el número total de tokens generados, así que mantén los mismos límites de salida y controles de costo.

### Transmisión en Python

**Python**

```
stream = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {"role": "user", "content": "Create a staged database migration plan."}
    ],
    max_completion_tokens=1600,
    stream=True,
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta.content:
        print(delta.content, end="", flush=True)
print()
```

### Transmisión en JavaScript

**JavaScript**

```
const stream = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "user", content: "Create a staged database migration plan." },
  ],
  max_completion_tokens: 1600,
  stream: true,
});

for await (const chunk of stream) {
  const text = chunk.choices[0]?.delta?.content ?? "";
  process.stdout.write(text);
}
```

• Gestiona la cancelación. Deja de leer el stream cuando el cliente se desconecte y cancela el trabajo upstream cuando sea posible.

• Bufferiza de forma segura. No asumas que cada fragmento contiene una palabra completa, un token JSON o un objeto de llamada de herramienta.

• Registra el uso final. El uso puede aparecer solo en el evento final o en metadatos específicos de la ruta.

## Cómo enviar imágenes

GLM-5.3 Flash (https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) acepta contenido visual mediante bloques image_url en messages[].content[]. La documentación oficial recomienda una URL de imagen accesible o una Data URL en Base64. La página del modelo en CometAPI identifica la capacidad de image-to-text, pero las aplicaciones deben probar formatos, tamaño de archivo y el comportamiento de la ruta antes de producción.

### Analizar una URL de imagen

**Python**

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://example.com/dashboard.png"
                    },
                },
                {
                    "type": "text",
                    "text": (
                        "Review this dashboard. Identify usability issues, "
                        "ambiguous metrics, and possible data-quality risks."
                    ),
                },
            ],
        }
    ],
    max_completion_tokens=1500,
)

print(completion.choices[0].message.content)
```

### Enviar una imagen local como Base64

**Python**

```
import base64
import mimetypes
from pathlib import Path

image_path = Path("dashboard.png")
mime_type = mimetypes.guess_type(image_path.name)[0] or "image/png"
encoded = base64.b64encode(image_path.read_bytes()).decode("utf-8")

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:{mime_type};base64,{encoded}"
                    },
                },
                {
                    "type": "text",
                    "text": "Extract the chart title, axes, and main trend.",
                },
            ],
        }
    ],
    max_completion_tokens=1000,
)

print(completion.choices[0].message.content)
```

• Recorta espacios en blanco irrelevantes antes de codificar una imagen.

• Reduce la escala de imágenes que son mucho más grandes que la información a inspeccionar.

• Haz una pregunta visual específica en lugar de solicitar una descripción genérica.

• No asumas que una URL de página pública es una URL directa a la imagen.

• Prueba el ordenado de múltiples imágenes porque cada imagen debe referenciarse claramente en el prompt.

## Cómo solicitar JSON estructurado

La salida estructurada es valiosa cuando el siguiente componente es código en lugar de un lector humano. Usa un esquema estrecho, valida el resultado y mantén un fallback para rutas que no expongan JSON Schema estricto exactamente en la misma forma.

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Return valid JSON only.",
        },
        {
            "role": "user",
            "content": (
                "Extract equipment, severity, observed symptom, and next action "
                "from this report: Feeder 12 showed repeated zero-sequence current "
                "spikes after rain; inspect insulation and compare adjacent sections."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

El modo JSON no elimina la necesidad de validación. Comprueba campos obligatorios, tipos, valores permitidos y longitudes máximas antes de almacenar el resultado o activar otro sistema.

## Cómo usar function calling

La llamada a funciones permite que el modelo decida cuándo necesita datos externos, mientras que el código de la aplicación sigue siendo responsable de la autorización y la ejecución. El patrón seguro es: el modelo propone una llamada de herramienta, el servidor la valida, el servidor ejecuta la herramienta y el modelo recibe el resultado.

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Return valid JSON only.",
        },
        {
            "role": "user",
            "content": (
                "Extract equipment, severity, observed symptom, and next action "
                "from this report: Feeder 12 showed repeated zero-sequence current "
                "spikes after rain; inspect insulation and compare adjacent sections."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

• Valida los argumentos. Trata el JSON de llamadas de herramientas como entrada no confiable.

• Impón autorización. El modelo no decide qué tiene permitido hacer el usuario actual.

• Separa herramientas de lectura y de escritura. Requiere confirmación para acciones destructivas o visibles externamente.

• Limita el inventario de herramientas. Expón solo las herramientas relevantes para el flujo actual.

• Limita el bucle. Establece un máximo de rondas de herramientas, tokens totales, tiempo transcurrido y costo.

## Parámetros de la API de GLM-5.3 Flash (https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)

| Parámetro               | Propósito                         | Guía práctica                                            |
| ----------------------- | --------------------------------- | -------------------------------------------------------- |
| model                   | Selecciona la ruta del modelo     | Usa glm-5.3-flash.                                       |
| messages                | Conversación y entrada multimodal | Mantén el orden de roles válido; preserva mensajes de herramientas requeridos. |
| max_completion_tokens   | Limita la salida generada         | Fija por flujo de trabajo en lugar de depender del máximo del modelo. |
| temperature             | Comportamiento de muestreo        | La recomendación oficial es 1.                           |
| top_p                   | Muestreo nucleus                  | La recomendación oficial es 0.95.                        |
| reasoning_effort        | Presupuesto de razonamiento       | Usa low, high o max; debe probarse el soporte de la ruta. |
| stream                  | Salida incremental                | Usa true para respuestas interactivas.                   |
| tools                   | Definiciones de funciones         | Mantén esquemas estrechos y valida cada llamada.         |
| tool_choice             | Controla la selección de herramientas | Empieza con auto salvo que el flujo requiera una herramienta. |
| response_format         | Solicita salida legible por máquina | Valida el soporte y el JSON devuelto.                    |

## API directa de Z.ai vs CometAPI

Ambas rutas pueden ser adecuadas. La decisión trata mayormente de la propiedad de la integración, la amplitud de modelos, la facturación y la velocidad con la que la aplicación necesita funciones nativas del proveedor.

| Dimensión       | API directa de Z.ai                         | CometAPI                                           | Resultado práctico                                              |
| --------------- | ------------------------------------------- | -------------------------------------------------- | --------------------------------------------------------------- |
| Cuenta y clave  | Cuenta y clave de Z.ai                      | Cuenta y clave de CometAPI                         | Las claves no son intercambiables.                              |
| Patrón de SDK   | Compatible con OpenAI                       | Compatible con OpenAI                              | Se puede reutilizar gran parte del código cliente.              |
| Cobertura de modelos | Familia de modelos de Z.ai             | Múltiples proveedores y familias de modelos        | CometAPI es útil para enrutamiento y comparación.               |
| Funciones nativas | Acceso más temprano a comportamiento específico del proveedor | Depende de la exposición de la pasarela y el pass-through | Prueba campos avanzados en la ruta seleccionada.                |
| Facturación     | Específica del proveedor                    | Centralizada entre modelos soportados              | La facturación unificada puede simplificar operaciones multi-modelo. |
| Diseño de fallback | Requiere integrar otro proveedor         | Puede mantenerse dentro de una sola capa de pasarela | CometAPI puede reducir la fricción al cambiar.                  |
| Mejor ajuste    | Compromiso profundo con capacidades nativas de Z.ai | Acceso unificado, evaluación y enrutamiento de producción | Elige según la arquitectura del sistema, no un ganador genérico. |

Usa la API directa cuando el parámetro o la función nativa más reciente del proveedor sea esencial. Usa CometAPI cuando importe más un solo cliente, facturación unificada y la capacidad de comparar o reemplazar modelos. Para producción, ejecuta el mismo conjunto de pruebas representativas contra la ruta exacta que planeas desplegar.

## Estimación de costos y presupuesto de tokens

La página actual del modelo en CometAPI (https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) indica $0.06 por millón de tokens de entrada (https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) y $0.20 por millón de tokens de salida (https://www.cometapi.com/models/zhipuai/glm-5-3-flash/). A esas tarifas, el costo estimado por solicitud es:

costo = input_tokens / 1,000,000 x 0.06 + output_tokens / 1,000,000 x 0.20

| Carga de trabajo         | Tokens de entrada | Tokens de salida | Costo estimado |
| ------------------------ | ----------------- | ---------------- | -------------- |
| Pregunta corta           | 2,000             | 400              | $0.00020       |
| Revisión de código       | 50,000            | 4,000            | $0.00380       |
| Análisis de documento grande | 250,000       | 10,000           | $0.01700       |
| Ejecución larga de agente | 800,000          | 30,000           | $0.05400       |

Los precios cambian con el tiempo. Confirma las tarifas en vivo de entrada, entrada en caché y salida antes de publicar o presupuestar para producción. El razonamiento y los bucles de herramientas pueden incrementar la salida facturada y reingresar entradas, por lo que estima flujos de trabajo completos en lugar de una única respuesta visible.

## Mejores prácticas de producción para la API de GLM-5.3 Flash

### Controles de costo y latencia

#### Límites de salida

Los ajustes de generación en benchmarks y los límites de la API en producción son diferentes. La evaluación HLE citada usó una longitud máxima de generación de 163,840 tokens, mientras que algunas evaluaciones usaron 64K de salida; ninguno demuestra que cada ruta alojada pueda devolver más de 100,000 tokens. Establece el límite desde el esquema de la ruta en vivo y el presupuesto del flujo de trabajo. Usa límites pequeños para clasificación y extracción, medianos para análisis y más grandes solo para tareas explícitas de formato largo o agentes.

Control del contexto

Una ventana de un millón de tokens es una capacidad, no un objetivo. Recupera archivos relevantes, elimina registros duplicados, coloca instrucciones estables cerca del inicio y mide si añadir contexto mejora el éxito de la tarea.

### Estado y fiabilidad

#### Preserva el estado

Almacena los mensajes completos del asistente necesarios para el siguiente turno, incluidas las llamadas a herramientas y campos específicos de la ruta que tu aplicación haya verificado. Perder historial estructurado puede romper un bucle de herramientas multietapa incluso cuando el texto visible parece completo.

#### Reintenta selectivamente

• Reintenta fallos transitorios 429, 500, 502, 503 y timeouts de red con backoff exponencial y jitter.

• No reintentes ciegamente errores de autenticación, parámetros inválidos o solicitudes sobredimensionadas.

• Adjunta un ID de solicitud de la aplicación para que el trabajo duplicado pueda reconocerse.

• Usa controles de idempotencia alrededor de operaciones de escritura externas, incluso si la solicitud del modelo se reintenta.

### Seguridad y validación

#### Valida la salida legible por máquina

La validación de esquemas, comprobaciones de valores permitidos, límites de longitud y reglas de dominio deben situarse entre el modelo y cada base de datos, cola o API externa. Un objeto JSON sintácticamente válido aún puede estar incompleto o ser inseguro.

#### Autoriza las llamadas de herramientas

Trata las llamadas de herramientas propuestas por el modelo como solicitudes no confiables: valida argumentos, aplica autorización de usuario, separa operaciones de lectura y escritura, y exige confirmación para acciones destructivas.

### Observabilidad y fallback

#### Mide el flujo de trabajo

• Éxito de la tarea o tasa de aceptación humana

• Tiempo hasta el primer token y latencia total

• Tokens de entrada, entrada en caché, razonamiento y salida

• Recuento de llamadas a herramientas y tasa de fallos de herramientas

• Reintentos, límites de tasa y errores del proveedor

• Costo por tarea completada en lugar de costo por llamada aislada

#### Diseña el fallback

Elige un fallback por carga de trabajo, no por reputación. Un fallback solo de texto puede ser aceptable para extracción de documentos pero fallar en una tarea basada en capturas de pantalla. Define qué entradas y esquemas de herramientas son portables, qué parámetros deben eliminarse y cuándo el usuario debería ver un error recuperable en lugar de un cambio automático de modelo.

## Errores comunes y solución de problemas

| Síntoma                 | Causa probable                                                     | Qué comprobar                                                                  |
| ----------------------- | ------------------------------------------------------------------ | ------------------------------------------------------------------------------ |
| 401 Unauthorized        | Clave ausente, malformada o revocada                              | Confirma el encabezado Authorization y la variable de entorno del servidor.    |
| 404 o modelo no encontrado | ID de modelo incorrecto o ruta no disponible                   | Usa glm-5.3-flash y confirma disponibilidad en la página del modelo en vivo.   |
| 429 Rate Limit          | Se excedió la cuota de solicitudes o tokens                        | Reduce, baja la concurrencia, revisa límites de cuenta y reintenta con jitter. |
| Parámetro no soportado  | Campo nativo del proveedor no expuesto por la pasarela             | Elimina campos opcionales y añádelos de nuevo uno por uno.                     |
| Se excedió la longitud de contexto | Prompt más salida solicitada supera el límite de la ruta | Recorta, recupera, resume o baja max_completion_tokens.                        |
| Imagen inválida         | URL inaccesible, formato no soportado o Base64 malformado          | Prueba una URL directa HTTPS a la imagen y corrige el prefijo MIME.            |
| JSON transmitido roto   | Los fragmentos se analizaron como objetos completos                | Bufferiza el stream y analiza solo tras recibir el JSON completo.              |
| Bucle de herramientas interminable | Sin presupuesto de pasos o resultados de herramientas ambiguos | Limita rondas, mejora descripciones y devuelve errores explícitos de herramienta. |

## ¿Cuándo deberías usar la API de GLM-5.3 Flash?

### Buenos encajes

• Comprensión de código a escala de repositorio y revisión de múltiples archivos

• Codificación visual, análisis de capturas de pantalla y QA de interfaces

• Paquetes de documentos largos y síntesis con evidencias

• Agentes que usan herramientas con planificación y verificación repetidas

• Flujos de alto volumen donde el costo por token afecta la economía unitaria

• Aplicaciones que se benefician de cambiar o comparar modelos a través de una sola pasarela

### Usa otra ruta o modelo cuando

• El producto necesita salida de imagen o video en lugar de salida de texto.

• La tarea es una clasificación pequeña y de bajo riesgo que un modelo más simple puede manejar de forma fiable.

• Es obligatoria una función nativa del proveedor que no esté expuesta en la ruta de la pasarela.

• El flujo de trabajo no puede tolerar el razonamiento siempre activo ni su perfil de latencia asociado.

• La aplicación aún no ha probado el modelo con sus propias herramientas, datos y casos de fallo.

## FAQ

###

### ¿Qué debo verificar en la ruta exacta de CometAPI antes del lanzamiento?

Verifica la disponibilidad del modelo, formatos multimodales aceptados, salida máxima, campos de razonamiento, comportamiento de salida estructurada, límites de tasa y precios actuales con solicitudes representativas.

### ¿Qué métricas debe rastrear una evaluación de producción?

Rastrea el éxito de la tarea, el tiempo hasta el primer token, la latencia total, los tokens de entrada y salida, fallos de llamadas a herramientas, tasa de reintentos y el costo por flujo de trabajo completado, no solo el costo por llamada de API.

### ¿Cómo debo elegir entre Z.ai directo y CometAPI?

Usa Z.ai directo cuando el acceso inmediato al comportamiento nativo del proveedor sea esencial. Usa CometAPI cuando sean más importantes la autenticación unificada, la facturación, la comparación de modelos y el fallback a nivel de pasarela.

### ¿Qué hace que un fallback sea seguro?

Un fallback seguro acepta la misma modalidad de entrada, preserva los esquemas de herramientas requeridos, elimina parámetros no soportados, se mantiene dentro de los límites de autorización de la tarea y falla de forma visible cuando no se puede preservar el comportamiento.

## Conclusión

GLM-5.3 Flash (https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) es más útil a través de una API cuando el contexto largo, la entrada visual, el razonamiento y el uso de herramientas forman parte de un mismo flujo de trabajo. La integración básica con CometAPI es pequeña: una clave del lado del servidor, un cliente compatible con OpenAI, el ID de modelo glm-5.3-flash (https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) y el endpoint de chat-completions. La calidad en producción proviene de todo lo que rodea esa solicitud: prompts acotados, límites de salida, validación de esquemas, autorización de herramientas, reintentos, observabilidad y evaluación específica del flujo de trabajo.

Empieza con una llamada corta de texto, añade una capacidad avanzada a la vez y prueba el recorrido completo del usuario antes de escalar. Confirma la página del modelo GLM-5.3 Flash en vivo (https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) para ver disponibilidad actual, comportamiento soportado de la ruta y precios.

## Metadatos SEO

Título meta: How to Use GLM-5.3 Flash API: Developer Guide

Descripción meta: Aprende a usar la API de GLM-5.3 Flash con CometAPI, incluyendo ejemplos en Python y JavaScript, visión, streaming, tools, salida JSON y mejores prácticas.

Palabras clave: GLM-5.3 Flash API, how to use GLM-5.3 Flash, GLM-5.3 Flash Python, GLM-5.3 Flash JavaScript, GLM-5.3 Flash CometAPI, GLM API tutorial, multimodal API, reasoning API, function calling

URL slug: how-to-use-glm-5-3-flash-api