
TL;DR
A 9 de octubre de 2026, los informes sugieren que Kimi K3.1 podría llegar este mes, pero las fuentes revisadas no establecen una fecha oficial de lanzamiento, precios finales ni resultados de benchmarks específicos de K3.1. Las etiquetas Low / High / Max, Extra Long, Agent y Swarm reportadas se superponen con funciones existentes de K3. La posible mejora importa si incrementa la eficiencia de razonamiento, la fiabilidad en contexto largo y el costo por tarea completada; las etiquetas de configuración por sí solas no demuestran esas ganancias.
Conclusiones clave
- Calendario de lanzamiento: octubre es una posibilidad reportada por medios, sin compromiso oficial de lanzamiento según las fuentes citadas.
- Pistas técnicas: Low / High / Max y una opción reportada de 1M tokens se superponen con capacidades de K3; la arquitectura y los límites finales de K3.1 siguen sin confirmarse.
- Flujos de trabajo de agentes: las flags de Agent, Swarm, search y batch indican posible trabajo de integración, no mejoras medidas.
- Rendimiento y precios: los resultados y tarifas publicados de K3 son líneas base de referencia, no benchmarks ni aranceles de K3.1.
- Preparación de API: confirme IDs de modelo habilitados, parámetros documentados y acceso de cuenta antes de desplegar K3.1 a través de CometAPI.
¿Qué es Kimi K3.1?
Kimi K3.1 es una iteración reportada de la familia de modelos Kimi de Moonshot AI. Identificadores de configuración filtrados sugieren trabajo en razonamiento, contexto largo y flujos de trabajo de agentes. Sus especificaciones finales, fecha de lanzamiento y precios no están establecidos por las fuentes revisadas, por lo que debe tratarse como un modelo prospectivo y no como un lanzamiento público confirmado.
¿Qué sabemos sobre Kimi K3.1?
La publicación original muestra un identificador relacionado con K3.1
El 23 de septiembre de 2026, @MaxForAI publicó una captura de configuración mostrando k3d1-agent. Esta es la imagen original asociada con la publicación; su procedencia interna y estado de producción no han sido autenticados de forma independiente.
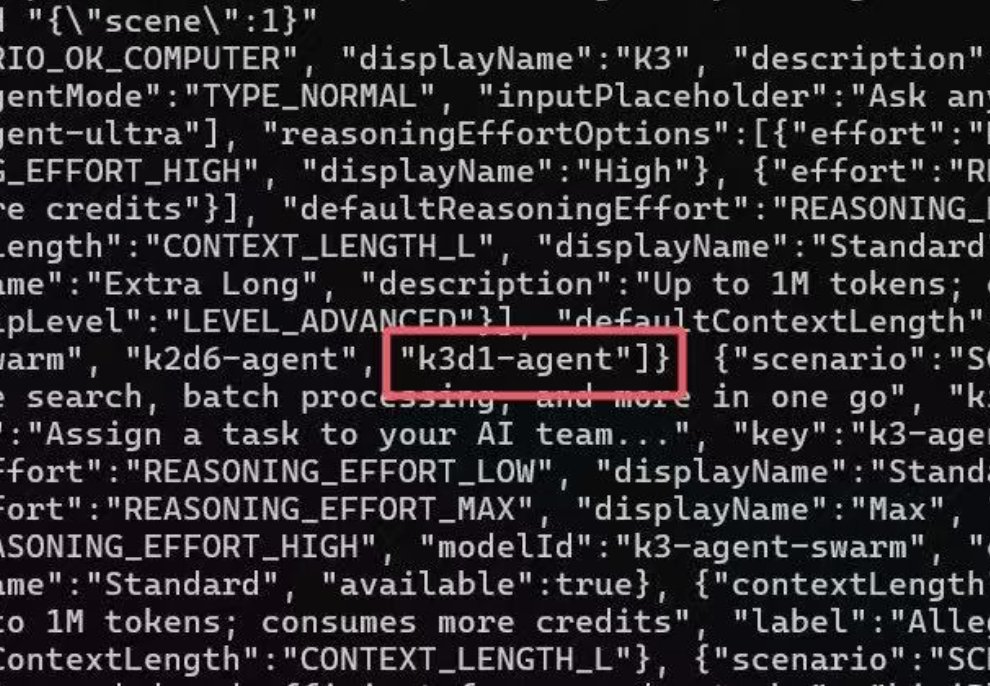
Fuente de la imagen: publicación original de @MaxForAI. La imagen contiene ajustes de esfuerzo de razonamiento y contexto junto con identificadores de agentes. Las cadenas de configuración visibles no prueban que cada opción pertenezca a K3.1.
El informe de Wccftech del 23 de septiembre interpreta la captura como una señal de desarrollo de K3.1. El seguimiento de IT Home del 24 de septiembre repite las opciones reportadas. Estos informes son interpretaciones secundarias de la misma filtración, no una confirmación independiente de preparación para el lanzamiento.
Las opciones reportadas apuntan a razonamiento y flujos de trabajo de agentes
Los informes describen ajustes de razonamiento Low / High / Max, una opción Extra Long de hasta 1M tokens y flags de Agent, Swarm, search y batch. Estas pistas sugieren posible integración de flujos de trabajo. No divulgan una arquitectura final, una ganancia de rendimiento validada ni un esquema de API pública soportado.
Los informes de medios difieren en la ventana de lanzamiento
Wccftech describe una posible llegada antes de octubre, mientras que IT Home menciona octubre de 2026. Esa discrepancia limita la utilidad de cualquiera de los pronósticos. Ninguno de los informes aporta un anuncio fechado de lanzamiento por parte de Moonshot.
Un identificador de modelo puede representar un checkpoint privado, una ruta inacabada, un despliegue en etapas o una vista previa con control de acceso. No puede, por sí solo, establecer un lanzamiento comercial de API. Los significados precisos y la disponibilidad de las flags filtradas siguen siendo inciertos.
¿Cuándo se lanzará Kimi K3.1?
Las fuentes revisadas no establecen una fecha oficial de lanzamiento de Kimi K3.1. IT Home reporta octubre de 2026, mientras que la cobertura anterior de Wccftech dice antes de octubre. Son pronósticos mediáticos divergentes, no un calendario de desarrollo verificado. Una captura no puede establecer fechas de despliegue, elegibilidad de cuentas o preparación de producción.
Busque un anuncio fechado de Moonshot, IDs de modelo soportados, documentación para desarrolladores y condiciones de acceso antes de tratar una fecha de lanzamiento como confirmada. La fijación de precios y las evaluaciones reproducibles específicas de K3.1 son evidencias separadas necesarias para decisiones de despliegue.
¿Qué especificaciones podría ofrecer Kimi K3.1?
La base técnica más sólida es el existente Kimi K3, un lanzamiento de julio de 2026 con una arquitectura MoE dispersa de 2,8 billones de parámetros, entrada visual nativa y una ventana de contexto comúnmente descrita como 1M tokens. Las fuentes citadas no establecen la arquitectura, el conteo de parámetros ni resultados de evaluación específicos de K3.1.
El resumen oficial del modelo especifica 104B parámetros activados y una ventana de contexto de 1.048.576 tokens. Su anuncio de pesos abiertos del 27 de julio confirma la publicación de los pesos de K3. Estas especificaciones aplican a K3, no al rumorado K3.1.
| Especificación | Kimi K3 | Kimi K3.1 |
|---|---|---|
| Lanzamiento | Julio de 2026 | Posiblemente octubre de 2026 |
| Parámetros totales | 2,8 billones | No divulgado |
| Parámetros activados | 104 mil millones (resumen oficial del modelo) | No divulgado |
| Arquitectura | Sparse MoE, KDA, AttnRes | No divulgado |
| Contexto | 1.048.576 tokens (aproximadamente 1M) | Hasta 1M sugerido |
| Razonamiento | Low / High / Max en la documentación actual de Kimi Code | Flags Low / High / Max |
| Visión | Entrada visual nativa | No confirmado |
| Swarm | Capacidad existente de Kimi Swarm | Se reporta aparición de flag |
| Precio de API | Tarifa publicada de K3 | Sin precios finales |
| Pesos | Pesos de K3 publicados | Desconocido |
¿Qué características se reportan para Kimi K3.1?
Los tres temas siguientes combinan las pistas reportadas de K3.1 con capacidades documentadas de K3. Explican lo que podrían significar los ajustes sin presentar funciones rumoreadas de K3.1 como especificaciones confirmadas.
Tres niveles de razonamiento ofrecen un trade-off de esfuerzo
Low, High y Max son etiquetas de configuración reportadas para K3.1. Describen un trade-off de esfuerzo, no una nueva arquitectura. La documentación actual de Kimi Code soporta low / high / max para K3, con high como predeterminado. Este es un ajuste de Kimi Code; no debe asumirse que predeterminados y derechos sean idénticos en todas las APIs o productos.
Low puede convenir a extracción, Q&A simple y clasificación rutinaria cuando la menor latencia importa. High puede ofrecer un equilibrio práctico para desarrollo multi-paso y trabajo con documentos. Max puede asignar más presupuesto de razonamiento a código o investigación difíciles, con mayor latencia y posible costo. Estos mapeos de tareas son interpretaciones a probar, no garantías verificadas de K3.1.
Estos ejemplos de cargas de trabajo son interpretaciones analíticas, no garantías de servicio verificadas de K3.1. Los desarrolladores deberían comparar calidad por unidad de gasto: una ejecución de alto esfuerzo puede costar más por intento, pero menos reintentos podrían reducir el costo total del flujo de trabajo. La mejora significativa sería aumentar el éxito de tareas a un presupuesto comparable de tokens y herramientas.
Una opción de 1M tokens extiende la base de contexto largo
Una ventana de un millón de tokens puede acomodar repositorios de código sustanciales, documentos técnicos largos, historiales de proyecto y trazas extensas de herramientas. Pero la longitud máxima de contexto no equivale a uso preciso de información distante. Un modelo productivo aún debe recuperar los hechos correctos, mantener consistencia entre documentos y mantener la latencia de prefill manejable.
Evalúe contexto largo probando recuperación en diferentes posiciones del prompt, consistencia entre documentos y tiempo hasta el primer token. Mida la reutilización de caché y el costo de retener o comprimir el historial del agente también. Un límite nominal de 1M tokens es útil solo si el modelo puede recuperar evidencia distante con precisión dentro de una latencia y presupuesto aceptables.
Moonshot reporta una puntuación BrowseComp de K3 de 90.4 con un contexto de 1M tokens y sin gestión de contexto. Esta es una condición de evaluación específica de K3, distinta de resultados con contexto compactado y de cualquier afirmación de rendimiento de K3.1.
Las flags de Agent y Swarm sugieren ejecución coordinada de tareas
Los identificadores relacionados con agentes y las flags de Swarm son quizá más interesantes que el número de contexto. Kimi ya soporta trabajo multi-agente; por lo tanto, la mejora rumoreada debería mejorar enrutamiento, delegación, agregación de resultados y control de costos, más que simplemente añadir una etiqueta Swarm.
En un flujo orquestado plausible, un coordinador descompone una solicitud compleja en subtareas de investigación, codificación, pruebas y síntesis. Trabajadores especializados se ejecutan en paralelo, devuelven evidencia y son reconciliados por el coordinador. Tal paralelismo puede reducir el tiempo transcurrido a la vez que incrementa el total de llamadas al modelo, por lo que la velocidad de reloj y el costo deben reportarse por separado.
La documentación oficial de Agent Swarm de Kimi describe la ejecución paralela de agentes existente. El ejemplo siguiente ilustra cómo dicha orquestación puede dividir el trabajo; no establece la configuración final de K3.1 ni una topología Swarm requerida.
Un trabajador de investigación puede recuperar fuentes y verificar citas; un trabajador de codificación puede modificar módulos y devolver evidencia de ejecución; un trabajador de análisis puede comparar alternativas con cálculos reproducibles. Un coordinador asigna tareas, reconcilia desacuerdos y limita el presupuesto. La salida de cada trabajador necesita verificación antes de aceptar el resultado combinado.
Para K3.1, los desarrolladores deberían buscar benchmarks reproducibles de tareas de agente end-to-end exitosas, recuperación ante fallos, manejo de desacuerdos entre agentes, conteo de llamadas a herramientas y gasto total. Las flags de configuración por sí solas no pueden establecer una mejora.
¿Cómo se compara Kimi K3.1 con K3 en benchmarks?
No hay disponible una tabla verificada específica de benchmarks de K3.1. Las siguientes cifras provienen de las evaluaciones oficiales de K3 de Moonshot, mostradas únicamente como línea base de comparación. Diferentes harnesses de modelos y ajustes de evaluación limitan inferencias estrictas de manzanas con manzanas.
| Benchmark | Kimi K3 | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| DeepSWE | 67.5 | 73.0 | 70.0 |
| Terminal-Bench 2.1 | 88.3 | 88.8 | 88.0 |
| FrontierSWE | 81.2 | 71.3 | 86.6 |
| Program Bench | 77.8 | 77.6 | 76.8 |
| Kimi Code Bench 2.0 | 72.9 | 64.8 | 76.9 |
| SWE Marathon | 42.0 | 39.0 | 35.0 |
Discrepancia de fuente: el visual original muestra Fable 5 en 84.6 en Terminal-Bench 2.1, mientras que la tabla de evaluación del repositorio oficial reporta 88.0. La tabla anterior sigue el repositorio; la imagen oficial se reproduce sin alteración.
Las notas de evaluación especifican esfuerzo máximo de K3, temperatura 1.0 y top-p 1.0. DeepSWE v1.1 usa Kimi Code aquí; el resultado de mini-SWE-agent citado por separado es 67.3. Terminal-Bench usa Kimi Code para K3, Terminus 2 para Fable 5 y Codex para Sol. FrontierSWE usa Kimi Code/Codex y puntuaciones de dominancia del 16 de julio; ProgramBench usa Kimi Code para K3. KCB 2.0 usa Kimi Code/Claude Code para K3 y Claude Code/Codex para Fable/Sol. SWE Marathon usa una rama v1.1 calibrada H20 con Claude Code/Codex; Fable tuvo fallbacks en 35% de las tareas. Son resultados reportados por el proveedor bajo harnesses diferentes.
Consulte las notas de evaluación oficiales para el protocolo completo de cada benchmark; las cifras no establecen una comparación controlada de K3.1.
K3 es particularmente competitivo en Program Bench y SWE Marathon en este conjunto, mientras que los líderes comparativos varían por prueba. No se puede declarar que K3.1 sea más rápido o más preciso hasta que se publiquen pruebas con un harness de agentes documentado, presupuesto de razonamiento y fecha de evaluación.
¿Cómo podrían ser los precios del API de Kimi K3.1?
La tarifa de lanzamiento oficial de K3 es US$0.30 de entrada en caché, US$3 de entrada sin caché y US$15 de salida por millón de tokens. La siguiente tabla registra ese esquema de referencia, no una tarifa actual verificada de K3.1. Las tarifas de K3.1 y cualquier cargo de orquestación requieren confirmación por separado.
| Medición | API de Kimi K3 en CometAPI (referencia de tarifa de lanzamiento oficial) | API de Kimi K3.1 en CometAPI (tarifa no confirmada) |
|---|---|---|
| Entrada en caché | US$0.30 / 1M tokens | Sin confirmar |
| Entrada sin caché | US$3.00 / 1M tokens | Sin confirmar |
| Salida | US$15.00 / 1M tokens | Sin confirmar |
| Orquestación de agentes | Depende del uso real | Sin confirmar |
A estas tarifas de referencia de K3, 100.000 tokens de entrada sin caché más 10.000 tokens de salida costarían US$0.45. Este es un ejemplo aritmético ilustrativo de K3, no un precio de K3.1. La planificación empresarial debe usar costo por tarea verificada en lugar de solo tokens.
¿Cómo pueden los desarrolladores prepararse para el acceso al API de Kimi K3.1?
Las comprobaciones de acceso preceden a la integración
Los desarrolladores pueden seguir la API de Kimi K3.1 en CometAPI para actualizaciones de acceso. El 9 de octubre de 2026, la sección de disponibilidad de la página aún dice Coming Soon, junto a texto genérico sobre endpoint y health. Trate esa página inconsistente como un enlace de descubrimiento; confirme un ID de modelo habilitado y una prueba exitosa a nivel de cuenta antes de asumir acceso a producción.
Una lista de verificación guía la decisión de despliegue
| Pregunta | Evidencia disponible ahora | Confirmación necesaria |
|---|---|---|
| ¿Lanzamiento? | Informes de filtraciones de septiembre | Anuncio de lanzamiento de Moonshot |
| ¿Nueva arquitectura? | No hay model card de K3.1 | Informe técnico y parámetros |
| ¿Mejor razonamiento? | Tres modos de esfuerzo conocidos | Calidad/costo vs K3 en cada nivel |
| ¿Mejor contexto largo? | Opción reportada de 1M | Precisión y latencia en 1M |
| ¿Mejor multi-agente? | Flags de configuración Agent/Swarm | Benchmarks de éxito y costo de agentes |
| ¿Acceso de API en producción? | Indicador Coming Soon | IDs soportados, docs, precios |
La preparación puede comenzar con evaluaciones portátiles y un presupuesto de prueba acotado. La migración debe esperar a acceso documentado y ganancias reproducibles a nivel de carga de trabajo. La decisión es si K3.1 produce resultados aceptados con mayor fiabilidad y economía, más que si existe una página de catálogo o una flag de configuración.
Preguntas frecuentes
¿Cómo pueden los desarrolladores verificar el acceso a Kimi K3.1?
Confirme el ID de modelo soportado por el proveedor y el derecho de su cuenta, luego ejecute una solicitud pequeña e inspeccione el identificador de modelo devuelto, el uso y los errores. Una llamada exitosa verifica el acceso para esa cuenta y ruta en ese momento; una entrada de catálogo o una etiqueta de health por sí sola no establece un lanzamiento público ni una cuota estable.
¿Puede Kimi K3.1 reemplazar a K3 en un agente existente?
Trate la migración como un cambio de compatibilidad. Revise esquemas de herramientas, manejo del historial de razonamiento, formatos de salida y comportamiento de timeouts antes de reproducir tareas representativas. Use una línea base fijada y mantenga enrutamiento de rollback. Un nombre de modelo similar o un límite de contexto no es evidencia suficiente de que sesiones de larga duración se comporten de forma idéntica.
¿Cómo deberían los equipos presupuestar un piloto de Kimi K3.1?
Empiece con un conjunto de tareas acotado en lugar de extrapolar un precio de tokens rumoreado. Rastree entrada sin caché, aciertos de caché, tokens de razonamiento/salida, llamadas a herramientas, reintentos y tiempo de corrección humana. Reserve un presupuesto de evaluación fijo y compare costo por resultado aceptado después de que se documenten las tarifas finales.
¿Qué contaría como una actualización significativa de Kimi K3.1?
Exija ganancias reproducibles en su carga de trabajo con presupuestos comparables de razonamiento y herramientas. Pruebe recuperación de evidencia distante, documentos conflictivos, recuperación de agentes y aceptación de tareas end-to-end. Registre tasa de fallos, latencia y gasto total juntos; una ventana nominal mayor o una flag adicional de configuración por sí sola es insuficiente.
Conclusión
Kimi K3.1 debe tratarse como un lanzamiento prospectivo reportado. La evidencia revisada identifica posible trabajo de configuración, mientras que K3 ya ofrece contexto largo, esfuerzo ajustable y ejecución Swarm. La oportunidad práctica es mejor calidad de tareas a un costo sostenible. Prepare evaluaciones portátiles ahora y tome decisiones de migración después de que estén disponibles especificaciones oficiales, condiciones de acceso, precios y resultados reproducibles de K3.1.