

TL;DR
MiMo-V2.5 es la opción predeterminada más sólida para trabajo multimodal, agentes rutinarios y producción sensible al costo. MiMo-V2.5-Pro es la opción especializada para razonamiento difícil, programación a escala de repositorio y uso prolongado de herramientas. Ambos proporcionan una ventana de contexto de 1M tokens y hasta 128K tokens de salida, pero Pro utiliza un backbone lingüístico mucho más grande y cuesta aproximadamente 3.1× más para tokens ordinarios de entrada y salida.
MiMo-V2.5 vs. Pro: decisión rápida
| Especificación — lanzamiento oficial | MiMo-V2.5 | MiMo-V2.5-Pro | Modelo recomendado | Motivo |
|---|---|---|---|---|
| Posicionamiento principal | Modelo multimodal y agentes eficientes | Agente insignia y codificación compleja | Elegir según la carga de trabajo | Las entradas multimodales favorecen V2.5; el trabajo textual difícil sostenido favorece Pro. |
| Arquitectura | MoE disperso | MoE disperso | Elegir según la carga de trabajo | El tamaño del modelo por sí solo no establece una mejor elección para cada tarea. |
| Parámetros totales | 310B | 1.02T | Elegir según la carga de trabajo | El modelo más grande apunta al razonamiento difícil, pero el tamaño no es un resultado. |
| Parámetros activados | 15B | 42B | Elegir según la carga de trabajo | Use la finalización de la tarea y el costo para decidir. |
| Capas del LLM | 48 | 70 | Elegir según la carga de trabajo | El conteo de capas describe la arquitectura, no una victoria universal. |
| Expertos enrutados | 256 | 384 | Elegir según la carga de trabajo | La diferencia importa solo si mejora la carga de trabajo objetivo. |
| Expertos activados por token | 8 | 8 | Cualquiera | Ambos activan ocho expertos por token. |
| Ventana de contexto | 1M tokens | 1M tokens | Cualquiera | Ambos anuncian una ventana de 1M tokens; pruebe la recuperación efectiva. |
| Salida máxima | 128K tokens | 128K tokens | Cualquiera | Ambos anuncian hasta 128K tokens de salida. |
| Modalidades de entrada | Texto, imagen, video y audio | Texto | MiMo-V2.5 | Acepta entrada de imagen, video y audio; Pro se centra en entrada de texto. |
| Invocación de herramientas | Sí | Sí | Elegir según la carga de trabajo | Ambos invocan herramientas; pruebe la tasa de éxito en la trayectoria real. |
| Pesos abiertos y licencia | Sí; MIT | Sí; MIT | Cualquiera | Ambos ofrecen pesos abiertos bajo MIT; los costos de servicio difieren. |
La diferencia decisiva: multimodal vs. primero-agente
V2.5 acepta de forma nativa texto, imágenes, video y audio. Xiaomi combina el backbone lingüístico con un codificador visual de 729M parámetros y un codificador de audio de 261M parámetros, permitiendo que la información multimodal participe directamente en el mismo flujo de razonamiento.
- Analizar capturas de pantalla antes de invocar herramientas.
- Entender un video y su pista de audio en conjunto.
- Extraer información de diagramas e imágenes de documentos.
- Operar agentes con soporte de interfaz visual y multimodal.
- Razonar sobre secuencias de video largas.
V2.5-Pro sigue un diseño diferente. Xiaomi especifica actualmente texto como la modalidad de entrada y enfatiza el razonamiento profundo, el desarrollo de código y la orquestación de herramientas de larga duración.
Si el flujo de trabajo incluye entrada de imagen, video o audio, comience con V2.5. Pruebe Pro cuando lo difícil sea razonar sobre texto, código fuente, herramientas o una trayectoria de agente prolongada.

Comparación oficial de Xiaomi en benchmark multimodal.
Por qué V2.5-Pro puede ser mejor en tareas difíciles
Escala del modelo: 310B/15B vs. 1.02T/42B
Ambos modelos usan backbones dispersos de Mixture-of-Experts, atención híbrida de ventana deslizante y global, y tres módulos de predicción multi-token. La ficha técnica de V2.5 documenta un backbone de 310B totales y 15B activos; la ficha de Pro escala a 1.02T parámetros totales con 42B activados por token.
| Arquitectura — ficha técnica oficial | V2.5 | Pro | Diferencia |
|---|---|---|---|
| Parámetros totales | 310B | 1.02T | Aproximadamente 3.3× |
| Parámetros activos | 15B | 42B | 2.8× |
| Tamaño oculto | 4,096 | 6,144 | 1.5× |
| Capas del LLM | 48 | 70 | 22 más |
| Cabezas de atención | 64 | 128 | 2× |
| Expertos enrutados | 256 | 384 | 1.5× |
| Expertos por token | 8 | 8 | Igual |
| Capas MTP | 3 | 3 | Igual |
V2.5 usa un patrón de atención 5:1, mientras que Pro pasa a un patrón local-a-global de 6:1. Xiaomi afirma que estos diseños reducen los requisitos de la KV-cache en casi 6× y 7× respectivamente, en comparación con atención completa en toda la red.
Los parámetros totales no se traducen linealmente en calidad de respuesta. El backbone más grande de Pro importa sobre todo cuando la dificultad del razonamiento o la longitud de la trayectoria hacen que pequeñas ganancias de fiabilidad por paso se acumulen.
Por qué pequeñas ganancias de fiabilidad se acumulan
Una tarea de agente larga tiene muchos pasos dependientes. Un error en una llamada de herramienta temprana puede forzar reintentos o invalidar trabajo posterior, por lo que una ganancia modesta en la fiabilidad por paso puede tener un efecto mayor en la finalización de extremo a extremo. Evalúe ese efecto en tareas representativas en lugar de asumir que el tamaño del modelo lo garantiza.
¿Dónde mejora realmente V2.5-Pro?
La comparación numérica más limpia es la evaluación del modelo base de Xiaomi, donde ambos modelos aparecen bajo los mismos ajustes. Esto evita combinar resultados producidos por arneses o configuraciones de postentrenamiento no relacionadas.
Conocimiento general: ganancias pequeñas a moderadas
En la comparación del modelo base de Xiaomi, Pro gana 1.2 puntos en BBH, 3.1 en MMLU y 2.7 en MMLU-Pro. Son medibles pero menores que sus ganancias en tareas de razonamiento más difíciles.
Matemáticas y ciencia: ganancias mayores
Pro gana 8.6 puntos en GPQA-Diamond, 16.3 en GSM8K y 18.5 en MATH en la misma evaluación de modelo base. Esta es la evidencia más clara para elegir Pro cuando el razonamiento difícil impulsa el éxito de la tarea.
Programación: mejor, pero no uniformemente mejor
Las ganancias reportadas son 4.3 puntos en HumanEval+, 3.2 en MBPP+, 4.1 en LiveCodeBench v6 y 4.9 en SWE-Bench AgentLess. Pruebe por separado las tareas a nivel de repositorio y el uso de herramientas: estas puntuaciones del modelo base no miden todos los flujos de trabajo de agentes en producción.
Resultado del benchmark: Pro no es tres veces mejor porque cuesta aproximadamente tres veces más. Se vuelve progresivamente más valioso a medida que aumentan la dificultad del razonamiento y la duración de la tarea.
Estas filas son evaluaciones de modelos base, no una promesa de que una API de producción reproducirá las mismas puntuaciones. Los resultados de agentes dependen de herramientas, prompts, reintentos, entorno de ejecución y presupuestos de tokens.
Postentrenamiento y agentes de largo horizonte
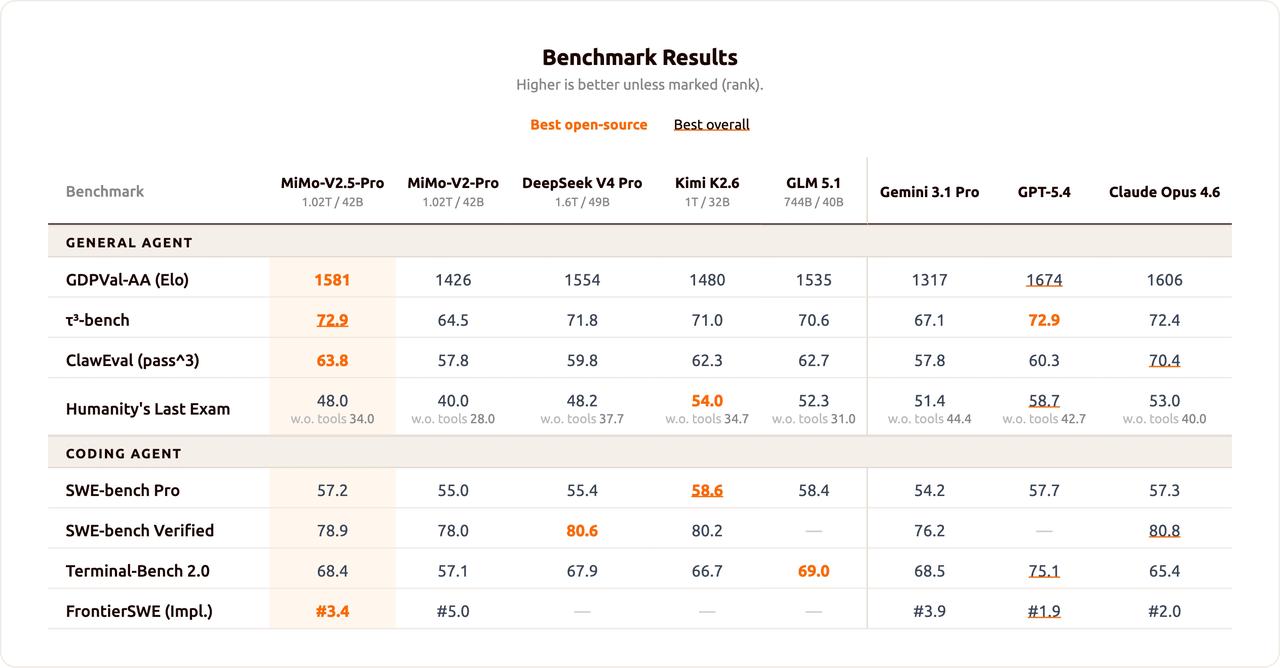
Los modelos de producción añaden ajuste supervisado, aprendizaje por refuerzo orientado a agentes y destilación on-policy multi-docente. Xiaomi reporta puntuaciones postentrenamiento de 56.1 en SWE-bench Pro, 65.8 en Terminal-Bench 2.0 y 62.1 Pass³ en la porción general de Claw-Eval para V2.5.
Pro está más explícitamente optimizado para ingeniería de software de largo horizonte. Xiaomi describe cientos de llamadas a herramientas en trayectorias sostenidas y publica un 78.9% en SWE-bench Verified.
Un estudio de caso oficial muestra a Pro completando un compilador SysY en 4.3 horas con 672 llamadas a herramientas y los 233 tests aprobados. La lección no es que toda solicitud de código necesite Pro; es que pequeñas diferencias de fiabilidad pueden determinar si un flujo de trabajo con cientos de acciones dependientes se completa.

Figura oficial de Xiaomi sobre benchmarks de codificación y agentes.
Contexto largo: misma capacidad, distintas cargas de trabajo
Ambos modelos proporcionan una ventana de contexto de 1M tokens y hasta 128K tokens de salida a través de la API actual de Xiaomi. Por lo tanto, el tamaño bruto del contexto no los diferencia.
V2.5 es atractivo cuando el contexto largo incluye material multimodal como video, imágenes de documentos o trazas de agentes visuales. Pro es el modelo a probar cuando el propio contexto se convierte en el problema de razonamiento: un repositorio grande, un contrato largo, un corpus de investigación o una trayectoria de agente con muchas acciones secuenciales.
Una gran ventana de contexto describe capacidad, no fidelidad de razonamiento garantizada. Evalúe recuperación, retención de instrucciones y uso de evidencias en las longitudes que importan a la aplicación.
Precio y eficiencia de costos
Los precios de pago por uso de Xiaomi en el extranjero dejan claro el intercambio.
| Precios — tabla oficial | V2.5 | Pro | Relación |
|---|---|---|---|
| Entrada sin caché por 1M de tokens | $0.14 | $0.435 | 3.11× |
| Entrada en caché por 1M de tokens | $0.0028 | $0.0036 | 1.29× |
| Salida por 1M de tokens | $0.28 | $0.87 | 3.11× |
| Ventana de contexto | 1M | 1M | Igual |
| Salida máxima | 128K | 128K | Igual |
Una solicitud con 1M tokens de entrada sin caché y 200K tokens de salida cuesta un estimado de $0.196 en V2.5 y $0.609 en Pro antes de aciertos de caché, cargos por búsquedas web o facturación específica del proveedor.
La diferencia de precio con caché es menor: Pro es aproximadamente 29% más caro para entradas con acierto de caché, en lugar de 211% más caro. Por lo tanto, los agentes de larga duración con prompts de sistema estables, definiciones de herramientas o prefijos de repositorio deberían medir su tasa real de acierto de caché.
Estime el costo por tarea exitosa. Un agente Pro que complete un flujo de trabajo difícil una vez puede costar menos que intentos repetidos fallidos en un modelo más económico.
¿Qué modelo debería usar?
| Carga de trabajo — guía oficial | Mejor opción | Por qué |
|---|---|---|
| Chat de texto rutinario | V2.5 | Menor costo; Pro suele ser innecesario |
| Generación de alto volumen | V2.5 | Precio de token estándar ~3.1× más bajo |
| Comprensión de imagen, video o audio | V2.5 | Entrada multimodal nativa |
| Invocación rutinaria de herramientas | V2.5 | Agente sólido a menor costo |
| Matemáticas y ciencia difíciles | Pro | Mayores ganancias en benchmarks |
| Codificación a escala de repositorio | Pro | Diseñado para ingeniería de software compleja |
| Cientos de llamadas de herramientas dependientes | Pro | Mejor ajuste para ejecución sostenida |
| Contexto de 1M sensible al costo | V2.5 | Mismo contexto nominal a mucho menor costo |
Resultado de selección: V2.5 es el predeterminado para aplicaciones multimodales, agentes rutinarios y cargas sensibles al costo. Pro es la mejora para razonamiento difícil, ingeniería de software compleja y trayectorias autónomas largas.
Una mejor estrategia de producción: enrutar entre ambos
Una elección global única de modelo suele ser innecesaria. Enrute solicitudes multimodales y rutinarias a V2.5, y escale solo el razonamiento textual difícil, la codificación compleja o la ejecución de largo horizonte a Pro.
| Dimensión de evaluación | Medida | Por qué importa | Señal de enrutamiento |
|---|---|---|---|
| Finalización | Tareas exitosas / intentos | Captura la fiabilidad de extremo a extremo | Escalar clases con baja finalización |
| Calidad | Puntuación humana o por rúbrica | Evita que el costo de tokens domine | Escalar tareas de alto impacto |
| Fiabilidad de herramientas | Errores y reintentos | Pequeños errores se acumulan en agentes | Escalar trayectorias largas |
| Latencia | Tiempo hasta resultado aceptado | Incluye sobrecarga por reintentos | Mantener ligeras las tareas interactivas |
| Costo | Gasto por tarea aceptada | Refleja fallas y reejecuciones | Usar el modelo más barato que tenga éxito |
Prueba ambas API en CometAPI
API de MiMo-V2.5 en CometAPI y API de MiMo-V2.5-Pro en CometAPI admiten evaluación lado a lado a través de una misma capa de agregación. Envíe los mismos prompts, instrucciones de sistema, herramientas y límites de salida a ambos modelos, y compare el éxito de tareas y el costo.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["mimo-v2.5", "mimo-v2.5-pro"]
prompt = """
Review this implementation plan.
Identify hidden technical risks and propose the three highest-priority fixes.
"""

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=2000,
    )
    print(f"\n--- {model} ---")
    print(response.choices[0].message.content)
Ejecútese un lote representativo que contenga solicitudes sencillas, razonamiento difícil, edición de código, tareas de contexto largo y llamadas de herramientas de agentes. Registre tasa de finalización, tokens, latencia, errores de herramientas, reintentos, calidad de respuesta y costo por tarea exitosa.
Limitaciones
Limitaciones de V2.5
El backbone lingüístico más pequeño deja rendimiento sobre la mesa a medida que aumenta la dificultad del razonamiento. La brecha es modesta en BBH pero se vuelve mucho mayor en GPQA-Diamond y MATH. Una ventana de contexto de 1M tokens tampoco debe confundirse con una fidelidad de razonamiento garantizada a 1M tokens.
Limitaciones de Pro
Los precios ordinarios de entrada y salida son aproximadamente 3.1× los de V2.5, y su entrada solo de texto lo hace inadecuado como reemplazo directo para aplicaciones multimodales. El modelo de pesos abiertos de 1.02T parámetros también es un proyecto exigente para autoalojamiento, aunque 42B parámetros se activan por token.
Veredicto final
Elija V2.5 para aplicaciones multimodales, agentes rutinarios y producción sensible al costo. Elija Pro para razonamiento difícil, ingeniería de software compleja y agentes autónomos de larga duración. Para cargas mixtas, enrute la mayor parte del tráfico a V2.5 y escale solo las solicitudes cuya dificultad o longitud de trayectoria justifique el costo adicional.
Preguntas frecuentes
¿Pro siempre es mejor que V2.5?
No. Pro es más fuerte en razonamiento textual difícil y codificación, pero V2.5 admite entrada de imagen, video y audio y es sustancialmente más económico.
¿Ambos modelos admiten una ventana de contexto de 1M tokens?
Sí. Ambos anuncian 1M tokens de contexto y hasta 128K tokens de salida. Aun así, las aplicaciones deben probar recuperación y razonamiento en sus longitudes operativas reales.
¿Qué modelo debería usar un agente multimodal?
Comience con V2.5 porque acepta de forma nativa entrada visual y de audio. Pro actualmente se orienta a flujos de trabajo con entrada de texto.
¿Cuándo vale la pena Pro pese a su mayor precio?
Es más defendible cuando una mejor fiabilidad de razonamiento afecta la finalización de matemáticas difíciles, codificación a escala de repositorio o trayectorias largas con muchas llamadas de herramientas dependientes.
¿Los sistemas de producción deberían usar un solo modelo?
No necesariamente. Una capa de enrutamiento puede mantener el trabajo rutinario y multimodal en V2.5 mientras escala el razonamiento textual difícil y las tareas de agentes a Pro.