
TL;DR
Tencent Hunyuan presentó Hyra 2.0 el 2 de noviembre de 2026 como un Harness de investigación para desarrollar modelos científicos, herramientas de software y flujos de trabajo reutilizables. Su característica definitoria es la coordinación persistente a lo largo de experimentos de varios días o semanas.
La versión pública actualmente consiste en artefactos de investigación seleccionados —modelos, código, pesos y reportes— en lugar de un servicio alojado de Hyra 2.0 de disponibilidad general. Al 4 de noviembre de 2026, los materiales públicos de Tencent no documentan una API de orquestación de propósito general ni un plan de suscripción.
Puntos clave
- Objetivo de investigación: Hyra 2.0 desarrolla modelos científicos y herramientas reutilizables que pueden respaldar más de un proyecto de investigación.
- Coordinación persistente: los agentes Overall, Mission y Worker dividen responsabilidades, mientras que las colas y los registros de investigación preservan el progreso a lo largo de experimentos prolongados.
- Conocimiento reutilizable: la memoria de los agentes, los Books y las habilidades de investigación retienen hallazgos junto con su evidencia de respaldo y condiciones de uso.
- Resultados específicos por tarea: los modelos lanzados de proteínas, campos de fuerza y células abordan diferentes cargas de trabajo científicas; la velocidad y la calidad deben evaluarse conjuntamente.
- Acceso práctico: comience con los artefactos de investigación disponibles. El Harness completo de Hyra y las APIs de modelos alojados de Hunyuan son ofertas distintas.
¿Qué es Tencent Hunyuan Hyra 2.0?
Hyra 2.0 significa Hunyuan Research Agent 2.0, un sistema multiagente diseñado para automatizar investigaciones científicas complejas y flujos de trabajo de ingeniería.
Tencent presenta Hyra 2.0 como un cambio desde la resolución de problemas aislados hacia el desarrollo de los modelos, métodos e infraestructura utilizados para investigar una clase más amplia de preguntas.
Hyra 2.0 no es un modelo fundacional independiente con un número fijo de parámetros o ventana de contexto. Es un sistema de orquestación que puede usar diferentes modelos de IA, ejecutar código, gestionar experimentos científicos y coordinar agentes de investigación especializados.
La investigación científica implica más que razonamiento. Un proyecto completo puede requerir diseño experimental, implementación, entrenamiento, depuración, evaluación y revisiones repetidas. Estas actividades pueden prolongarse durante varios días o semanas, a menudo con experimentos paralelos y recursos computacionales compartidos.
Hyra 2.0 aborda este desafío operativo combinando inteligencia de modelos con ejecución persistente, colaboración estructurada y verificación basada en evidencias.
Especificaciones técnicas de Hyra 2.0
Las especificaciones del sistema describen sus capacidades de orquestación e investigación. Los modelos científicos individuales creados por Hyra 2.0 tienen arquitecturas, conteos de parámetros y benchmarks de desempeño separados.
Por qué Hyra 2.0 construye herramientas
El cambio de Hyra 1.0 a Hyra 2.0 aborda una limitación fundamental en la investigación automatizada: resolver con éxito un problema no mejora necesariamente la capacidad del sistema para resolver el siguiente.
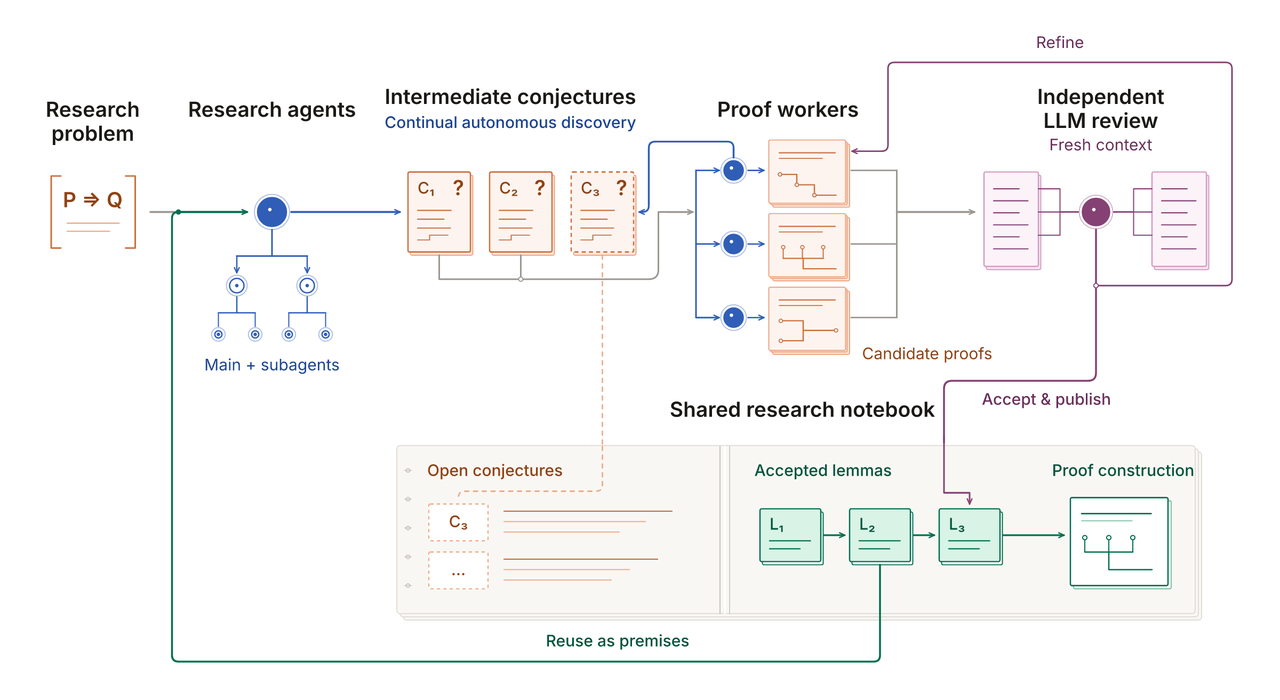
Hyra 1.0 utilizó un bucle de agente relativamente simple para generar soluciones, ejecutar evaluaciones y mejorar resultados mediante intentos repetidos. Impulsado por el modelo de código abierto Hy3 de Tencent, Hyra 1.0 ayudó a establecer el exponente óptimo que relaciona sumsets y difference sets, con una prueba verificada por máquina publicada junto con el resultado. La distinción importa: un resultado matemático evaluado es una salida concreta, mientras que una mejora del proceso de investigación puede reutilizarse en problemas posteriores.
El siguiente desafío es hacer que el progreso de investigación se acumule.
De respuestas a capacidades reutilizables
Considere tres niveles de automatización matemática:
- Un agente resuelve un problema matemático individual.
- Un agente desarrolla un flujo de trabajo de prueba que puede resolver problemas similares.
- Un agente mejora los modelos de razonamiento y las herramientas de verificación utilizados por futuros sistemas de investigación.
El primero produce una respuesta. El segundo produce un método reutilizable. El tercero puede mejorar la capacidad de investigación subyacente en sí.
Hyra 2.0 apunta al segundo y tercer niveles.
Tencent describe dos grandes categorías de herramientas reutilizables. Herramientas simbólicas expresan capacidades mediante código, algoritmos, reglas y flujos de trabajo. Ejemplos incluyen sistemas de verificación automatizada, algoritmos de búsqueda científica y pipelines de gestión de experimentos. Herramientas paramétricas almacenan capacidades aprendidas en pesos de modelos, incluyendo modelos de diseño de proteínas y modelos fundacionales científicos.
Mejorar cualquiera de las dos categorías puede beneficiar múltiples tareas downstream sin requerir que cada proyecto de investigación comience desde el mismo punto de partida.
La dirección hacia la auto-mejora recursiva
Hyra 2.0 también crea un camino hacia la auto-mejora recursiva. La investigación en modelos fundacionales depende de infraestructura de entrenamiento, pipelines de datos sintéticos, algoritmos de optimización y sistemas de inferencia.
Si agentes de IA mejoran estas herramientas, pueden ayudar a desarrollar modelos más fuertes. Esos modelos más fuertes pueden luego participar en rondas posteriores de desarrollo de herramientas.
Mejores herramientas de investigación → modelos de IA más fuertes → agentes de investigación más capaces → mejores herramientas de investigación.
Tencent describe aplicar Hyra a la infraestructura de preentrenamiento, generación de datos post-entrenamiento y optimización de inferencia. Esto crea un bucle de retroalimentación plausible entre el desarrollo de herramientas y el desarrollo de modelos. No establece por sí mismo una mejora recursiva ilimitada o completamente autónoma; cada ganancia propuesta aún requiere un experimento que aísle su efecto.
¿Cómo funciona la arquitectura del Harness de Hyra 2.0?
El Harness es la innovación de ingeniería central de Hyra 2.0. Un bucle de agente convencional puede ejecutar herramientas, inspeccionar resultados y continuar razonando dentro de una sesión. El desarrollo de modelos científicos requiere un entorno de ejecución más sofisticado.
Los experimentos pueden durar horas, los trabajos de entrenamiento pueden tardar días y diferentes direcciones de investigación pueden requerir distintos recursos de cómputo y métodos de validación. Hyra 2.0 aborda estos requisitos mediante tres capas de agentes, programación persistente de tareas, registros de investigación estructurados y verificación independiente.
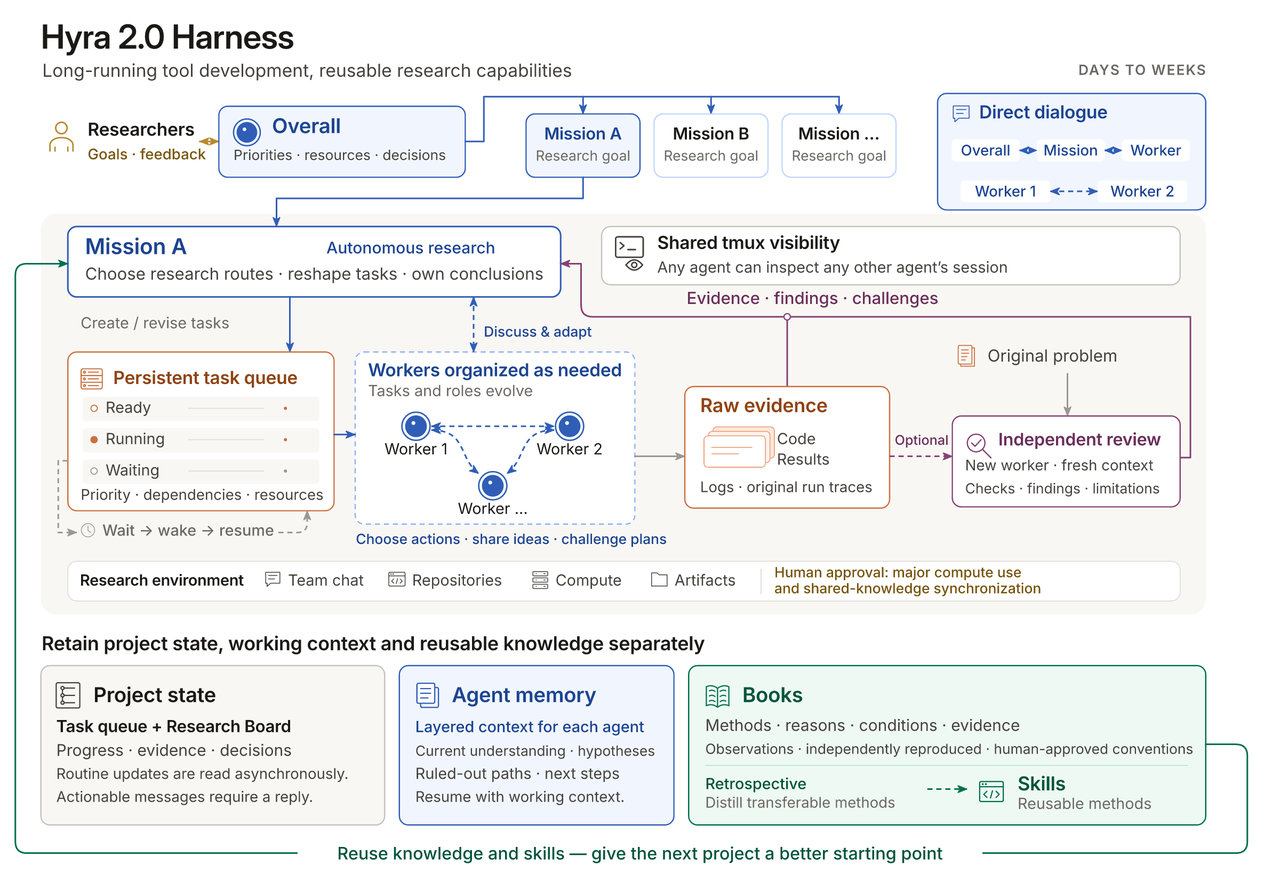
El diagrama de arquitectura del Hyra 2.0 oficial de Tencent Hunyuan muestra la jerarquía, la cola de trabajo persistente, el proceso de revisión y almacenes separados para el estado del proyecto, la memoria de agentes y el conocimiento compartido.
Overall: coordinación de investigación y gestión de recursos
Overall es la capa de coordinación más alta. Se comunica con investigadores humanos, mantiene la alineación con los objetivos de investigación, gestiona prioridades y coordina recursos computacionales.
Sus responsabilidades incluyen determinar qué proyectos deben recibir recursos adicionales e identificar decisiones que requieren aprobación humana. Por lo tanto, Overall funciona como la capa de coordinación entre actividades de investigación autónomas y la gestión de investigación humana.
Mission: planificación de investigación a largo plazo
Cada Mission es responsable de un problema de investigación particular. Una Mission mantiene la dirección de investigación a lo largo de múltiples experimentos, organiza a los Workers, interpreta resultados y decide si una hipótesis merece investigación adicional.
También determina cuándo un enfoque de investigación debe revisarse o abandonarse. Esto crea continuidad a lo largo de un proyecto de larga duración sin requerir que una sesión de agente retenga cada acción intermedia.
Worker: ejecución de experimentos y exploración independiente
Los Workers llevan a cabo tareas de investigación especializadas. Sus responsabilidades incluyen leer código, implementar algoritmos, ejecutar experimentos, diagnosticar fallas y proponer enfoques alternativos.
Los Workers pueden cuestionar decisiones de una Mission, y diferentes Workers pueden usar distintos modelos de IA subyacentes. Esta estructura soporta exploración paralela y reduce la dependencia del camino de razonamiento de un solo agente.
Programación persistente y Research Board
Hyra 2.0 coloca tareas de investigación en una cola persistente. El planificador considera la prioridad de tareas, dependencias y recursos disponibles al lanzar Workers.
Cuando un experimento espera resultados de entrenamiento o aprobación humana, otras tareas pueden continuar. Los agentes también pueden programar su próxima activación después de que termine un experimento.
El Research Board registra hipótesis, hallazgos, evidencias y decisiones importantes. Esto separa el estado persistente del proyecto de las conversaciones individuales de los agentes.
Verificación independiente y aprobación humana
Las conclusiones de los Workers deben estar respaldadas por evidencia experimental, como versiones de código, registros de ejecución, resultados de evaluación o trazas originales.
Cuando un resultado requiere examen adicional, un Review Worker separado puede inspeccionar independientemente el problema original y la evidencia. Este proceso ayuda a identificar conclusiones no fundamentadas y errores de implementación antes de que influyan en investigaciones posteriores.
Las operaciones de cómputo de alto costo y los cambios en el conocimiento compartido del equipo siguen sujetos a aprobación humana. La arquitectura, por lo tanto, combina ejecución autónoma con puntos de control explícitos para decisiones de gran impacto.
Books: convertir la experiencia de investigación en habilidades
Hyra 2.0 separa la información en tres categorías de almacenamiento:
- Estado del proyecto: colas de tareas, registros de colaboración y progreso de investigación.
- Memoria del agente: comprensión actual, hipótesis, enfoques rechazados y planes futuros.
- Books: conocimiento reutilizable compartido entre proyectos de investigación.
Books categoriza la información en observaciones, hallazgos verificados y convenciones. Un solo experimento puede producir una observación. Hallazgos reproducidos independientemente pueden convertirse en conocimiento verificado. Las convenciones que afectan el comportamiento del equipo requieren confirmación humana.
Durante las revisiones de proyecto, los métodos reutilizables pueden convertirse en habilidades. Un procedimiento de verificación numérica exitoso o un método para diagnosticar inestabilidad de entrenamiento puede convertirse en un componente reutilizable de futuros flujos de trabajo de investigación.
Este mecanismo permite que el sistema preserve mejoras operativas más allá de sesiones individuales.
¿Qué resultados de investigación ha logrado Hyra 2.0?
Los resultados iniciales de Hyra 2.0 abarcan modelos científicos, investigación matemática, computación cuántica, robótica, análisis unicelular e ingeniería de hardware.
El repositorio oficial de investigación contiene implementaciones seleccionadas, pesos, informes y artefactos de verificación. La visión general a continuación resume los resultados reportados por Tencent; las subsecciones siguientes explican sus condiciones de prueba y disponibilidad. Estas son diferentes tareas científicas, no una única clasificación de la capacidad de un agente de propósito general.
Estos resultados demuestran múltiples tipos de salida de investigación más que una puntuación única de agente de propósito general.
HyInv: plegado inverso de proteínas 57× más rápido
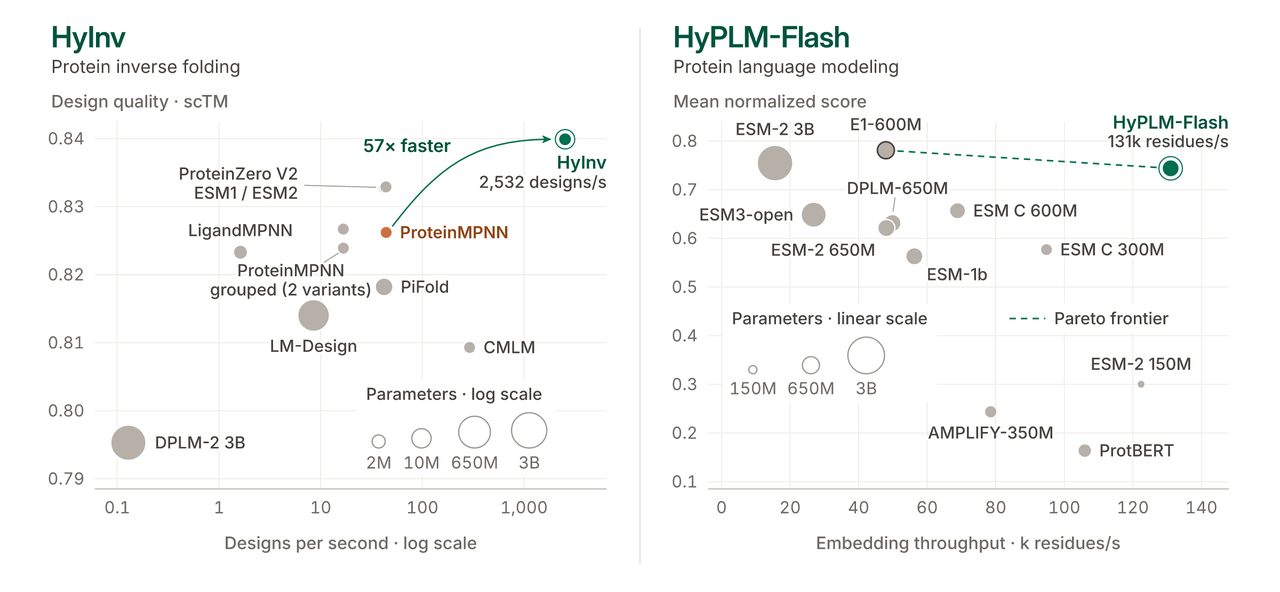
HyInv genera secuencias de proteínas para una columna vertebral objetivo. Su modelo de 1.96M parámetros reporta ser 57× más rápido que ProteinMPNN. Los 50.6 ms reportados para 128 diseños usan una columna vertebral de 402 residuos, un H20 y BF16, excluyendo compilación y captura de gráficos CUDA. Trátelo como velocidad de generación en caliente; el filtrado estructural sigue contribuyendo al ciclo completo de diseño.
HyPLM-Flash: modelado de lenguaje de proteínas de alto rendimiento
HyPLM-Flash es un modelo de lenguaje de proteínas de 650M parámetros entrenado en 726B tokens. En la evaluación publicada de 28 checkpoints y 32 tareas, su puntuación en ProteinGym fue estadísticamente empatada con codificadores comparables. La inferencia en INT8 alcanza alrededor de 130,000 residuos/s en un H20; BF16 es preferible cuando pequeñas diferencias de representación afectan el análisis downstream. La figura del lanzamiento a continuación usa un alcance de evaluación diferente.
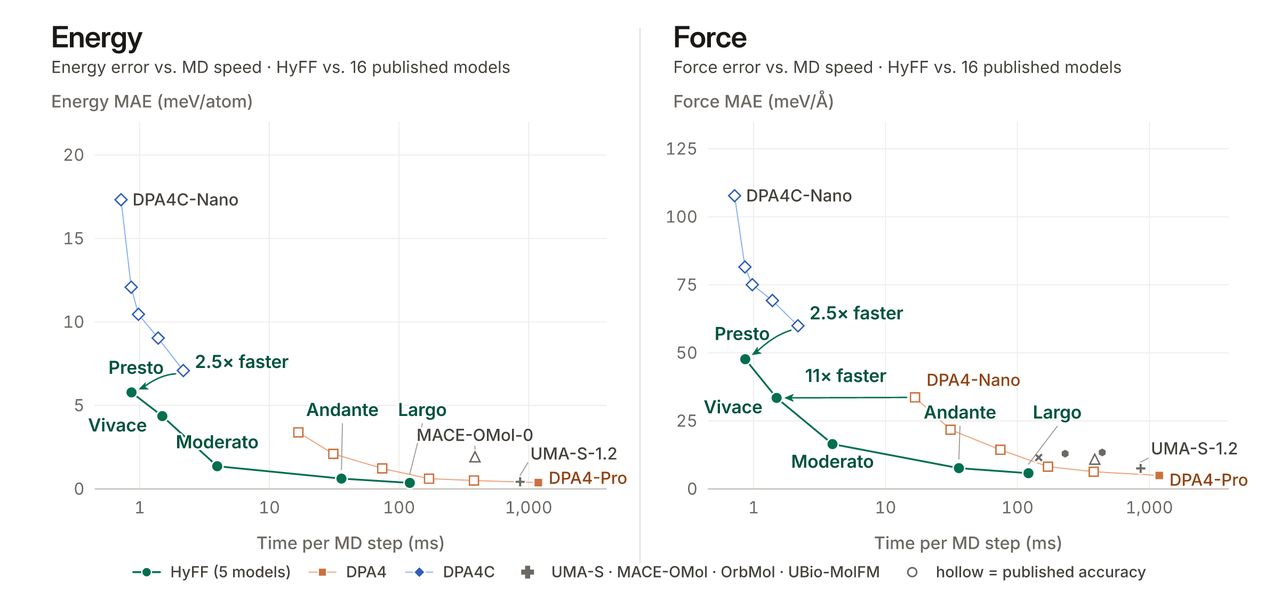
HyFF: simulación molecular más rápida con cinco tamaños de modelo
HyFF predice energías moleculares y fuerzas atómicas, con cinco tamaños de modelo que abarcan 2.3M–1.2B parámetros. En la comparación OMol25 reportada, Andante combina un error de fuerza similar al de UMA-S-1.2 (7.65 frente a 7.55 meV/Å) con una dinámica molecular 29× más rápida. Largo reporta menor error de energía que DPA4-Pro (0.364 frente a 0.380 meV/átomo) y 9.7× mayor velocidad. Elija un tamaño probando tanto la precisión como el tiempo de ejecución en las moléculas que pretende simular.
HyCell: un modelo de embeddings de célula única
HyCell mapea conteos de expresión génica de células humanas a embeddings de 512 dimensiones con un modelo de 16.1M parámetros. En siete atlas celulares retenidos, su puntuación compuesta es 0.735, cercana a 0.736 de Stack. Esa puntuación combina conservación biológica, corrección de lotes y transferencia de anotaciones; no es una exactitud de clasificación. Verifique las métricas componentes relevantes para su estudio.
HyProver: flujos de trabajo reutilizables para investigación matemática
HyProver organiza el trabajo matemático en exploración, desarrollo de pruebas y revisión. Sus resultados reportados establecen el caso de cinco dimensiones de la conjetura de conjuntos equiláteros de Petty y dan un contraejemplo a la forma no restringida de la conjetura de circle-action de Yau. Estos resultados tienen límites específicos: la conjetura de Petty no está resuelta en todas las dimensiones, y la formulación simplemente conexa de Yau permanece abierta.
HyQEC: una mejora del 48% en la eficiencia de códigos cuánticos
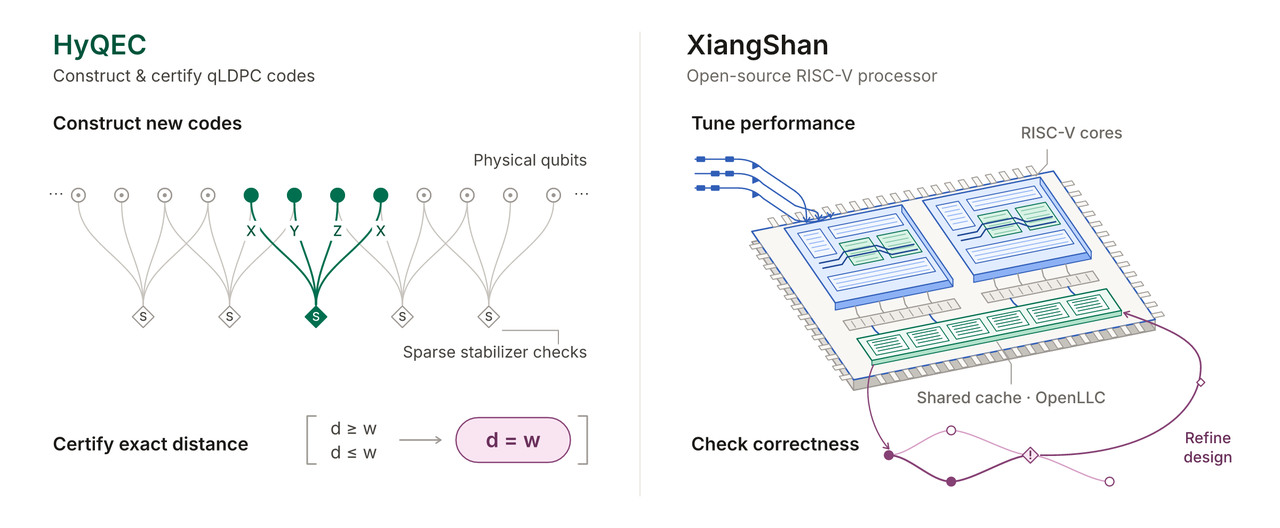
HyQEC busca códigos de corrección de errores cuánticos y verifica sus distancias. Tencent informa una construcción [[488,123,22]] con una métrica de eficiencia kd²/n de 122.0, aproximadamente 48% por encima del líder previo del desafío bajo las restricciones indicadas. Esto mide la eficiencia del código, no el desempeño del hardware cuántico. Verificado al 5 de noviembre de 2026, el lanzamiento oficial incluye las herramientas hyqec-verify y hyqec-check, pero aún lista el archivo de código de esta construcción particular y su certificado como evidencias por liberar. Las herramientas públicas y la evidencia públicamente reproducible para un resultado específico son hitos separados.
Spiral Hand: morfología robótica diseñada por IA
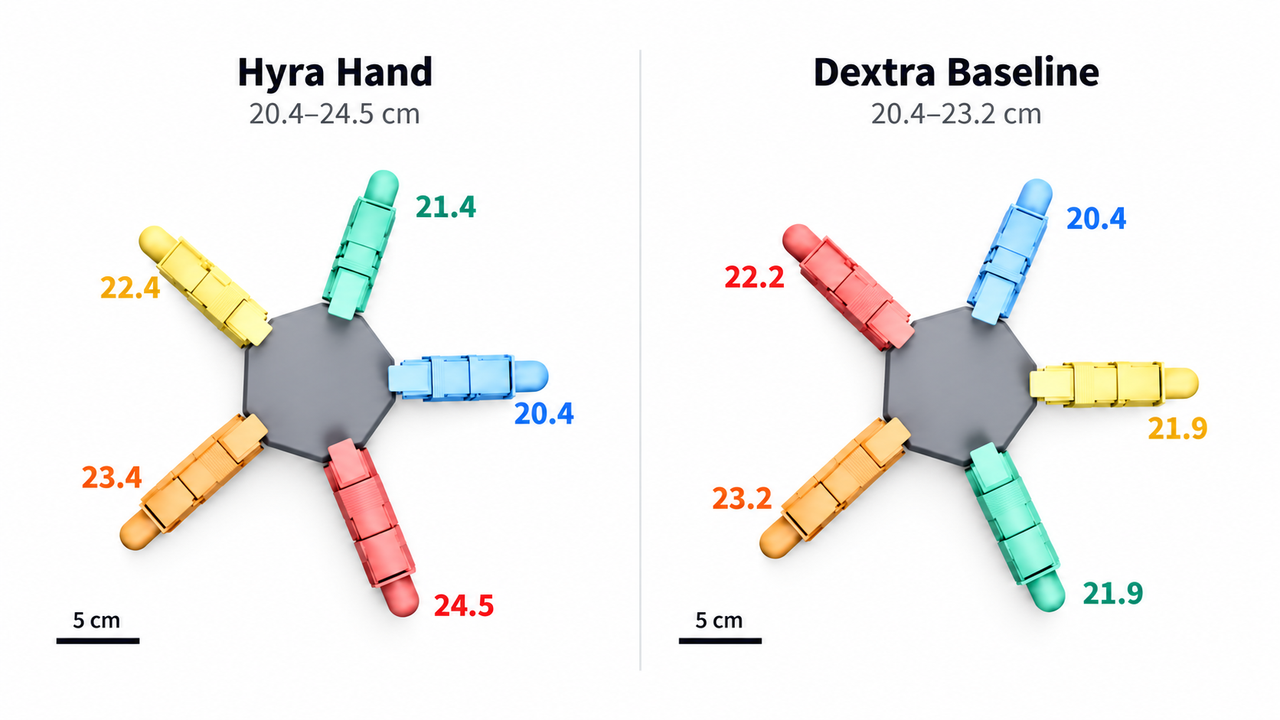
La Spiral Staircase Hand de Hyra utiliza dedos progresivamente más largos alrededor de la palma. Tencent reporta 28.6% más rápida la rotación de objetos y 21% más objetivos completados que la línea base Dextra en simulación DR5 tras presupuestos de fine-tuning de políticas iguales. La validación en hardware físico permanece pendiente.
XiangShan: optimización de procesadores y verificación formal
Para el procesador RISC-V XiangShan, Tencent reporta una mejora de 5.79% en la puntuación SPEC CPU2006 por GHz, frecuencia de núcleo sin cambios y un aumento de área de 0.3%. El trabajo también encontró diez bugs no reportados previamente y un contraejemplo de coherencia de caché. Estos resultados aplican al diseño y cargas de trabajo evaluados, más que a todos los sistemas RISC-V.
¿Cómo deberían los investigadores interpretar los benchmarks de Hyra 2.0?
Lea cada benchmark dentro de su propia carga de trabajo. Compare las mismas entradas, hardware, precisión y límites de temporización, luego evalúe la calidad de salida junto con el tiempo de ejecución. Para afirmaciones científicas, inspeccione el código, los datos, la prueba o el certificado de respaldo: un resultado reportado y un resultado reproducido independientemente proporcionan niveles de evidencia distintos.
¿Pueden los desarrolladores usar Hyra 2.0 a través de una API?
Al 4 de noviembre de 2026, los materiales públicos de Hyra describen resultados de investigación y lanzamientos seleccionados. No documentan una API de orquestación Hyra 2.0 de disponibilidad general, un precio de suscripción ni un paquete completo de despliegue. Un anuncio de investigación y artefactos descargables deben distinguirse del acceso alojado al sistema completo.
Los materiales disponibles públicamente se concentran en resultados de investigación y artefactos seleccionados. Los desarrolladores pueden acceder a ciertos modelos creados a través de Hyra, incluyendo HyInv, HyPLM-Flash, HyFF y HyCell, mediante los repositorios de investigación asociados.
El Harness completo de Hyra 2.0 debe distinguirse de esas salidas descargables.
Hyra 2.0 y APIs hospedadas de Hunyuan
Los desarrolladores pueden acceder a Tencent Hy4 a través de CometAPI usando el ID de modelo hy4. Esto proporciona inferencia de modelos alojada para aplicaciones como programación, análisis y flujos de trabajo de agentes. No proporciona el Harness de investigación completo de Hyra 2.0; los modelos científicos desarrollados a través de Hyra están disponibles por separado mediante los repositorios de investigación de Tencent.
¿Qué haría útil a Hyra 2.0 en un equipo de investigación?
Comience con un artefacto lanzado y una pequeña carga de trabajo de referencia. Una vez que eso se ejecute correctamente, pruebe datos locales representativos con un umbral de calidad fijo y un presupuesto de cómputo. Mantenga juntos la revisión del repositorio, los pesos, el entorno, las entradas y las salidas para que los colegas puedan reproducir el resultado. Agregue coordinación multiagente persistente cuando largas esperas, experimentos dependientes o hipótesis en competencia lo hagan útil.
Conclusión
Hyra 2.0 integra la planificación de investigación, la ejecución de experimentos y el conocimiento reutilizable en un flujo de trabajo persistente. Sus salidas científicas son puntos de partida prometedores para trabajos posteriores. Para un equipo de investigación, la prueba práctica es si un artefacto lanzado mejora un experimento real y produce evidencia que otros pueden inspeccionar y reproducir.
Preguntas frecuentes
¿Cómo debería un laboratorio presupuestar su primera prueba de un artefacto de Hyra?
Presupueste tres etapas: configurar un entorno reproducible, ejecutar un caso de referencia pequeño y evaluar una carga de trabajo local representativa. Incluya tiempo de preparación y revisión, así como uso de aceleradores. Elija un criterio de aceptación antes de empezar, como mantener un nivel de calidad requerido mientras se reduce el tiempo de respuesta. Una prueba inicial debe ser lo suficientemente pequeña como para diagnosticar fallas sin comprometer los recursos requeridos para una campaña de investigación completa.
¿Qué debe contener un paquete de reproducibilidad?
Mantenga juntos la revisión del repositorio, identificadores de pesos del modelo, versiones del entorno, procedencia de datos de entrada, configuración, semillas aleatorias cuando sea relevante y salidas de evaluación. Registre cualquier cambio respecto al ejemplo publicado. Cuando un resultado depende de una prueba o certificado, preserve la versión del verificador y su salida también. El paquete debe permitir que otro investigador distinga un problema de software, una entrada cambiada y una diferencia genuina en el resultado científico.
¿Cómo pueden los investigadores evitar la contaminación de benchmarks?
Separe los datos usados para elegir modelos o ajustar configuraciones de los datos usados para la evaluación final. Congele el protocolo final antes de comparar candidatos y documente cualquier superposición con datos de preentrenamiento o desarrollo que pueda establecerse. Para nuevos conjuntos de datos científicos, use particiones que reflejen el entorno de despliegue previsto, como un estudio retenido o una condición experimental. Una puntuación fuerte es menos informativa si los ejemplos de evaluación moldearon repetidamente el sistema bajo prueba.
¿Cómo deberían los equipos manejar conclusiones conflictivas entre agentes?
Compare los experimentos subyacentes en lugar de combinar conclusiones por voto mayoritario. Verifique si los agentes usaron la misma versión del conjunto de datos, supuestos, métrica y configuración de software. Conserve ambos hallazgos hasta que se explique la diferencia, luego ejecute un experimento enfocado que discrimine entre las explicaciones en competencia. El acuerdo entre agentes es útil, pero no reemplaza mediciones externas ni un argumento verificable.
¿Cuándo es preferible un flujo de trabajo de investigación más simple?
Una tarea corta y determinista con un script maduro y un evaluador claro puede no beneficiarse de la coordinación multiagente persistente. La programación adicional, el mantenimiento de registros y la revisión pueden costar más de lo que ahorran. Introduzca orquestación cuando los experimentos tengan dependencias significativas, largas esperas, varias hipótesis en competencia o salidas reutilizables que necesiten mantenimiento continuo. La decisión debe seguir la estructura de la carga de trabajo y el costo de coordinación observado.