
TL;DR: FLUX 3 es el modelo fundacional multimodal unificado de Black Forest Labs. Su Video API pública genera clips de hasta 20 segundos a 24 fps, con audio sincronizado opcional, a partir de texto, imágenes, fotogramas clave o video existente. Admite resoluciones desde HD hasta UHD/4K, mientras que FLUX 3 Image y el modelo de pesos abiertos FLUX 3 Dev siguen siendo lanzamientos independientes.
¿Qué es FLUX 3?
FLUX 3 es un modelo multimodal de vanguardia de Black Forest Labs. En lugar de entrenar de forma independiente un modelo para imágenes, otro para video y otro para audio, BFL entrena una representación compartida entre estas modalidades.
La idea central es que las imágenes, el video y el sonido son observaciones diferentes del mismo mundo subyacente. Un coche en movimiento tiene apariencia visual, movimiento, sonido, relaciones espaciales, propiedades de materiales y comportamiento causal. Aprender estas señales conjuntamente da al modelo más restricciones que aprender fotogramas individuales por separado.
Por eso Black Forest Labs describe FLUX 3 como un paso hacia un modelo de la realidad o modelo del mundo más que un simple generador de imágenes o video. El sistema de video lanzado ya demuestra esa dirección: audio sincronizado, movimiento, estructura de escenas, diálogo, comportamiento de cámara y sonidos ambientales se manejan en un único flujo de generación.
No todas las capacidades anunciadas de FLUX 3 están disponibles públicamente aún. A septiembre de 2026, FLUX 3 Video está disponible, mientras que FLUX 3 Image y el modelo de pesos abiertos FLUX 3 Dev siguen siendo elementos de despliegue separados.
Especificaciones de FLUX 3 de un vistazo
Las siguientes especificaciones reflejan la documentación actual para desarrolladores de FLUX 3, en lugar de la configuración preliminar del lanzamiento de julio.
| Especificación | Documentación oficial de FLUX 3 |
|---|---|
| Desarrollador | Black Forest Labs |
| Familia de modelos | FLUX 3 |
| Tipo de modelo | Fundacional multimodal unificado / modelo generativo de video |
| Lanzamiento público de video | 4 de agosto de 2026 |
| Dirección central de entrenamiento | Aprendizaje conjunto de representación de imagen, video y audio |
| Base de investigación | Self-Flow |
| Salida principal actual del API | Video con audio sincronizado |
| Texto a video | Compatible |
| Imagen a video | Compatible |
| Fotogramas clave a video | Compatible |
| Continuación de video | Compatible |
| Duración máxima T2V/I2V | 20 segundos |
| Duración de continuación de video | 5–15 segundos |
| Tasa de fotogramas | 24 fps |
| Resolución | HD, FHD, QHD/2K y UHD/4K |
| Resolución FHD 16:9 | 1920 × 1088 |
| Referencias de imagen | Hasta 10 para flujos I2V/fotogramas clave |
| Audio nativo | Sí |
| Diálogo multilingüe | Sí |
| Sincronización labial | Sí |
| Generación de múltiples tomas | Sí |
| Modo borrador | Sí |
| Endpoint público de imagen fija FLUX 3 | Aún no publicado por BFL |
| FLUX 3 Dev pesos abiertos | Planeado |
La documentación actual de BFL especifica 5–20 segundos para texto a video e imagen a video, mientras que la continuación de video acepta una ventana de generación de 5–15 segundos. Las relaciones de aspecto compatibles incluyen 21:9, 2:1, 16:9, 4:3, 1:1, 3:4 y 9:16.
¿Cómo funciona FLUX 3?
Self-Flow
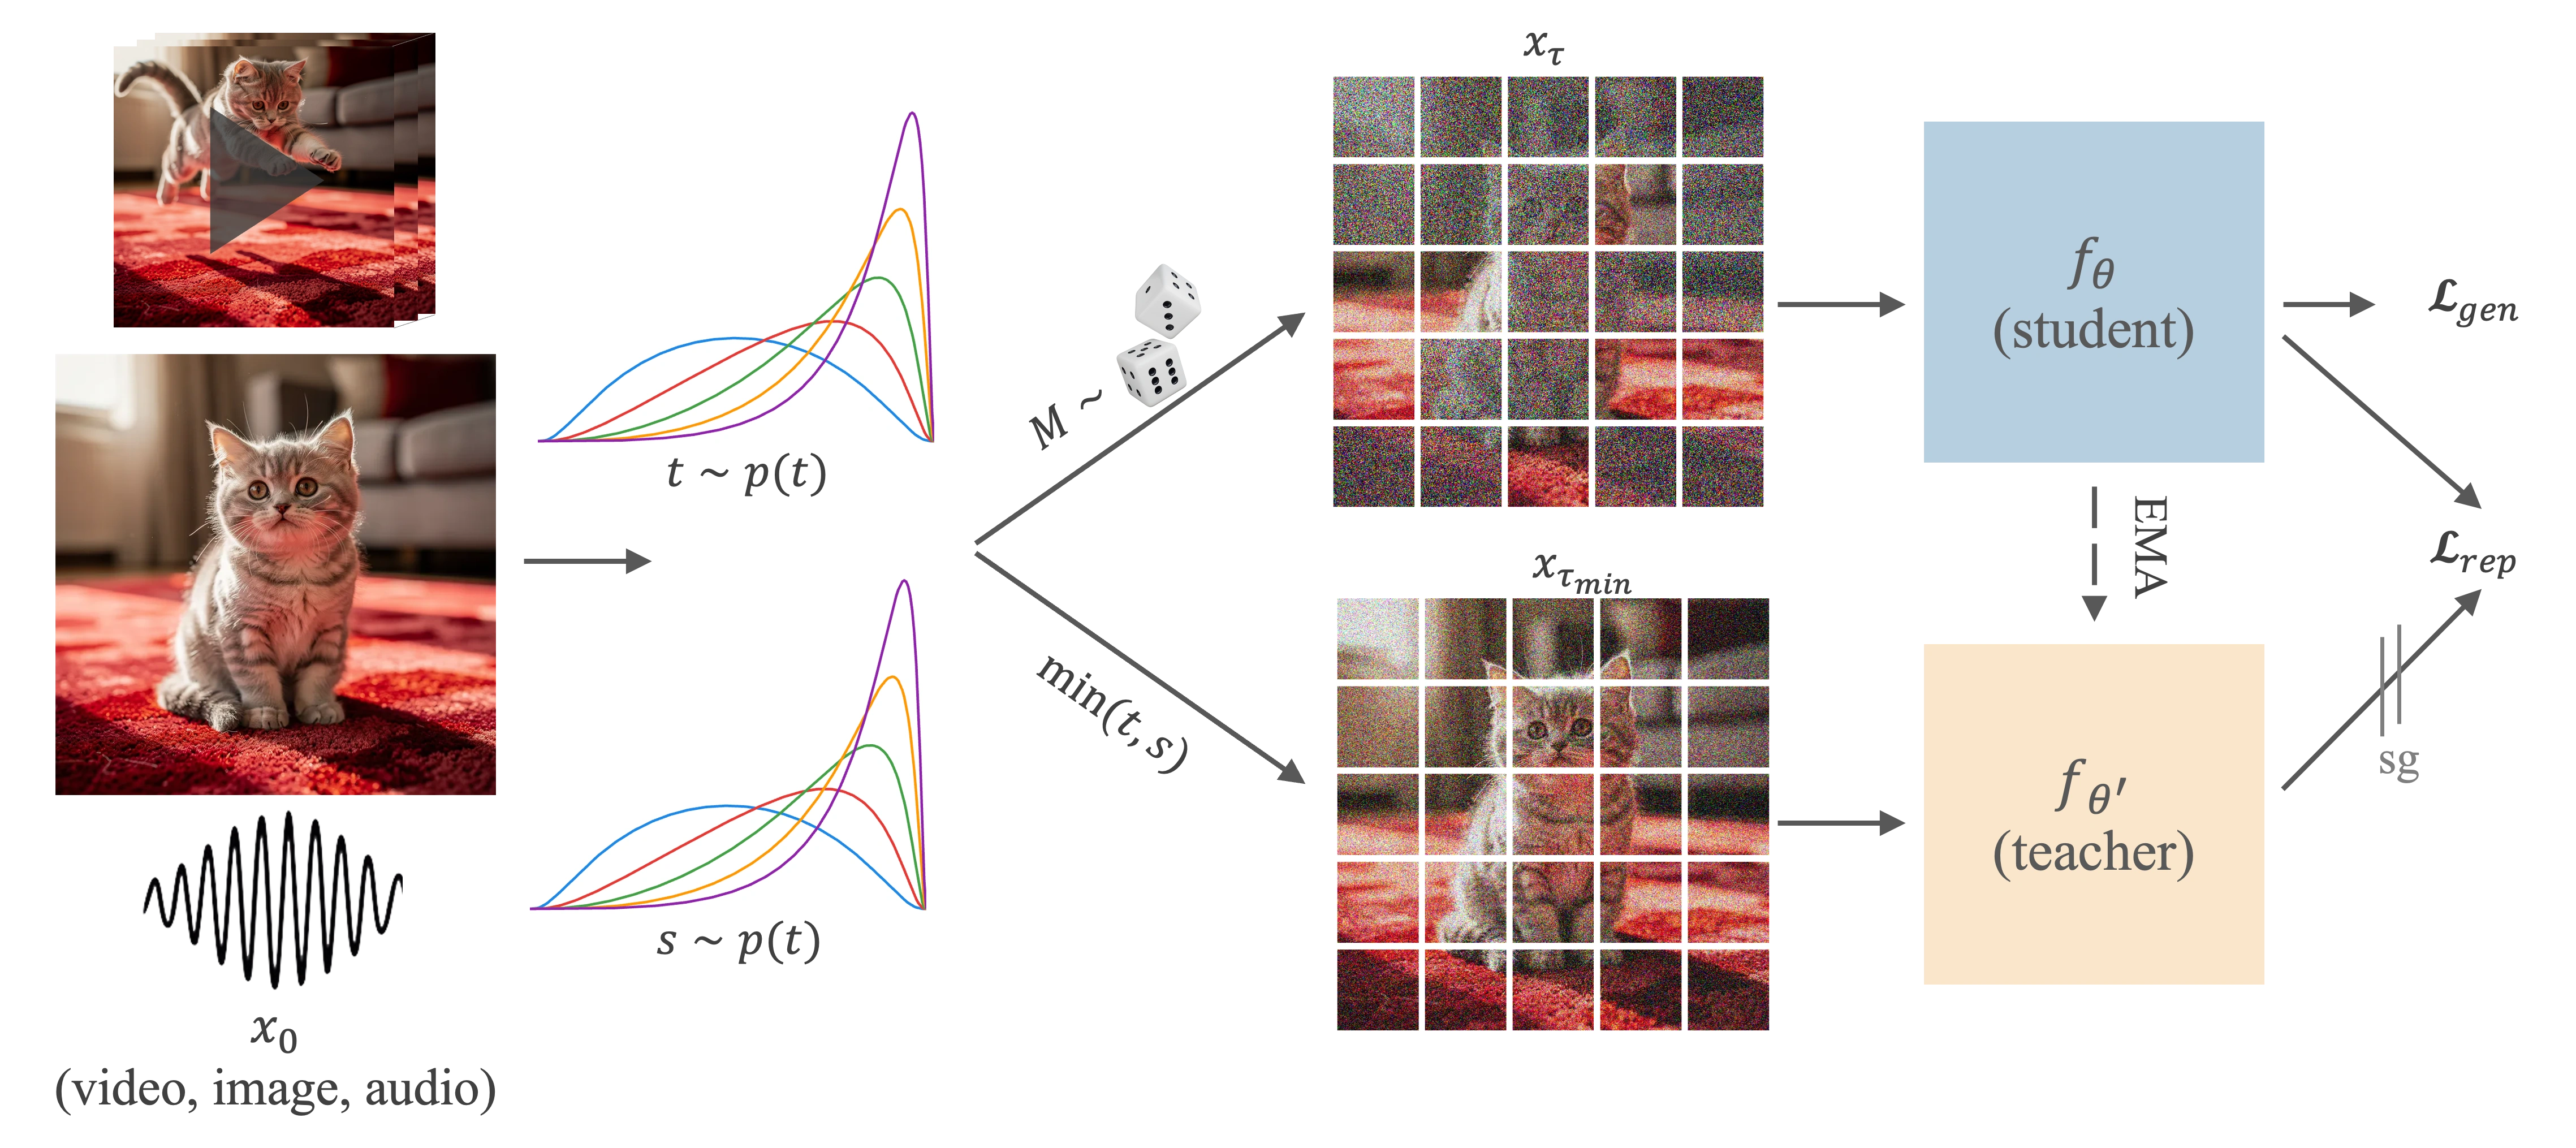
La base de investigación clave es Self-Flow, el enfoque de ajuste de flujo auto-supervisado de Black Forest Labs. Los pipelines de entrenamiento generativo tradicionales a menudo dependen de modelos de representación preentrenados separados o supervisión auxiliar. Self-Flow está diseñado para aprender representaciones útiles directamente a partir del objetivo generativo.
Un mecanismo principal es Dual-Timestep Scheduling. A diferentes grupos de tokens se les pueden asignar distintos niveles de ruido durante el entrenamiento. Esto crea asimetría de información: algunas partes de la entrada contienen más información utilizable que otras, obligando a la red a construir representaciones que ayuden a inferir lo que falta.
En términos prácticos, se incentiva a FLUX 3 a aprender relaciones entre objetos, fotogramas, movimiento, sonido y eventos temporales, en lugar de simplemente memorizar cómo deben verse los fotogramas individuales.
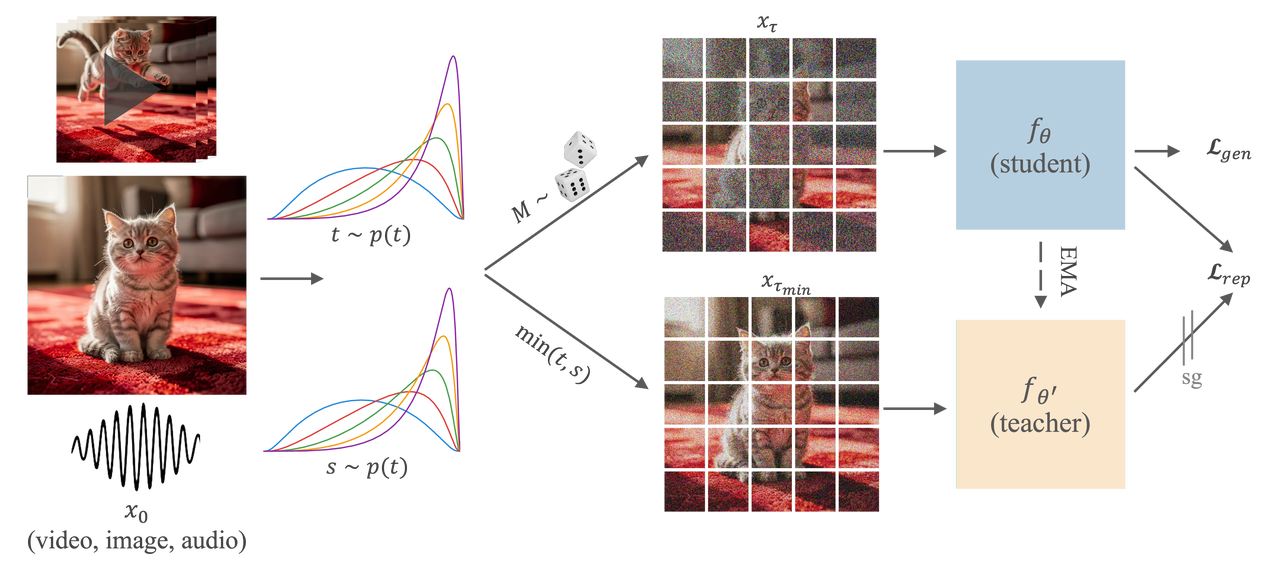
Arquitectura del método Self-Flow - fuente oficial de la imagen: Proyecto Self-Flow de Black Forest Labs
BFL también probó el entrenamiento multimodal conjunto usando una columna vertebral derivada de FLUX.2 con millones de videos y cientos de millones de imágenes. Los experimentos respaldan la hipótesis más amplia de FLUX 3 de que el aprendizaje de representación y la generación no necesitan ser sistemas separados.
Por qué el video es central en FLUX 3
El video es particularmente valioso para el modelado del mundo porque contiene información que una imagen fija no puede proporcionar. Un solo fotograma puede mostrar una pelota sobre el suelo; un video puede revelar que la pelota está cayendo, rebotando, deformándose al impactar, produciendo un sonido y cambiando de dirección después.
BFL reveló que la predicción de video representa más del 95% del cómputo de entrenamiento de FLUX 3. El audio es comparativamente barato porque es una señal de mucha menor dimensión estrechamente acoplada a eventos visibles. Esa asignación ayuda a explicar por qué el video es la primera capacidad de FLUX 3 en alcanzar disponibilidad general.
¿Qué puede hacer FLUX 3?
Texto a video
Los usuarios pueden generar un video completo a partir de instrucciones en lenguaje natural. BFL afirma que el modelo lanzado maneja prompts simples y complejos mientras coordina movimiento, lógica de escenas, composición visual y sonido. Esto es especialmente útil para prompts que contienen múltiples eventos secuenciales en lugar de un único sujeto animado.
Imagen a video y fotogramas clave
FLUX 3 puede animar una imagen inicial, trabajar hacia un fotograma final o usar múltiples imágenes como fotogramas clave temporizados. El API actual admite hasta diez referencias de imagen en flujos de imagen a video, lo que permite a los creadores controlar cómo cambia una escena con el tiempo en lugar de pedirle al modelo que improvise toda la secuencia.
Continuación de video
Se puede proporcionar un video existente y su audio como contexto, y FLUX 3 puede generar lo que sigue. BFL describe una continuación que preserva el movimiento, el comportamiento de la cámara, el diálogo y el sonido a través de la transición, lo que es materialmente diferente de generar un segundo clip independiente y unir ambos archivos después.
Audio nativo y diálogo
FLUX 3 produce audio en el momento de la generación en lugar de requerir una pasada separada de generación de voz o sonido. Sus capacidades de audio lanzadas incluyen diálogo, efectos de sonido y sonido ambiente. También se admite diálogo multilingüe con sincronización labial.
Múltiples tomas en una sola generación
Un único prompt puede contener múltiples escenas o ángulos de cámara. Esto importa porque muchos modelos de video anteriores son más fuertes cuando se les pide un solo plano corto y visualmente continuo; FLUX 3 está diseñado explícitamente para admitir secuencias con múltiples tomas en una sola generación.
Modo borrador
El Modo borrador es una de las adiciones más prácticas para la generación de video a gran volumen. En lugar de pagar el precio completo por cada experimento de prompt, los desarrolladores pueden crear una vista previa más rápida y de menor costo y luego mejorar el borrador seleccionado preservando la composición y el movimiento elegidos. Según la tarifa actual de BFL, un borrador estándar T2V/I2V cuesta $0.06 por segundo, frente a $0.17 por segundo para la generación HD normal.
¿Qué no se ha lanzado aún?
El anuncio de lanzamiento de FLUX 3 describió capacidades de imagen, video, audio y acción bajo una misma dirección arquitectónica, pero la disponibilidad es escalonada.
| Capacidad | Hoja de ruta y disponibilidad actuales de BFL |
|---|---|
| Generación de video FLUX 3 | Disponibilidad general |
| Audio nativo de video | Disponibilidad general |
| Texto a video | Disponibilidad general |
| Imagen a video / fotogramas clave | Disponibilidad general |
| Continuación de video | Disponibilidad general |
| Combinaciones más ricas de referencias de imagen/video/audio | Expansión planificada |
| Generación y edición de imagen FLUX 3 | Próximamente |
| FLUX 3 Dev pesos abiertos | Planeado |
| Despliegue de predicción de acciones | Investigación / vía de socios comerciales |
Esta distinción es especialmente importante para usuarios familiarizados con FLUX.2 Max. FLUX.2 sigue siendo una opción dedicada actual para generación de imágenes fijas, mientras que el producto público FLUX 3 está centrado en video y audio.
Rendimiento de FLUX 3 en benchmarks
Ahora hay dos tipos útiles de evidencia de benchmarks para FLUX 3: la evaluación interna de BFL posterior al lanzamiento y la evaluación independiente de terceros. La primera muestra preferencia humana relativa bajo el protocolo de BFL; la segunda comprueba si esas fortalezas siguen siendo visibles bajo un benchmark diseñado de forma independiente.
Evaluación ELO posterior al lanzamiento de BFL
El anuncio inicial de julio incluía tasas de victoria preliminares. El benchmark más relevante para los usuarios actuales es la evaluación del modelo lanzado de BFL del 4 de agosto. Black Forest Labs reporta una puntuación ELO de 1135 en texto a video en su evaluación interna de todos contra todos.
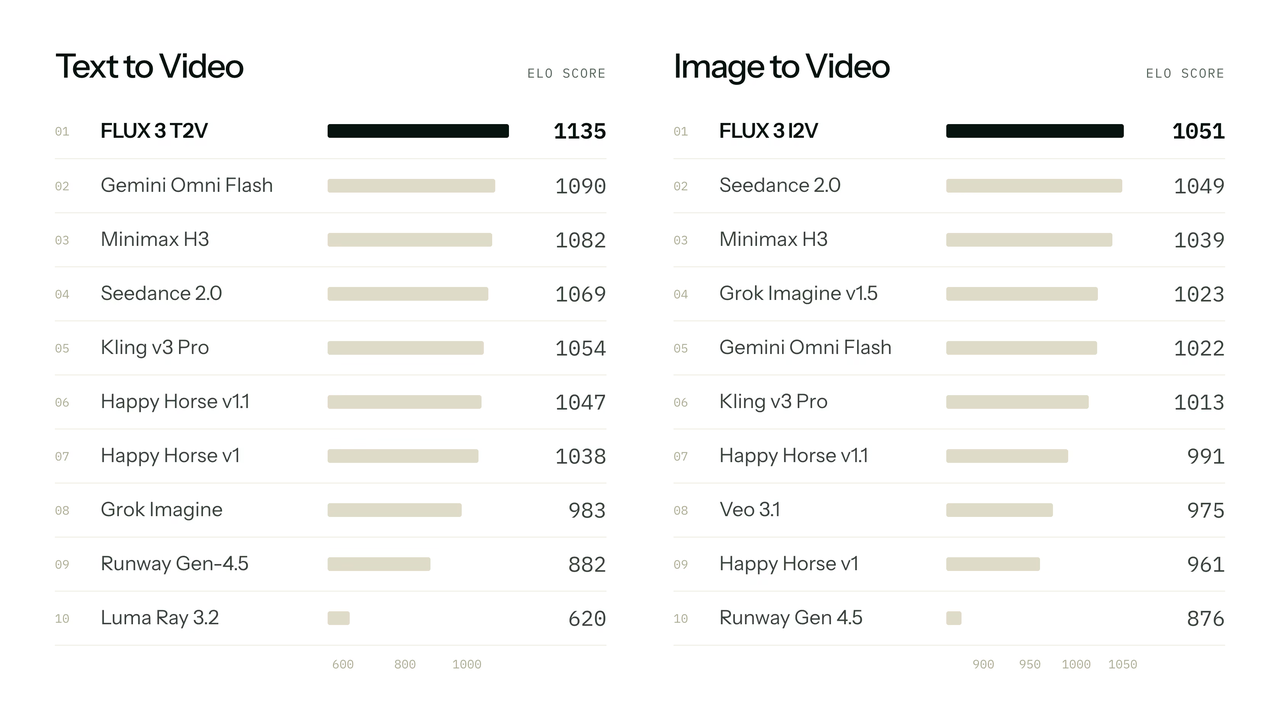
Evaluación ELO del modelo lanzado de FLUX 3 - fuente oficial de la imagen: Black Forest Labs
| Métrica | Evaluación del modelo lanzado por BFL |
|---|---|
| ELO de texto a video | 1135 |
| Posición T2V | Puntuación más alta en el grupo probado por BFL |
| Resultado de imagen a video | Empató con el competidor más fuerte probado y superó a los demás modelos evaluados |
| Tipo de evaluación | Evaluación interna de preferencia humana |
| Etapa del modelo | Lanzamiento de FLUX 3 Video con disponibilidad general |
Esto es evidencia más sólida que el benchmark preliminar del lanzamiento porque evalúa el modelo publicado en agosto. Sin embargo, sigue siendo un benchmark gestionado por el proveedor y no debe interpretarse como prueba de que FLUX 3 superará a todos los competidores en todas las categorías de prompts.
Benchmark independiente de FLUX 3
El v-benchmark v2 de Megaton proporciona una comprobación independiente. FLUX 3 fue evaluado en agosto de 2026 y actualmente publica un Megaton Index de 76.51/100, ocupando el puesto n.º 3 en el conjunto publicado en el momento de la evaluación.
| Dimensión del benchmark | Evaluación de FLUX 3 en Megaton |
|---|---|
| Megaton Index | 76.51 |
| Adherencia al prompt | 87.07 |
| Consistencia de escena | 94.76 |
| Física | 70.63 |
| Fidelidad humana | 73.70 |
| Fidelidad de objetos y productos | 83.82 |
| Coherencia causal y semántica | 80.91 |
| Fidelidad de texto | 82.41 |
| Cinematografía | 71.43 |
| Gusto y dirección artística | 65.00 |
El perfil es más informativo que la puntuación global. La Consistencia de escena con 94.76 es la categoría mayor más fuerte, mientras que la adherencia al prompt, la fidelidad de objetos, la coherencia causal y la fidelidad de texto también superan 80. Física, Fidelidad humana y Gusto y dirección artística son más débiles, mostrando que una representación temporal más fuerte no elimina el movimiento sintético ni la variación en calidad artística.
Esto también explica por qué las conclusiones de benchmarks pueden diferir: la prueba interna de preferencia de BFL sitúa a FLUX 3 en la cima de su conjunto de comparación, mientras que el ranking independiente de Megaton lo coloca tercero. Diferentes prompts, dimensiones de puntuación, poblaciones de evaluadores y métodos de agregación pueden producir rankings distintos.
FLUX 3 vs Seedance 2.5 vs MiniMax H3 vs Wan 3.0
El mercado de video de IA se movió rápidamente en 2026. FLUX 3 ahora compite con sistemas multimodales que combinan cada vez más generación de formato largo, audio sincronizado, referencias y edición.
| Dimensión | FLUX 3 | Seedance 2.5 | MiniMax H3 | Wan 3.0 |
|---|---|---|---|---|
| Desarrollador | Black Forest Labs | ByteDance Seed | MiniMax | Alibaba |
| Clip máximo anunciado | 20 s | 30 s | 15 s | 30 s |
| Resolución de video | HD / FHD / QHD (2K) / UHD (4K) | Dependiente del nivel del API | Hasta 2K | Hasta 1080p |
| Audio nativo | Sí | Sí | Sí, estéreo | Sí |
| Texto a video | Sí | Sí | Sí | Sí |
| Entrada de imagen/referencia | Sí | Sí | Sí | Sí |
| Control de fotogramas/referencias | Fotogramas clave temporizados sólidos | Control de referencias multimodales sólido | Condicionamiento multimodal | Control de referencias multimodal |
| Continuación/edición de video | Continuación disponible | Flujo orientado a la edición | Enfoque de generación omni-modal | Flujos de edición y referencia |
| Generación de múltiples tomas | Sí | Sí | Sí | Sí |
| Fortaleza distintiva | Arquitectura de “modelo de realidad”, consistencia de escena, Self-Flow | Narrativa de formato largo y control de referencias | Generación audiovisual 2K y contexto omni-modal | Clips largos y coste inicial más bajo |
| Precio inicial/unitario en CometAPI* | $0.136/s | $0.0824/s listado | $0.064/s | $0.040/s |
* El precio es solo una comparación aproximada. Las APIs de video usan diferentes resoluciones, duraciones, niveles de calidad y reglas de facturación, por lo que el número más barato por segundo no es necesariamente la salida de calidad equivalente más barata.
FLUX 3 vs Seedance 2.5
Seedance 2.5 tiene una ventaja obvia en duración, con generación de hasta 30 segundos frente a los 20 segundos de FLUX 3. También está fuertemente orientado hacia la generación impulsada por referencias, la edición y la narrativa de formato largo. FLUX 3 se diferencia por su arquitectura compartida de modelo del mundo, consistencia de escena, generación audiovisual nativa, fotogramas clave temporizados y una hoja de ruta más amplia de imagen/acción.
Las pruebas independientes refuerzan que es una competencia de alta gama genuina: Megaton actualmente sitúa a Seedance 2.5 por encima de FLUX 3 en general.
FLUX 3 vs MiniMax H3
MiniMax H3 ofrece salida de hasta 2K y audio estéreo nativo, lo que le da una especificación técnica sólida para contenido audiovisual. FLUX 3 admite una ventana de generación máxima más larga—20 segundos frente a 15 segundos de H3—y su Modo borrador proporciona un flujo de iteración con control de costos.
FLUX 3 vs Wan 3.0
Wan 3.0 enfatiza entradas multimodales amplias, generación audiovisual, edición y clips de hasta 30 segundos. También es más barato al precio inicial listado por CometAPI. FLUX 3 es más caro pero se diferencia por su posicionamiento de modelo de realidad, consistencia de escena, base de investigación Self-Flow, Modo borrador e integración con predicción de acciones.
Precios de FLUX 3
Black Forest Labs cobra FLUX 3 por duración de video generado.
| Modo | Precios oficiales de FLUX 3 de BFL |
|---|---|
| T2V / I2V borrador HD | $0.06/s |
| T2V / I2V HD | $0.17/s |
| T2V / I2V FHD | $0.29/s |
| T2V / I2V QHD (2K) | $0.40/s |
| T2V / I2V UHD (4K) | $0.80/s |
| Borrador de continuación de video | $0.12/s |
| Continuación de video HD | $0.41/s |
| Continuación de video FHD | $0.53/s |
| Continuación de video QHD (2K) | $0.65/s |
| Continuación de video UHD (4K) | $0.95/s |
Una generación estándar de 10 segundos en HD cuesta aproximadamente $1.70 según la tarifa listada de BFL, mientras que una generación de 10 segundos en FHD cuesta aproximadamente $2.90. La continuación de video es sustancialmente más cara que la generación ordinaria, por lo que las aplicaciones que extienden clips con frecuencia deben modelar esos costos por separado.
Precio de FLUX 3 en CometAPI
CometAPI actualmente lista FLUX 3 como disponible con el ID de modelo flux-3.
| Resolución | Precios de FLUX 3 en CometAPI |
|---|---|
| 720p | $0.136/s |
| 1080p | $0.232/s |
Para una generación de 10 segundos, eso corresponde aproximadamente a $1.36 en 720p o $2.32 en 1080p. En comparación con las tarifas listadas de BFL de $0.17/s y $0.29/s, los precios predeterminados de CometAPI son alrededor de un 20% más bajos para estos dos niveles.
Nota sobre disponibilidad: parte del contenido descriptivo antiguo en CometAPI aún refleja el período de Acceso Temprano de julio. La ficha del modelo en vivo, la sección de precios y el ejemplo de API listan flux-3 como Available, con una fecha de lanzamiento en CometAPI del 13 de agosto de 2026. Para decisiones de integración, el API en vivo y los campos de precios son más relevantes que el texto de disponibilidad antiguo.
Por qué FLUX 3 importa más allá del video de IA
Lo más inusual de FLUX 3 no es la generación de video de 20 segundos. Varios competidores ya pueden generar clips igual de largos o más. La apuesta técnica más grande es que una representación de video sólida puede convertirse en una base para otras formas de inteligencia.
De la predicción de video a la predicción de acciones
Las señales de control robótico son predicciones temporales condicionadas a observaciones visuales, por lo que BFL usa la representación de video de FLUX 3 como base para la predicción de acciones. Su colaboración con mimic robotics produjo FLUX-mimic, en el que un decodificador de acciones lee representaciones del modelo de video en lugar de entrenar una pila de percepción completamente independiente.
BFL informa que la columna vertebral de FLUX-mimic puede ejecutarse en menos de 80 ms en una sola RTX 5090, mientras que el sistema robótico completo alcanza un bucle de reacción de aproximadamente 101 ms. La compañía también ha hablado de evaluación industrial con Audi.
Esto no convierte al Video API público de FLUX 3 en un API de robótica. Sí demuestra por qué BFL invirtió fuertemente en representación de video multimodal en lugar de tratar la generación de video como una tarea de medios aislada.
¿Cuáles son las principales fortalezas de FLUX 3?
- Consistencia temporal y de escena. La puntuación de Consistencia de escena de 94.76 de Megaton es la categoría principal más fuerte del modelo.
- Generación audiovisual nativa. Diálogo, efectos, ambiente y visuales pueden generarse juntos en lugar de ensamblarse desde modelos separados.
- Fuerte adherencia al prompt. El resultado independiente de Adherencia al prompt de 87.07 sugiere que las fortalezas del modelo van más allá del pulido visual puro.
- Control por fotogramas clave. Hasta diez imágenes pueden participar en los flujos actuales de imagen a video, dando a los creadores control temporal explícito.
- Flujo de borrador a final. El Modo borrador aborda un problema de costo real en video de IA: muchas generaciones se descartan durante la iteración de prompts.
- Amplio rango visual. BFL posiciona FLUX 3 como capaz de salidas crudas, naturales, cinematográficas, nostálgicas, lúdicas, estilizadas e inusuales en lugar de un único estilo fijo de casa.
- Dirección de investigación de modelo del mundo. Self-Flow y la predicción de acciones hacen que FLUX 3 sea relevante más allá de la generación de medios.
¿Cuáles son las limitaciones de FLUX 3?
- La hoja de ruta multimodal completa no se ha lanzado. No se deben asumir FLUX 3 Image público y FLUX 3 Dev con pesos abiertos a partir del anuncio de la familia.
- 20 segundos ya no es la duración líder en la industria. Algunos competidores de 2026 ya admiten generaciones de 30 segundos.
- La física no está resuelta. Megaton da a FLUX 3 una puntuación de Física de 70.63, considerablemente por debajo de su puntuación de consistencia de escena.
- La fidelidad humana aún tiene margen de mejora. Una puntuación independiente de 73.70 significa que la anatomía difícil y el movimiento humano realista aún pueden fallar.
- La continuación de video es cara. El precio de continuación de BFL es sustancialmente más alto por segundo que el T2V/I2V ordinario.
- El benchmark competitivo principal de BFL es interno. Las decisiones de producción también deben incluir pruebas independientes usando los prompts, tipos de plano, idiomas y recursos de referencia de la propia aplicación.
Cómo usar FLUX 3 con CometAPI
La cobertura anterior de FLUX 3 de CometAPI explica la fase de Acceso Temprano de julio, los benchmarks preliminares y el plan de despliegue. Esta sección se centra en la integración de producción actual, los precios y el flujo del API en funcionamiento para no repetir ese recorrido histórico. El modelo de producción FLUX 3 usa el ID de modelo flux-3.
Una petición básica a 720p usa el endpoint /v1/videos:
Bash
curl --request POST "https://api.cometapi.com/v1/videos" \--header "Authorization: Bearer $COMETAPI_KEY" \ --form-string "model=flux-3" \ --form-string "prompt=Un barco de papel se desliza por un estanque tranquilo a la suave luz de la mañana" \ --form-string "seconds=5" \ --form-string "size=1280x720" |
|---|
El flujo de video es asíncrono. Después de que la solicitud inicial devuelve un ID de tarea, la aplicación comprueba la tarea hasta que la generación se complete y luego recupera el video resultante. Para aplicaciones de producción, la generación normalmente debe ser manejada por un trabajo en segundo plano o una cola de tareas en lugar de mantener una solicitud HTTP abierta durante todo el tiempo de renderizado.
¿Quién debería usar FLUX 3?
FLUX 3 es particularmente atractivo para aplicaciones que necesitan algo más que clips de cinco segundos visualmente atractivos: sistemas publicitarios con visuales y audio sincronizados, producción automatizada de formato corto, demostraciones de producto donde la persistencia de objetos importa, generación de diálogo multilingüe, flujos de storyboard a video, animación controlada por fotogramas clave, contenido educativo y experimentos con pipelines multimodales más largos.
Puede ser menos atractivo cuando el único requisito es el costo por segundo más bajo, cuando se deben generar más de 20 segundos en una sola pasada o cuando la generación de imágenes fijas es la tarea principal. Para imágenes fijas, un modelo de imagen FLUX existente como FLUX.2 Max puede ser actualmente una mejor opción.
¿Es FLUX 3 mejor que otros modelos de video de IA?
No hay una única respuesta defendible para todos los casos de uso. La evaluación interna de BFL sitúa al FLUX 3 lanzado en la cima de su comparación de texto a video, mientras que la evaluación independiente de Megaton coloca a FLUX 3 tercero en general por detrás de competidores más nuevos. Ambos resultados pueden ser válidos porque las pruebas miden distribuciones de prompts y dimensiones de calidad diferentes.
FLUX 3 parece particularmente fuerte cuando importan la consistencia de escena, el seguimiento de prompts, la fidelidad de objetos, la coherencia causal, el renderizado de texto, el sonido sincronizado y los fotogramas clave controlables. Otros modelos pueden ganar en duración máxima, resolución, preferencias artísticas, fidelidad humana, flujos de edición o costo. Para los desarrolladores, la comparación correcta es específica de la carga de trabajo más que del ranking.
Preguntas frecuentes
¿Está FLUX 3 disponible ahora?
Sí. FLUX 3 Video alcanzó disponibilidad general a través de BFL el 4 de agosto de 2026. CometAPI también lista FLUX 3 como Available bajo el ID de modelo flux-3. El lanzamiento de imagen fija FLUX 3 y los pesos abiertos FLUX 3 Dev siguen siendo elementos de la hoja de ruta separados.
¿Puede FLUX 3 generar audio?
Sí. FLUX 3 Video genera audio nativo sincronizado, incluido diálogo, sonido ambiental y efectos. También se admiten diálogo multilingüe y sincronización labial.
¿Qué duración pueden tener los videos de FLUX 3?
La generación actual de texto a video e imagen a video admite 5–20 segundos. La continuación de video admite 5–15 segundos de contenido recién generado.
¿Qué resolución admite FLUX 3?
BFL admite HD (hasta 1 megapíxel por fotograma), FHD (hasta 2 MP), QHD/2K (hasta 4 MP) y UHD/4K (hasta 8 MP). Una salida FHD 16:9 es 1920 × 1088. Las bandas de resolución se basan en píxeles totales por fotograma en lugar de la relación de aspecto; el Modo borrador es solo HD.
¿FLUX 3 admite imagen a video?
Sí. La generación de imagen a video y por fotogramas clave forman parte del conjunto de funciones de FLUX 3 Video con disponibilidad general.
¿FLUX 3 es un modelo de generación de imágenes?
Arquitectónicamente, FLUX 3 se entrena en imágenes, video y audio, y BFL ha demostrado investigación en generación y edición de imágenes. Sin embargo, el producto FLUX 3 Image sigue siendo un lanzamiento pendiente; no confunda la hoja de ruta de la familia con el Video API público FLUX 3 disponible actualmente.
¿FLUX 3 es de código abierto?
Actualmente no. BFL ha anunciado FLUX 3 Dev, una variante multimodal con pesos abiertos, pero aún no ha proporcionado una fecha de lanzamiento pública.
¿Cuánto cuesta FLUX 3?
BFL fija el precio de texto/imagen a video en $0.06/s para borrador HD, $0.17/s para HD, $0.29/s para FHD, $0.40/s para QHD y $0.80/s para UHD. Video a video cuesta $0.12/s para borrador HD; luego $0.41/s para HD, $0.53/s para FHD, $0.65/s para QHD y $0.95/s para UHD. CometAPI actualmente lista $0.136/s para 720p y $0.232/s para 1080p.
¿Qué es Self-Flow?
Self-Flow es el enfoque de ajuste de flujo auto-supervisado de BFL. Está diseñado para permitir que un modelo generativo desarrolle representaciones internas útiles sin depender de un modelo de representación externo. Su uso de diferentes niveles de ruido entre tokens anima a la red a inferir información faltante y aprender relaciones entre observaciones multimodales.
¿FLUX 3 es un modelo del mundo?
Black Forest Labs posiciona FLUX 3 como una base de modelo de realidad porque sus representaciones compartidas se extienden desde la predicción audiovisual hacia la predicción de acciones físicas. Llamarlo un modelo del mundo general completo sería más fuerte que la evidencia que existe actualmente; una descripción más precisa es un modelo fundacional generativo multimodal diseñado explícitamente en torno a objetivos de modelado del mundo.
Conclusión
FLUX 3 representa un cambio mayor para Black Forest Labs que una actualización convencional de un modelo de imagen FLUX a otro. Su idea clave es entrenar una representación multimodal compartida del mundo y luego usar esa representación para video, sonido, imágenes y, eventualmente, acciones. Self-Flow proporciona la base de investigación, mientras que el modelo FLUX 3 Video lanzado es la primera demostración de producción de esa estrategia.
A septiembre de 2026, FLUX 3 Video admite clips de hasta 20 segundos, 24 fps, salida desde HD hasta UHD/4K, audio sincronizado, diálogo multilingüe, imagen a video, fotogramas clave, continuación de video, generación de múltiples tomas y Modo borrador.
La imagen de benchmarks también es más creíble que en el lanzamiento. La evaluación actual del modelo lanzado de BFL sitúa a FLUX 3 primero en su prueba ELO interna de T2V, mientras que las pruebas independientes de Megaton lo ubican tercero en general y destacan una consistencia de escena particularmente fuerte.
FLUX 3 por lo tanto no es automáticamente el mejor modelo de video para todas las cargas de trabajo. Seedance 2.5, MiniMax H3, y Wan 3.0 pueden ofrecer generación más larga, resolución nominal más alta, precios más bajos o distintas capacidades de referencia y edición.
Lo que hace a FLUX 3 inusualmente interesante es la dirección debajo del generador de video: BFL apuesta a que las mismas representaciones necesarias para predecir video convincente eventualmente pueden soportar generación de imágenes, audio, razonamiento físico y acciones robóticas. Los desarrolladores ya pueden probar el primer paso de producción a través de FLUX 3 en CometAPI usando el ID de modelo flux-3.