Construye con CometAPI¿Necesitas una sola API para varios modelos?Prueba el flujo en el Playground y luego crea una clave de API cuando el modelo y el costo encajen con tu caso de uso.
¿Qué es MiMo-V2.5? Especificaciones, pruebas comparativas, características, precios y acceso a la API
Explora las especificaciones de Xiaomi MiMo‑V2.5, la arquitectura, los benchmarks oficiales, los precios, la comparación con MiMo‑V2.5‑Pro, los casos de uso, las limitaciones y el acceso a CometAPI.
Deon GoodwinEquipo de investigación de modelos de IA y API
El modelo estándar V2.5 de Xiaomi combina comprensión nativa de texto, imágenes, video y audio con una ventana de contexto de 1 millón de tokens, uso de herramientas y eficiencia de Mixture-of-Experts disperso. Es la mejor opción cuando importan la entrada multimodal y el costo por tarea completada. La variante Pro es más grande y sólida para trabajos exigentes de programación y agentes de largo horizonte, pero se centra en entrada de texto y cuesta aproximadamente el triple por token según las tarifas publicadas por Xiaomi.
La decisión práctica es sencilla: elige el modelo estándar para agentes multimodales, análisis de documentos y medios, y automatización de alto volumen; elige Pro cuando el cuello de botella sea ingeniería de software difícil o ejecución autónoma sostenida.
Key Takeaways
El modelo estándar usa 310B parámetros totales y activa 15B por token.
Acepta texto, imágenes, video y audio, y devuelve texto.
Su API admite contexto de 1M, hasta 128K de salida, llamadas a herramientas, búsqueda web, streaming, salida estructurada y caché de contexto.
Revisado para mayor claridad, atribución de fuentes y terminología API actual.
Resultados informados por el publicador incluyen 65.8 en Terminal-Bench 2.0 y 56.1 en SWE-Bench Pro.
La model card actual de Xiaomi para MiMo-V2.5-Pro lista 1.02T parámetros totales y 42B activos. Las puntuaciones de SWE-Bench Pro listadas por el publicador son 56.1 para MiMo-V2.5 y 57.2 para Pro; son comparaciones con fecha, informadas por el publicador, no una garantía para un flujo de trabajo de programación específico.
A las tarifas actuales de Xiaomi, los costos de entrada/salida del estándar son $0.14/$0.28 por millón de tokens; Pro cuesta $0.435/$0.87.
Ambas APIs en CometAPI tienen un precio 20% por debajo del par oficial sin caché.
Información verificada: September 28, 2026. Los precios, benchmarks, límites, disponibilidad y formatos de solicitud pueden cambiar. Xiaomi ha anunciado que los nombres de modelo oficiales mimo-v2.5 y mimo-v2.5-pro de su API serán desaprobados a las 10:00 hora de Beijing el October 21, 2026, sin reemplazo automático. Planifica la migración y confirma la ruta activa antes del despliegue.
Nota sobre el ciclo de vida de la API: la plataforma oficial de Xiaomi planea retirar ambos IDs de modelos V2.5 el October 21, 2026. Este aviso concierne a la plataforma de API de Xiaomi; verifica cualquier gateway de terceros por separado. Aviso de desaprobación de modelos de Xiaomi
What the Standard Model Is
MiMo-V2.5 es el modelo base de Xiaomi MiMo orientado a la eficiencia para percepción multimodal y trabajo de agentes. Proporciona entrada nativa de texto, imágenes, video y audio dentro de una única arquitectura y produce salida de texto.
El registro de lanzamientos del modelo de Xiaomi fecha la beta pública de la serie MiMo-V2.5 al April 23, 2026. Los pesos se publicaron posteriormente bajo la licencia MIT. MiMo-V2.5 tiene 310B parámetros en total, pero activa solo unos 15B por token; usa un gran conjunto de especialistas sin ejecutarlos todos a la vez.
MiMo-V2.5-Pro apunta a una carga de trabajo diferente. Es un modelo de un billón de parámetros, con entrada de texto, diseñado para las tareas más difíciles de programación, terminal y agentes de larga duración. Las dos variantes comparten un contexto máximo de 1M pero difieren marcadamente en modalidad, cómputo activo y precio.
MiMo-V2.5 Specifications and Features
Official architecture details
Value
Why it matters
Architecture
Sparse MoE
Gran capacidad de expertos con activación selectiva
Total / active parameters
310B / 15B
El cómputo activo está muy por debajo de la capacidad total
Transformer layers
48: 1 dense + 47 MoE
La mayoría de capas usan expertos enrutados
Routed experts
256; 8 active per token
Especialización sin ejecutar densamente 310B
Attention
39 SWA + 9 global layers
Equilibra eficiencia local y flujo a largo alcance
SWA window
128 tokens
Reduce la presión de caché en contextos largos
Context / maximum output
1M / 128K tokens
Admite documentos largos y trazas extendidas
Input / output
Text, image, video, audio / text
Percepción nativa en cuatro tipos de entrada
Vision encoder
729M ViT; 28 layers
Comprensión de imágenes y video
Audio encoder
261M transformer; 24 layers
Comprensión nativa de audio
Multi-Token Prediction
3 modules; about 329M parameters
Admite eficiencia de decodificación especulativa
El entorno operativo incluye contexto de 1M y salida de 128K, además de límites publicados de 100 solicitudes por minuto y 10 millones de tokens por minuto. Los límites a nivel de proveedor pueden diferir por cuenta y ruta de integración.
Sparse Experts: Total Capacity Is Not Active Compute
El hecho central de eficiencia es el diseño de 310B totales y 15B activos. El enrutador selecciona ocho de 256 expertos para cada token. Eso le da al modelo acceso a un conjunto de parámetros mucho mayor que un modelo denso convencional de 15B sin ejecutar todos los 310B parámetros cada vez.
Esto no hace trivial el autoalojamiento. Los pesos completos aún deben almacenarse y distribuirse, por lo que la capacidad de memoria, el ancho de banda de interconexión, el enrutamiento de expertos y el software de servicio siguen siendo limitaciones materiales.
Hybrid Attention for Long Context
El tronco intercala atención de ventana deslizante y global en una relación SWA:global de 5:1. Treinta y nueve capas locales controlan el crecimiento de la caché, mientras que nueve capas globales preservan el flujo de información a larga distancia. Xiaomi reporta casi una reducción de seis veces en la caché KV frente a un diseño totalmente global.
Un máximo de 1M tokens es capacidad, no precisión garantizada. La calidad de recuperación, la latencia, el crecimiento del estado de herramientas y la atención sobre evidencia distante aún requieren evaluación específica por carga de trabajo.
Native Encoders and Agent Features
Un transformador de visión de 729M parámetros maneja entradas de imágenes y video; un transformador de audio de 261M parámetros maneja audio. Los proyectores mapean ambos flujos al tronco de lenguaje, permitiendo que un único agente combine una captura de pantalla, un segmento de video, una pista de audio, instrucciones de texto y resultados de herramientas.
Tres módulos de predicción de múltiples tokens admiten decodificación especulativa y eficiencia de aprendizaje por refuerzo. El modelo fue entrenado en alrededor de 48T tokens, con el contexto ampliado progresivamente a 1M durante el posentrenamiento.
Los pesos abiertos usan una licencia MIT. Se permite el despliegue comercial, pero el costo de infraestructura y las dependencias de terceros aún requieren revisión separada.
MiMo-V2.5 Benchmarks: Coding, Agents, and Multimodal Results
Nota de benchmark:
las cifras a continuación son informadas por el publicador. Son evidencia direccional, no una garantía para un repositorio específico, formato de medios, pila de herramientas, objetivo de latencia o política de seguridad.
Coding and Agent Results
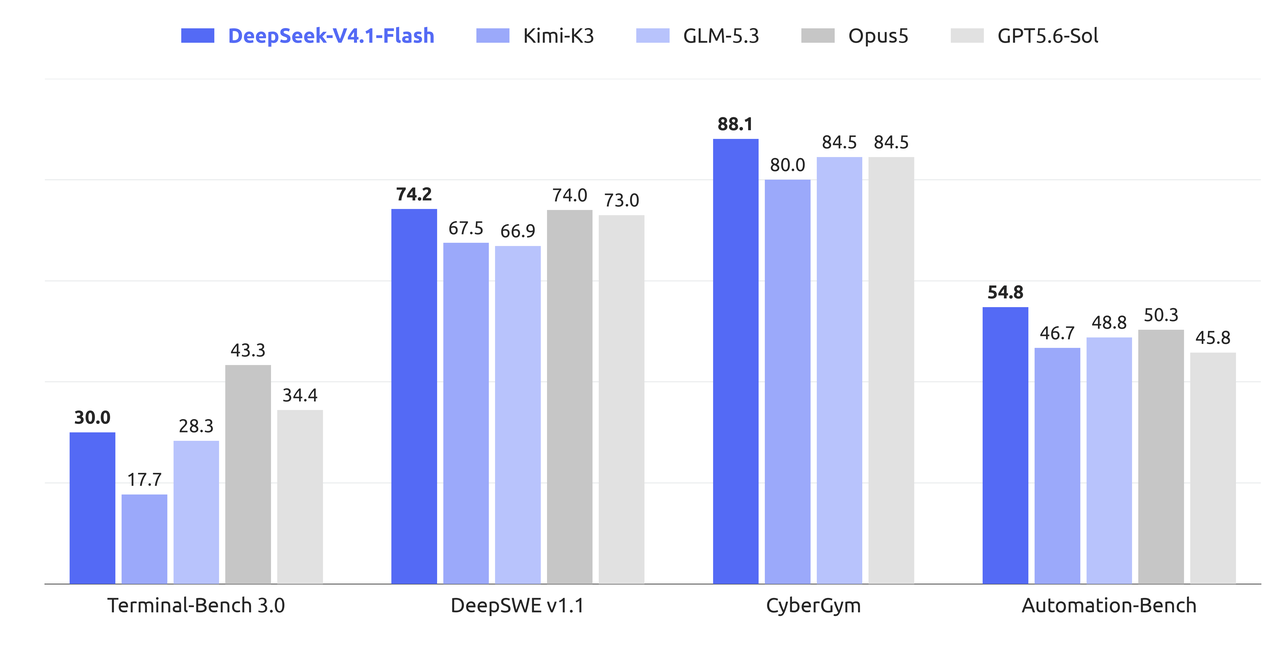
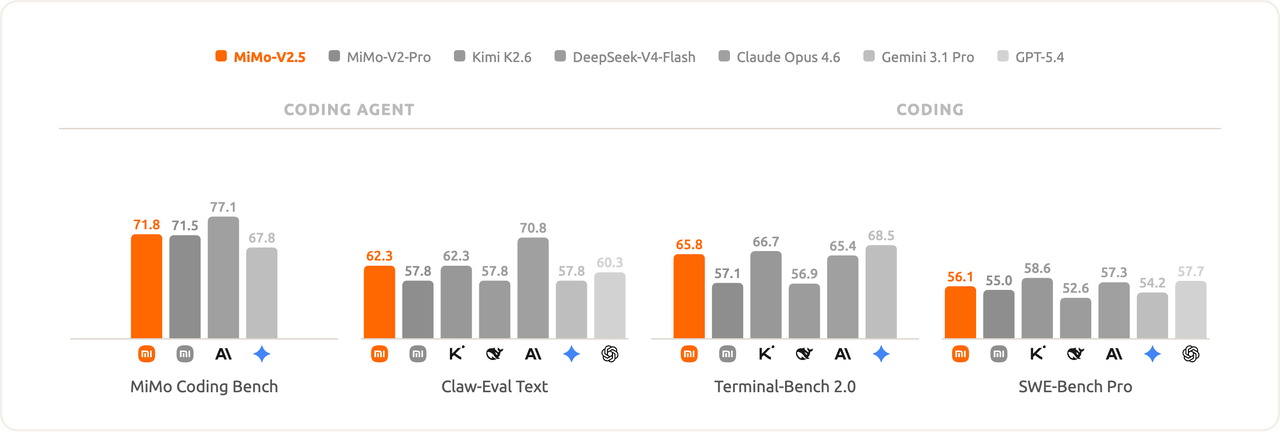
Gráfico oficial de benchmarks de programación y agentes de Xiaomi MiMo.
Official coding benchmark
Reported score
Decision signal
MiMo Coding Bench
71.8
Capacidad amplia de agentes de programación
Claw-Eval Text
62.3
Compleción general de agentes de texto
Terminal-Bench 2.0
65.8
Ejecución interactiva en terminal
SWE-Bench Pro
56.1
Ingeniería de software en el mundo real
Claw-Eval Multi-Turn
63.2
Trabajo de agentes multietapa más largo
ResearchClawBench
16.91
Flujos de trabajo de investigación autónomos
Resultado: el caso más sólido es el uso práctico de herramientas más que la simple finalización de código. Un resultado de 65.8 en Terminal-Bench respalda agentes orientados a terminal, mientras que 56.1 en SWE-Bench Pro sugiere capacidad útil a nivel de repositorio. La puntuación de investigación mucho más baja recuerda que se debe probar por separado la recopilación de evidencia y el comportamiento de citación.
Multimodal Results
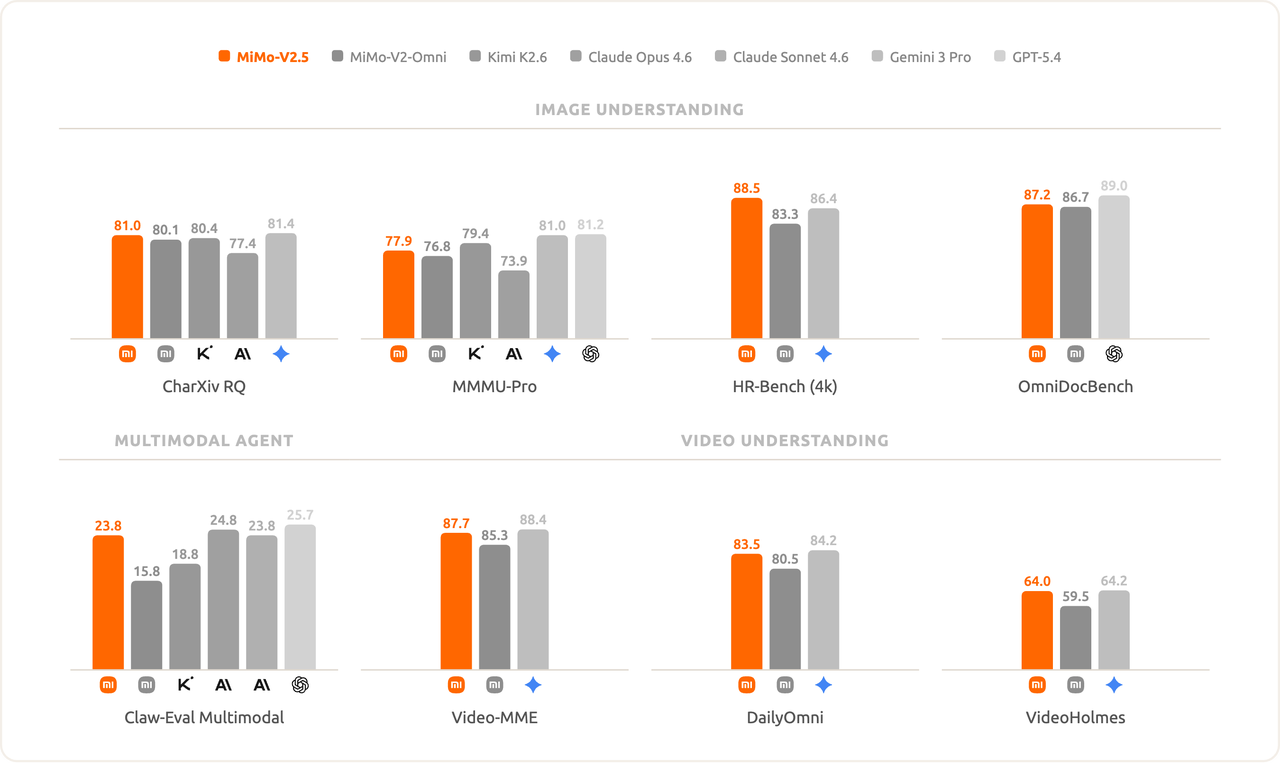
Gráfico oficial de benchmarks de imagen, video y agentes multimodales de Xiaomi MiMo.
Official multimodal benchmark
Reported score
Capability tested
CharXiv RQ
81.0
Razonamiento sobre gráficos y documentos
MMMU-Pro
77.9
Razonamiento multimodal a nivel experto
HR-Bench 4K
88.5
Comprensión de imágenes de alta resolución
OmniDocBench
87.2
Comprensión de documentos
Claw-Eval Multimodal
23.8
Compleción de agentes multimodales
Video-MME
87.7
Comprensión de video
DailyOmni
83.5
Razonamiento audiovisual cotidiano
VideoHolmes
64.0
Razonamiento temporal en video
Resultado: las fortalezas más claras son la comprensión de documentos, imágenes de alta resolución y video. La puntuación de 23.8 en agentes multimodales es mucho más baja que las de percepción, por lo que un sistema que deba tanto entender medios como operar herramientas de forma fiable debe evaluarse de extremo a extremo.
MiMo-V2.5 vs MiMo-V2.5-Pro: Multi-Dimensional Comparison
Official architecture comparison
MiMo-V2.5
MiMo-V2.5-Pro
Official Pro specifications
Official Pro benchmarks
Practical implication
Total parameters
310B
1.02T
Pro tiene más de 3× la capacidad total
Activated parameters
15B
42B
Pro usa ~2.8× más parámetros activos
Layers / routed experts
48 / 256
70 / 384
Pro es un objetivo de servicio más grande
Model-card context ceiling
1M
1M
Ambos listan hasta 1M tokens; prueba recuperación y latencia al tamaño de tu carga
Official API maximum output
128K
128K
Las páginas actuales de la API de Xiaomi listan 128K; los límites específicos pueden variar
Native input
Text, image, video, audio
Text
MiMo-V2.5 es la opción multimodal documentada; verifica el endpoint Pro exacto antes de enviar medios
SWE-Bench Pro
56.1
57.2
Pro lidera por 1.1 puntos
Terminal-Bench 2.0
65.8
68.4
Pro lidera por 2.6 puntos
Primary fit
Efficient multimodal agents
Complex coding and long-horizon agents
Elige según la carga probada; los márgenes a nivel de modelo no prueban una ventaja general
Resultado de la comparación: la ventaja de Pro en benchmarks compartidos de agentes de programación es modesta, mientras que la variante estándar añade entrada nativa de imagen, video y audio y usa muchos menos parámetros activos. Pro se justifica cuando pequeñas ganancias en tareas difíciles valen más que la entrada multimodal y el menor costo unitario.
How Much Do MiMo-V2.5 and MiMo-V2.5-Pro Cost?
Price basis: May 27, 2026
Official standard API
Official Pro API
MiMo-V2.5 API in CometAPI
MiMo-V2.5-Pro API in CometAPI
Input, cache miss / MTok
$0.14
$0.435
$0.112
$0.348
Output / MTok
$0.28
$0.87
$0.224
$0.696
Input, cache hit / MTok
$0.0028
$0.0036
Check live billing
Check live billing
Discount vs official uncached rate
Baseline
Baseline
20%
20%
A tarifas oficiales, Pro cuesta alrededor de 3.1× más que el estándar tanto para entrada como salida sin caché. Los precios del proveedor mostrados arriba reducen cada par sin caché en 20%, pero la brecha relativa entre variantes permanece esencialmente igual.
El precio por token no es el costo total. Reintentos de herramientas, tamaño de contexto, longitud de salida, latencia, recuperación de tareas fallidas y revisión humana determinan el costo por tarea completada. Ejecuta una muestra de carga representativa antes de seleccionar un modelo de producción por defecto.
What Is MiMo-V2.5 Best For?
Agentes multimodales: combina capturas de pantalla, documentos, video, audio, instrucciones y herramientas en un solo flujo.
Análisis de documentos largos: procesa repositorios, contratos, archivos de investigación, registros y historiales de soporte.
Comprensión de medios: resume videos, extrae eventos, interpreta gráficos y responde preguntas audiovisuales.
Agentes de programación y terminal: inspecciona archivos, ejecuta comandos, modifica código e itera sobre resultados de pruebas.
Automatización de alto volumen: usa activación dispersa y precios de tokens más bajos para tareas de producción repetidas.
Limitations and Risks
Solo 15B parámetros se activan por token, pero el autoalojamiento aún requiere el sistema completo de 310B pesos.
La salida multimodal es texto; la generación de imágenes, voz y video requiere otros modelos.
Un techo de contexto de 1M no garantiza precisión uniforme en toda la ventana.
Los benchmarks del publicador pueden no transferirse a herramientas, repositorios, prompts o restricciones de seguridad personalizados.
La exposición de modalidades por parte del proveedor puede diferir de la capacidad completa del modelo de pesos abiertos subyacente.
Puerta de producción:
valida precisión, finalización de llamadas a herramientas, latencia, consumo de tokens, manejo de modalidades y comportamiento de fallback en tareas representativas antes de comprometer tráfico.
API Example
El siguiente ejemplo en Python usa un endpoint de CometAPI compatible con OpenAI y el ID del modelo estándar. Confirma el endpoint actual y el esquema de solicitud admitido antes del despliegue.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
    max_retries=0,
)

response = client.chat.completions.create(
    model="mimo-v2.5",
    max_tokens=256,
    messages=[
        {
            "role": "user",
            "content": "Summarize the main findings in this technical report.",
        }
    ],
)

print(response.choices[0].message.content)
Decision Guide
Workload signal
Start with
Switch when
Images, video, or audio are first-class inputs
Standard
No cambies salvo que el preprocesamiento multimodal sea aceptable
Large document or mixed-media volume
Standard
Pro solo si los fallos de razonamiento dominan el costo
Difficult repository engineering
Test both
Elige Pro si su ganancia en finalización compensa el costo unitario 3.1×
Long autonomous terminal trajectories
Pro
Vuelve al estándar si las ganancias no son medibles
High-volume routine automation
Standard
Escala solo tareas fallidas o de alto valor
Recomendación de enrutamiento:
usa el estándar como predeterminado para trabajo multimodal y de alto volumen, y enruta solo las tareas difíciles orientadas a texto o de largo horizonte a Pro. Esto preserva la capacidad mientras controla el costo total.
Conclusion
El modelo estándar no es simplemente un Pro más pequeño. Es un punto de optimización distinto: entrada multimodal nativa, contexto de 1M, sólidos benchmarks orientados a herramientas y 15B parámetros activos a un precio por token mucho más bajo.
Pro es la opción especialista para ingeniería de software difícil y ejecución autónoma sostenida. Su capacidad adicional produce ganancias medibles pero no universales, por lo que el patrón de despliegue más sólido es el enrutamiento basado en carga de trabajo en lugar de seleccionar una variante para cada solicitud.
FAQ
Is the standard model open source?
Sus pesos se publican bajo la licencia MIT, lo que permite uso comercial, modificación, fine-tuning y redistribución sujetos a los términos de la licencia.
How many parameters does it use?
El MoE disperso contiene 310B parámetros totales y activa 15B por token. Los parámetros activos describen el cómputo por token, no el tamaño de almacenamiento del modelo completo.
Does it support images, video, and audio?
Sí. La variante estándar acepta texto, imágenes, video y audio y devuelve texto. La especificación oficial de la variante Pro lista entrada de texto.
What is the maximum context window?
Ambas model cards especifican una ventana de contexto de hasta 1M tokens. Las páginas actuales de la API de Xiaomi listan una salida máxima de 128K para MiMo-V2.5 y MiMo-V2.5-Pro. Los límites utilizables reales pueden variar según el endpoint, proveedor, cuenta y formato de solicitud; verifica la ruta desplegada antes de depender de esos techos.
La página actual de la API oficial de Pro confirma por separado el contexto de 1M y una salida máxima de 128K: MiMo-V2.5-Pro API specifications
Which variant is better for coding agents?
Pro reporta resultados más altos en benchmarks compartidos de programación y terminal, pero el margen es modesto. Prueba ambos en el repositorio objetivo y elige según finalización de tareas, latencia y costo total.
Which variant is better for multimodal agents?
La variante estándar es la elección natural porque acepta nativamente entrada de imágenes, video y audio. Pro se centra en entrada de texto.
How should a production team choose?
Comienza con el estándar, mide fallos y enruta solo las tareas difíciles orientadas a texto que se beneficien de Pro. Compara el costo por tarea completada en lugar del precio por token únicamente.
Training scale
About 48T tokens
Amplia canalización de entrenamiento textual y multimodal