
TL;DR
La OpenAI Decisions API es un endpoint especializado que convierte texto e imágenes en decisiones procesables y legibles por máquina en lugar de prosa generada. Usa GPT-6 Luna y admite preguntas de tipo predicado, elección y puntuación. OpenAI reporta un rendimiento aproximadamente 10× más rápido que su Responses API para tareas de decisión compatibles y un precio estándar de entrada de $0.10 por millón de tokens.
Key Takeaways
- Decisiones diseñadas para un propósito: preguntas predefinidas en lugar de conversación libre.
- Tres tipos de decisión: predicado, elección y puntuación.
- Automatización consciente de la probabilidad: enruta entradas ambiguas o de alto impacto a revisión humana.
- Ganancias de velocidad reportadas por el proveedor y precio estándar de entrada de $0.10 por millón de tokens sin cobro por salida hacen que el endpoint sea relevante para decisiones de alto volumen.
- Ideal para enrutamiento, clasificación, comprobaciones visuales y compuertas de decisión para agentes de IA.
What Is the OpenAI Decisions API?
La OpenAI Decisions API evalúa información y devuelve decisiones acotadas y legibles por máquina. OpenAI la lanzó en beta el 6 de octubre de 2026. Esta guía es para desarrolladores que ya entienden claves de API y JSON y quieren evaluar flujos de trabajo de clasificación o enrutamiento. Los detalles del producto se verificaron el 12 de octubre de 2026.
El esquema de solicitud POST /v1/decisions acepta un modelo, entrada compartida de texto o imagen y preguntas definidas por el desarrollador. El endpoint dedicado devuelve juicios tipados en lugar de prosa explicativa.
OpenAI Decisions API specifications
| Especificación | Detalles documentados del endpoint |
|---|---|
| Tipo de producto | Endpoint de API especializado, no un modelo fundacional independiente |
| Endpoint | POST /v1/decisions |
| Modelo subyacente | gpt-6-luna |
| Entradas | Texto e imágenes |
| Tipos de decisión | predicado, elección, puntuación |
| Salidas | Decisiones tipadas e información de probabilidad |
| Rendimiento | Aproximadamente 10× más rápido que Responses API (afirmación del proveedor) |
| Precio estándar de entrada | $0.10 / 1M tokens |
| Cargo por salida | Ninguno para Decisions API |
| Llamada de herramientas / streaming | No compatible directamente con este endpoint |
Current availability and access
Al 15 de octubre de 2026, la guía oficial indica acceso en beta pública, con gpt-6-luna como el único modelo compatible. Envía solicitudes a POST /v1/decisions; el estado beta no garantiza estabilidad en producción.
Usa un proyecto de la OpenAI API y verifica su acceso al modelo, estado de facturación y límites de tasa antes del despliegue. La guía menciona el SDK de Python 3.26.0 o posterior; el acceso específico de la cuenta debe confirmarse con una solicitud de prueba pequeña.
Los clientes elegibles pueden usar Zero Data Retention y acuerdos HIPAA. La guía indica procesamiento regional en EE. UU. y Europa; siguen aplicando la elegibilidad y los requisitos contractuales. El acceso mediante una interfaz Luna de terceros no supone compatibilidad con este endpoint dedicado.
How Does the OpenAI Decisions API Work?
Una solicitud combina evidencia de entrada compartida con preguntas definidas por el desarrollador. La API evalúa la entrada usando GPT-6 Luna y devuelve respuestas que el código de la aplicación puede usar para automatizar, revisar o escalar. Varias preguntas pueden compartir la misma entrada, aunque las preguntas dependientes deben secuenciarse desde la aplicación.
Predicate evaluation
Un predicado evalúa si se cumple una condición específica. Un minorista podría preguntar si una fotografía muestra daños visibles en el producto; la respuesta proporciona una probabilidad entre 0 y 1.
Extracto ilustrativo de una respuesta de tipo predicado.
{
  "type": "predicate",
  "name": "visible_damage",
  "probability": 0.92
}
Choice selection
Una pregunta de elección selecciona entre categorías suministradas explícitamente, como Billing, Technical Support o Account Access. Los campos de distribución y confianza respaldan políticas posteriores de enrutamiento y escalamiento.
Score evaluation
Una pregunta de puntuación evalúa la entrada frente a una rúbrica ordenada. La puntuación esperada puede reflejar los índices ponderados por probabilidad de los niveles definidos; esto no representa automáticamente un riesgo real calibrado.
| Índice | Severidad | Interpretación |
|---|---|---|
| 0 | Baja | Sin acción inmediata |
| 1 | Moderada | Seguimiento rutinario |
| 2 | Alta | Impacto significativo en el cliente |
| 3 | Crítica | Escalamiento inmediato |
What Are the Main Features of the OpenAI Decisions API?
Fast, bounded execution
Las salidas tipadas eliminan gran parte de la necesidad de generar prosa, analizar texto o reintentar respuestas mal formadas. OpenAI describe una mejora de velocidad relativa de aproximadamente diez veces en tareas de decisión compatibles; las ganancias reales dependerán de la longitud de la entrada, la sobrecarga de red y la concurrencia.
Multiple questions over shared context
Un ticket de soporte puede evaluarse para departamento, urgencia y elegibilidad de revisión en una sola solicitud. Las aplicaciones aún deben aplicar reglas de negocio deterministas y comprobaciones de autorización.
Text and image understanding
Texto e imágenes admiten enrutamiento de tickets, triaje de capturas de pantalla e inspección visual. Consulta la documentación oficial para formatos de imagen compatibles, límites de tamaño y estructuras de carga útiles aceptadas actualmente.
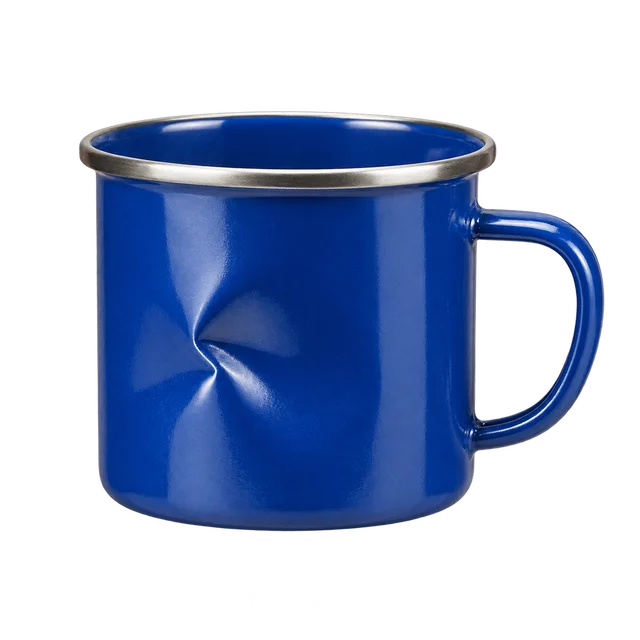
OpenAI utiliza esta taza abollada en su ejemplo de decisión visual. La imagen ilustra daño observable; no es evidencia de una tasa de precisión medida. Este endpoint acepta URLs de datos de imagen en base64 inline, no URLs de imágenes alojadas ni IDs de archivo.
Probability-aware automation
La confianza reportada no es precisión garantizada. Los equipos deben ajustar umbrales con datos etiquetados de reserva, usando umbrales separados para casos con altas consecuencias de falsos positivos o falsos negativos.
Security and data controls
La retención de datos, el procesamiento regional y el uso regulado dependen de la configuración de la cuenta y de los requisitos contractuales aplicables. Confirma la elegibilidad antes de procesar información regulada o sensible.
How Much Does the OpenAI Decisions API Cost?
La tarifa estándar reportada es de $0.10 por millón de tokens de entrada sin facturación de tokens de salida mediante el endpoint dedicado Decisions. Los multiplicadores por procesamiento regional o contexto largo pueden alterar la factura final.
| Componente | Precio del endpoint dedicado |
|---|---|
| Entrada estándar | $0.10 por 1M tokens |
| Tokens de salida | $0 |
| Lecturas / escrituras de caché | $0 |
| Procesamiento regional | Puede aplicar recargo |
| Contexto largo | Puede aplicar multiplicador |
| Unidad de facturación | Tokens de entrada |
How much can Decisions API save versus Responses API?
Compara tareas equivalentes en el mismo modelo. La guía de Decisions indica $0.10 por millón de tokens de entrada y sin cargos por salida o caché. La página del modelo Luna indica precios estándar de texto de $0.10/M de entrada sin caché y $0.50/M de salida para uso general del modelo.
Cálculo ilustrativo, no un benchmark: 1,000,000 solicitudes de texto, 500 tokens de entrada facturables sin caché por solicitud en cada endpoint, una clasificación por solicitud y sin recargos regionales o por contexto largo. Para Responses, usa el total de tokens de salida facturados, incluidos los tokens de razonamiento facturados, en lugar de solo la longitud visible de la respuesta.
Con estas suposiciones: Costo de Decisions = N × I × $0.10 / 1,000,000. Costo de Responses = N × (I × $0.10 + O × $0.50) / 1,000,000. Porcentaje de ahorro = (Costo de Responses − Costo de Decisions) / Costo de Responses × 100%, donde N es solicitudes, I tokens de entrada/solicitud y O tokens de salida facturados/solicitud.
| Salida facturada de Responses / solicitud | Costo de Decisions / 1M solicitudes | Costo de Responses / 1M solicitudes | Ahorro estimado |
|---|---|---|---|
| 5 tokens | $50.00 | $52.50 | $2.50 (4.8%) |
| 20 tokens | $50.00 | $60.00 | $10.00 (16.7%) |
| 100 tokens | $50.00 | $100.00 | $50.00 (50.0%) |
Los ahorros anteriores provienen del supuesto de salida facturada en Responses; no son un descuento fijo del endpoint. Recalcula con el uso de entrada medido, aciertos de caché, escrituras de caché, nivel de procesamiento y reintentos. Las entradas en caché o tarifas de Batch/Flex pueden cambiar el resultado. Suma por separado tarifas de herramientas, revisión humana e infraestructura. Compara el costo por decisión correcta aceptada tras verificar calidad y latencia; una etiqueta corta y una explicación más larga son cargas de trabajo distintas.
OpenAI Decisions API vs Responses API vs Jev and Aplomb 1
La tabla se centra en servicios de decisión dedicados. Para explicaciones generadas, esquemas de extracción personalizados o flujos de herramientas, usa la Responses API como se describe en la guía de decisiones de OpenAI. Una decisión puede seleccionar una rama de flujo de trabajo, mientras que Responses genera contenido o solicita la llamada a una herramienta, con el código de la aplicación manejando la ejecución de herramientas personalizadas.
Capabilities and pricing overview
| Dimensión | OpenAI Decisions API | Jev 1.13 | Aplomb 1 |
|---|---|---|---|
| Entradas | Texto e imágenes | Texto; imágenes experimentales con opt-in | Texto, JSON, imágenes, video y audio |
| Precio estándar de entrada / 1M tokens | $0.10 | $0.042 | $0.02 |
| Acceso | API de OpenAI alojada | API de TypeSafe alojada | API alojada; pesos descargables bajo la EmpirioLabs Model License |
| Ajuste para evaluación | Enrutamiento, filtrado y puntuación en flujos de trabajo de OpenAI | Clasificación y enrutamiento de intención | Decisiones multimedia; despliegue que requiere pesos |
Alcance de la selección: Jev y Aplomb se incluyen por sus funcionalidades de decisión publicadas, no como un ranking de popularidad. Las especificaciones y los precios estándar de entrada se verificaron el 16 de octubre de 2026. TypeSafe aún asigna jev-latest a 1.13 y jev-preview a 1.14, por lo que esta comparación fija 1.13. El soporte de imágenes en Jev es experimental. Los pesos de Aplomb tienen restricciones de licencia; revisa los términos para despliegue comercial. Los precios de tokens publicados no son un indicador de calidad ni una estimación del costo total del flujo de trabajo.
Workflow selection
Preselecciona servicios según las entradas requeridas y opciones de despliegue, luego pruébalos en los mismos casos etiquetados. Alinea la preparación de entradas, rúbricas de decisión, mediciones de latencia de extremo a extremo y políticas de revisión humana. Compara la precisión de enrutamiento, casos perdidos, carga de revisión y costo por decisión correcta aceptada. Informa estos resultados juntos para que un precio de token más bajo o una respuesta más rápida no oculten errores adicionales o costos de revisión.
How Can You Use the OpenAI Decisions API?
Step 1: Configure credentials
Crea una clave de API y proporciónala como la variable de entorno OPENAI_API_KEY. Nunca codifiques claves secretas en repositorios o aplicaciones de frontend.
Step 2: Send a request with cURL
La siguiente solicitud sigue el esquema de ejemplo de choice oficial. Configura OPENAI_API_KEY antes de ejecutarla; una respuesta exitosa contiene un arreglo answers. Los comandos de shell usan sintaxis Bash.
Enruta una solicitud de soporte con cURL.
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [
      {
        "type": "choice",
        "name": "department",
        "instructions": "Which department should handle this complaint?",
        "choices": [
          {"value": "billing", "description": "Payments and refunds"},
          {"value": "technical", "description": "Product issues"},
          {"value": "other", "description": "Everything else"}
        ]
      }
    ]
  }'
Step 3: Integrate with Python
Instala el SDK de Python requerido.
pip install --upgrade "openai>=3.26.0"
Solicita e inspecciona una decisión de tipo choice.
from openai import OpenAI

client = OpenAI()
result = client.decisions.create(
    model="gpt-6-luna",
    input="I was charged twice for my order.",
    questions=[{
        "type": "choice",
        "name": "department",
        "instructions": "Which team should handle this request?",
        "choices": [
            {"value": "billing", "description": "Payments and refunds"},
            {"value": "technical", "description": "Product issues"},
            {"value": "other", "description": "Other requests"}
        ]
    }]
)
answer = result.answers[0]
if answer.type == "refusal":
    print("Decision refused")
elif answer.type == "choice":
    print(answer.choice, answer.confidence)
Step 4: Define an escalation rule
Aplica un umbral de enrutamiento ilustrativo.
if answer.type == "choice":
    if answer.choice != "other" and answer.confidence >= 0.90:
        print("Eligible for automatic routing")
    else:
        print("Send to human review")
El umbral 0.90 es ilustrativo, no una garantía del proveedor ni un valor predeterminado oficialmente recomendado. Valídalo con ejemplos reales y el riesgo del negocio.
How Can You Access GPT-6 Luna Through CometAPI?
Los desarrolladores pueden usar la GPT-6 Luna API en CometAPI para tareas de modelo de propósito general. Esto no debe confundirse con soporte para el endpoint dedicado OpenAI Decisions, que requiere verificación de compatibilidad por separado.
Clasifica texto mediante Responses de CometAPI.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)
response = client.responses.create(
    model="gpt-6-luna",
    input=(
        "Classify as billing, technical, or other. "
        "Return only the category. "
        "Request: I was charged twice for my order."
    )
)
print(response.output_text)
Este ejemplo es una clasificación de propósito general mediante la interfaz de modelo compatible con CometAPI; no devuelve la estructura de probabilidad nativa de Decisions API ni hereda su precio solo por entrada.
What Are the Best Use Cases for the OpenAI Decisions API?
Estos son flujos de trabajo de aplicación ilustrativos, no implementaciones reportadas ni resultados de benchmarks. Usan los tipos de preguntas predicado, elección y puntuación de la guía oficial de Decisions. El código de la aplicación realiza las acciones posteriores.
Customer support classification
Proporciona el texto del ticket, el historial de conversación relevante y una lista predefinida de equipos de soporte. Una pregunta de elección puede seleccionar Billing, Technical Support o Account Access; una pregunta de puntuación separada puede evaluar la urgencia contra una rúbrica escrita. El código de la aplicación puede asignar la cola sugerida y enviar casos inciertos o incompletos a un revisor.
Evalúa el flujo de trabajo en tickets etiquetados por el personal de soporte, midiendo la precisión de enrutamiento por categoría, casos urgentes perdidos, tasas de reasignación y carga de revisión. Compara estos resultados con el proceso de enrutamiento existente antes de ampliar el despliegue.
Content moderation and review queues
Proporciona textos o imágenes enviados junto con categorías de revisión claramente definidas. Las preguntas de predicado pueden evaluar si aparecen condiciones particulares en el contenido, mientras que una pregunta de puntuación puede priorizar la revisión según una rúbrica de severidad documentada. La aplicación puede colocar los elementos marcados en la cola adecuada y presentar el contenido relevante a los revisores; el endpoint en sí no elimina contenido ni aplica reglas de plataforma.
Evalúa violaciones perdidas, marcados innecesarios, acuerdo entre revisores y demoras en las colas con ejemplos representativos etiquetados. Ajusta umbrales por separado para categorías con diferentes consecuencias.
E-commerce image inspection
Proporciona fotografías de productos y los criterios de inspección relevantes para el artículo, como grietas visibles, desgarros o empaques dañados. Las preguntas de predicado pueden evaluar si aparece cada condición, y una pregunta de puntuación puede aplicar una rúbrica de severidad definida cuando las imágenes contienen evidencia suficiente. El código de la aplicación puede solicitar otra fotografía o crear una tarea de inspección humana cuando la evidencia no esté clara.
Evalúa la precisión de detección frente a artículos inspeccionados, incluyendo daños no detectados y falsas alarmas en categorías de productos y condiciones de imagen. Mantén las decisiones de reembolso o sustitución en el flujo de aprobación existente del minorista.
AI-agent action gating
Proporciona la acción propuesta, sus argumentos, la solicitud del usuario relevante y las reglas de ejecución escritas de la aplicación. Las preguntas de predicado pueden evaluar si la propuesta coincide con la tarea solicitada o requiere revisión. El código de la aplicación puede usar el resultado para seleccionar una rama predefinida: continuar, solicitar aclaración o escalar. Las comprobaciones de permisos independientes aún deben determinar si la ejecución está autorizada; el juicio del modelo es solo una entrada.
Evalúa la compuerta con propuestas de acción etiquetadas, midiendo acciones no autorizadas perdidas, escalaciones innecesarias y sensibilidad a contexto incompleto o conflictivo antes de conectarla a la ejecución.
Document and email triage
Proporciona el texto del documento o correo electrónico, metadatos relevantes y un conjunto fijo de categorías como invoice, support request, meeting request u otras. Una pregunta de elección puede seleccionar la categoría, mientras que las preguntas de predicado pueden identificar condiciones como información requerida faltante. El código de la aplicación puede enviar el elemento al flujo de extracción, recuperación o revisión apropiado sin pedir al endpoint de decisión que realice esos pasos posteriores.
Evalúa la precisión por categoría, el enrutamiento incorrecto posterior, el volumen de revisión y el tiempo de procesamiento usando registros representativos etiquetados, incluyendo elementos ambiguos y formatos no familiares.
What Are the OpenAI Decisions API’s Limitations?
La API no genera contenido explicativo arbitrario, no ejecuta herramientas directamente ni elimina la necesidad de probar predicciones. Las categorías faltantes y las rúbricas de decisión mal redactadas pueden producir resultados inadecuados. Los valores de confianza pueden estar descalibrados; la automatización de alto riesgo aún necesita salvaguardas, revisión humana y lógica de autorización.
Conclusion
La Decisions API es prometedora para juicios acotados de alto volumen porque combina salidas tipadas de probabilidad con un modelo de precios de tokens simplificado. Los equipos deben compararla con Structured Outputs y modelos de decisión alternativos usando los mismos casos etiquetados, mediciones de latencia y costos completos del flujo de trabajo. La oportunidad central es identificar pasos en una aplicación de IA que necesitan una elección en lugar de prosa generada.
FAQs
How should OpenAI Decisions API refusals be handled?
Trata una negativa como un resultado de flujo de trabajo independiente. Verifica answer.type antes de leer campos de choice, score o probability. Registra el nombre de la pregunta y enruta la solicitud a una ruta de revisión o recuperación; nunca interpretes una negativa como un predicado negativo o una puntuación cero.
How can Decisions API thresholds be maintained over time?
Elige umbrales con ejemplos etiquetados de reserva, luego monitorea la precisión entre las decisiones aceptadas y la proporción enviada a revisión. Reevalúa después de cambiar categorías, instrucciones, fuentes de entrada o el comportamiento del modelo. Mantén una rúbrica versionada para que los cambios de enrutamiento puedan vincularse con la configuración que los produjo.
How should OpenAI Decisions API latency tests be reported?
Registra fecha, región, identificador del modelo, cantidad de preguntas, longitud del texto, tamaño de imagen, concurrencia, versión del cliente, política de reintentos y configuración del endpoint de comparación. Informa p50 y p95 de extremo a extremo con recuentos de muestra y resultados de calidad, de modo que una ganancia de velocidad no se logre simplemente aceptando más errores.
How should Decisions API categories evolve without breaking integrations?
Usa valores estables legibles por máquina y mantén un mapeo explícito a las colas posteriores. Agrega una categoría de respaldo y prueba casos límite históricos antes de desplegar nuevas descripciones. Si se renombra una categoría, actualiza el mapa de enrutamiento y la rúbrica juntos en lugar de permitir que valores desconocidos alcancen acciones en producción.
What should be logged for a Decisions API routing audit?
Registra la versión de la rúbrica, la categoría seleccionada, las probabilidades o la confianza relevantes, el umbral, el identificador del modelo, la marca de tiempo y la acción realizada. Limita el contenido de entrada almacenado a lo que el flujo de trabajo requiere y aplica la política de retención de la organización. Un registro de auditoría debe mostrar por qué la lógica de la aplicación enrutó o escaló el caso.