
TL;DR
Claude Haiku 5.5 et GPT-6 Luna sont des modèles de raisonnement à faible coût pour des charges API à grand volume. Tous deux démarrent à 0,10 $ par million de jetons d'entrée et 0,50 $ par million de jetons de sortie. Haiku obtient un score plus élevé sur les six comparaisons publiées dans les documents de lancement d'Anthropic. Luna conserve ses tarifs de base pour les invites jusqu'à 272K jetons d'entrée, contre 100K pour Haiku. Pour les développeurs, les mesures clés sont le taux d'acceptation, la latence de bout en bout, la compatibilité API et le coût par résultat accepté—le coût total de toutes les tentatives divisé par le nombre de sorties qui passent des contrôles prédéfinis.
Principaux enseignements
- Haiku 5.5 est en tête de la comparaison OSWorld 2.1 sur l'usage de l’ordinateur, 72,4 % contre 48,9 % pour Luna.
- Sur Terminal-Bench 4.0, les résultats cités sont 39,2 % pour Haiku et 16,4 % pour Luna.
- Tous deux démarrent avec des prix identiques en contexte court, mais le palier de prix supérieur de Haiku commence au-delà de 100K jetons d'invite, contre un seuil de 272K pour Luna.
- Les pages « max-effort » d’Artificial Analysis, vérifiées le 9 octobre 2026, indiquent des vitesses de sortie de 240,6 jetons/s pour Haiku et 123,0 jetons/s pour Luna ; le débit exclut le temps d’attente du premier jeton.
- Commencez par Haiku pour les tâches d’usage de l’ordinateur et de terminal reflétées dans les benchmarks partagés ; envisagez Luna pour les grandes invites. Conservez votre modèle actuel jusqu’à ce qu’un pilote représentatif démontre une amélioration utile.
Qu’est-ce que Claude Haiku 5.5 et GPT-6 Luna ?
Claude Haiku 5.5 : aperçu
Claude Haiku 5.5 a été lancé le 7 octobre 2026. Il combine inférence à bas prix, raisonnement ajustable, utilisation d’outils, long contexte et entrées texte et image. Les applications typiques incluent l’extraction de documents, les requêtes de base de données, le support client et des sous-agents légers.
GPT-6 Luna : aperçu
GPT-6 Luna a été lancé le 22 septembre 2026. Il est positionné pour des tâches ciblées à grande échelle, notamment la classification, l’extraction d’information, la sortie structurée, l’assistance à la programmation et le traitement de longs documents. Ses paramètres de raisonnement flexibles incluent une configuration sans raisonnement pour les travaux plus simples.
Spécifications
| Specification | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Developer | Anthropic | OpenAI |
| Release | October 7, 2026 | September 22, 2026 |
| Model ID | claude-haiku-5-5 | gpt-6-luna |
| Context window | 1,000,000 tokens | 1,050,000 tokens |
| Maximum output (standard API) | 128,000 tokens | 128,000 tokens |
| Input | Text and image | Text and image |
| Output | Text | Text |
| Reasoning | Adjustable, Low to Max | None to Max |
| Default effort | Medium | Medium |
| Knowledge cutoff | June 2026 | May 18, 2026 |
| Tool use | Yes | Yes |
| Structured output | Yes | Yes |
| Open weights | No | No |
| Architecture and parameter count | Not specified in the cited official materials | Not specified in the cited official materials |
Les spécifications utilisent la documentation des modèles API standard des fournisseurs, vérifiée le 9 octobre 2026 : Spécifications API standard de Haiku et Spécifications API standard de Luna. L’architecture et le nombre de paramètres ne sont pas précisés car ces sources ne les établissent pas.
Claude Haiku 5.5 vs GPT-6 Luna : résultats de benchmarks
| Benchmark | Haiku 5.5 | GPT-6 Luna | Leader |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1,620 | 1,437 | Haiku +183 |
| AA-Briefcase v1.1 (Elo) | 1,578 | 1,336 | Haiku +242 |
| OSWorld 2.1, offline partial score | 72.4% | 48.9% | Haiku +23.5 pp |
| Terminal-Bench 4.0 | 39.2% | 16.4% | Haiku +22.8 pp |
| FrontierCode 1.1 Main | 46.4% | 42.4% | Haiku +4.0 pp |
| Chartography, no tools | 46.4% | 29.1% | Haiku +17.3 pp |
Les six lignes ci-dessus reproduisent les résultats de comparaison publiés par Anthropic lors du lancement, vérifiés le 9 octobre 2026. Ce sont des comparaisons publiées par Anthropic, incluant des résultats indépendants reproduits, plutôt que de nouveaux tests effectués pour cet article. GDPval-AA et AA-Briefcase sont des scores Elo ; les écarts en pourcentage sont des points de pourcentage. Ces familles de benchmarks mesurent des tâches différentes et ne doivent pas être moyennées pour en tirer un vainqueur universel.
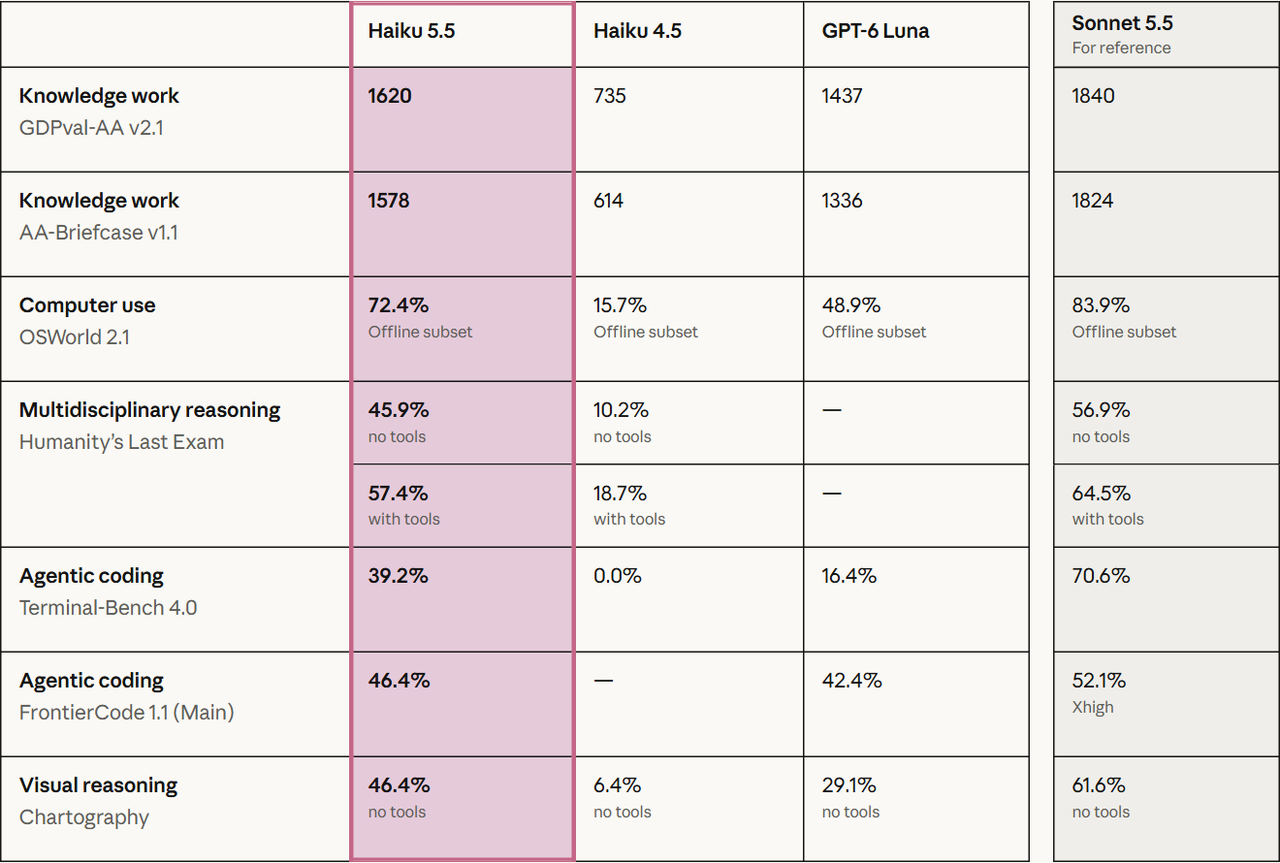
Les résultats relatifs les plus forts de Haiku dans ce tableau de lancement apparaissent dans l’interaction visuelle avec l’ordinateur et les tâches basées sur le terminal. Son avance plus faible sur FrontierCode met en garde contre l’extrapolation d’un écart de 20 points à toutes les situations de codage. Utilisez ces résultats pour sélectionner des candidats pilotes, puis validez vos invites et votre pile d’outils.
Effort de raisonnement et limites d’évaluation
L’effort de raisonnement modifie le compromis précision–coût. Comparez les réglages disponibles en utilisant la même charge de travail et le même banc d’essai ; des noms de réglages identiques chez les fournisseurs ne garantissent pas des budgets de jetons de raisonnement égaux. Le tableau de lancement rapporte le sous-ensemble hors ligne d’OSWorld et Chartography sans outils. Le harnais, la sélection des tâches, les reprises et l’accès aux outils peuvent changer les résultats. La system card d’Anthropic documente les conditions spécifiques aux benchmarks. Lire les méthodes de benchmark dans la system card d’Anthropic.
- OSWorld utilise le sous-ensemble hors ligne de 82 tâches, une machine virtuelle Ubuntu, des captures 1080p, une limite de 500 actions, un effort max et cinq tentatives par tâche. La comparaison 72,4 %/48,9 % est un score à crédit partiel, pas le pourcentage de tâches terminées parfaitement ; le taux de réussite strict de Haiku est de 37,1 %. Anthropic a exécuté Luna sur le même sous-ensemble via l’API d’OpenAI.
- Terminal-Bench utilise 66 tâches conteneurisées ; Haiku a été exécuté à effort maximum dans Claude Code en mode bare, sans sortie Internet ni modèle de secours, avec une moyenne de dix essais par tâche.
- FrontierCode Main contient 100 tâches avec cinq exécutions par tâche ; les modèles Claude utilisaient Claude Code et les modèles GPT utilisaient Codex.
- GDPval-AA et AA-Briefcase ont été évalués indépendamment par Artificial Analysis et reproduits dans les supports de lancement. Il s’agit de pipelines d’évaluation distincts, pas d’un harnais de production partagé.
Claude Haiku 5.5 vs GPT-6 Luna : comparaison des fonctionnalités
Utilisation de l’ordinateur et codage agentique
L’avantage le plus fort de Haiku réside dans les tâches communes au lancement qui nécessitent une interaction avec un ordinateur graphique ou un travail en terminal. L’écart de score partiel sur OSWorld est de 23,5 points, tandis que Terminal-Bench diffère de 22,8 points. La plus faible différence de 4,0 points sur FrontierCode montre pourquoi la catégorie plus large du codage ne doit pas être traitée comme une seule charge de travail.
Pour l’automatisation de navigateur, testez la navigation, la saisie de formulaires, la récupération après échec d’outils et l’achèvement de bout en bout. Pour le codage, testez si un correctif passe les contrôles fonctionnels de votre dépôt et reste dans le périmètre. Ces contrôles d’acceptation sont plus utiles que de choisir un modèle sur la base du plus grand écart mis en avant.
Long contexte et traitement de documents
La différence de 5 % en capacité nominale de contexte est moins significative que la fiabilité et le prix du traitement d’invites substantielles. Aucun modèle n’est intrinsèquement supérieur pour la récupération d’information simplement parce que sa fenêtre de contexte est plus grande.
La différence clé est le moment où s’appliquent des tarifs plus élevés : une invite de 150K jetons franchit le seuil de Haiku tout en restant dans le palier de base de Luna. Luna est donc le point de départ moins coûteux pour cette charge de jetons. Le fait qu’il soit le meilleur analyste de documents dépend toujours de la précision d’extraction, des citations et du nombre de reprises nécessaires pour obtenir une réponse acceptable.
Contrôles de raisonnement
Les deux modèles exposent un effort de raisonnement ajustable, avec un réglage moyen par défaut dans la documentation citée. Luna expose également un réglage none. Utilisez ces contrôles pour adapter la tâche : l’extraction et le routage peuvent requérir moins de raisonnement qu’un flux d’outils multi-étapes incertain. La même étiquette d’effort n’implique pas le même budget de calcul entre fournisseurs.
Entrées multimodales et flux structurés
Tous deux acceptent du texte et des images et produisent du texte. Cela en fait des candidats pour des captures d’écran, l’extraction d’images de documents et des flux en aval structurés. Leur seul support d’entrée n’établit pas une précision égale sur du petit texte, des graphiques ou des interfaces visuelles ; mesurez ces cas séparément.
Vitesse et économie des tâches
| Independent metric (max effort) | Haiku 5.5 — Artificial Analysis | GPT-6 Luna — Artificial Analysis |
|---|---|---|
| Intelligence Index v4.3.2 | 43 | 38 |
| Output speed | 240.6 tokens/s | 123.0 tokens/s |
| Weighted cost per Intelligence Index task | $0.21 | $0.07 |
Artificial Analysis est l’éditeur de tests indépendant. Le tableau est un instantané des pages de modèles à effort maximum, vérifié le 9 octobre 2026, plutôt qu’une performance officielle du fournisseur. La vitesse de sortie mesure les jetons reçus après le début de la génération ; elle est distincte du temps jusqu’au premier jeton et de la latence complète de la tâche. Le coût par tâche est un indicateur pondéré de l’Intelligence Index, pas un devis pour votre tâche de production ni un coût par résultat réussi.
Le débit instantané de sortie de Haiku est environ 1,96 fois celui de Luna, tandis que le coût pondéré par tâche d’évaluation de Luna est inférieur. Cela n’établit pas un avantage de 1,96 en temps d’achèvement de la tâche complète. Les tests en production doivent enregistrer séparément le temps jusqu’au premier jeton, le temps d’achèvement, la longueur de sortie, la consommation de raisonnement et le temps d’exécution des outils.
Claude Haiku 5.5 vs GPT-6 Luna : tarification et accès API
Tarifs standard officiels
| USD per 1M tokens | Haiku ≤100K | Haiku >100K | Luna ≤272K | Luna >272K |
|---|---|---|---|---|
| Input | $0.10 | $0.50 | $0.10 | $0.20 |
| Cached read | $0.01 | $0.05 | $0.01 | $0.02 |
| Cache write (Haiku: 5-minute TTL) | $0.125 | $0.625 | $0.125 | $0.25 |
| Output | $0.50 | $2.50 | $0.50 | $0.75 |
USD par million de jetons aux tarifs de traitement standard, vérifiés le 9 octobre 2026. Le tableau utilise les tarifs standard et d’écriture de cache 5 minutes de Haiku et les tarifs court et long contexte de Luna. Les frais d’outils, taxes, majorations régionales et ajustements optionnels de palier de traitement sont exclus. Au-delà du seuil d’entrée, les tarifs plus élevés applicables couvrent la requête plutôt que les seuls jetons excédentaires.
La distinction centrale est le seuil de facturation. Haiku passe à des tarifs plus élevés au-delà de 100K jetons d’invite, tandis que Luna conserve son palier bas jusqu’à 272K. Même au-dessus de ce seuil, les prix cités de Luna pour l’entrée et la sortie en long contexte sont plus bas.
Haiku propose également des écritures de cache d’1 heure à 0,20/1,00 $ par million de jetons pour les invites courtes/longues. Les mécanismes de persistance et de tarification du cache diffèrent entre fournisseurs ; comparez donc les schémas de réutilisation plutôt que de considérer que les deux lignes « écriture de cache » correspondent à des produits identiques. La limite de sortie de 128K de Haiku est la limite API standard ; son API Message Batches peut prendre en charge 300K de sortie avec un en-tête bêta.
Coûts illustratifs pour des budgets de jetons fixes
| Workload | Input / Output | Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| Ticket classification | 2K / 200 | $0.0003 | $0.0003 |
| Short report | 40K / 4K | $0.006 | $0.006 |
| Repository analysis | 150K / 5K | $0.0875 | $0.0175 |
| Large document review | 300K / 10K | $0.175 | $0.0675 |
| Massive context analysis | 800K / 20K | $0.45 | $0.175 |
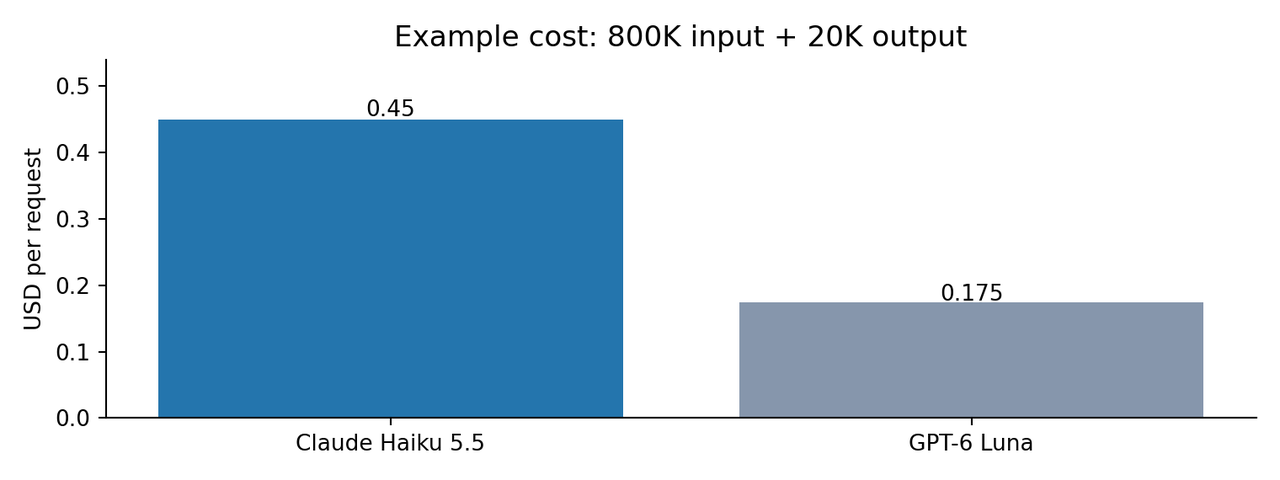
Estimation non mise en cache au tarif standard calculée par l’auteur : coût = jetons d’entrée × tarif d’entrée / 1,000,000 + jetons de sortie facturés × tarif de sortie / 1,000,000. « Output » signifie la sortie totale facturée pour cette estimation, incluant les jetons de raisonnement lorsque facturés en sortie ; il ne s’agit pas nécessairement de la longueur de la réponse visible. Les mêmes décomptes de jetons rapportés sont utilisés pour les deux modèles, bien que les tokenizer puissent différer.
Un jeton bon marché n’équivaut pas nécessairement à un résultat réussi bon marché. Les équipes doivent tenir compte des tentatives répétées, des appels d’outils échoués, de la consommation de jetons de raisonnement et des différences de tokenizer.
Accès CometAPI et contraintes d’intégration
CometAPI propose des options d’accès pour les deux modèles. Avant de les comparer ou de les déployer via la passerelle, vérifiez les IDs de modèle, les endpoints pris en charge, les paramètres de requête, le comportement des outils et les règles de facturation pour chaque route. Ces liens fournisseurs documentent des options d’accès ; ils ne remplacent pas les sources techniques ou de tarification standard des vendeurs.
Pour des intégrations OpenAI directes, Luna prend en charge des outils intégrés via l’API Responses ; l’appel de fonctions Chat Completions nécessite un effort de raisonnement none. Haiku utilise l’API Messages d’Anthropic et la réflexion adaptative. Une passerelle ne rend pas interchangeables les schémas sous-jacents : validez les définitions d’outils, le comportement de sortie structurée, les événements de streaming et la comptabilité avec la route exacte que vous avez l’intention d’utiliser.
Comment les développeurs peuvent-ils comparer Claude Haiku 5.5 et GPT-6 Luna avec la même invite ?
Exemple d’extraction de long document
Une comparaison pratique peut utiliser un lot de contrats fournisseurs contenant des dates d’effet, des termes de renouvellement, des délais de préavis et des exceptions. Gardez le lot de documents, les instructions d’extraction, les champs attendus et les règles de validation identiques. Ce qui suit est une conception d’évaluation, pas un nouveau résultat mesuré de modèle.
Invite d’exemple : Extraire pour chaque contrat le nom du fournisseur, la date d’effet, la date de renouvellement, le délai de préavis de résiliation et les exceptions de tarification. Pour chaque valeur extraite, citer le titre du document et l’extrait exact justificatif. Retourner null lorsqu’un champ est absent ; ne pas inférer de dates manquantes. Signaler les clauses contradictoires et maintenir la réponse finale dans la limite de 1,000 mots.
| Check | Acceptance criterion | What to record |
|---|---|---|
| Extraction accuracy | Required fields match an independently checked answer key | Correct, incorrect, and missing values |
| Grounding | Every non-null field has a valid supporting passage | Unsupported claims and wrong document citations |
| Instruction following | No invented dates; absent fields return null | Schema failures and constraint violations |
| Economics | Calculate spend per accepted extraction | Billed input, output, reasoning, retries, and fallback cost |
| Latency | Compare full job completion under the same tool policy | First-token time and end-to-end time |
Exécutez plus d’un lot représentatif et répétez les cas où les résultats varient. Commencez avec le même niveau d’effort disponible, puis testez une configuration moins coûteuse pour chaque modèle. Indiquez la taille de l’échantillon, les réglages, la route, la date et le nombre d’échecs avant de présenter un gagnant.
Haiku 5.5 ou GPT-6 Luna : lequel choisir ?
| Dimension | Better-supported starting point | Decision boundary |
|---|---|---|
| GUI interaction | Claude Haiku 5.5 | Shared OSWorld partial scores favor Haiku; verify full task completion |
| Terminal coding | Claude Haiku 5.5 | Shared Terminal-Bench scores favor Haiku; validate repository changes |
| Short prompts and base prices | Test both | Identical base rates; compare billed usage and retries |
| Prompts above 100K tokens | GPT-6 Luna on standard rates | Luna retains the base tier longer; accuracy may alter total cost |
| Streamed token throughput | Claude Haiku 5.5 in the dated snapshot | Throughput differs from full completion latency |
| Simple repeated extraction | Test Luna with low or no reasoning | Select by valid accepted output, rather than price alone |
Choisir Claude Haiku 5.5 pour des tâches interactives pertinentes aux benchmarks
Commencez avec Haiku lorsque votre application ressemble aux tâches publiées d’ordinateur graphique, de codage en terminal ou de travail professionnel, et qu’un taux d’achèvement plus élevé compenserait une dépense supplémentaire de raisonnement ou de long contexte. Confirmez cet avantage sur votre propre pile d’outils avant d’acheminer du trafic de production.
Choisir GPT-6 Luna pour le contrôle des coûts sur grandes invites
Commencez avec Luna lorsque les invites dépassent fréquemment 100K jetons et que les coûts standard par jeton affectent matériellement votre budget. C’est également un candidat pour les extractions répétées ou le routage pouvant réussir avec peu ou sans raisonnement. Maintenez la recommandation conditionnelle aux taux de résultats acceptés et à l’usage effectivement facturé.
Utiliser les deux lorsque les charges ont des besoins différents
Un pilote pourrait router l’extraction de longs documents vers Luna et les tâches GUI ou terminal vers Haiku, puis valider chaque choix contre des contrôles d’acceptation. Déclenchez un secours lorsqu’une sortie échoue la validation de schéma, manque de preuves requises ou échoue un contrôle spécifique à la tâche, et incluez les coûts et la latence de secours dans la comparaison.
Valider avant de changer
Incluez votre modèle actuel comme référence. Ne migrez que lorsque le candidat atteint un objectif de correction prédéfini et améliore le coût par résultat accepté ou la latence de bout en bout suffisamment pour couvrir la migration et la maintenance. Suspendez le déploiement si les erreurs critiques d’outils augmentent. La recommandation change si votre pilote montre que le tarif inférieur de Luna est compensé par des reprises, ou que les scores de benchmark supérieurs de Haiku n’améliorent pas le succès de votre tâche.
- Utilisez un échantillon de charge représentatif et comptabilisez les résultats corrects, incorrects et incomplets.
- Mesurez la latence du premier jeton, le temps de tâche de bout en bout et la fiabilité des outils.
- Suivez séparément les jetons d’entrée, en cache, de sortie et de raisonnement.
- Calculez le coût par résultat réussi, y compris reprises et secours.
- Comparez l’effort moyen et élevé avant d’activer par défaut des réglages maximum.
Conclusion
Claude Haiku 5.5 présente des preuves de lancement plus solides en face-à-face sur les benchmarks de travail professionnel, d’usage de l’ordinateur et de codage agentique comparés ici. Il a également un débit de sortie plus élevé dans l’instantané indépendant. GPT-6 Luna a un avantage clair en tarif standard pour les invites au-dessus du seuil 100K de Haiku et un coût pondéré par tâche d’évaluation plus faible. Aucune de ces observations ne détermine à elle seule la fiabilité en production ou le coût par résultat réussi.
Le gagnant pratique est le modèle qui fournit un résultat acceptable au coût opérationnel totalement mesuré le plus bas. Faites tourner les deux sur vos propres invites, outils et règles de reprise plutôt que de traiter un seul benchmark comme la réponse.
FAQ
Pourquoi les coûts de tâche peuvent-ils différer alors que les deux modèles ont les mêmes prix de base par jeton ?
Le même prix de base ne signifie pas la même facture totale. Les modèles peuvent utiliser des quantités différentes de jetons d’entrée, de sortie et de raisonnement, et peuvent nécessiter des nombres différents de reprises ou d’appels d’outils pour produire un résultat acceptable. Les tarifs long contexte et l’usage du cache affectent également le total. Comparez le coût total de toutes les tentatives divisé par le nombre de résultats acceptés, plutôt que les seuls prix des jetons.
Les tarifs plus élevés en long contexte s’appliquent-ils uniquement aux jetons au-dessus du seuil ?
Non. Selon la tarification standard décrite dans cet article, franchir le seuil d’entrée applique les tarifs plus élevés à la requête, pas seulement aux jetons excédentaires. Par exemple, une requête de 150K jetons d’entrée franchit le seuil 100K de Haiku mais reste dans le palier de base de Luna à 272K. Utilisez les tarifs d’entrée et de sortie applicables à l’ensemble de la requête pour estimer le coût.
Claude Haiku 5.5 et GPT-6 Luna peuvent-ils partager un cache d’invite ?
N’assumez pas que des entrées de cache se transfèrent entre modèles ou fournisseurs. Concevez des stratégies de réutilisation distinctes, puis mesurez les taux de hit et la facturation sur chaque route. La prise en charge par la passerelle, les règles de rétention et la structure des requêtes peuvent affecter l’éligibilité des entrées répétées au cache ; vérifiez-les avant d’anticiper des économies.
Que doit couvrir un test de migration de Haiku vers Luna ?
Testez des entrées texte et image représentatives, les champs structurés requis, les arguments d’outils, les réponses en streaming et la récupération d’erreurs. Établissez le taux d’acceptation de votre système actuel avant la migration, puis comparez les deux candidats sous la même politique de reprise et d’outils. Des prix de jetons ou des catégories de modèles similaires n’établissent pas la compatibilité.
Les scores de benchmark doivent-ils déclencher un secours Haiku ou Luna ?
Utilisez les scores pour choisir des candidats, puis déclenchez des secours sur des échecs observés tels que des arguments d’outils invalides, des champs requis manquants ou des contrôles de tâche non satisfaits. Suivez la fréquence des secours et le coût total facturé. Un second modèle peut ajouter de la latence et des dépenses ; vérifiez donc qu’il améliore les résultats acceptés plutôt que de simplement produire une seconde réponse.
Des données sensibles peuvent-elles être acheminées via les deux API ?
Examinez précisément les fournisseurs et la passerelle impliqués, leurs réglages actuels de rétention, lieux de traitement, conditions contractuelles et la politique de votre organisation en matière de données avant d’acheminer des entrées sensibles. Les capacités des modèles et les tableaux de tarification n’établissent pas l’éligibilité d’une route pour des données réglementées ou confidentielles. Utilisez la route approuvée lorsque ces exigences sont déterminantes.