
TL;DR
Anthropic indique Claude Sonnet 5.5 à 2 $/M de tokens d’entrée et 10 $/M de tokens de sortie. CometAPI affiche des tarifs tiers distincts de 1,60 $/M en entrée et 8 $/M en sortie. Sonnet 5.5 conserve les mêmes tarifs standard d’entrée et de sortie que Sonnet 5, mais son tarif de lecture du cache est inférieur. Le coût par tâche acceptée dépend également des hits de cache, de l’utilisation de tokens, des appels d’outils et des réessais.
Prévoyez un budget pour les écritures et lectures de cache, les tokens de sortie facturés, y compris d’éventuels tokens de raisonnement facturés, l’usage des outils, les réessais, ainsi que la relecture ou correction humaine. L’amélioration de coût par tâche mise en avant dépend de la charge de travail ; ce n’est pas une remise universelle applicable à chaque requête.
Points clés
- Claude Sonnet 5.5 coûte 2 $/M en entrée et 10 $/M en sortie sur l’API Claude ; les tarifs CometAPI commencent à 1,60 $/M en entrée et 8 $/M en sortie.
- Les lectures de cache coûtent 0,10 $/M ; les écritures coûtent 2,50 $/M pour cinq minutes ou 4 $/M pour une heure. Les économies dépendent des hits de cache réels et du calendrier de réutilisation.
- L’API Claude Batch réduit les tarifs d’entrée et de sortie de 50 % ; confirmez la disponibilité et la facturation combinée du cache sur l’itinéraire que vous utilisez.
- Sonnet 5.5 conserve les tarifs standard d’entrée et de sortie de Sonnet 5, avec un tarif de lecture du cache plus bas. Le coût par tâche acceptée dépend de l’usage de tokens, des réessais, des outils et de la qualité des complétions.
- La fenêtre de contexte de 1 M de tokens et la limite standard de sortie à 128 K prennent en charge de grandes tâches ; 300 K de sortie est une option bêta de l’API Batch, pas la limite standard.
Combien coûte Claude Sonnet 5.5 en un coup d’œil ?
Les tarifs officiels des tokens Sonnet 5.5 ci-dessous sont en USD par million de tokens. Les écritures de cache, lectures et entrées ordinaires sont des catégories de facturation distinctes. Batch est une option de traitement asynchrone et ne doit pas être considérée comme disponible via chaque passerelle.
| Mode de l’API Claude | Entrée / 1M | Sortie / 1M | Traitement du cache |
|---|---|---|---|
| Standard | 2,00 $ | 10,00 $ | Lecture 0,10 $ ; écriture 5m 2,50 $ ; écriture 1h 4,00 $ |
| Batch | 1,00 $ | 5,00 $ | Confirmez la facturation combinée Batch et cache |
Sonnet 5.5 dispose d’une fenêtre de contexte de 1 M de tokens. Confirmez le fournisseur sélectionné, la géographie de routage, les tarifs actifs et la facturation du cache avant de budgéter. La capacité de contexte est une limite du modèle, pas une raison d’appliquer le seuil de tarification ou les paliers d’un autre modèle.
Combien coûte Claude Sonnet 5.5 via CometAPI ?
L’API Claude Sonnet 5.5 dans CometAPI affiche des tarifs d’entrée et de sortie 20 % inférieurs aux tarifs correspondants de l’API Claude. Tarifs vérifiés au 1er octobre 2026 ; les estimations de tokens excluent les outils, réessais et autres frais.
| Tarif ou charge de travail | API Claude | CometAPI | Différence |
|---|---|---|---|
| Entrée / 1M | 2,00 $ | 1,60 $ | 20 % inférieur |
| Sortie / 1M | 10,00 $ | 8,00 $ | 20 % inférieur |
| 10K entrée + 2K sortie | 0,040 $ | 0,032 $ | 0,008 $ par requête |
| 100K entrée + 10K sortie | 0,300 $ | 0,240 $ | 0,060 $ par requête |
À 100 000 requêtes équivalentes de 10 K en entrée et 2 K en sortie, les estimations simplifiées de tokens sont de 4 000 $ et 3 200 $, soit une différence de 800 $. À 10 000 requêtes équivalentes de 100 K en entrée et 10 K en sortie, elles sont de 3 000 $ et 2 400 $, soit une différence de 600 $. L’usage du cache, la variation de sortie et les réessais modifient ces totaux.
Coûts au-delà des tokens du modèle
Un agent de codage ou de recherche consomme aussi des ressources de retrieval, de navigation, de stockage, d’hébergement d’applications et d’exécution. Les résultats d’outils peuvent agrandir la prochaine invite même si l’action externe elle-même est peu coûteuse. Confirmez les prix des outils hébergés auprès du fournisseur qui exécute effectivement l’outil ; des remises sur les tokens du modèle ne réduisent pas automatiquement des services distincts.
Effort de raisonnement et dépense totale
L’effort n’est pas un multiplicateur séparé dans ce tableau de tarifs. Il peut affecter le nombre de tokens de sortie facturés, les itérations d’outils et les réessais. Comparez les réglages d’effort sur le même ensemble de tâches et rapportez la qualité de complétion en parallèle du coût total.
Quel est le coût de Claude Sonnet 5.5 sur des charges réalistes ?
Ces exemples contrôlés utilisent des entrées non mises en cache et des sorties facturées aux tarifs standard, en excluant les outils et les réessais. L’entrée plus la sortie réservée doivent tenir dans les limites de contexte actives.
| Charge de travail | Entrée | Sortie | Estimation API Claude | Estimation CometAPI |
|---|---|---|---|---|
| Petite demande de code | 10K | 2K | 0,040 $ | 0,032 $ |
| Analyse de document | 100K | 10K | 0,300 $ | 0,240 $ |
| Long tour d’agent | 300K | 20K | 0,800 $ | 0,640 $ |
| Tâche sur dépôt | 800K | 40K | 2,000 $ | 1,600 $ |
Pour l’exemple 300 K d’entrée et 20 K de sortie, le coût via l’API Claude est (300,000 / 1,000,000 × 2 $) + (20,000 / 1,000,000 × 10 $) = 0,80 $. À 1,60 $/M en entrée et 8 $/M en sortie, le calcul correspondant via CometAPI est de 0,64 $. Les deux estimations supposent une entrée ordinaire non mise en cache et une sortie standard facturée, en excluant les outils et les réessais.
Un agent multi-tours peut renvoyer l’historique accumulé à plusieurs reprises. Estimez la somme de toutes les requêtes, y compris les exécutions infructueuses, plutôt que de ne chiffrer que la réponse finale. Le coût par tâche acceptée correspond aux dépenses totales mesurées de la charge de travail divisées par les tâches acceptées ; le temps de relecture humaine peut être rapporté séparément.
Qu’est-ce qui rend Claude Sonnet 5.5 plus rentable ?
Génération de sortie plus rapide. Anthropic indique que Sonnet 5.5 génère des sorties 30 % et plus rapidement que Sonnet 5. Une génération plus rapide ne réduit pas directement la facturation par token, mais peut améliorer le débit et réduire la durée des boucles d’agents interactives.
Moins de tokens par tâche réalisée. La plus grande économie potentielle survient lorsque le modèle atteint le même résultat avec moins de tokens de raisonnement, d’outils et de sortie finale.
Moins d’étapes d’agent. Des appels d’outils répétés peuvent multiplier le contexte car l’historique de conversation et les sorties d’outils sont souvent renvoyés au modèle. Réduire une itération d’outil inutile peut donc éliminer plus qu’un seul coût de génération isolé.
Effort adaptatif. Sonnet 5.5 prend en charge une réflexion adaptative et adopte par défaut un effort élevé sur la plateforme Claude. Des réglages d’effort plus bas peuvent échanger une partie de la profondeur de raisonnement contre des réponses plus courtes, plus rapides et moins coûteuses lorsque la charge de travail ne nécessite pas une délibération maximale.
La cible d’optimisation importante n’est donc pas le minimum de tokens à tout prix, mais le coût le plus faible par résultat accepté.
Qu’est-ce que Claude Sonnet 5.5 ?
Claude Sonnet 5.5 est un modèle Anthropic sorti le 28 septembre 2026. Sa fenêtre de contexte de 1 M de tokens et ses entrées texte et image prennent en charge le codage, les agents et l’analyse de documents avec sortie texte. L’API Claude adopte par défaut un effort élevé ; choisissez l’effort en fonction de la qualité et du coût mesurés pour votre charge de travail.
| Spécification | Claude Sonnet 5.5 |
|---|---|
| Fournisseur | Anthropic |
| ID du modèle Claude API | claude-sonnet-5-5 |
| Date de sortie | 28 septembre 2026 |
| Fenêtre de contexte | 1 M tokens |
| Sortie maximale | 128 K tokens |
| Sortie max Batch API | 300 K tokens, bêta |
| Entrée | Texte, images |
| Sortie | Texte |
| Raisonnement | Adaptatif |
| Effort par défaut de l’API | Élevé |
| Date limite de connaissances fiable | juin 2026 |
| Prix officiel d’entrée | 2 $/M tokens |
| Prix officiel de sortie | 10 $/M tokens |
| Lecture du cache | 0,20 $/M tokens |
| Écriture cache 5 minutes | 2,50 $/M tokens |
| Écriture cache 1 heure | 4 $/M tokens |
| Batch API | Remise de 50 % |
Quelle performance achetez-vous avec Claude Sonnet 5.5 ?
La méthodologie d’évaluation officielle distingue les paramètres de test. Sauf indication contraire, le résumé utilise une réflexion adaptative, un effort Max, l’échantillonnage par défaut et cinq essais ; les configurations des modèles historiques peuvent différer. Cette comparaison centrée sur le prix retient trois benchmarks de code et d’agents : Terminal-Bench, FrontierCode et CursorBench. Les cinq lignes barrées ci-dessous sont supprimées de l’article révisé et conservées ici uniquement pour examen.
| Benchmark / métrique | Claude Sonnet 5.5 | Claude Sonnet 5 | Claude Opus 5.5 | Paramètre d’évaluation |
|---|---|---|---|---|
| Terminal-Bench 4.0 / succès | 70,6 % Max | 10,3 % | 66,4 % Xhigh | 66 tâches terminal en conteneur ; Sonnet utilise Claude Code --bare, sans sortie Internet, garde-fous activés |
| FrontierCode 1.1 Main / score | 46,2 % Max | 42,4 % | 54,4 % | Patches de dépôts en conteneurs avec accès Internet ; tests retenus et notation par grille |
| CursorBench 4.0 / score | 55,5 % Max | 34,1 % | 57,8 % | Tâches de code réelles dans le harnais d’agent de production de Cursor ; mesuré indépendamment par Cursor |
Ces trois benchmarks couvrent des tâches d’agents terminal, du patching de dépôts et du codage dans un harnais d’agent de production. Leurs scores décrivent des configurations d’évaluation différentes, plutôt qu’une comparaison à effort égal ou un avantage de coût mesuré. Pour évaluer le rapport qualité-prix, rejouez des tâches représentatives et comparez la dépense totale par résultat accepté, y compris l’usage du cache, les outils et les réessais.
Comment la mise en cache des prompts modifie-t-elle les coûts d’entrée de Claude Sonnet 5.5 ?
La tarification de la mise en cache des prompts d’Anthropic distingue les écritures 5 minutes, 1 heure, et les lectures réussies. Une lecture à 0,10 $/M est 95 % inférieure à 2 $/M d’entrée ordinaire, mais ce pourcentage ne s’applique qu’aux tokens d’entrée réutilisés.
| Opération | Prix API Claude / 1M |
|---|---|
| Entrée ordinaire | 2,00 $ |
| Écriture 5 minutes | 2,50 $ |
| Écriture 1 heure | 4,00 $ |
| Lecture réussie | 0,10 $ |
Considérez dix requêtes, chacune contenant le même préfixe de 100 K tokens. Supposez une écriture 5 minutes suivie de neuf lectures complètes du préfixe avant expiration, aucune écriture supplémentaire, et suffisamment de contexte pour le reste de l’invite et la sortie.
| Composant du préfixe répété | Sans cache | Une écriture + neuf lectures |
|---|---|---|
| Entrée de préfixe ordinaire | 10 × 100K × 2 $/M = 2,00 $ | 0,00 $ |
| Écriture initiale | 0,00 $ | 100K × 2,50 $/M = 0,25 $ |
| Neuf lectures | 0,00 $ | 9 × 100K × 0,10 $/M = 0,09 $ |
| Total préfixe répété | 2,00 $ | 0,34 $ |
La réduction est de 83 % pour le seul préfixe répété. Si chaque requête génère également 2 K tokens de sortie facturés, la sortie ajoute 0,20 $ sur dix requêtes : les totaux de tokens du modèle deviennent 2,20 $ sans cache et 0,54 $ avec cache, soit une réduction d’environ 75,5 %. Des entrées supplémentaires, l’expiration du cache, des préfixes réécrits et les outils changent à nouveau la facture.
Suivez séparément les lectures et écritures réussies. Un prompt répété n’est pas la preuve d’un hit de cache. L’exemple illustre les tarifs de l’API Claude ; vérifiez les tarifs de cache et le reporting d’usage de l’itinéraire CometAPI sélectionné avant d’appliquer la même estimation.
Comment Claude Sonnet 5.5 se compare-t-il à d’autres modèles ?
Claude Sonnet 5.5 vs Claude Sonnet 5
La comparaison de tarification de l’API Claude donne aux deux modèles les mêmes tarifs de 2 $/M en entrée et 10 $/M en sortie. Les lectures de cache de Sonnet 5 coûtent 0,20 $/M, tandis que celles de Sonnet 5.5 coûtent 0,10 $/M. Les développeurs qui évaluent l’API Claude Sonnet 5 dans CometAPI par rapport à Sonnet 5.5 devraient comparer la dépense par tâche acceptée, et non inférer une économie de tarif par token d’une mise à niveau de modèle.
Anthropic rapporte jusqu’à 30 % de coût par tâche en moins et une génération de sortie plus rapide pour Sonnet 5.5. Ce sont des résultats de charges de travail rapportés par le fournisseur, pas une réduction de 30 % de la grille tarifaire. Moins de tokens, d’itérations d’outils et de réessais peuvent modifier la facture ; mesurez ces quantités selon vos propres critères d’acceptation.
Si les deux modèles consomment un nombre identique de tokens d’entrée et de sortie non mis en cache et réussissent aussi souvent, la facture standard par token est identique. Avec des lectures de cache, leurs factures peuvent différer même à compte de tokens identique. Un modèle qui termine plus de tâches ou nécessite moins de corrections peut tout de même offrir une meilleure économie. Comparez la dépense totale sur tout l’ensemble d’évaluation, y compris les tentatives échouées.
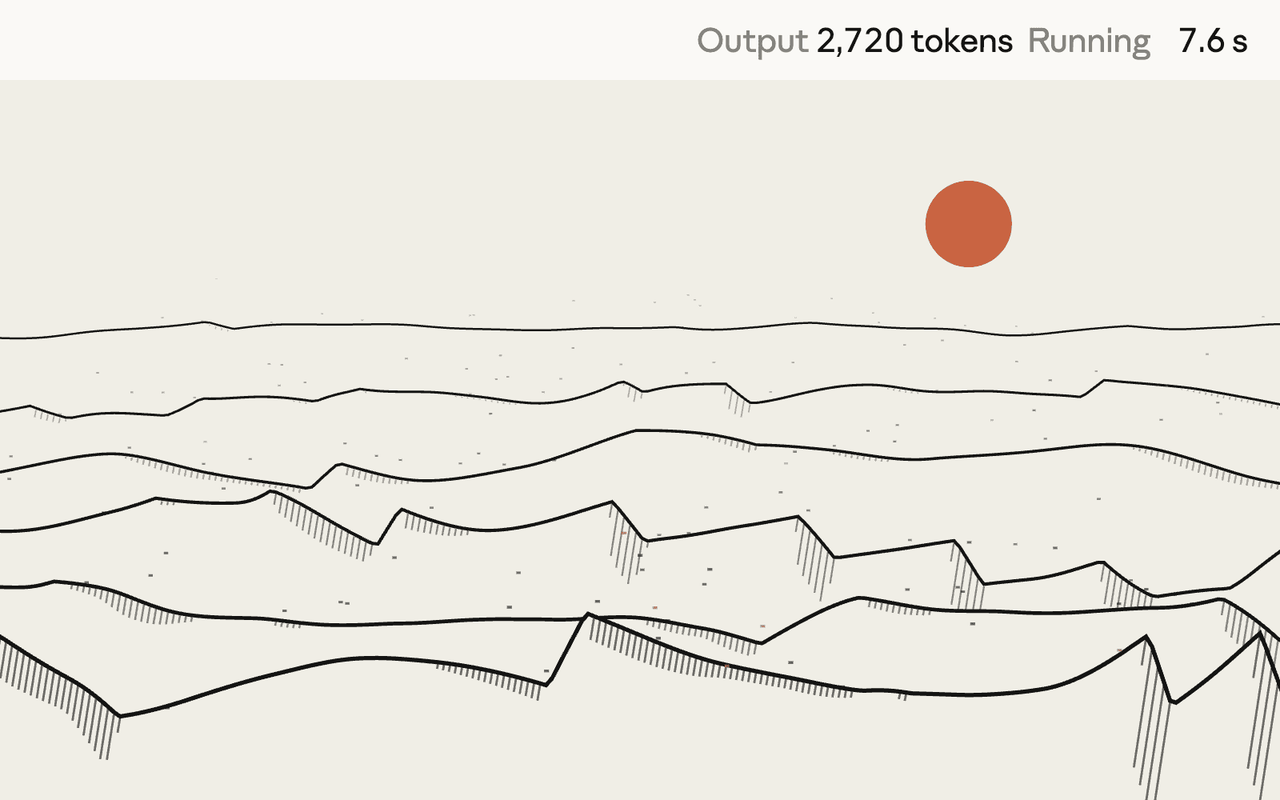
Démonstration de codage « sand-dunes » de Sonnet 5.5 publiée par Anthropic.
La démonstration « dunes de sable » d’Anthropic montre une sortie de code issue de sa démo produit officielle. L’image illustre un seul exemple, pas une garantie de latence ni un benchmark de coût reproductible.
Claude Sonnet 5.5 vs Claude Opus 5.5
| Modèle | Entrée / 1M | Sortie / 1M | Lecture du cache | Contexte |
|---|---|---|---|---|
| Claude Sonnet 5.5 | 2 $ | 10 $ | 0,10 $ | 1 M |
| Claude Opus 5.5 | 4 $ | 20 $ | 0,20 $ | 1 M |
Anthropic documente un contexte de 1 M, une sortie à 128 K et 4 $/M en entrée plus 20 $/M en sortie pour Opus 5.5. L’API Claude Opus 5.5 dans CometAPI est une alternative pour les travaux complexes et ouverts. Sonnet 5.5 a la moitié des tarifs standard nominaux par token ; un itinéraire d’escalade doit néanmoins inclure la tentative Sonnet échouée, la validation et les réessais dans son coût total.
Claude Sonnet 5.5 vs GPT-6 Sol
OpenAI documente les tarifs et limites du modèle GPT-6 Sol. Les tarifs standard correspondent à Sonnet pour les entrées jusqu’à 272 K tokens. Au-delà, GPT-6 Sol applique 4 $/M en entrée et 15 $/M en sortie à la requête entière. La capacité de contexte et la borne du tarif inférieur sont des limites différentes.
| Dimension | Claude Sonnet 5.5 | GPT-6 Sol |
|---|---|---|
| Entrée / sortie standard, USD par 1M | 2 $ / 10 $ | 2 $ / 10 $ jusqu’à 272K en entrée |
| Entrée / sortie standard au-delà de 272K | 2 $ / 10 $ | 4 $ / 15 $ pour la requête entière |
| Contexte / sortie max standard | 1,000,000 / 128,000 | 1,050,000 / 128,000 |
| Modalités natives | Texte et images en entrée ; texte en sortie | Texte et images en entrée ; texte en sortie |
| Contrôle du raisonnement | Réflexion adaptative ; défaut élevé | Effort de none à max ; défaut moyen |
| Intégration API directe | Claude Messages API | Responses ; Chat Completions impose des contraintes d’appel d’outils |
GPT-6 Sol prend en charge des outils intégrés via Responses ; Chat Completions nécessite reasoning_effort=none pour l’appel de fonctions. Les développeurs peuvent évaluer l’API GPT-6 Sol dans CometAPI, mais doivent vérifier séparément la compatibilité de la passerelle et les tarifs en vigueur. Pour les deux modèles, comparez les tokens totaux, les outils, les réessais, la latence et la complétion des tâches acceptées au niveau d’effort et au palier de prix sélectionnés.
Comment réduire les coûts de l’API Claude Sonnet 5.5 ?
- Mettez en cache des préfixes stables comme les prompts système, schémas d’outils, conventions de codage et gros documents statiques.
- Réduisez la croissance de contexte inutile en élaguant ou en résumant les résultats d’outils obsolètes et le contenu de conversation antérieur.
- Alignez l’effort sur la difficulté de la tâche au lieu d’utiliser un raisonnement maximal pour un simple travail de classification ou de mise en forme.
- Utilisez le traitement Batch pour les charges qui n’exigent pas de réponses immédiates.
- Évaluez le coût par tâche réussie, pas seulement les dollars par million de tokens.
Claude Sonnet 5.5 vaut-il son prix ?
Le positionnement tarifaire de Claude Sonnet 5.5 est inhabituel car Anthropic a maintenu ses tarifs standard d’entrée et de sortie inchangés tout en réduisant le tarif de lecture du cache. Il conserve les 2 $/M en entrée et 10 $/M en sortie de Sonnet 5 et se concentre plutôt sur la réduction du travail modèle requis par tâche.
Si une charge se contente de générer exactement le même nombre de tokens d’entrée et de sortie non mis en cache, Sonnet 5.5 ne crée pas d’économie officielle par token par rapport à Sonnet 5. Mais si un meilleur codage, un usage d’outils plus efficace et une exécution plus concise réduisent les tours d’agent, les réessais ou les tokens de sortie, la facture peut baisser même à tarifs de tokens identiques.
L’affirmation d’Anthropic de jusqu’à 30 % de coût par tâche en moins doit donc être considérée comme un résultat d’efficacité dépendant de la charge, plutôt qu’une remise API universelle de 30 %. Pour un test de migration, rejouez un ensemble fixe de tâches de production réelles et consignez l’entrée totale, l’entrée mise en cache, les tokens générés, les appels d’outils, le taux de complétion, la latence et le coût total.
Conclusion
Claude Sonnet 5.5 combine un tarif de tokens familier avec une mise à niveau axée sur l’efficacité. Utilisez la complétion mesurée des tâches, la réutilisation du cache, l’effort, l’activité des outils et les réessais pour déterminer sa valeur pratique. Avant de migrer, rejouez un ensemble représentatif de tâches sur les deux modèles et comparez le coût par tâche acceptée, le taux de complétion, les réessais et la latence aux tarifs actuels des fournisseurs.
FAQ
Comment une équipe peut-elle budgéter des longueurs de sortie variables de Claude Sonnet 5.5 ?
Regroupez les requêtes de production par charge de travail au lieu de vous fier à une seule réponse moyenne. Mesurez l’entrée facturée, la sortie, les réessais et l’usage du cache pour chaque groupe, puis calculez le volume mensuel attendu aux tarifs applicables. Rapportez une estimation centrale et un scénario de forte utilisation basé sur les réponses longues observées ; mettez à jour le budget lorsque la distribution ou le mix de trafic change.
Quand un agent Sonnet 5.5 doit-il utiliser une durée de cache plus longue ?
Comparez le calendrier de réutilisation attendu avec le coût des réécritures. Une écriture d’une heure coûte plus cher initialement qu’une écriture de cinq minutes, mais peut être justifiée lorsque des requêtes utiles arrivent après l’expiration du cache plus court. Calculez les écritures et hits attendus pour chaque option avec le même préfixe, et vérifiez l’usage réel plutôt que de traiter chaque requête répétée comme un hit.
Comment les équipes peuvent-elles évaluer une stratégie d’escalade Sonnet 5.5 et Opus 5.5 ?
Rejouez le même ensemble de tâches via des routes Sonnet uniquement, Opus uniquement et Sonnet d’abord. Définissez des déclencheurs d’escalade à partir d’échecs de validation ou de critères d’acceptation non satisfaits, et incluez la tentative Sonnet infructueuse dans le coût de la route combinée. Comparez la complétion des tâches acceptées, la dépense totale, le temps de correction et la latence avant de décider si l’escalade réduit le coût pour la charge de travail.