Construire avec CometAPIBesoin d'une seule API pour plusieurs modèles ?Testez le workflow dans Playground, puis créez une clé API lorsque le modèle et le coût correspondent à votre cas d'usage.
DeepSeek V4.1 Flash vs V4 Pro : performances, tarification et guide de migration
Comparez DeepSeek V4.1 Flash et V4 Pro selon l’architecture, les benchmarks officiels, la tarification de l’API, la vision, la simultanéité et les choix de migration.
Deon GoodwinÉquipe de recherche sur les modèles IA et API
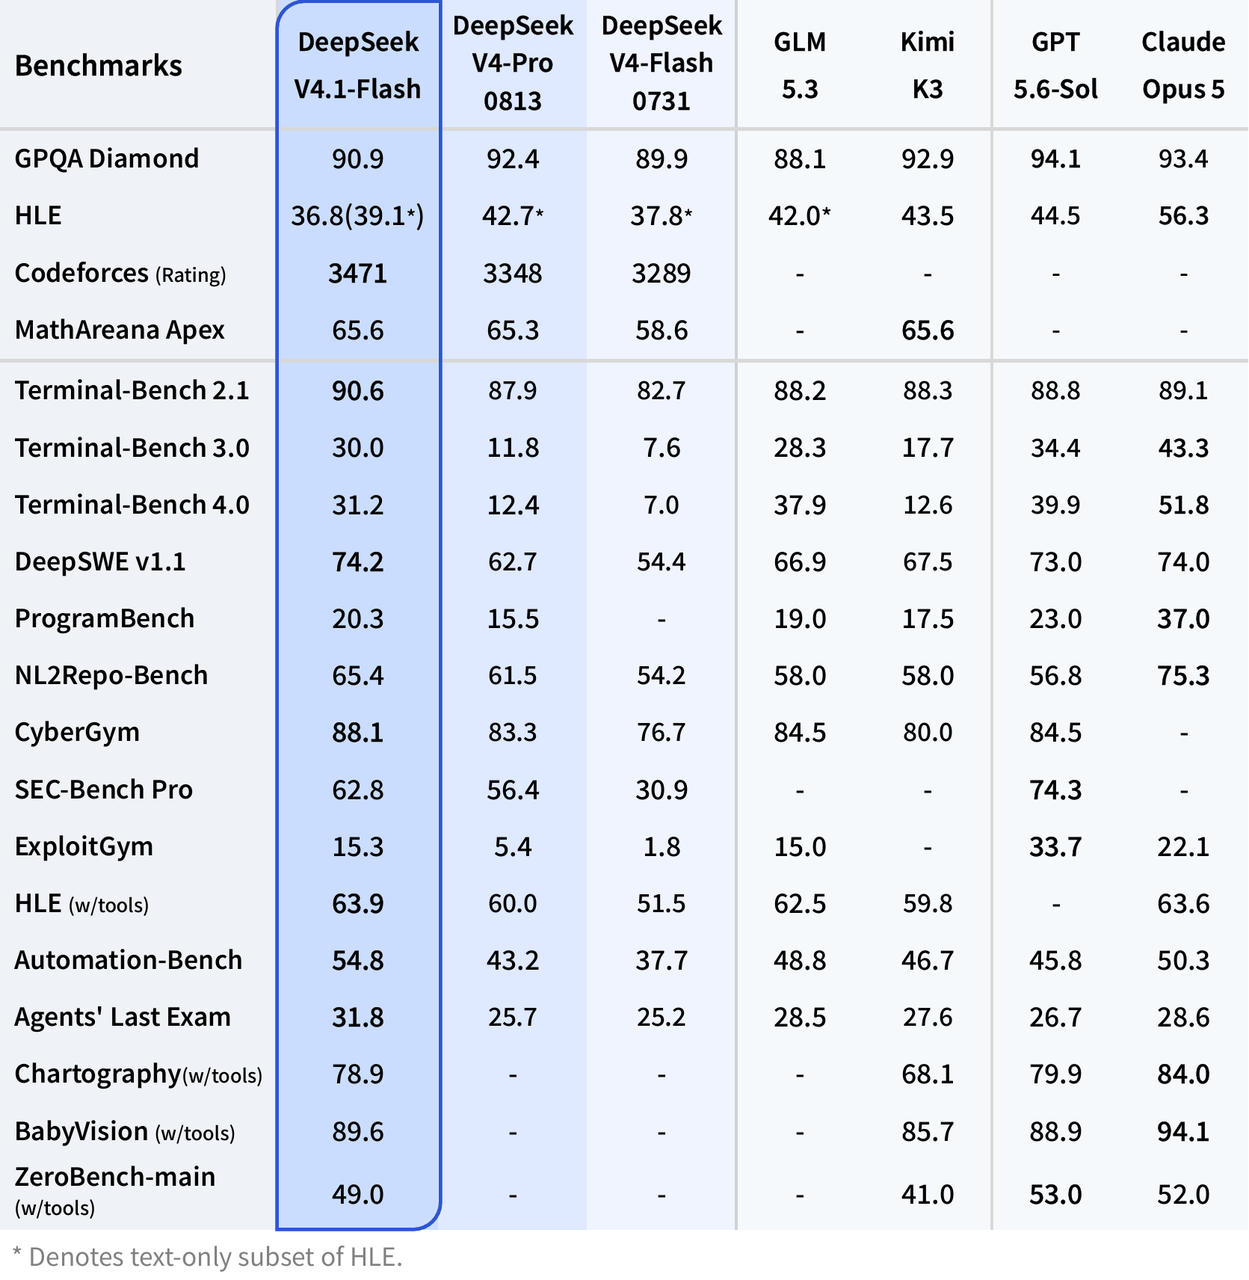
DeepSeek V4.1 Flash remplace l’ancienne génération V4 Flash par un modèle MoE encodeur–décodeur causal à 552B paramètres, une compréhension d’images native, une fenêtre de contexte de 1M jetons et un coût de service sensiblement inférieur. Dans la comparaison officielle de DeepSeek, il améliore la plupart des benchmarks de codage, terminal, sécurité et agents par rapport à V4 Pro 0813, tandis que V4 Pro garde l’avantage sur GPQA Diamond et HLE sans outils.
La page de tarification API actuelle de DeepSeek répertorie de nouveau deepseek-flash et deepseek-v4-pro comme routes distinctes, servant respectivement V4.1 Flash et V4-Pro-0813. Elles ont des prix, des limites de concurrence et une prise en charge de la vision différents. Les nouvelles intégrations doivent donc sélectionner l’ID de modèle correspondant à la charge de travail visée plutôt que de s’appuyer sur un comportement d’alias historique.
Points clés
V4.1 Flash et V4 Pro sont actuellement deux choix API officiels distincts : utilisez pour V4.1 Flash et pour V4-Pro-0813.
Revu pour la clarté, l'attribution des sources et la terminologie API actuelle.
deepseek-flash
deepseek-v4-pro
Les gains les plus comparables apparaissent dans les tâches terminal, les agents de codage, l’automatisation et l’exécution orientée sécurité — pas dans chaque benchmark de raisonnement en closed-book.
V4.1 Flash est sensiblement moins cher que la route V4 Pro actuellement listée, sur les jetons d’entrée cache-hit, cache-miss et de sortie.
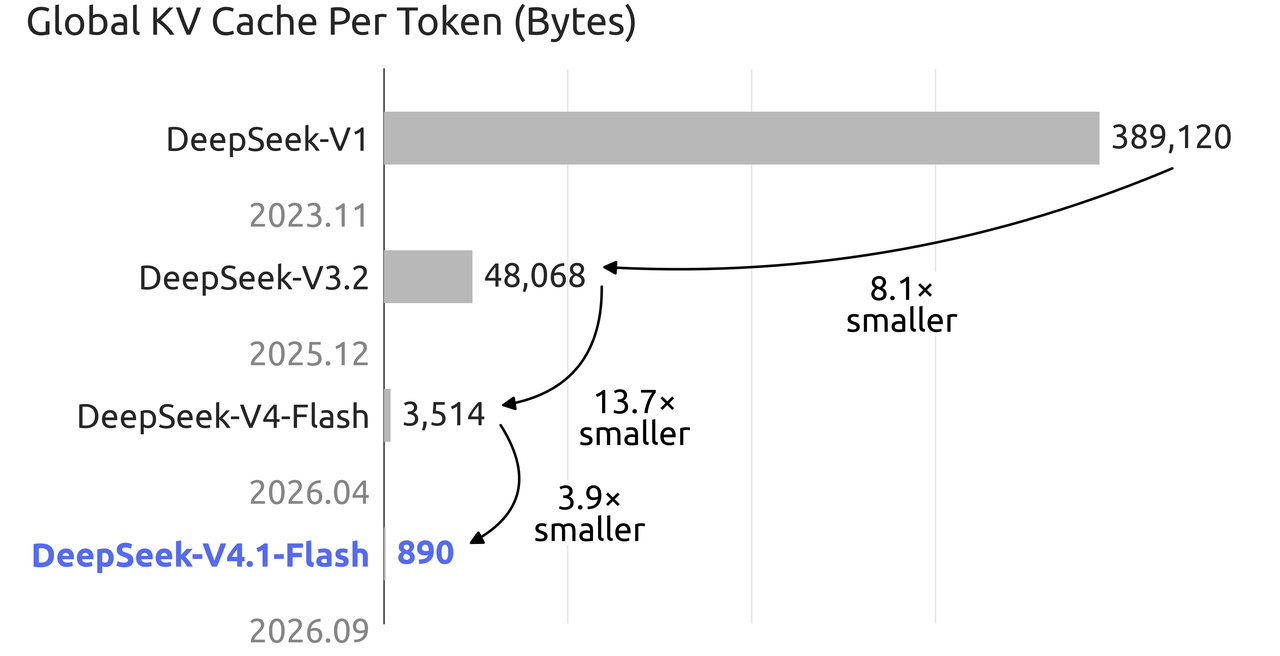
V4.1 Flash ajoute la vision native, fait passer la concurrence documentée de 500 à 2,500 et réduit le stockage global du cache KV à 890 bytes par jeton.
La migration doit être explicite même si les alias fonctionnent : mettez à jour les IDs de modèle, validez les comportements en modes thinking et non-thinking, re-testez les appels d’outils et les entrées image, et surveillez l’usage de jetons et la latence.
Note de routage actuelle : la page de tarification officielle identifie deepseek-v4-pro comme V4-Pro-0813, distinct de V4.1 Flash.
Comment les spécifications de DeepSeek V4.1 Flash et V4 Pro se comparent-elles ?
L’architecture est passée d’un très grand MoE clairsemé dans V4 Pro à une conception asymétrique encodeur–décodeur causal dans V4.1 Flash. Le nouveau modèle active moins de paramètres pour le traitement de l’entrée que pour la génération de la sortie, ce qui aide à réduire le coût de préremplissage tout en préservant une capacité de génération plus forte.
Spécification
DeepSeek V4.1 Flash
DeepSeek V4 Pro 0813
Architecture
MoE encodeur–décodeur causal
MoE clairsemé
Total parameters
Backbone parameters / repository weight count
552B paramètres du backbone ; Hugging Face liste une taille de modèle de 763B
1.6T paramètres du backbone ; Hugging Face liste une taille de modèle d’environ 1.7T
Paramètres actifs
8B pour l’entrée ; 16B pour la sortie
49B par jeton
Fenêtre de contexte
1M jetons
1M jetons
Sortie maximale
384K jetons
384K jetons
Modes thinking et non-thinking
Pris en charge
Pris en charge
Compréhension d’images native
Pris en charge
Non pris en charge
Concurrence documentée
2,500
500 sur la configuration actuelle
Statut API officiel actuel
Actif en tant que deepseek-flash
Actif en tant que deepseek-v4-pro (V4-Pro-0813)
Précision sur le comptage des paramètres : la fiche du modèle V4.1 Flash de DeepSeek décrit 552B paramètres de backbone, tandis que le dépôt Hugging Face rapporte une taille de modèle de 763B. Ces chiffres décrivent des périmètres de comptage différents et ne doivent pas être présentés comme des totaux interchangeables.
Précision sur la longueur de sortie : la fiche du modèle V4.1 Flash recommande max_tokens ≥ 256K pour l’inférence locale, tandis que la page de tarification API actuelle de DeepSeek indique explicitement une sortie maximale de 384K pour les deux modèles API. Une recommandation de réglage d’inférence n’est pas équivalente à un maximum imposé par l’API.
Où DeepSeek V4.1 Flash s’améliore-t-il par rapport à V4 Pro ?
Le tableau de benchmarks officiel de DeepSeek montre les améliorations les plus nettes sur les charges de travail d’exécution. La colonne de pourcentage ci-dessous est calculée à partir des scores publiés ; les comparaisons en pourcentage sont omises lorsque la métrique est une note ou lorsqu’un pourcentage simple serait trompeur.
Benchmark
V4.1 Flash
V4 Pro 0813
Différence
Interprétation
Terminal-Bench 2.1
90.6
87.9
+2.7 points ; +3.1%
Exécution terminale plus fiable
Terminal-Bench 3.0
30.0
11.8
+18.2 points ; +154.2%
Gain important sur des tâches terminales plus difficiles
Terminal-Bench 4.0
31.2
12.4
+18.8 points ; +151.6%
Gain important sur des tâches terminales plus récentes
DeepSWE v1.1
74.2
62.7
+11.5 points ; +18.3%
Meilleures performances au niveau dépôt logiciel
ProgramBench
20.3
15.5
+4.8 points ; +31.0%
Synthèse de programmes améliorée
NL2Repo-Bench
64.0
61.5
+2.5 points ; +4.1%
Meilleure conversion langage naturel → dépôt
CyberGym
88.1
83.3
+4.8 points ; +5.8%
Exécution de tâches cyber plus solide
HLE with tools
63.9
60.0
+3.9 points ; +6.5%
Meilleur raisonnement assisté par outils
Le résultat est multidimensionnel : V4.1 Flash est nettement meilleur pour les agents de codage, l’opération terminale, l’automatisation, les tâches de sécurité, l’utilisation d’outils, la vision, la concurrence et le coût. L’avantage restant de V4 Pro est concentré dans certains tests de raisonnement pur. Les charges de travail doivent donc être évaluées selon le mix de tâches plutôt qu’au travers d’une seule affirmation agrégée.
Pourquoi DeepSeek V4.1 Flash est-il plus efficace que V4 Pro ?
Calcul d’entrée et de sortie asymétrique
V4.1 Flash active 8B paramètres lors du traitement de l’entrée et 16B lors de la génération de la sortie. Cette conception asymétrique cible les besoins de calcul différents du préremplissage et du décodage, réduisant le coût sans forcer les deux étapes à partager le même budget de paramètres actifs.
Empreinte de cache KV plus petite
DeepSeek indique que V4.1 Flash utilise un quart de la HBM et un huitième de la capacité SSD exigés par le cache KV de la génération précédente. Le graphique publié situe le cache KV global à 890 bytes par jeton, contre 3,514 bytes pour V4 Flash.
Entrée multimodale native et concurrence plus élevée
V4.1 Flash peut interpréter les images nativement et expose une limite de concurrence documentée de 2,500, soit cinq fois la valeur actuelle de 500 pour V4 Pro. Ces changements comptent pour les agents basés sur captures d’écran, l’extraction de documents, le dépannage visuel et les files de production à haut volume.
Quel est le coût de DeepSeek V4.1 Flash par rapport à V4 Pro ?
Le barème API officiel actuel tarifie les deux routes séparément. Par 1M de jetons, V4.1 Flash coûte 0.003$/0.006$ pour l’entrée cache-hit, 0.15$/0.30$ pour l’entrée cache-miss, et 0.60$/1.20$ pour la sortie (off-peak/peak). V4 Pro coûte 0.022$/0.044$, 0.66$/1.32$, et 1.98$/3.96$ respectivement. Les prix peuvent évoluer ; les budgets de production doivent donc se référer à la page de tarification en ligne.
Comment migrer de DeepSeek V4 Pro ou V4 Flash vers V4.1 Flash ?
Utiliser explicitement l’ID de modèle de production
Utilisez deepseek-flash lorsque vous voulez V4.1 Flash. Les noms plus anciens deepseek-v4-flash et deepseek-v4-flash-vision-exp se résolvent toujours vers V4.1 Flash, mais une dénomination explicite facilite l’audit du monitoring et des retours arrière. Utilisez deepseek-v4-pro lorsque vous souhaitez intentionnellement le backend V4-Pro-0813 actuellement listé.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_API_KEY",
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",  # or "deepseek-v4-pro"
    messages=[{"role": "user", "content": "Review this migration plan."}],
)

print(response.choices[0].message.content)
Re-tester le comportement, pas seulement la compatibilité de point de terminaison
Exécuter des invites représentatives dans les modes thinking et non-thinking ; comparer la réussite des tâches, le nombre de jetons et la latence.
Re-tester les schémas d’outils, la sortie JSON, le comportement de l’API Responses, les complétions par préfixe et FIM lorsque utilisé.
Ajouter des tests d’entrée image si le produit utilisera la nouvelle capacité visuelle native.
Recaler les budgets en utilisant les tarifs en heures de pointe et hors pointe plutôt que de reconduire les hypothèses V4 Pro.
Suivre le taux d’atteinte du cache d’invite car il peut dominer le coût d’entrée à l’échelle.
Choisir explicitement le backend visé
La route actuelle deepseek-v4-pro sélectionne V4-Pro-0813. Les équipes doivent consigner la version résolue du modèle, la date d’évaluation, l’ensemble d’invites et la fenêtre tarifaire afin que les comparaisons restent reproductibles si le routage change à nouveau.
Quelles charges de travail conviennent le mieux à DeepSeek V4.1 Flash ?
Charge de travail
Choix recommandé
Raison
Agents de codage et maintenance de dépôts
V4.1 Flash
Scores plus élevés sur DeepSWE, ProgramBench, NL2Repo et terminal
Automatisation pilotée par outils
V4.1 Flash
Scores plus élevés sur Automation-Bench, HLE-with-tools et agents
Assistants sensibles aux images
V4.1 Flash
Compréhension d’images native
Service à haut débit ou sensible aux coûts
V4.1 Flash
Concurrence plus élevée et prix de jeton bien plus bas
Reproduction historique de V4 ProCurrent V4 Pro access and evaluation
V4 Pro
La route officielle identifie actuellement V4-Pro-0813
Raisonnement closed-book pur
Valider sur des données de domaine
V4 Pro reste plus élevé sur GPQA Diamond et HLE sans outils
FAQ : DeepSeek V4.1 Flash vs V4 Pro
DeepSeek V4.1 Flash est-il meilleur que V4 Pro ?
Pour la plupart des dimensions de production — agents de codage, tâches terminales, automatisation, usage d’outils, vision, débit et prix — oui. V4 Pro conserve des scores publiés plus élevés sur GPQA Diamond et HLE sans outils, donc les charges de travail de raisonnement pur doivent être testées avec des invites spécifiques au domaine.
Puis-je encore appeler deepseek-v4-pro ?
Oui. La page API officielle actuelle répertorie deepseek-v4-pro comme V4-Pro-0813, avec sa propre tarification et sa limite de concurrence.
Quel ID de modèle une nouvelle intégration doit-elle utiliser ?
Utilisez deepseek-flash pour V4.1 Flash, ou deepseek-v4-pro pour V4-Pro-0813. Ne traitez pas ces deux IDs comme des alias.
Les anciens IDs de modèle V4 Flash fonctionnent-ils encore ?
DeepSeek indique que les requêtes deepseek-v4-flash et deepseek-v4-flash-vision-exp sont automatiquement routées vers V4.1 Flash et facturées au nouveau prix Flash. La mise à jour de l’ID de modèle configuré reste recommandée pour plus de clarté.
DeepSeek V4.1 Flash prend-il en charge les images ?
Oui. La compréhension d’images native fait partie de V4.1 Flash ; l’API historique V4 Pro ne fournissait pas cette capacité.
DeepSeek V4.1 Flash est-il moins cher que le V4 Pro actuel ?
Oui. Le barème officiel actuel liste des prix plus bas pour l’entrée cache-hit, l’entrée cache-miss et la sortie pour V4.1 Flash que pour V4 Pro.
Dois-je m’attendre à des sorties identiques après la migration ?
Non. La compatibilité de point de terminaison ne garantit pas des chemins de raisonnement, une sélection d’outils, une utilisation de jetons ou un formatage identiques. Réexécutez les évaluations de production avant de vous fier aux seuils précédents.