Construire avec CometAPIBesoin d'une seule API pour plusieurs modèles ?Testez le workflow dans Playground, puis créez une clé API lorsque le modèle et le coût correspondent à votre cas d'usage.
Comparez Eleven v4 et v4 Turbo en termes de qualité vocale, de latence, de tarification de l’API, de streaming et d’accès à CometAPI. Choisissez le modèle approprié pour les contenus ou les agents.
Deon GoodwinÉquipe de recherche sur les modèles IA et API
Choisissez Eleven v4 pour les livres audio, la narration et les performances de personnages lorsque la qualité de production est prioritaire. Choisissez Eleven v4 Turbo pour les agents vocaux et les applications interactives où le temps de réponse est crucial. ElevenLabs indique que les deux partagent la même palette expressive ; le tarif publié par caractère de l’API Turbo est inférieur de 50 %. Faites votre choix final à l’aide de vos propres scripts, tests d’écoute et mesures de latence de bout en bout.
Points clés
Pour l’audio produit : commencez par la variante standard et évaluez l’interprétation, la cohérence et l’effort de montage.
Pour l’interaction en direct : commencez par Turbo et mesurez le temps total depuis l’entrée utilisateur jusqu’à la réponse audible.
le tarif publié par caractère de Turbo est inférieur de 50 %, avant de prendre en compte les nouvelles tentatives ou d’autres services.
Revu pour la clarté, l'attribution des sources et la terminologie API actuelle.
Pour le coût :
Pour les benchmarks : les résultats de préférence publiés comparent le modèle standard à des systèmes concurrents ; ils n’établissent pas une marge de qualité directe par rapport à Turbo.
Pour l’intégration : le streaming natif et la génération asynchrone via des tiers ont des exigences opérationnelles différentes.
Narration produite, livres audio et performances de personnages
Agents temps réel et parole interactive
ID du modèle
eleven_v4
eleven_v4_turbo
Langues
90+
90+
Prix natif
$0.08 / 1 000 caractères
$0.04 / 1 000 caractères
Latence d’inférence médiane
Aucune valeur directement comparable identifiée
∼100 ms
Temps médian jusqu’au début de la parole
Aucune valeur comparable identifiée
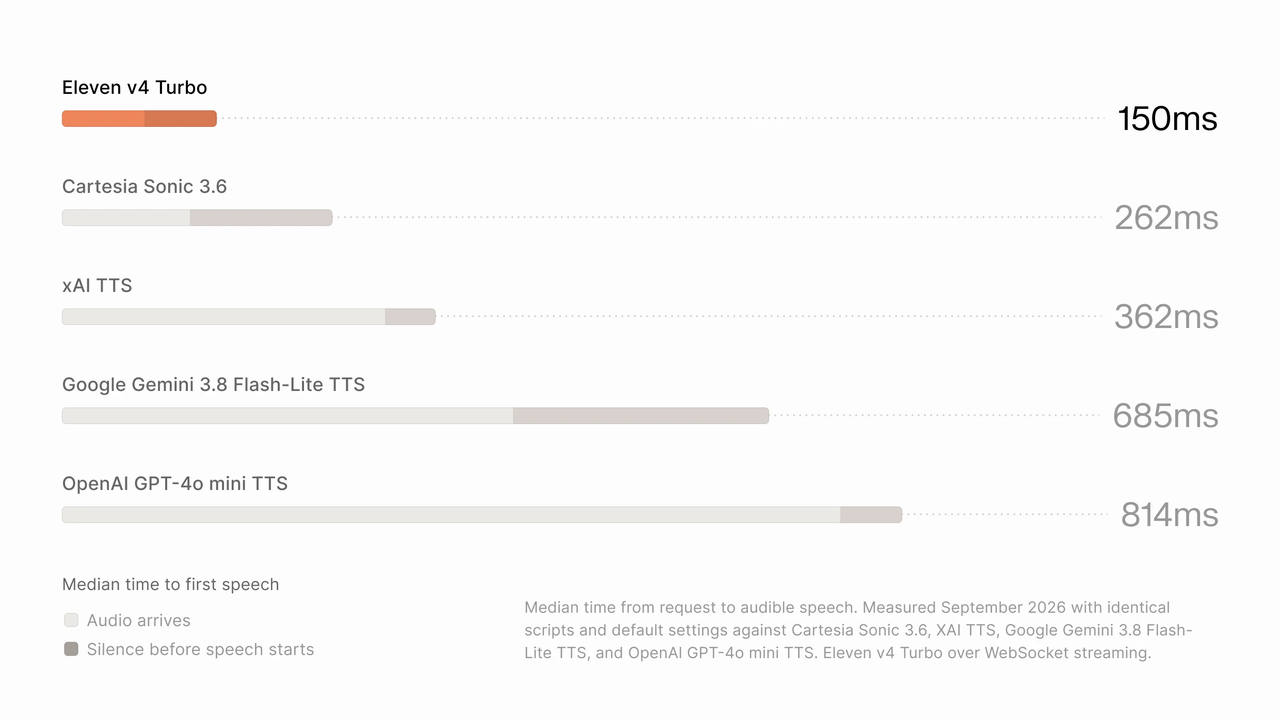
∼150 ms de délai médian entre la requête et le début de la parole audible via WebSocket ; latence réseau mesurée exclue
Voix enregistrées par connexion WebSocket Text to Dialogue
Jusqu’à 10
Exactement 1
Le chiffre de 150 ms provient de la comparaison d’ElevenLabs de septembre 2026, utilisant des scripts identiques et les paramètres par défaut. Il mesure le début de la parole audible, plutôt que le délai complet d’une conversation avec un agent vocal. Les limites d’enregistrement des voix s’appliquent à l’endpoint WebSocket Text to Dialogue.
Eleven v4 vs v4 Tu
Eleven v4 vs v4 Turbo : vue d’ensemble et spécifications
Eleven v4 : audio produit et performances multi-intervenants
La position officielle publiée du modèle standard est la production vocale de la plus haute qualité, incluant des dialogues naturels à plusieurs interlocuteurs et une narration longue. Cela en fait un premier choix judicieux lorsqu’un enregistrement peut être relu et édité avant diffusion. La question pertinente est de savoir si son interprétation reste convaincante sur des passages complets et des répliques régénérées.
Eleven v4 Turbo : parole expressive en temps réel
Eleven v4 Turbo est conçu pour des agents temps réel, assistants et personnages interactifs. ElevenLabs indique qu’il conserve la gamme expressive complète d’Eleven v4 et prend en charge Professional Voice Clones, tout en priorisant une génération à faible latence.
Évaluez‑le pendant le streaming et la lecture audio, car un extrait isolé convaincant n’établit pas que la conversation complète répond rapidement. Sa faible latence d’inférence est une spécification de départ, pas une garantie pour l’ensemble de l’application.
Une courte voix off didactique peut sonner de façon équivalente sur les deux, tandis qu’une scène dramatique peut révéler des différences qui justifient une génération plus coûteuse.
Architecture et périmètre d’évaluation
L’annonce officielle d’architecture décrit Eleven v4 comme reposant sur une architecture entièrement nouvelle et précise que Turbo apporte la même technologie aux cas d’usage à faible latence. Elle ne divulgue pas assez de détails pour comparer le nombre de paramètres, la structure des couches, le calcul d’entraînement, ni les changements spécifiques responsables de la différence de vitesse. Considérez ces éléments comme non divulgués plutôt que d’en déduire que Turbo est plus petit ou distillé.
Limites natives et contrôles de voix
Vérifiez la limite d’entrée pour le modèle et l’endpoint que vous prévoyez d’utiliser avant de scinder un long script. Une limite publiée pour une interface ne s’applique pas automatiquement à une autre, et l’absence de limite publiée ne signifie pas une entrée illimitée.
Les deux variantes offrent des réglages de Stability et Similarity. Lorsque vous sélectionnez un Professional Voice Clone avec Eleven v4, un curseur Clone Strength ajuste le degré de fidélité de la sortie aux enregistrements d’entraînement du clone. Des valeurs basses permettent une interprétation plus flexible avec un léger lissage de la voix ; des valeurs élevées préservent davantage la performance originale et les traits vocaux distinctifs, y compris les accents. ElevenLabs recommande de commencer à 0 % pour la plupart des voix. Les curseurs Style et Speed ne sont pas disponibles dans l’expérience v4 native, et SSML n’est pas pris en charge.
La conséquence pratique pour la migration : conservez le sens de vos consignes de voix existantes, mais revoyez leur formulation. Un ancien script fortement basé sur SSML devrait être adapté et testé à l’écoute plutôt que copié tel quel.
Eleven v4 vs v4 Turbo : performances
Benchmarks publiés et limites de portée
Deux résultats officiels comptent ici : la préférence d’écoute et la latence de réponse. Ils répondent à des questions différentes.
Éléments publiés — méthodologie de benchmark officielle
Résultat rapporté
Ce que cela établit
Tests de préférence à l’aveugle du modèle standard
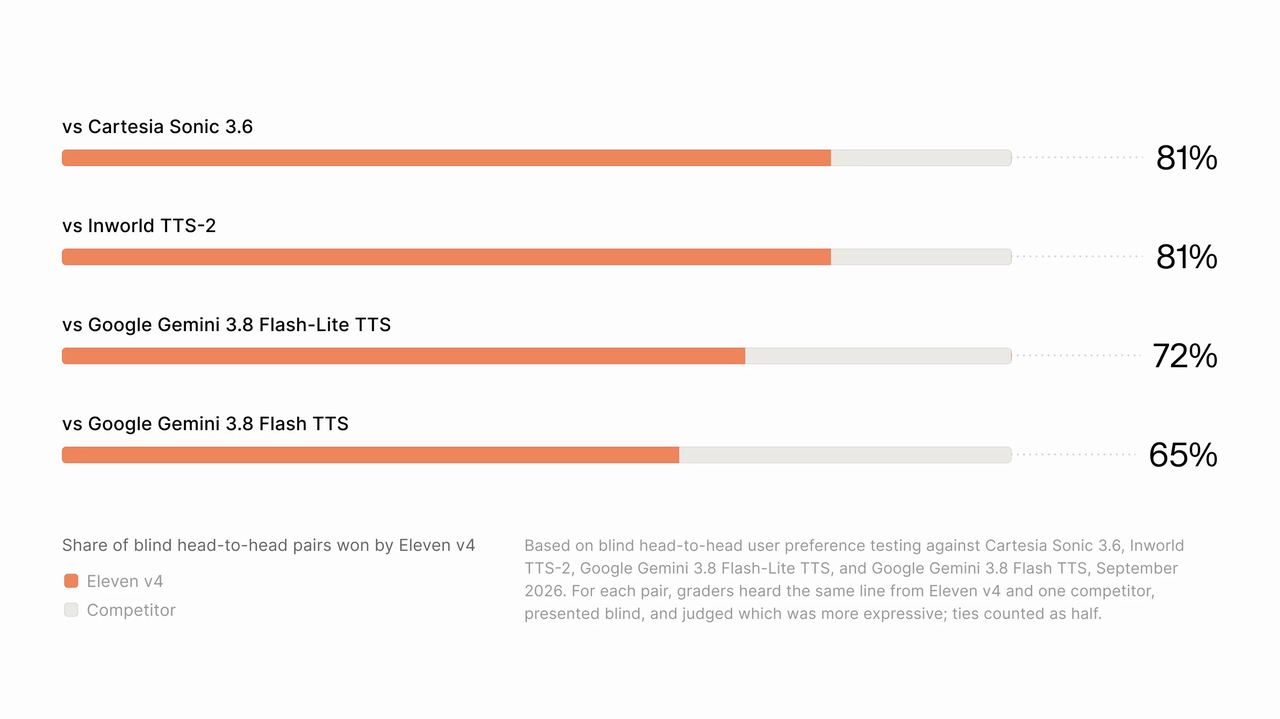
Environ 75 % de préférence globale ; les résultats du graphique s’étendent de 65 % à 81 %
Préférence des auditeurs par rapport aux modèles concurrents testés
Latence médiane d’inférence de Turbo
Environ 100 ms
Une revendication de timing d’inférence du modèle
Temps médian de Turbo jusqu’au début de la parole
Environ 150 ms
Timing entre la requête et la parole audible dans la configuration de test indiquée
Les tests d’écoute publiés comparent Eleven v4 à des modèles de parole concurrents. Ils n’établissent pas dans quelle mesure, le cas échéant, les auditeurs le préfèrent à Eleven v4 Turbo. Pour ce choix, comparez les deux variantes en utilisant les mêmes scripts et voix dans votre propre test d’écoute à l’aveugle.
Graphique officiel de latence d’ElevenLabs. Le timing rapporté exclut la latence réseau mesurée.
Conditions d’évaluation
L’étude d’écoute officielle de septembre 2026 a utilisé des comparaisons appariées à l’aveugle de la même réplique produite par Eleven v4 et un modèle concurrent, en évaluant l’expressivité et la naturalité ; les ex æquo comptaient pour moitié. Les systèmes comparés et les taux de préférence par système figurent dans le graphique officiel ci‑dessous. Ces résultats rapportés par le fournisseur comparent Eleven v4 à des systèmes concurrents. Ils ne quantifient pas une différence de qualité d’écoute entre Eleven v4 et Eleven v4 Turbo.
La comparaison de latence de septembre 2026 a utilisé des scripts identiques et les paramètres par défaut, a soustrait la latence réseau mesurée pour chaque système, et a exécuté Turbo via un streaming WebSocket. Les 150 ms rapportés mesurent le délai entre la requête et le début de la parole audible ; c’est une métrique différente du chiffre d’inférence d’environ 100 ms. La méthodologie citée ne fournit pas un détail complet du matériel, de la région, de la charge et de la taille d’échantillon, et n’établit donc pas une garantie de latence en production.
Qualité de la voix et constance en production
ElevenLabs met en avant la prise en charge de Professional Voice Clone, une meilleure constance du locuteur sur les répliques régénérées, et l’assemblage de requêtes pour l’audio longue durée. Évaluez ces affirmations avec un passage complet et une réplique de remplacement insérée dans un enregistrement existant.
Pour l’audio enregistré, distinguez l’expressivité de la constance en production. Écoutez l’accentuation, l’émotion, la prononciation et vérifiez si le même locuteur reste reconnaissable d’un passage à l’autre. Le modèle standard est l’option orientée qualité du fournisseur, mais un script didactique simple peut ne pas révéler de différence utile. Comparez les prises acceptées plutôt que de supposer qu’une génération plus chère nécessitera toujours moins de montage.
Direction de voix et livraison multilingue
Les deux variantes prennent en charge une interprétation expressive, mais l’expressivité utile dépend du script et de la voix choisie. Commencez par un petit nombre de consignes claires, puis écoutez si elles améliorent le sens voulu.
Une réponse de support rassurante peut combiner un ton chaleureux avec une brève pause:
[warm, reassuring] I found your reservation.
[short pause] Let me confirm the arrival time with you.
Il s’agit d’un prompt illustratif, pas d’un résultat de performance mesuré. Testez‑le en parallèle d’une version sans balises. Des consignes supplémentaires ne sont utiles que lorsqu’elles améliorent la sortie.
La localisation mérite également une écoute distincte. Selon le guide produit natif, la génération dans la même langue préserve l’accent original de la voix de référence, tandis que la génération interlangue adopte une prononciation naturelle dans la langue cible au lieu de conserver l’accent de la langue source.
Ce comportement peut convenir à un tutoriel produit localisé, mais un personnage fictif avec un accent étranger volontairement reconnaissable pourrait nécessiter des consignes supplémentaires. Évaluez séparément la prononciation, l’identité et l’accent voulu ; une voix peut paraître fluide tout en manquant le cahier des charges créatif.
Latence et fiabilité
Pour un agent vocal en production, la synthèse vocale n’est qu’une partie du délai. La reconnaissance vocale, la détection de tours de parole, la sortie du modèle de langage, le transit réseau et la mise en mémoire tampon audio peuvent tous influer sur le moment où l’utilisateur entend une réponse.
Mesurez à la fois les temps de réponse médians et de la queue lente dans votre propre application. Un médian faible peut coexister avec des pauses occasionnelles qui rendent la conversation frustrante.
Eleven v4 vs v4 Turbo : coût
Tarifs officiels par caractère de l’API
La comparaison de l’API native ci‑dessous utilise des tarifs publiés vérifiés au 19 octobre 2026. Les totaux de volume sont des calculs basés sur ces tarifs, plutôt que des devis de forfaits séparés.
Usage — tarification officielle de l’API
Variante standard
Variante Turbo
Économie calculée avec Turbo
1 000 caractères
$0.08
$0.04
$0.04
100 000 caractères
$8.00
$4.00
$4.00
1 million de caractères
$80.00
$40.00
$40.00
10 millions de caractères
$800.00
$400.00
$400.00
Ces chiffres décrivent la génération vocale facturée au caractère, pas l’ensemble de la facture d’un agent vocal. Les quotas d’abonnement, les autres services et les conditions commerciales applicables doivent être considérés séparément.
Tarification CometAPI et conditions de facturation
CometAPI affiche une tarification en jetons, tandis que les tarifs natifs ci‑dessus sont au caractère. Comparez les coûts uniquement après avoir confirmé comment l’endpoint choisi mesure et facture l’usage. Si vous avez besoin de Turbo, confirmez que le modèle est disponible sur la route CometAPI choisie avant de planifier l’intégration.
Coût par enregistrement ou interaction acceptés
Pour la budgétisation, utilisez :
Coût de synthèse vocale = caractères facturables ÷ 1 000 × tarif par caractère applicable
Pour la production de contenu, une mesure opérationnelle plus utile est le coût par enregistrement accepté. Incluez les prises régénérées et le temps de montage. Si la variante moins chère échoue à répétition sur une performance difficile, son avantage de prix unitaire peut diminuer.
Pour les agents en direct, comparez le coût des interactions réalisées au niveau de qualité et de temps de réponse requis. Une facture de synthèse faible a une valeur limitée si les utilisateurs abandonnent des conversations lentes ou déroutantes.
Eleven v4 vs v4 Turbo : comparaison et sélection
Sélection basée sur les capacités et la charge
Les recommandations suivantes combinent le positionnement publié avec des critères d’évaluation pratiques. Ce sont des points de départ pour les tests, plutôt que des résultats de benchmark supplémentaires.
Projet
Point de départ recommandé
Évaluation décisive
Livre audio ou documentaire
Variante standard
Cohérence à travers les passages et les répliques régénérées
Scène dramatique de personnage
Variante standard
Interprétation émotionnelle et interaction entre les intervenants
Agent de support client
Turbo
Temps de réponse audible, prononciation et gestion des interruptions
Personnage de jeu interactif
Turbo
Réactivité et performance lors de tours de parole courts
Clips didactiques simples
Tester les deux
Si les auditeurs perçoivent une différence de qualité significative
Production multilingue
Tester les deux selon la langue
Prononciation, accent et identité de la voix
Produit avec audio enregistré et audio en direct
Routage séparé selon la charge
Si chaque route satisfait ses propres critères d’acceptation
Pour les livres audio, la publicité et les scènes dramatiques, testez Eleven v4 avec un passage neutre, un passage émotionnel et une réplique régénérée insérée dans un enregistrement existant. Écoutez l’identité vocale, le rythme et la prononciation pour vérifier leur constance aux jonctions. Choisissez la variante standard lorsque la performance acceptée ou le temps de montage économisé justifie son coût de génération plus élevé.
Pour les agents de support et les personnages interactifs, testez Turbo sur la conversation complète : parole utilisateur, détection de tours, génération de réponse, synthèse et lecture. Intégrez des connexions lentes, des échecs de connexion et des interruptions. Confirmez que la lecture s’arrête rapidement lorsque l’utilisateur interrompt et que la réponse suivante commence proprement. Choisissez Turbo lorsqu’il satisfait à la fois votre seuil de qualité d’écoute et votre objectif de temps de réponse.
Constituez un jeu de test représentatif : incluez une explication neutre, une réponse rassurante, un passage émotionnel, des noms ou abréviations, et des textes multilingues utilisés par votre audience.
Maintenez le script, la voix et les réglages de sortie aussi comparables que chaque interface le permet.
Évaluez les enregistrements sans étiquettes de modèle. Notez les erreurs de prononciation, les identités vocales incohérentes et les corrections nécessaires pour chaque prise.
Mesurez le temps de réponse en direct séparément de la qualité d’écoute, en incluant la latence médiane et les délais de queue lente.
Fixez des seuils d’acceptation avant de choisir une route : prononciation, constance de la voix, effort de montage, temps de réponse médian et temps de réponse de queue lente.
Faites passer un trafic représentatif par l’endpoint que vous allez déployer. Suivez les sorties rejetées, les nouvelles tentatives et les échecs de lecture ou de connexion.
Comparez le coût par enregistrement accepté ou interaction réalisée, en incluant les prises régénérées et l’effort de montage.
Pour les produits avec audio préenregistré et audio en direct, testez un routage séparé et confirmez que chaque route respecte ses propres seuils d’acceptation.
Où accéder à Eleven v4 et v4 Turbo ?
Accès via le fournisseur officiel
Utilisez la voie native du fournisseur qui correspond à la charge : synthèse de voix et dialogue pour l’audio produit, et streaming Text to Dialogue WebSocket pour l’interaction Turbo. L’exemple officiel ci‑dessous documente la connexion de streaming et ses restrictions d’enregistrement de voix. Vérifiez le schéma d’endpoint actuel, les exigences d’authentification et les limites de compte avant de connecter une charge de production.
La même référence précise qu’il y a exactement une voix enregistrée par connexion Turbo, contre jusqu’à dix pour la variante standard sur cet endpoint. Ce sont des règles au niveau de la connexion, pas une affirmation universelle concernant toutes les interfaces.
Accès via CometAPI
L’API Eleven v4 dans CometAPI offre une voie pour générer de la parole via une interface compatible Runway. Son annonce d’intégration du 10 octobre 2026 documente le comportement spécifique au fournisseur résumé ci‑dessous.
Détail d’intégration — annonce CometAPI
Comportement publié
ID du modèle
eleven_v4
Endpoint de soumission
POST /runwayml/v1/text_to_speech
Traitement
Soumission de tâche asynchrone
Sortie
Audio MP3
Limite d’entrée
Jusqu’à 2 500 caractères par requête
Configuration de voix
Voix prédéfinies
Contrôle supplémentaire exposé
Vitesse de parole ajustable
Ce sont des détails d’intégration spécifiques au fournisseur. La limite native de 10 000 caractères et les contrôles d’interface natifs ne doivent pas être substitués au comportement documenté de cette interface. De même, le flux asynchrone n’établit pas que la performance native WebSocket de Turbo est disponible via cette voie.
Une séquence d’intégration pratique consiste à soumettre un court script, suivre le workflow documenté du statut de tâche, récupérer le résultat et vérifier la prononciation et la durée de la sortie avant d’augmenter le volume.
Conclusion
Choisissez Eleven v4 lorsque ses enregistrements acceptés offrent une qualité de performance ou des économies de production suffisantes pour justifier le tarif par caractère plus élevé. Choisissez Eleven v4 Turbo lorsqu’il franchit votre seuil d’écoute et offre la réactivité nécessaire à une conversation en direct. Prenez la décision finale sur l’endpoint que vous déploierez, en incluant des scripts représentatifs, des nouvelles tentatives et le coût d’exploitation total.
FAQ
Comment faut‑il scinder de longs scripts Eleven v4 pour la production ?
Scindez aux limites de paragraphe, de phrase ou de scène plutôt qu’au milieu d’un mot ou d’un tour de parole. Laissez de la marge pour toute consigne textuelle dans l’entrée autorisée par l’endpoint, conservez un enregistrement du script et des réglages de voix pour chaque segment, et testez les jonctions après l’assemblage audio. Comparez le niveau, le rythme, la prononciation et l’identité de la voix à travers les frontières ; accepter chaque clip individuellement n’établit pas que l’enregistrement combiné est homogène. Utilisez la limite de l’endpoint du fournisseur réel, car les limites de requête natives et CometAPI diffèrent.
Comment relancer une requête Eleven v4 interrompue ?
Suivez l’identifiant de la requête ou de la tâche d’origine et déterminez son état avant de soumettre à nouveau le même texte. Pour un workflow fournisseur asynchrone, vérifiez si la tâche originale est terminée et si son résultat reste récupérable. Pour un flux en direct, notez quel audio a déjà été lu et décidez s’il faut rejouer l’énoncé ou reprendre à une frontière propre. Confirmez les règles de nouvelle tentative, d’idempotence et de facturation de l’endpoint ; n’assumez pas que répéter une requête est gratuit ou produit un audio identique.
Comment les équipes peuvent‑elles tester en régression une version de voix Eleven v4 ?
Maintenez un ensemble d’acceptation fixe contenant des noms de marque, abréviations, nombres, prononciations difficiles, passages émotionnels et les langues utilisées par le produit. Archivez le script, l’identifiant du modèle, l’identifiant de la voix, les réglages disponibles, la date de génération et les enregistrements de référence acceptés. Lorsqu’un modèle, une voix ou une intégration change, écoutez de nouveaux échantillons par rapport à ces références et documentez les corrections requises. Distinguez une procédure de test reproductible d’une supposition d’ondes identiques : réussir un enregistrement ne garantit pas que toutes les générations ultérieures réussiront.