
TL;DR
Google a annoncé Gemini 4 Argon le 30 septembre 2026 en tant que modèle de pointe pour des workflows complexes et de longue durée. Ses résultats publiés montrent un schéma clair : de solides performances dans le travail professionnel de connaissance, les tâches à long contexte et certaines évaluations en ingénierie logicielle, avec des résultats plus faibles sur certains benchmarks de terminal et d’utilisation de l’ordinateur. Google introduit le modèle via un déploiement par étapes. Par ailleurs, CometAPI signale une disponibilité au catalogue au 1er octobre ; l’éligibilité du compte et une requête de test réussie doivent être vérifiées avant le déploiement. Le point le plus utile est d’identifier où se situent ses gains.
Argon obtient 68,9% sur Vals Index, 65,4% sur Vals Finance Agent v2, 77,9% sur DeepSWE v1.1, 91,7% sur LVBench et 84,2% sur GraphWalks à 256K–1M de contexte. En parallèle, il est à la traîne par rapport aux modèles de frontière concurrents sur FrontierSWE v2, Terminal-Bench 4.0, Terminal-Bench Science et OSWorld-2.0.
Les résultats favorisent une lecture d’Argon spécifique à la charge de travail. Ses meilleurs scores se concentrent autour du travail professionnel de connaissance, des tâches à très long contexte et de certaines évaluations multimodales et de génie logiciel. D’autres modèles conservent des avantages sur plusieurs tests de terminal et d’usage de l’ordinateur.
Principaux enseignements
- Gemini 4 Argon est particulièrement performant pour le travail de connaissance en entreprise, le raisonnement à long contexte, la compréhension multimodale et plusieurs évaluations de codage à long horizon.
- Sa limite maximale de sortie d’1 million de tokens offre plus de marge pour des trajectoires de raisonnement longues ; il n’établit pas de spécification publique du contexte d’entrée.
- Argon est en tête sur plusieurs résultats publiés en travail de connaissance et long contexte, mais GPT-6 Astra et Claude Opus 5.5 restent en tête sur certaines évaluations de codage et d’utilisation de l’ordinateur.
- Les scores de benchmark décrivent des configurations spécifiques modèle+agent. Les métriques, les conditions d’entrée et les paramètres d’évaluation comptent autant que les pourcentages mis en avant.
- Le déploiement de Google et l’accès via CometAPI sont des annonces distinctes. Vérifiez la voie active, l’identifiant du modèle et l’éligibilité du compte avant de migrer du trafic.
Qu’est-ce que Gemini 4 Argon ?
Gemini 4 Argon est le nouveau modèle Gemini de frontière de Google DeepMind, conçu pour des workflows difficiles nécessitant un raisonnement en plusieurs étapes plutôt qu’une réponse à une courte invite.
Le positionnement officiel de Google met l’accent sur l’ingénierie logicielle réelle, le travail de connaissance en entreprise comme le juridique et la finance, la cybersécurité défensive, la compréhension multimodale et les tâches agentiques de longue durée.
C’est une distinction importante par rapport aux récentes versions Flash. La Gemini 3.8 Flash API dans CometAPI est conçue comme un « cheval de bataille » à moindre coût pour des charges agentiques à grande échelle. Argon représente plutôt l’extrémité de frontière de l’empilement de Google, privilégiant la profondeur et l’exécution soutenue.
Spécifications du modèle
| Spécification | Gemini 4 Argon |
|---|---|
| Développeur | Google DeepMind |
| Annonce | 30 septembre 2026 |
| Famille de modèle | Gemini 4 |
| Positionnement | Modèle de pointe pour le raisonnement et à long horizon |
| Sortie maximale | 1 000 000 tokens |
| Évaluation long contexte | Testé jusqu’à 256K–1M sur GraphWalks |
| Contexte d’entrée public | Non spécifié formellement dans une spécification API publique standard au lancement |
| Compréhension multimodale | Oui ; inclut graphiques, documents et évaluation sur longues vidéos |
| Codage agentique | Oui |
| Utilisation de l’ordinateur | Évaluée |
| Cybersécurité | Capacités défensives spécialisées |
| ID du modèle API publique Google | Non annoncé dans la documentation publique initiale ; CometAPI utilise gemini-4-argon comme identifiant de catalogue. |
Budget de sortie et compromis
Google annonce une limite maximale de sortie d’1 million de tokens pour Argon, en hausse par rapport à la limite précédente de 64K mentionnée dans son annonce de lancement. Cela offre une marge pour des trajectoires de raisonnement plus longues. Il ne faut pas l’interpréter comme un budget total garanti pour une session agent multi-appels, ni comme la preuve que chaque tâche s’améliorera.
Une sortie maximale n’est pas synonyme d’intelligence. Donner plus de tokens de sortie à un modèle ne le rend pas automatiquement plus capable ; cela supprime un goulot d’étranglement potentiel. Le modèle doit encore utiliser ce budget de manière productive.
Il existe aussi un compromis coût/latence. Un modèle qui génère effectivement des centaines de milliers de tokens peut être coûteux et lent, même si le prix par token nominal paraît attractif.

Résultats de benchmarks sélectionnés reproduits depuis l’article. Comparez les modèles au sein de chaque ligne ; les métriques et les conditions d’évaluation diffèrent. Ce graphique remplace l’œuvre décorative en dégradé et ne représente pas un test indépendant.
Une limite maximale de sortie et une fenêtre de contexte d’entrée décrivent des capacités différentes. La plage d’évaluation GraphWalks témoigne des entrées testées, ce n’est pas un substitut à une spécification API publique.
Comment Gemini 4 Argon se comporte-t-il sur les benchmarks ?
Le tableau de performances de Google DeepMind couvre des workflows agentiques, le travail professionnel de connaissance et des tâches multimodales. Les valeurs ci-dessous reproduisent cette comparaison publiée. Elles mesurent la performance à la tâche, pas le débit de tokens ni la latence de réponse ; « — » signifie qu’aucun résultat n’est rapporté dans cette comparaison.
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 | Conditions d’évaluation |
|---|---|---|---|---|---|
| Vals Index | 68,9% | 63,1% | 65,8% | 67,0% | Vals AI |
| AutomationBench | 51,3% | 41,4% | 31,4% | 42,5% | Ensemble privé ; classement Zapier |
| Vals Finance Agent v2 | 65,4% | 53,5% | 58,9% | 58,6% | Vals AI |
| Harvey's Legal Agent | 19,6% | 5,4% | 6,7% | 3,8% | Vals AI |
| DeepSWE v1.1 | 77,9% | 74,1% | 67,4% | 74,2% | mini-swe harness ; sources mixtes |
| FrontierSWE v2 | 55,0% | 65,5% | 56,3% | 62,3% | Classement Proximal |
| Vibe Code Bench | 91,9% | 89,6% | 90,3% | 90,3% | Classement Vals AI |
| Terminal-Bench 4.0 | 57,4% | 58,2% | 57,9% | 66,4% | Auto-test / classement |
| PostTrainBench | 45,3% | 44,3% | 40,2% | 49,3% | v1.1 ; OpenCode ; 10h ; un H100 |
| Terminal-Bench Science 0.1 | 57,6% | 68,1% | 52,6% | 63,3% | Timeout du vérificateur ×6 |
| LABBench 2 | 88,8% | 85,4% | 68,6% | 73,1% | Outils Linux ; internet |
| RiemannBench | 76,0% | 72,0% | 65,6% | 69,6% | Classement Surge |
| GraphWalks jusqu’à 128K | 99,7% | 98,7% | 91,4% | 90,6% | BFS F1 ; 650 éléments |
| GraphWalks 256K–1M | 84,2% | 71,8% | 65,0% | 66,8% | BFS F1 ; 200 éléments |
| Agent's Last Exam | 39,5% | 34,2% | — | 38,2% | Succès binaire ; ALE-Claw ; 5 h |
| OSWorld-2.0 | 69,2% | 72,6% | — | — | Score partiel hors ligne ; meilleur de 3 exécutions |
| Chartography | 71,6% | 71,0% | 46,2% | 66,3% | Sans outils ; classement Surge |
| LVBench | 91,7% | 87,5% | 79,7% | 83,7% | Sans outils ; échantillonnage de frames spécifique au modèle |
| CWE-bench v1 | 68,0% | 68,0% | 58,0% | 67,0% | pass@1 ; pass@4 départage les égalités |
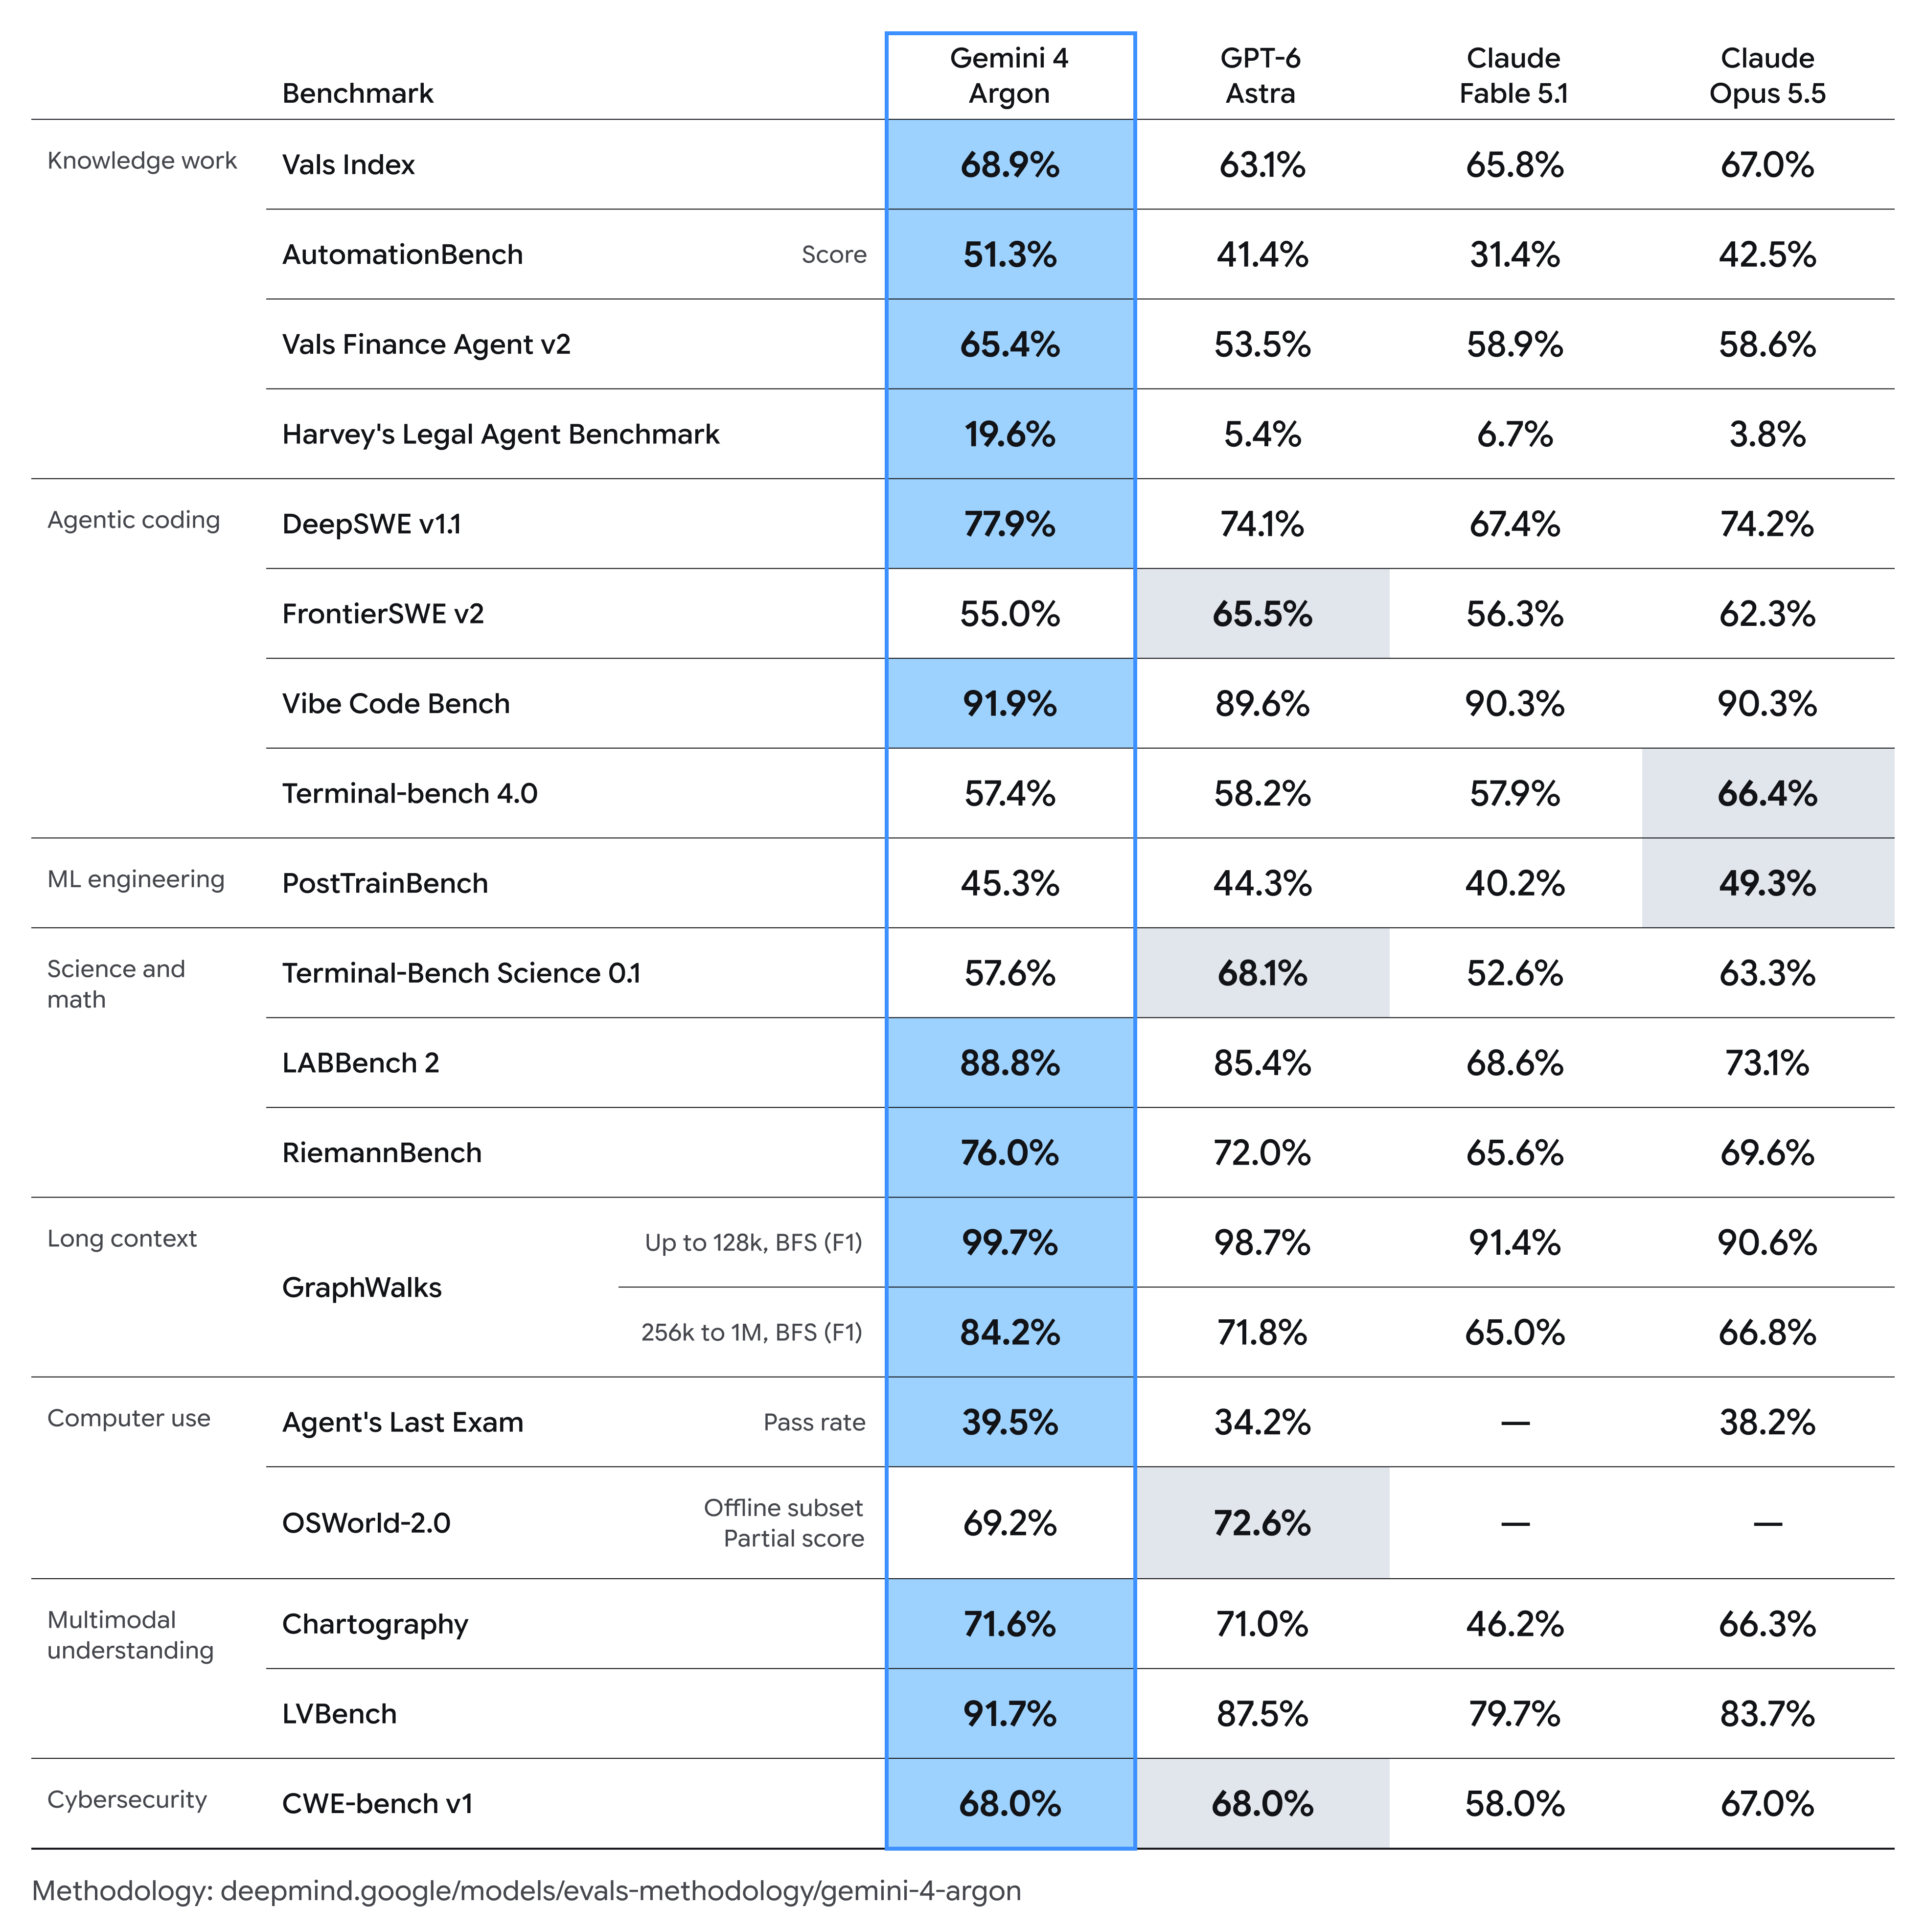
Comparaison officielle des benchmarks de Gemini 4 Argon par Google
Sauf mention contraire, les résultats d’Argon utilisent une seule tentative et le réglage de réflexion le plus élevé. Les résultats des autres modèles proviennent généralement des rapports des fournisseurs, avec des exceptions spécifiques aux benchmarks. LVBench utilise 1 FPS pour Gemini, 800 frames pour GPT-6 Astra, 300 pour Fable 5.1 et 600 pour Opus 5.5. Ces entrées ne sont pas identiques ; comparez donc les configurations rapportées plutôt que de considérer chaque ligne comme une reprise contrôlée.
Conditions d’évaluation et limites
Le tableau est utile, mais il ne doit pas être interprété comme un classement universel indépendant.
- La sélection des benchmarks est celle de Google.
- Les paramètres d’évaluation spécifiques aux benchmarks diffèrent d’une ligne à l’autre, incluant les frameworks d’agents, les budgets de temps, les outils et l’échantillonnage des entrées.
- La méthodologie officielle identifie les résultats des concurrents rapportés par les fournisseurs comme valeur par défaut, avec des exceptions spécifiques aux classements et des calculs propres.
- Le réglage de benchmark le plus élevé peut ne pas refléter une configuration d’inférence de production par défaut.
- Un score de benchmark mis en avant ne révèle pas l’usage des tokens, les appels d’outils, les réessais, le temps écoulé ni l’intervention humaine.
En production, une meilleure métrique est souvent le coût par tâche menée à bien plutôt que le prix par token ou un pourcentage de benchmark.
Pour quelles charges de travail Gemini 4 Argon est-il le mieux adapté ?
Performances en travail de connaissance
Le schéma le plus clair dans les résultats d’Argon apparaît dans le travail professionnel de connaissance en plusieurs étapes.
Sur Vals Index, Argon atteint 68,9%, contre 67,0% pour Claude Opus 5.5. L’écart numérique est modeste, mais le schéma devient plus évident dans des workflows spécialisés.
- Vals Finance Agent v2 : 65,4%, soit 6,5 points au-dessus du meilleur concurrent présenté dans le tableau de Google.
- AutomationBench : 51,3%, soit 8,8 points au-dessus de Claude Opus 5.5.
- Harvey's Legal Agent Benchmark : 19,6%, contre 6,7% pour le modèle suivant.
Le profil de performance suggère qu’Argon en bénéficie le plus lorsque le modèle doit collecter des informations, préserver l’état, raisonner sur plusieurs étapes et produire un artefact professionnel plutôt que répondre à une question fermée.
Le faible score absolu sur l’agent juridique est également important. Un score de 19,6% ne révèle pas à lui seul combien de critères ou de workflows complets ont échoué. La conclusion utile est qu’Argon montre une grande amélioration relative sur cette évaluation, sans établir pour autant une automatisation fiable du travail juridique.
Raisonnement à long contexte
L’avantage le plus marquant d’Argon pourrait être la version 256K–1M de GraphWalks.
- Gemini 4 Argon : 84,2%
- GPT-6 Astra : 71,8%
- Claude Opus 5.5 : 66,8%
- Claude Fable 5.1 : 65,0%
Cela représente un avantage de 12,4 points sur le modèle le plus proche dans la comparaison publiée.
L’écart est beaucoup plus faible à des longueurs de contexte plus courtes : sur GraphWalks jusqu’à 128K, Argon obtient 99,7% et GPT-6 Astra 98,7%. Cela suggère qu’Argon se dégrade moins fortement que les modèles comparés sur cette évaluation de très long contexte en particulier.
Google n’a pas divulgué suffisamment d’informations architecturales pour attribuer cette différence à un mécanisme d’attention spécifique, un système de récupération, une recette d’entraînement ou une stratégie à l’inférence. Des affirmations telles que « Gemini 4 introduit une nouvelle architecture d’attention » dépasseraient donc les preuves publiques.
Performances en codage
Le tableau officiel des benchmarks ne soutient pas une réponse simple.
Argon performe extrêmement bien sur certaines formes de codage et perd nettement sur d’autres. Sur DeepSWE v1.1, il atteint 77,9%, contre 74,2% pour Claude Opus 5.5 et 74,1% pour GPT-6 Astra. Son score Vibe Code Bench est également élevé à 91,9%.
- FrontierSWE v2 : 55,0% pour Argon contre 65,5% pour GPT-6 Astra.
- Terminal-Bench 4.0 : 57,4% pour Argon contre 66,4% pour Claude Opus 5.5.
- Terminal-Bench Science 0.1 : 57,6% pour Argon contre 68,1% pour GPT-6 Astra.
Cette scission est importante pour les développeurs. Argon semble particulièrement fort lorsque la programmation devient un long workflow d’ingénierie avec un contexte et une planification substantiels, tandis que l’exécution fortement axée terminal reste plus compétitive. Un benchmark de migration de référentiel et un benchmark de terminal interactif ne doivent pas être traités comme des mesures interchangeables de la « capacité de codage ».
Cybersécurité défensive
La cybersécurité est un domaine de déploiement clé. Le positionnement cybersécurité défensive de Google inclut la découverte autonome de vulnérabilités, la validation et le patching. Il s’agit d’une revendication de capacité du fournisseur ; le résultat sur CWE-bench ci-dessous mesure la remédiation des vulnérabilités sur sa propre évaluation.
Sur CWE-bench v1, Argon obtient 68%, à égalité avec GPT-6 Astra et légèrement devant Claude Opus 5.5 à 67%.
Google met également en avant des garde-fous plus solides contre les abus, l’injection indirecte d’invite, les comportements agentiques risqués et la compromission de l’environnement d’exécution. Argon est donc autant une sortie axée sur la sécurité des agents qu’une simple mise à niveau de modèle.
Compréhension multimodale
Argon obtient 71,6% sur Chartography et 91,7% sur LVBench pour la compréhension de longues vidéos. Le résultat LVBench est 4,2 points au-dessus de GPT-6 Astra dans le tableau de Google. Comme les modèles reçoivent des configurations d’échantillonnage de frames différentes, il s’agit d’une comparaison des configurations rapportées plutôt que d’un avantage purement lié au modèle.
Ceci est important car de nombreux workflows professionnels ne sont pas uniquement textuels. Un agent de recherche financière peut devoir inspecter un graphique ; un assistant d’entreprise peut combiner rapports, PDF et captures d’écran ; un système d’analyse vidéo peut devoir préserver des événements sur une longue séquence plutôt que de traiter des frames de manière indépendante.
La combinaison d’Argon entre perception multimodale et raisonnement soutenu est donc plus pertinente que la seule prise en charge multimodale.
Performances en sciences et mathématiques
Les résultats sont mitigés mais généralement solides. Argon atteint 88,8% sur LABBench 2 et 76,0% sur RiemannBench, devant les modèles comparés dans le tableau de Google. Cependant, sur Terminal-Bench Science 0.1, GPT-6 Astra atteint 68,1% contre 57,6% pour Argon.
Cette différence pointe vers un schéma plus large : Argon semble plus fort pour raisonner sur des informations scientifiques que pour chaque forme d’exécution scientifique pilotée par des outils.
Performances d’utilisation de l’ordinateur
Sur Agent's Last Exam, Argon obtient un taux de réussite binaire de 39,5%, devant GPT-6 Astra à 34,2% et Claude Opus 5.5 à 38,2%. Sur l’ensemble hors ligne d’OSWorld-2.0, son score partiel est de 69,2%, en dessous des 72,6% de GPT-6 Astra. La valeur OSWorld n’est pas un taux de réussite sur tâche complète, et l’absence d’entrées pour Claude ne signifie pas zéro capacité.
Les données actuelles ne montrent donc pas un avantage transversal en utilisation de l’ordinateur. Pour un déploiement en production, les scores de benchmark doivent être complétés par des tests au niveau des tâches sur la précision de navigation, les clics ratés, la fréquence de réessai, les actions non intentionnelles, le temps d’achèvement et le taux de correction humaine.
Gemini 4 Argon vs GPT-6 Astra et Claude
| Dimension | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|
| Travail de connaissance | Très fort | Fort | Très fort | Fort |
| Benchmark long contexte | Meilleur résultat publié | Fort | Modéré–fort | Modéré |
| Codage à long horizon | Très fort | Très fort | Très fort | Fort |
| Codage terminal | Compétitif | Fort | Meilleur sur certains tests | Compétitif |
| Agents scientifiques en terminal | Compétitif | Meilleur sur certains tests | Fort | Compétitif |
| Compréhension multimodale | Très fort | Très fort | Fort | Compétitif |
| Utilisation de l’ordinateur | Compétitif | Fort | Mixte / comparaison limitée | Comparaison limitée |
| Cybersécurité | À égalité en tête sur CWE-bench v1 | À égalité en tête | Très proche | Inférieure |
Argon se distingue dans cette comparaison pour le long contexte, les documents volumineux et le travail agentique professionnel. Les développeurs peuvent le comparer avec GPT-6 Astra, Claude Opus 5.5 et Claude Fable 5.1 via CometAPI.
Sélection basée sur les performances
Les libellés qualitatifs ci-dessus résument le tableau de benchmarks sélectionné, pas un classement universel. Favorisez Argon pour un pilote lorsque le travail ressemble à ses évaluations de tête ; testez Astra et Opus sur des charges fortement orientées terminal avant de sélectionner une valeur par défaut.
Spécifications et contraintes de déploiement
Cette comparaison de performances n’établit pas un avantage d’architecture ni un vainqueur général prix/performance. Le nombre de paramètres d’Argon et son architecture ne sont pas spécifiés dans les documents de lancement de Google examinés. Sa limite publique de contexte d’entrée nécessite une documentation API officielle. CometAPI indique une route gemini-4-argon ; confirmez ses paramètres pris en charge et l’accès au compte indépendamment du déploiement plus large de Google. Comparez les limites de chaque route et les coûts réels par tâche avant déploiement.
Comment les développeurs peuvent-ils accéder à Gemini 4 Argon via CometAPI ?
CometAPI signale le modèle comme disponible sous gemini-4-argon. Utilisez le tableau de bord du compte pour créer une clé API, sélectionnez cet identifiant dans le playground et exécutez une requête de test avant l’intégration. Son exemple compatible OpenAI utilise l’URL de base https://api.cometapi.com/v1. Confirmez l’endpoint et les paramètres pris en charge du modèle dans la documentation de votre compte ; un simple badge de catalogue ne confirme pas un appel réussi.
- Créez un compte CometAPI et générez une clé API dans le tableau de bord.
- Choisissez gemini-4-argon et validez une requête représentative dans le playground.
- Configurez le client compatible avec l’URL de base CometAPI, votre clé et l’identifiant du modèle ; confirmez le schéma de requête pris en charge et la facturation avant déploiement.
CometAPI et tarification officielle
Google a annoncé un tarif d’introduction de $2 par million de tokens d’entrée et $10 par million de tokens de sortie, avec des entrées mises en cache facturées 95% moins cher que le tarif d’entrée. Après la période d’introduction, les tarifs annoncés sont de $4 en entrée et $20 en sortie par million de tokens. Ce sont les tarifs annoncés par Google, pas les prix CometAPI ni la confirmation d’un accès API général immédiat.
| Base de facturation | API Gemini 4 Argon dans CometAPI | Annonce officielle de Google | Comparaison |
|---|---|---|---|
| Entrée / 1M tokens | $3,20 | $4,00 après la période d’introduction | 20% en dessous du tarif post-intro annoncé |
| Sortie / 1M tokens | $16,00 | $20,00 après la période d’introduction | 20% en dessous du tarif post-intro annoncé |
Conclusion
Le profil de benchmarks de Gemini 4 Argon est plus intéressant qu’une simple affirmation de classement.
Les meilleurs résultats dans cette comparaison se concentrent autour du travail professionnel de connaissance, du long contexte et d’une exécution agentique soutenue. Ce schéma est utile pour la sélection des charges de travail, mais n’identifie pas l’architecture sous-jacente ni ne prouve le mécanisme ayant causé les gains.
Les résultats rapportés en finance, juridique, longues vidéos et ingénierie logicielle soutiennent un pilote ciblé pour ces charges. La persistance du même avantage en production dépend du mix d’entrées, du framework d’agents, des réglages d’inférence et des exigences de vérification.
Dans le même temps, les résultats montrent que les performances des modèles de frontière deviennent de plus en plus spécialisées. Argon peut mener DeepSWE tout en étant derrière sur FrontierSWE ; mener Agent's Last Exam tout en étant derrière sur OSWorld ; et mener LABBench tout en étant derrière sur Terminal-Bench Science. Ces benchmarks sollicitent différentes parties d’un système agentique.
Pour les développeurs, la leçon la plus importante est que la sélection de modèles doit de plus en plus se faire au niveau de la charge de travail plutôt qu’au niveau de la marque ou de la famille.
FAQ
Comment les développeurs doivent-ils valider Gemini 4 Argon sur leurs propres charges de travail ?
Construisez un ensemble de tâches représentatif avec des critères d’acceptation explicites. Gardez comparables, entre modèles, les outils, limites de temps, préparation des entrées et politiques de réessai. Enregistrez les tâches menées à bien, le total de tokens, le temps écoulé et les corrections humaines. Commencez par un petit pilote et examinez les cas d’échec avant d’acheminer du trafic de production.
Les pourcentages de benchmark de Gemini 4 Argon peuvent-ils être moyennés en un seul score ?
Non. Le tableau combine différentes métriques, incluant F1, taux de réussite et scores partiels. Utilisez des critères spécifiques à la tâche plutôt que de faire la moyenne de tous les pourcentages.
Un agent Gemini 4 Argon doit-il toujours utiliser tout son budget de sortie ?
Non. Choisissez le plus petit budget testé qui répond à vos exigences de qualité et de fiabilité. La limite maximale de sortie est un plafond, pas une cible.
Comment les équipes doivent-elles évaluer l’accès à Gemini 4 Argon via CometAPI ?
Commencez par une vérification de disponibilité au niveau du compte et une petite requête en utilisant la route CometAPI documentée. Mesurez la qualité de réponse, la latence, les limites et les tokens facturés, puis appliquez les mêmes tests d’acceptation utilisés pour les modèles alternatifs. Traitez l’annonce d’accès CometAPI séparément du déploiement plus large de Google, et gardez le routage configurable jusqu’à ce que la route réponde à vos exigences.