

TL;DR
Le niveau gratuit de l’API Gemini est disponible en octobre 2026 pour certains modèles, notamment Gemini 3.8 Flash, Gemini 3.6 Flash, Gemini 3.5 Flash‑Lite et Gemini 3.1 Flash‑Lite. Vous pouvez commencer sans configurer la facturation, mais le quota disponible pour votre projet détermine ce que vous pouvez réellement exécuter.
Commencez avec Gemini 3.8 Flash pour des expériences exigeantes de programmation et de raisonnement, ou avec un modèle Flash‑Lite pour l’extraction et la classification de routine. Avant d’utiliser de véritables données client, vérifiez les conditions d’utilisation des données applicables. Si vous avez besoin de capacité payante, comparez les tarifs natifs de Google à l’accès facturé séparément de CometAPI.
Points clés
- Gemini 3.8 Flash est la toute dernière option Flash abordée ici, avec entrée multimodale et effort de raisonnement réglable.
- Gemini 3.6 Flash reste une option prise en charge pour les intégrations existantes ; Gemini 3.5 Flash‑Lite et Gemini 3.1 Flash‑Lite visent des charges plus légères.
- Gemini 4 Argon nécessite un accès API payant. Sa disponibilité gratuite dans un autre produit Google n’implique pas son éligibilité gratuite via l’API.
- Vérifiez les quotas dans AI Studio. La fenêtre de contexte d’un modèle est différente des allocations de requêtes et de jetons de votre projet.
- Comparez les voies d’accès. Le quota gratuit de Google et les prix, crédits et limites de compte de CometAPI sont distincts.
L’API Gemini est-elle gratuite en 2026 ?
Google offre des jetons d’entrée et de sortie gratuits pour certains modèles de l’API Gemini, sous réserve de quotas au niveau du projet. Vous pouvez commencer sans activer la facturation. Il s’agit d’un niveau gratuit basé sur des quotas, et non d’un crédit promotionnel unique.
Il est important de distinguer Google AI Studio, l’API Gemini et les abonnements grand public à Gemini, qui sont des parcours d’accès distincts. La disponibilité d’un modèle dans une interface ne garantit pas son accès gratuit via une autre.
Quels modèles Gemini API sont gratuits en octobre 2026 ?
Les quatre modèles ci-dessous constituent des points de départ utiles pour des applications texte et multimodales. Il ne s’agit pas d’une liste exhaustive de tous les points de terminaison éligibles à la gratuité. Suivez les liens des modèles pour explorer l’accès via CometAPI ; les spécifications Google sont liées sous le tableau.
Les quatre acceptent des entrées texte, image, vidéo, audio et PDF, et produisent du texte. Leur limite d’entrée publiée est de 1 048 576 jetons, avec jusqu’à 65 536 jetons de sortie. Ces limites de modèle ne garantissent pas que votre projet gratuit puisse envoyer une requête de cette taille.
Audio, embeddings et génération d’images : accès et limites
Google indique également un accès gratuit pour certains modèles spécialisés, tels que Gemini 3.8 Live, Gemini 3.8 Flash TTS et Gemini Embedding 2. Vérifiez l’entrée tarifaire du modèle et du point de terminaison exacts avant d’intégrer : comprendre une image ou un clip audio est une capacité différente de la génération d’une image ou d’une réponse vocale.
Les méthodes API, formats de requête et limites varient selon la capacité. Consultez la documentation du modèle et de l’opération spécifiques que vous prévoyez d’utiliser.
L’accès gratuit ne s’étend pas à chaque modèle Gemini ni à chaque point de terminaison de génération. Gemini 4 Argon nécessite un accès API payant, tandis que les points de terminaison premium de génération d’images et de vidéos ont leurs propres règles d’éligibilité. Avant d’intégrer une fonctionnalité, vérifiez le modèle et l’opération exacts plutôt que de supposer qu’ils partagent la même allocation gratuite.
Quelle est la performance de Gemini 3.8 Flash ?
L’évaluation publiée par Google compare Gemini 3.8 Flash à Gemini 3.7 Flash et à d’autres modèles. Elle indique 73.7 % sur DeepSWE v1.1, contre 65.3 % pour 3.7 Flash — soit une augmentation de 8.4 points de pourcentage. Sur HLE‑Verified, le score rapporté passe de 53.6 % à 54.9 %.
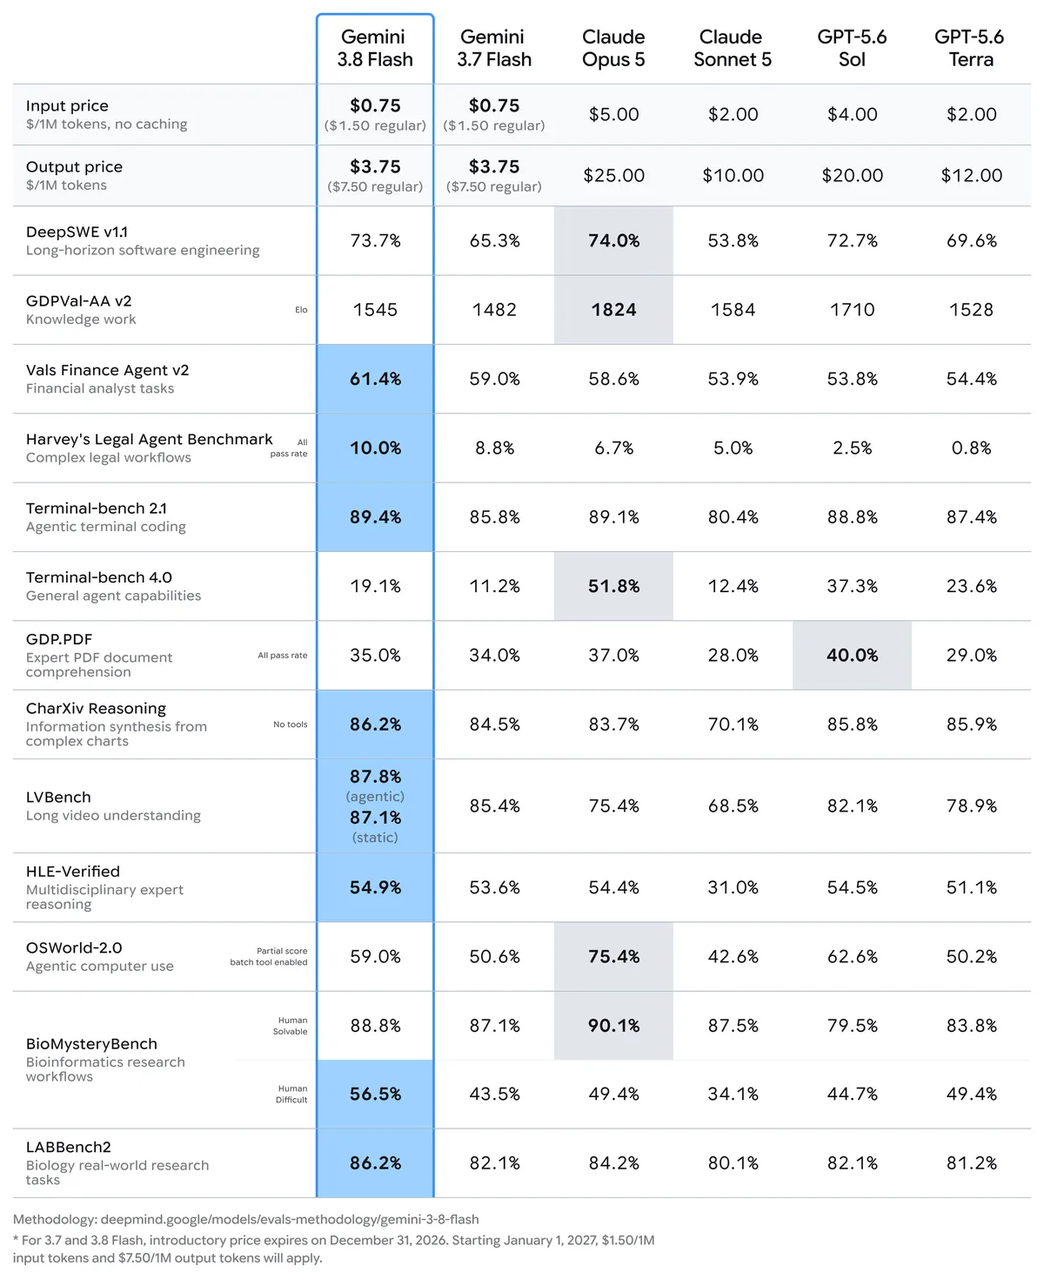
Utilisez ces résultats pour choisir un modèle à tester, puis évaluez‑le sur des exemples de votre propre application. Pour un extracteur de documents, les champs corrects et la stabilité du format de sortie peuvent compter davantage qu’un benchmark de programmation. Pour un assistant de programmation, mesurez si la modification proposée fonctionne, combien de temps elle prend et combien de jetons elle consomme.
Quelles sont les limites de débit du niveau gratuit de l’API Gemini en 2026 ?
La plus grande idée reçue concernant le niveau gratuit de Gemini est que chaque compte reçoit le même nombre fixe de requêtes.
Ouvrez Google AI Studio, choisissez le projet derrière votre clé API et examinez les limites actives pour le modèle sélectionné. Le guide des limites de débit de Google explique les dimensions de quota ; le tableau de bord affiche l’allocation qui s’applique à votre compte.
- RPM (requests per minute) : limite le nombre de requêtes que vous pouvez envoyer chaque minute. Surveillez les courtes rafales et les workers parallèles qui envoient trop de requêtes simultanément.
- TPM (input tokens per minute) : limite le volume de jetons d’entrée que vous pouvez envoyer chaque minute. De grandes invites, des historiques de conversation et des documents peuvent consommer cette allocation même lorsque le nombre de requêtes est faible.
- RPD (requests per day) : limite votre nombre total de requêtes quotidiennes. Planifiez votre charge en fonction de l’allocation quotidienne et de son heure de réinitialisation.
Une limite d’entrée d’un million de jetons décrit la taille maximale d’entrée prise en charge par le modèle. Elle ne garantit pas qu’un projet au niveau gratuit dispose d’une capacité TPM suffisante pour soumettre un million de jetons en une seule requête. La capacité de contexte et la capacité de limites de débit doivent être évaluées séparément.
Les quotas de requêtes quotidiens se réinitialisent à minuit, heure du Pacifique. Plusieurs clés dans un même projet partagent ses limites d’usage, donc créer une autre clé n’ajoute pas de capacité. D’autres limites peuvent s’appliquer à des modèles ou opérations spécialisés.
Gérer les erreurs 429 de l’API Gemini
Lisez le corps de l’erreur avant de réessayer. Dans l’API Interactions actuelle, un 429 peut distinguer une limite de requêtes ou de jetons de court terme d’un quota quotidien épuisé. Pour une limite de court terme, ralentissez la file et utilisez un backoff exponentiel avec jitter. Pour un épuisement quotidien, attendez la réinitialisation ou modifiez le plan de capacité de l’application. Un 503 signale une indisponibilité temporaire du service. Voir la référence des erreurs d’API de Google.
Comment comparer les prix de Google et CometAPI ?
Quand la facturation de l’API Gemini commence-t‑elle ?
Épuiser votre quota gratuit ne bascule pas automatiquement votre projet vers une utilisation payante. Sans compte de facturation actif, les requêtes qui dépassent l’allocation gratuite disponible rencontrent des restrictions d’accès ou de capacité au lieu de frais standards de jetons payants.
Pour utiliser une capacité payante, vous devez lier la facturation. Si votre compte est assigné à un forfait prépayé, vous devez également ajouter des crédits, à partir de 5 $ ou de l’équivalent local. Vérifiez votre forfait assigné et les contrôles de dépenses dans AI Studio avant de mettre à niveau. Les soldes et la comptabilisation de l’utilisation peuvent se mettre à jour avec un délai, ainsi un solde prépayé affiché n’est pas un seuil de dépense instantané.
Le crédit de bienvenue Cloud de 300 $ de Google est distinct du niveau gratuit de l’API Gemini. Les comptes ouverts après le 2 mars 2026 ne peuvent pas utiliser ce crédit pour des frais de l’API Gemini ou d’AI Studio. Consultez le guide de facturation pour connaître les règles qui s’appliquent à votre compte.
Prix des jetons chez Google et CometAPI
Le tableau compare les prix standard de jetons chez Google aux tarifs publiés de CometAPI vérifiés le 26 octobre 2026. Tous les montants sont en USD par million de jetons ; la sortie inclut le raisonnement facturable le cas échéant. Les entrées et sorties gratuites de Google ne s’appliquent qu’aux requêtes éligibles à l’intérieur de l’allocation du projet.
Les prix introductifs Flash de Google ci‑dessus se terminent le 31 décembre 2026 ; 3.8 Flash et 3.6 Flash passent alors à 1,50 $ en entrée et 7,50 $ en sortie. Le prix de lancement d’Argon se termine le 30 novembre 2026, après quoi il devient 4 $ en entrée et 20 $ en sortie. Les tarifs CometAPI doivent être vérifiés indépendamment lorsque ces promotions évoluent. Les outils, la mise en cache, le stockage, les taxes et d’autres services peuvent engendrer des frais supplémentaires.
Un petit exemple de charge de travail
Supposons que vous envoyiez 1 000 requêtes texte, chacune avec 2 000 jetons d’entrée et 500 jetons de sortie. Cela représente deux millions de jetons d’entrée et un demi‑million de jetons de sortie. Aux tarifs ci‑dessus, Gemini 3.8 Flash coûte 3,375 $ via Google, soit environ 3,38 $, et 2,70 $ via CometAPI. Une charge éligible au niveau gratuit de Google coûte 0 $ uniquement si elle tient dans les quotas disponibles. Ce sont des estimations de coût en jetons, pas des factures mesurées.
Comment commencer à utiliser le niveau gratuit de l’API Gemini ?
Vous avez besoin d’un compte Google et d’une région éligibles, d’une clé API et d’un environnement Python avec pip disponible. L’exemple ci‑dessous suit le guide de démarrage actuel de Google et utilise l’API Interactions.
Créer une clé et installer le SDK
Dans Google AI Studio, copiez ou créez une clé API pour un projet qui n’a pas activé la facturation payante. Installez le SDK, puis définissez la clé dans votre environnement de terminal. Conservez la clé sur votre serveur plutôt que de l’intégrer dans du code côté navigateur.
pip install -U google-genai
Sur macOS ou Linux :
export GEMINI_API_KEY="your_api_key"
Sous Windows PowerShell :
$env:GEMINI_API_KEY="your_api_key"
Envoyer une requête et vérifier le résultat
from google import genai

client = genai.Client()
interaction = client.interactions.create(
    model="gemini-3.8-flash",
    input="Explain vector databases in 100 words."
)
print(interaction.output_text)
Enregistrez ceci dans un fichier Python et exécutez‑le depuis le même environnement. Une requête réussie affiche une courte explication. Ensuite, vérifiez le tableau de bord d’utilisation d’AI Studio pour confirmer le projet et le modèle recevant le trafic. En cas d’échec, inspectez le code d’erreur et vérifiez la clé, l’accès au modèle, le quota et l’état de facturation avant de modifier le code.
Comment les développeurs peuvent-ils accéder aux modèles de l’API Gemini via CometAPI ?
CometAPI propose une voie d’accès distincte pour les modèles Gemini pris en charge et d’autres fournisseurs d’IA.
Choisissez cette voie lorsqu’une interface partagée entre fournisseurs simplifie votre application. Utilisez une clé CometAPI avec son point de terminaison, puis vérifiez l’ID de modèle pris en charge et les limites de compte. Le quota gratuit de Google ne se transfère pas vers ce service. L’exemple suivant utilise l’interface compatible OpenAI documentée par CometAPI.
pip install -U openai
Définissez COMETAPI_KEY dans votre environnement en utilisant la même méthode spécifique au shell présentée ci‑dessus, puis exécutez :
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)
response = client.chat.completions.create(
    model="gemini-3.8-flash",
    messages=[{
        "role": "user",
        "content": "Summarize the benefits of RAG."
    }]
)
print(response.choices[0].message.content)
Avant le déploiement, confirmez que l’ID de modèle visé est pris en charge par votre compte CometAPI. Les identifiants natifs Google et les alias spécifiques au fournisseur ne sont pas garantis comme correspondant pour chaque modèle.
Quelles restrictions de confidentialité s’appliquent au niveau gratuit de l’API Gemini ?
Selon les Conditions supplémentaires du service Gemini API de Google, les invites et sorties des services non payants peuvent être utilisées pour améliorer les produits Google, et des évaluateurs humains peuvent les examiner. N’envoyez pas d’informations sensibles, confidentielles ou personnelles aux services non payants. Les services API payants ont des règles d’utilisation des données différentes.
Les règles régionales comptent : les dispositions d’utilisation des données des services payants s’appliquent à certaines utilisations non payantes dans l’EEE, en Suisse et au Royaume‑Uni, mais rendre un client API disponible pour des utilisateurs dans ces régions exige des Services payants. Ce sont des conditions distinctes. Vérifiez les conditions en vigueur pour vos utilisateurs et votre déploiement avant la mise en production.
Comment optimiser l’utilisation du niveau gratuit de l’API Gemini ?
Construisez autour du quota que vous avez mesuré. Conservez un petit ensemble de tâches représentatives et enregistrez la réussite des tâches, la latence, les jetons d’entrée et de sortie, ainsi que les réessais. Modifiez ensuite une partie de la charge à la fois :
- Aiguiller selon la difficulté. Testez Flash‑Lite sur l’extraction de routine et utilisez un modèle plus grand uniquement là où il améliore le résultat.
- Réduire l’entrée. Envoyez la section de document pertinente et l’historique de conversation nécessaire au lieu de tout renvoyer à chaque fois.
- Contrôler la génération. Demandez une longueur de sortie utile et ajustez l’effort de raisonnement uniquement là où le modèle et l’API le permettent.
- Réutiliser le travail. Stockez les résultats d’application répétés et vérifiez l’éligibilité à la mise en cache spécifique au modèle avant de supposer que la mise en cache de l’API est gratuite.
- Maîtriser la concurrence. Placez les workers derrière une file partagée afin que les tâches indépendantes ne créent pas une rafale évitable.
Enfin, surveillez la qualité autant que la consommation. Un modèle moins cher qui échoue fréquemment ou nécessite plusieurs tentatives peut générer plus de travail qu’un modèle légèrement plus coûteux qui réussit dès la première requête.
Une métrique interne utile est :
Coût effectif par tâche réussie = Coût total d’inférence / Nombre de tâches réussies
Pour les expérimentations au niveau gratuit, une autre métrique opérationnelle est le nombre de tâches réussies par fenêtre de quota disponible.
FAQ
Comment savoir si un problème de quota est dû à des rafales de requêtes ou à de gros documents ?
Comparez les horodatages des échecs avec le nombre de requêtes et le volume de jetons d’entrée. Une rafale de courtes invites pointe vers la fréquence des requêtes ; quelques longs documents peuvent épuiser la capacité en jetons même avec un faible RPM. Dans l’API Interactions, inspectez le code d’erreur lisible par machine et distinguez l’épuisement du quota quotidien d’une limite de court terme. Journalisez l’utilisation de jetons et la concurrence des workers ensemble pour pouvoir modifier la partie pertinente de la file.
Que faire si une requête expire après son envoi ?
Un délai d’expiration n’indique pas toujours si une opération distante s’est terminée. Pour une interaction dont vous disposez de l’ID, vérifiez son état avant de lancer une autre tâche coûteuse. Ajoutez un ID de tâche au niveau de l’application à votre workflow et dédupliquez les actions en aval, en particulier les e‑mails, les écritures en base de données et les appels d’outils. Une relance de génération de texte ne doit pas répéter silencieusement une action métier. La documentation Interactions de Google décrit la récupération d’interactions et les états d’exécution.
Comment comparer Flash et Flash‑Lite pour l’extraction de documents ?
Utilisez les mêmes documents, champs requis et règles d’acceptation pour les deux modèles. Incluez des scans bruyants, des champs manquants et des valeurs ambiguës. Notez l’exactitude factuelle des champs et la validité de la sortie, puis comptez les réessais et corrections manuelles. Un modèle qui produit moins de jetons peut tout de même consommer plus d’efforts si ses erreurs nécessitent une autre requête. Conservez un ensemble de documents en réserve afin que les changements d’invite ne soient pas jugés uniquement sur des exemples déjà ajustés.
Que faut-il vérifier avant de basculer une application de Google vers CometAPI ?
Testez exactement le point de terminaison, l’ID de modèle, le format des messages et les fonctionnalités utilisés par votre application. Une requête de type chat‑completions compatible n’établit pas un support identique pour les fichiers, outils, mise en cache ou paramètres de raisonnement. Comparez les champs d’usage renvoyés et la gestion des erreurs ainsi que la réponse textuelle, et examinez les politiques de données de l’intermédiaire et du fournisseur amont. Commencez par une petite charge non sensible avant de déplacer le reste de votre trafic.
Comment garder une intégration stable lorsque les modèles et les prix évoluent ?
Conservez les IDs de modèles, paramètres de point de terminaison et hypothèses de prix dans la configuration. Enregistrez le modèle et la date avec les résultats d’évaluation, surveillez les avis de dépréciation et relancez des tâches représentatives avant de changer de modèle. Définissez des alertes budgétaires et réexaminez les tarifs promotionnels avant leurs dates de fin. Gardez une solution de repli testée pour les charges essentielles plutôt que de supposer qu’un quota gratuit ou un alias de modèle particulier restera disponible indéfiniment.
Conclusion
Le niveau gratuit de l’API Gemini est un moyen utile de valider une application avant de payer pour la capacité. Choisissez un modèle adapté à la tâche, mesurez le quota disponible pour votre projet et vérifiez les règles d’utilisation des données avant d’utiliser des entrées de production.
Pour une première expérience, faites une petite requête et confirmez‑la dans AI Studio. Puis mesurez une charge représentative. Si la capacité gratuite devient la contrainte, comparez l’API payante de Google avec CometAPI en utilisant les mêmes invites, exigences de qualité et coûts de jetons complets.