
TL;DR
Commencez par GPT-6.1 Sol si vous utilisez déjà les outils Responses d’OpenAI ou si vous avez besoin de son échelle explicite d’effort de raisonnement ; testez Claude Sonnet 5.5 pour l’itération de code bien cadrée et des livrables professionnels pilotés par des modèles. Ce sont des priorités d’évaluation, pas un classement de qualité établi. Les deux commencent à $2/M en entrée et $10/M en sortie et facturent $0.10/M pour les lectures de cache de base. Avec environ 1M de contexte et 128K de sortie maximale standard, les différences pratiques portent sur l’intégration, le comportement des tâches, la rétention du cache et la facturation en long contexte plutôt que sur une remise sur la lecture de cache de base.
Le compromis clé concerne le comportement des tâches et les conditions de facturation. GPT-6.1 Sol utilise cinq niveaux d’effort et requiert Responses pour l’appel d’outils ; Sonnet 5.5 utilise une réflexion adaptative. Au‑delà de 272K jetons d’entrée, GPT-6.1 Sol applique des tarifs plus élevés à la requête Standard complète. Les sources examinées ici n’établissent pas de vainqueur par comparaison contrôlée de versions strictement appariées, choisissez donc le modèle qui satisfait vos critères d’acceptation au coût total de workflow le plus faible.
Key Takeaways
- Tarifs de base identiques : les deux modèles facturent $2/M en entrée, $10/M en sortie et $0.10/M pour les lectures de cache. Comparez les écritures de cache, la rétention, les paliers long contexte et l’usage effectivement facturé.
- Contexte proche : 1,05M contre 1M de jetons ; les deux supportent 128K de sortie maximale standard.
- Intégration différente : GPT-6.1 Sol requiert Responses pour l’appel d’outils et n’accepte pas none ou minimal ; Sonnet 5.5 utilise une réflexion adaptative et des contraintes d’outils spécifiques au modèle.
- Conservez des preuves spécifiques à la version : les scores de GPT-6 Sol ne peuvent pas être requalifiés en résultats de GPT-6.1 Sol.
- Choisissez selon le travail achevé : mesurez la qualité, la latence, les réessais, les écritures et lectures de cache, les frais d’outils et la correction humaine.
GPT-6.1 Sol vs Claude Sonnet 5.5 at a Glance
| Facteur de décision / spécification | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| Fournisseur | OpenAI | Anthropic |
| Date de sortie | September 29, 2026 | September 28, 2026 |
| ID du modèle | gpt-6.1-sol | claude-sonnet-5-5 |
| Contexte / sortie maximale standard | 1,050,000 / 128,000 jetons | 1,000,000 / 128,000 jetons |
| Entrée → sortie | Texte et images → texte | Texte et images → texte |
| Contrôles de raisonnement | low, medium, high, xhigh, max ; medium par défaut | Réflexion adaptative ; high par défaut sur Claude Platform |
| Effort par défaut | medium | high sur Claude Platform |
| Date de coupure des connaissances | April 30, 2026 | June 2026 |
| Tarifs officiels base entrée / sortie 1M | $2 / $10 ; Requêtes Standard jusqu’à 272K jetons d’entrée | $2 / $10 |
| Lectures de cache de base officielles 1M | $0.10 | $0.10 |
| Écritures de cache de base officielles 1M | $2.50 | $2.50 pour 5 minutes ; $4.00 pour 1 heure |
| Tarification long contexte | Au‑delà de 272K en entrée : $4 entrée, $0.20 lecture cache, $5 écriture cache, $15 sortie par 1M ; s’applique à toute la requête Standard | Pas de surcoût équivalent indiqué dans l’aperçu du modèle cité |
| Positionnement principal | Codage complexe, utilisation de l’ordinateur et travail professionnel | Itération de code rapide et workflows professionnels |
| À tester en premier lorsque | Vous utilisez déjà les outils Responses ou avez besoin de contrôles d’effort explicites | Votre travail se concentre sur le code, les documents, les diapositives ou les feuilles de calcul |
| Preuves et limites de décision | Capacités documentées ; aucun vainqueur numérique de version strictement appariée n’est établi ici | Résultats publiés en codage et travail de connaissance ; pas de victoire contrôlée sur GPT-6.1 Sol |
GPT-6.1 Sol Overview
GPT-6.1 Sol est la version Sol d’OpenAI du 29 septembre 2026 pour le codage complexe, l’utilisation de l’ordinateur et le travail professionnel. OpenAI le décrit comme ayant une performance proche d’Astra à moindre coût ; ce positionnement doit être validé sur vos tâches. Son large contexte et son raisonnement ajustable en font un candidat pour des agents de dépôt et des workflows professionnels multi‑étapes.
Ses contraintes opérationnelles comptent autant que son positionnement : medium est l’effort par défaut, low est le niveau le plus bas pris en charge, et l’appel d’outils requiert Responses. Un workflow basé sur une voie sans raisonnement ou sur les outils de Chat Completions nécessite une migration avant de pouvoir utiliser ce modèle de manière fiable.
Claude Sonnet 5.5 Overview
Claude Sonnet 5.5 est la version du 28 septembre 2026 d’Anthropic pour le codage quotidien bien cadré, les agents et le travail professionnel. Son aperçu de modèle documente la réflexion adaptative, un effort par défaut élevé sur Claude Platform, l’entrée texte‑et‑image et 128K de sortie maximale standard. Anthropic met en avant la correction de bogues, des documents clairs, des diapositives soignées et une itération efficace.
Pour une équipe de développement, cela fait de Sonnet un candidat utile pour des cycles répétés d’implémentation et de revue. Pour un workflow bureautique, évaluez sa qualité de premier jet et le respect des modèles. La revendication de vitesse du fournisseur compare Sonnet 5.5 à Sonnet 5 ; elle n’établit pas un avantage de vitesse sur GPT-6.1 Sol.
GPT-6.1 Sol vs Claude Sonnet 5.5: Performance
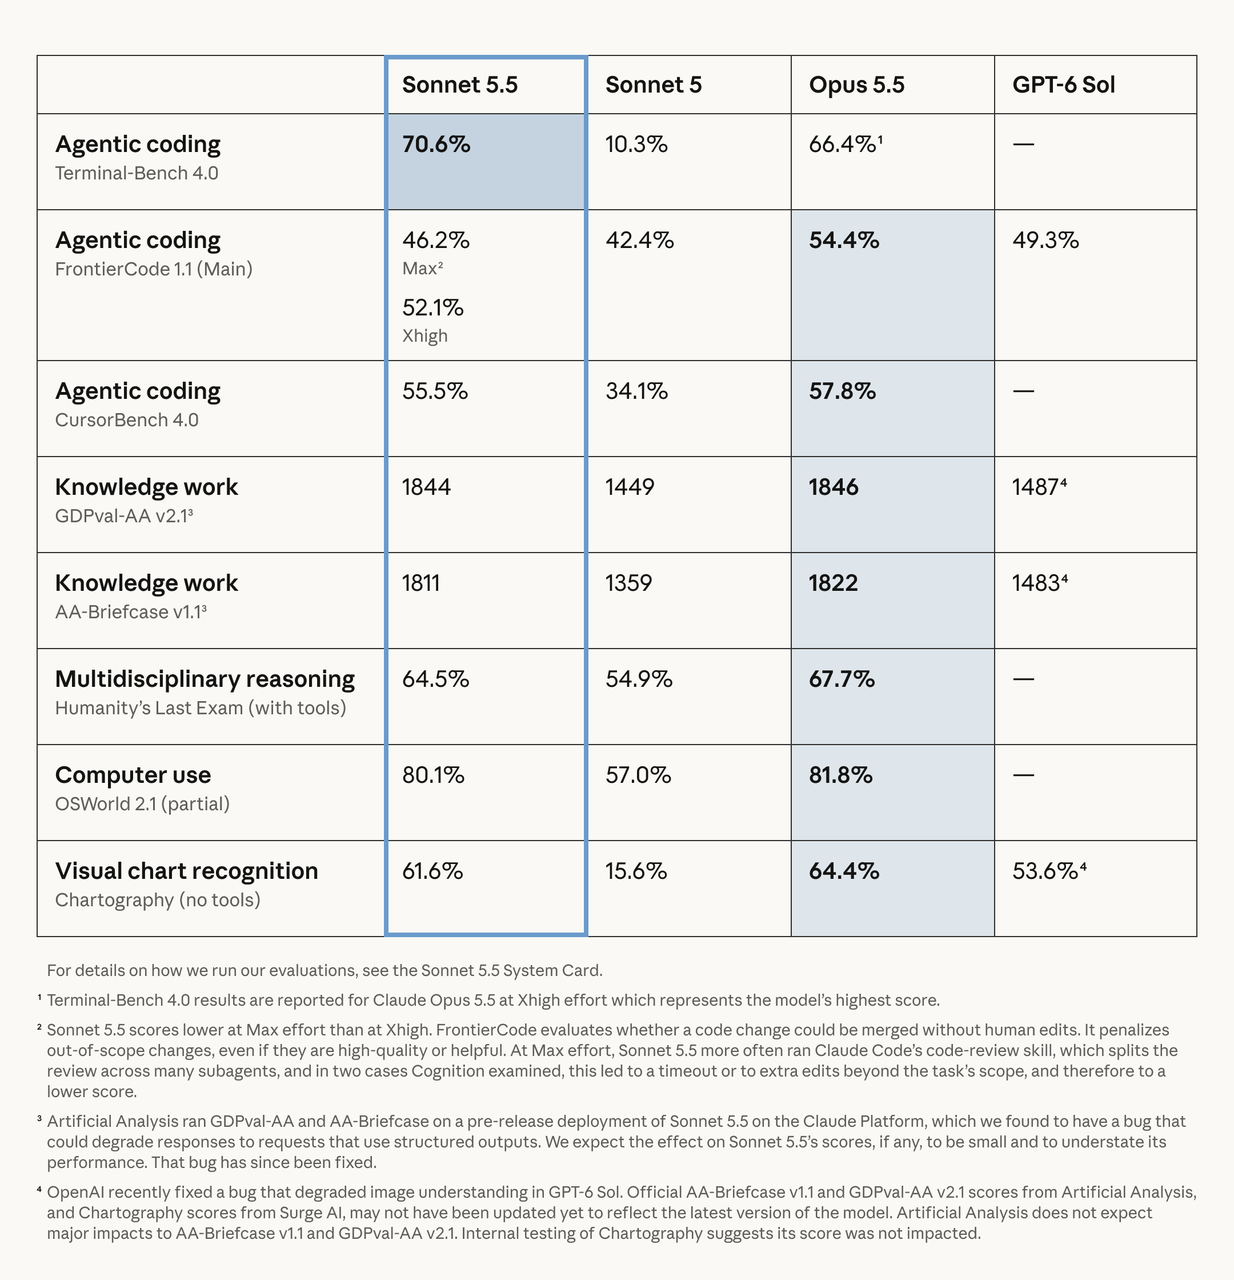
Les résultats de lancement de Sonnet 5.5 par Anthropic fournissent un ensemble utile de signaux par charge de travail. Sa comparaison inclut l’ancien GPT-6 Sol, donc ces valeurs de la colonne OpenAI sont exclues du tableau des modèles actuels ci‑dessous. « Non établi » signifie que les sources citées ne permettent pas une note pour cette version exacte ; cela ne signifie pas zéro performance.
| Benchmark / conditions | GPT-6.1 Sol | Claude Sonnet 5.5 | Ce que cela mesure |
|---|---|---|---|
| Terminal-Bench 4.0 | Non établi ici | 70.6% | Tâches de codage en terminal |
| FrontierCode 1.1 Main | Non établi ici | 52.1% Xhigh ; 46.2% Max | Modifications fusionnables de dépôt |
| CursorBench 4.0 | Non établi ici | 55.5% | Développement agentique façon Cursor |
| GDPval-AA v2.1 | Non établi ici | 1844 | Travail de connaissance professionnel |
| AA-Briefcase v1.1 | Non établi ici | 1811 | Travail de connaissance sur long horizon |
| Humanity’s Last Exam, tools | Non établi ici | 64.5% | Raisonnement pluridisciplinaire |
| OSWorld 2.1, partiel | Non établi ici | 80.1% | Récompense partielle d’utilisation d’ordinateur |
| Chartography, sans outils | Non établi ici | 61.6% | Reconnaissance de graphiques visuels |
Conditions de test : l’effort et le harnais agent influencent les résultats en codage. GDPval-AA et AA-Briefcase sont des évaluations Artificial Analysis, tandis que les résultats Chartography proviennent de Surge AI. Anthropic mentionne un bogue de sortie structurée corrigé ultérieurement dans le déploiement pré‑release de Sonnet qui a pu sous‑estimer légèrement ses résultats en travail professionnel. Utilisez le lien vers la System Card de l’annonce pour les environnements de test et la méthodologie complète ; ne combinez pas des métriques hétérogènes en un classement global.
L’image d’origine d’Anthropic ci‑dessous inclut les notes de bas de page de l’évaluation. Sa colonne GPT-6 Sol est un contexte historique et ne rapporte pas les performances de GPT-6.1 Sol.
Agentic Coding and Software Engineering
Sonnet 5.5 dispose de preuves publiées sur le codage en terminal, les changements de code fusionnables et les tâches d’agent type IDE. GPT-6.1 Sol est documenté pour le codage complexe et s’intègre à l’écosystème d’outils OpenAI. Ni le positionnement produit ni le score d’un prédécesseur n’établissent un vainqueur actuel en codage. Pour une évaluation utile, choisissez de vrais changements avec tests de régression et demandez aux réviseurs d’évaluer la portée, la maintenabilité et l’état de préparation à la fusion.
Knowledge Work, Reasoning, Math, and Science
Les résultats GDPval-AA et AA-Briefcase de Sonnet font des rapports, analyses et livrables bureautiques des cibles d’évaluation pertinentes. GPT-6.1 Sol vise aussi le travail professionnel, mais les sources utilisées ici n’offrent pas de comparaison appariée entre ces modèles. Utilisez vos propres modèles de documents, feuilles de calcul et présentations. Les affirmations en mathématiques avancées et en sciences nécessitent des preuves spécifiques à la tâche plutôt qu’une extrapolation depuis des contrôles de raisonnement génériques.
Computer Use, Browser Automation, and Multimodal Workflows
Les deux modèles acceptent des images, ce qui permet le débogage par captures d’écran et l’analyse visuelle. Les résultats OSWorld et Chartography de Sonnet sont des preuves pour ces évaluations particulières. GPT-6.1 Sol documente l’utilisation de l’ordinateur via les outils Responses. Testez le workflow complet : précision de navigation, récupération après un appel d’outil raté, exactitude de sortie et temps jusqu’à l’achèvement. L’entrée texte‑et‑image ne garantit pas à elle seule une intégration identique à l’usage ordinateur.
Independent Evaluation and Evidence Quality
Un tableau publié par un fournisseur peut contenir des résultats tiers sans constituer une expérience contrôlée unique. Pour toute comparaison indépendante, consignez les ID de modèle exacts, les dates de déploiement, l’effort, les outils, les garde‑fous, le délai d’expiration, la politique de réessai et les règles d’arrêt. Un indice d’intelligence agrégé, un taux de réussite en codage et un score de récompense partielle en usage d’ordinateur répondent à des questions différentes. Les sources examinées n’établissent pas un ensemble complet de résultats indépendants appariés pour cette paire exacte.
GPT-6.1 Sol vs Claude Sonnet 5.5: Cost
Official API Pricing
| Métrique de tarification | Tarifs officiels GPT-6.1 Sol | Tarifs officiels Claude Sonnet 5.5 |
|---|---|---|
| Entrée / 1M de jetons, base Standard | $2.00 | $2.00 |
| Sortie / 1M de jetons, base Standard | $10.00 | $10.00 |
| Lecture de cache / 1M, base | $0.10 | $0.10 |
| Écriture de cache / 1M, base | $2.50 | $2.50 pour 5m ; $4.00 pour 1h |
| Traitement par lots | 50% en dessous du Standard | 50% de remise entrée/sortie |
| Entrée au‑delà de 272K, requête Standard entière | $4 entrée / $0.20 lecture cache / $5 écriture cache / $15 sortie | Pas de surcoût équivalent indiqué dans l’aperçu cité |
Tous les tarifs sont en USD par million de jetons. Les lectures de cache de base de GPT-6.1 Sol coûtent $0.10/M et celles de Sonnet 5.5 aussi $0.10/M. La condition de Sol au‑delà de 272K en entrée augmente les tarifs pour la requête Standard complète, pas seulement les jetons excédentaires. Comparez les écritures de cache, la rétention, les paliers long contexte, le traitement régional et les niveaux de service ; le prix de lecture de base seul ne donne l’avantage à aucun modèle.
Cost per Completed Task
Coût par résultat accepté = coût total de l’ensemble des tâches tentées / nombre de résultats acceptés. Le coût total inclut l’entrée facturée fraîche, les lectures et écritures de cache, la sortie (y compris les jetons de raisonnement facturés le cas échéant), les appels d’outils payants et la relecture ou la correction humaines. Les coûts de réessai sont comptabilisés selon leur usage réel, sans être ajoutés à nouveau en double.
Pour un million de jetons de lecture de cache facturés entièrement au tarif de base, chaque modèle coûte $0.10 ; l’écart de prix de lecture de base est de $0.00. Il s’agit d’une illustration de tarif, pas d’une requête Sol d’un million de jetons d’entrée facturée au palier de base. Le coût réel de session inclut aussi l’entrée fraîche, les écritures de cache, la sortie, les outils et les réessais. Comparez les sessions à cache froid et chaud selon le palier de contexte applicable et rapportez le taux de résultats acceptés aux côtés de l’usage facturé.
CometAPI Pricing
| Palier CometAPI publié | API GPT-6.1 Sol via CometAPI | API Claude Sonnet 5.5 via CometAPI |
|---|---|---|
| Entrée / sortie de base par 1M | $1.60 / $8.00 | $1.60 / $8.00 |
| Remise de base vs fournisseur | 20% | 20% |
| Entrée / sortie long contexte GPT | $3.20 / $12.00 | Vérifier les conditions spécifiques de la route actuelle |
| Lectures de cache GPT, base / long | $0.08 / $0.16 | Non spécifié dans le tableau de tarification basique cité |
Ce sont les prix publiés pour les routes de modèles consultés pour cette révision, distincts des tarifs fournisseurs. La tarification CometAPI de GPT-6.1 Sol distingue court et long contexte. Le tableau basique cité pour Sonnet liste l’entrée et la sortie ; il ne justifie pas de supposer une politique de cache de passerelle identique. Vérifiez les conditions de facturation actuelles de la route sélectionnée avant d’estimer une session en production.
How Do Context Windows, Speed, and Technical Specs Compare?
GPT-6.1 Sol supporte 1,05M de jetons, tandis que Claude Sonnet 5.5 supporte 1M de jetons. La différence nominale n’est que d’environ 5 %, donc la capacité de contexte seule est peu susceptible de décider la plupart des déploiements.
L’échelle d’effort de GPT-6.1 Sol est low, medium, high, xhigh et max ; medium est le défaut. Sonnet 5.5 utilise une réflexion adaptative avec high comme défaut sur Claude Platform. Ces noms n’impliquent pas des budgets de raisonnement égaux. À exigences de qualité égales, mesurez séparément le temps jusqu’au premier jeton, le débit de sortie, la latence des boucles d’outils et l’achèvement de bout en bout.
Anthropic rapporte plus de 30 % de génération plus rapide pour Sonnet 5.5 par rapport à Sonnet 5. Considérez‑le comme une comparaison au prédécesseur. Les éléments de preuve de cet article n’établissent pas un chiffre de latence universel pour GPT-6.1 Sol ni un vainqueur direct en vitesse entre les modèles actuels. Pour les charges interactives, testez des réglages d’effort plus bas selon le même cahier d’acceptation plutôt que de supposer que max est le meilleur réglage de déploiement.
What Matters for Safety, Alignment, and Deployment?
Les décisions de déploiement doivent distinguer le comportement documenté du modèle et les contrôles d’application. Une comparaison de modèles ne peut pas, à elle seule, établir quel déploiement répond aux exigences de gestion des données ou d’accès de votre organisation. Évaluez le fournisseur ou la passerelle que vous utilisez réellement, y compris la journalisation des requêtes, la résidence des données, les permissions d’outils et la gestion des échecs.
- Migration du raisonnement : GPT-6.1 Sol ne prend pas en charge none ou minimal. Les conseils de migration d’OpenAI orientent les workflows d’appel d’outils vers Responses.
- Comportement des outils Claude : les changements de compatibilité documentés de Sonnet 5.5 incluent des modes d’outil forcés non pris en charge et des blocs de réflexion liés à la conversation. Testez ces parcours avant le déploiement.
- Contrôles opérationnels : ne donnez aux agents que les outils nécessaires à la tâche, enregistrez les appels échoués et conservez une relecture humaine pour les actions externes conséquentes. Ce sont des choix de conception applicative, pas des avantages mesurés pour l’un ou l’autre modèle.
GPT-6.1 Sol vs Claude Sonnet 5.5: Which Should You Choose?
Testez GPT-6.1 Sol en premier si vous utilisez déjà les outils Responses ou si vous avez besoin d’une échelle d’effort prévisible. Testez Sonnet 5.5 pour l’itération de code bien cadrée, les diapositives, feuilles de calcul et workflows documentaires lorsque les preuves publiées correspondent à vos tâches. Pour des sessions à préfixe mis en cache, testez les deux : leurs tarifs de base en lecture de cache sont égaux, tandis que les coûts d’écriture, la rétention, les paliers long contexte et le succès des tâches peuvent modifier la facture totale. N’orientez le travail qu’après des évaluations représentatives établissant une différence utile de qualité, coût ou latence.
Workload-Based Selection
| Charge de travail | Point de départ | À vérifier |
|---|---|---|
| Agent OpenAI Responses existant | GPT-6.1 Sol | Compatibilité des outils et changements d’effort |
| Itération de code / correction de bogues | Sonnet 5.5, puis comparer Sol | Prêt à fusionner, latence et réessais |
| Diapositives / feuilles / rapports | Sonnet 5.5, puis comparer Sol | Respect des modèles et temps d’édition humaine |
| Sessions stables à préfixe en cache | Les deux ; lectures de cache de base égales | Taux de hit, écritures, palier de contexte et qualité acceptée |
| Requêtes complètes au‑delà de 272K entrée | Les deux | Facture long contexte réelle et qualité de récupération |
| Automatisation ordinateur / navigateur | Les deux | Récupération, achèvement des tâches et permissions |
| Math / analyse scientifique | Les deux, sur des tests spécifiques aux tâches | Exactitude avec réponses vérifiables |
| Production sensible aux coûts | Les deux | Coût total par résultat accepté |
Une comparaison en production doit maintenir constant le système environnant. Utilisez les mêmes invites, dépôts ou documents, permissions d’outils, délai, politique de réessai et cahier d’acceptation de sortie.
Consignez l’entrée fraîche, les écritures et lectures de cache, l’usage de sortie, les appels d’outils payants, les réessais, le temps de relecture humaine, le succès des tâches et la latence bout‑à‑bout. Une première réponse moins chère peut tout de même produire un résultat accepté plus coûteux.
How Can You Access GPT-6.1 Sol and Claude Sonnet 5.5?
Les développeurs peuvent accéder à GPT-6.1 Sol API dans CometAPI et à Claude Sonnet 5.5 API dans CometAPI via les routes de modèles documentées. Créez une clé API, stockez‑la en sécurité et vérifiez l’accès au modèle et la facturation spécifique à la route avant la production.
GPT-6.1 Sol Access
Pour Sol, utilisez la route Responses documentée lorsque l’appel d’outils est requis. Sélectionnez gpt-6.1-sol et un niveau d’effort pris en charge, medium étant le défaut. Transmettez l’entrée de la tâche, ne configurez que les outils nécessaires, et validez le texte retourné, les appels d’outils, les erreurs et l’usage. Confirmez la prise en charge passerelle des fonctionnalités spécifiques au fournisseur plutôt que de supposer que toutes les options OpenAI sont disponibles.
Claude Sonnet 5.5 Access
Pour Sonnet, sélectionnez claude-sonnet-5-5 sur une interface compatible documentée et envoyez la tâche sous forme de messages de conversation avec un budget de sortie approprié. Confirmez la manière dont cette route gère la réflexion native et les paramètres d’outils ; les champs de raisonnement d’OpenAI ne sont pas automatiquement interchangeables avec les options de Claude. Validez la poursuite de conversation et la gestion des erreurs avant le déploiement d’agents.
Une vérification d’endpoint confirme la connectivité, pas la performance comparative. Pour l’évaluation, alignez les invites, les budgets effectifs de sortie et de raisonnement, les outils, les réessais, les délais et les critères d’acceptation, puis comparez le travail accepté, la latence et le coût total facturé.
Conclusion
GPT-6.1 Sol et Claude Sonnet 5.5 partagent les mêmes tarifs de base en entrée, sortie et lecture de cache, avec une capacité de contexte similaire. Sol est un candidat naturel pour les agents Responses existants et des contrôles d’effort explicites. La réflexion adaptative de Sonnet et ses résultats publiés en codage et travail professionnel en font un candidat utile pour les livrables du quotidien. Les workflows fortement fondés sur le cache requièrent une comparaison de session complète : des tarifs de lecture de base égaux ne garantissent pas des coûts d’écriture, de rétention, de long contexte ou de tâche terminée égaux.
Choisissez le modèle qui accomplit votre travail réel selon vos exigences de qualité, latence et coût. Gardez séparés les scores des prédécesseurs des preuves des modèles actuels, tarifez le palier de contexte que votre charge utilise et comparez les deux routes avant d’adopter un défaut.
FAQ
GPT-6.1 Sol et Sonnet 5.5 peuvent-ils partager un même schéma d’outils ?
Une définition d’outil JSON commune peut servir de point de départ, mais la prise en charge d’endpoint, le comportement d’outil forcé, les blocs de réflexion et la gestion de réponse diffèrent. Validez les appels d’outils de chaque modèle avec des tests de contrat sur les arguments, les chemins d’échec et la poursuite de conversation. Conservez des adaptateurs spécifiques au modèle pour les options non prises en charge plutôt que de supposer qu’une requête texte réussie prouve la compatibilité agent.
Comment faire correspondre l’effort de raisonnement entre les deux modèles ?
Ne considérez pas des réglages de nom identique comme des budgets de calcul égaux. Définissez un cahier d’acceptation et soit une limite de coût, soit une cible de latence, puis balayez les niveaux d’effort pour chaque modèle. Comparez la meilleure configuration qui satisfait la même contrainte opérationnelle, y compris les réessais et la correction humaine, plutôt que de comparer uniquement les réglages les plus élevés des deux modèles.
Quand un workflow à contexte 1M doit-il plutôt utiliser la récupération (retrieval) ?
Utilisez la récupération lorsqu’une tâche nécessite une petite partie identifiable d’un grand corpus et que vos tests de récupération montrent que le contenu pertinent est systématiquement retrouvé. Testez des requêtes plein contexte lorsque les preuves sont distribuées ou que des relations inter‑fichiers comptent. Comparez l’exactitude des réponses, la couverture des citations, le coût d’entrée et la latence ; une grande limite de contexte n’établit pas à elle seule qu’il est économique ou fiable de remplir toute la fenêtre.
Comment les équipes peuvent-elles éviter une comparaison trompeuse des coûts de cache ?
Mesurez séparément les exécutions à cache froid et cache chaud, enregistrez les écritures de cache ainsi que les lectures, et appliquez la fenêtre de rétention correcte et le palier long contexte. Maintenez stables les préfixes partagés et comparez des sessions réalistes répétées, pas seulement une requête à tarif réduit. Rapportez le taux de hit et l’usage total facturé afin qu’une économie apparente puisse être reproduite.
Qu’est-ce qui doit déclencher une nouvelle évaluation GPT-6.1 Sol vs Sonnet 5.5 ?
Relancez la suite de tâches affectée après une mise à jour de déploiement, une correction de bogue du fournisseur, un changement de routage, d’outil ou d’invite, ou une révision tarifaire significative. Enregistrez la date d’évaluation, l’ID du modèle, l’endpoint, l’effort et la version du harnais. Conservez l’exécution antérieure comme référence afin que les changements de qualité ou de latence ne soient pas confondus avec des modifications du système environnant.