TL;DR
GPT-6.1 Sol n’est pas un remplacement plus coûteux ni à plus grand contexte pour GPT-6 Sol. Il conserve la même fenêtre de contexte de 1,05 million de tokens, une sortie maximale de 128K et la tarification API Standard de $2/$10, tout en améliorant le code, l’usage de l’ordinateur, les workflows professionnels, la fiabilité factuelle et le comportement d’agent. Le changement de prix le plus clair concerne la mise en cache des invites : l’entrée mise en cache passe de $0,20 à $0,10 par million de tokens.
Dans la pratique, GPT-6.1 Sol vise moins à changer la forme de l’API qu’à fournir un travail nettement plus utile avec un budget de tokens sensiblement identique.
Principaux enseignements
- GPT-6.1 Sol est une mise à niveau de capacités de GPT-6 Sol, avec la même fenêtre de contexte de 1 050 000 tokens et un plafond de sortie de 128 000 tokens.
- Les prix Standard d’entrée et de sortie restent à $2/M et $10/M ; l’entrée mise en cache passe de $0,20/M à $0,10/M.
- Les évaluations officielles montrent de meilleures performances en codage, usage de l’ordinateur, automatisation métier et workflows scientifiques ; les résultats dépendent du benchmark et du réglage de raisonnement.
- La migration nécessite de vérifier à la fois l’effort de raisonnement et la compatibilité des endpoints API : GPT-6.1 Sol n’en supprime aucun et requiert Responses API pour les appels d’outils.
- Validez la réussite des tâches, la latence, les hits de cache réels et le coût de bout en bout avant de remplacer un déploiement GPT-6 Sol stable.
Qu’est-ce que GPT-6.1 Sol, et pourquoi arrive-t-il si peu de temps après GPT-6 Sol ?
OpenAI a présenté GPT-6 Sol le 22 septembre 2026. Une semaine plus tard, un addendum au system card daté du 29 septembre a annoncé GPT-6.1 Sol. OpenAI présente cette nouvelle version comme une mise à niveau de GPT-6 Sol plutôt qu’un palier tarifaire séparé.
L’intervalle de sortie court est important, car GPT-6.1 Sol n’est pas positionné comme une nouvelle offre tarifaire. OpenAI a conservé le palier Sol et a centré la mise à jour sur la capacité à traiter des tâches difficiles, l’efficacité-coût et la fiabilité des agents.
OpenAI positionne GPT-6.1 Sol sur le codage agentique, l’usage de l’ordinateur et le travail professionnel. La comparaison clé est la réussite des tâches à coût donné, plutôt que le nom du modèle lui-même. Le résumé officiel des benchmarks ci-dessous sépare les gains de capacité des spécifications de l’API demeurées inchangées.
Cela rend la comparaison inhabituellement simple : GPT-6.1 Sol est principalement une mise à niveau de capacité et d’efficacité, plutôt qu’une extension de fenêtre de contexte ou une augmentation du prix de base.
GPT-6.1 Sol vs. GPT-6 Sol : qu’est-ce qui reste inchangé ?
Les deux modèles conservent la même capacité phare, les modalités d’entrée/sortie prises en charge et les prix Standard d’entrée/sortie. Le tableau consigne également des différences de dates de coupure, d’options de raisonnement, d’appels d’outils et de tarifs d’entrée mise en cache ; ces différences ne doivent pas être confondues avec des spécifications communes.
Spécifications partagées et différences de compatibilité
| Spécification | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Model ID | gpt-6.1-sol | gpt-6-sol |
| Release date | Sep. 29, 2026 | Sep. 22, 2026 |
| Context window | 1,050,000 tokens | 1,050,000 tokens |
| Maximum output | 128,000 tokens | 128,000 tokens |
| Knowledge cutoff | Apr. 30, 2026 | Apr. 20, 2026 |
| Text input / output | Yes / Yes | Yes / Yes |
| Image input | Yes | Yes |
| Standard input price | $2.00 / 1M | $2.00 / 1M |
| Cached input | $0.10 / 1M | $0.20 / 1M |
| Cache write | $2.50 / 1M | $2.50 / 1M |
| Output price | $10.00 / 1M | $10.00 / 1M |
| Reasoning effort | low, medium, high, xhigh, max | none, low, medium, high, xhigh, max |
| Structured outputs | Yes | Yes |
Les deux colonnes officielles ci-dessus documentent les mêmes limites de contexte et de sortie. Ces chiffres décrivent la capacité ; ils n’impliquent pas une exactitude de récupération ni une latence égales pour tous les workloads à long contexte.
La date de coupure des connaissances avance légèrement, du 20 avril au 30 avril 2026. Plus important, GPT-6.1 Sol ne prend plus en charge reasoning.effort="none" ; ses réglages de raisonnement disponibles commencent à low.
Pour les développeurs dépendant d’un comportement à latence minimale, ce détail de compatibilité mérite un test, car GPT-6 Sol prend toujours en charge un effort de raisonnement none.
Architecture : ce qui reste non divulgué
Aucune des pages des modèles utilisées pour cette comparaison ne fournit un nombre de paramètres ni une décomposition détaillée de l’architecture. Le system card addendum officiel indique que GPT-6.1 Sol utilise les mêmes types de données et d’entraînement qu’Astra ; cette affirmation ne prouve pas que Sol et Astra ont des architectures identiques. Les différences d’architecture et d’échelle de paramètres demeurent donc non divulguées dans le matériel cité.
La tarification de base est inchangée ; les lectures mises en cache sont moins chères
Pour les tokens ordinaires non mis en cache, non. Les tarifs Standard d’entrée et de sortie sont inchangés. La principale amélioration tarifaire concerne l’entrée mise en cache.
| Tarification API officielle — USD par 1M tokens | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Input / 1M tokens | $2.00 | $2.00 |
| Cached input / 1M | $0.10 | $0.20 |
| Cache write / 1M | $2.50 | $2.50 |
| Output / 1M tokens | $10.00 | $10.00 |
GPT-6.1 Sol réduit l’entrée mise en cache à $0,10 par million de tokens, soit 5 % du tarif d’entrée non mise en cache.
Par exemple, réutiliser 100 millions de tokens d’entrée mis en cache coûte environ $10 sur GPT-6.1 Sol, contre $20 sur GPT-6 Sol. Cette différence est modeste pour des prompts ponctuels, mais plus significative pour des agents à fort volume avec des préfixes d’invite stables.
Les conditions tarifaires officielles présentées dans la documentation du modèle s’appliquent également : les requêtes au-dessus de 272K tokens d’entrée utilisent des tarifs d’entrée et de cache multipliés par 2 et une tarification de sortie multipliée par 1,5 pour la requête entière. Le mode Fast de GPT-6.1 Sol est à 2x le Standard ; Batch et Flex sont 50 % en dessous du Standard. Le traitement régional ajoute une majoration de 10 % là où disponible, et le mode Fast est indisponible avec la résidence des données UE. Des frais séparés pour les outils peuvent s’appliquer. Établissez le budget selon le mode de traitement sélectionné, la région et les hits de cache réels.
Qu’est-ce qui a été amélioré dans GPT-6.1 Sol ?
La mise à niveau s’évalue le mieux à travers le codage, les workflows d’agents, les documents professionnels, la science, la factualité et la récupération en cas d’échec. Les sections ci-dessous regroupent ces améliorations tout en conservant les conditions et limites originales des benchmarks.
Aperçu des benchmarks : gains rapportés et conditions d’évaluation
L’argument le plus solide en faveur de GPT-6.1 Sol vient des performances au niveau des tâches plutôt que des spécifications brutes. OpenAI rapporte des améliorations en ingénierie logicielle, automatisation métier, interaction avec l’ordinateur, workflows scientifiques, factualité et alignement des agents.
| Résultats officiels de benchs / évaluations | GPT-6.1 Sol vs. GPT-6 Sol | Signification du changement |
|---|---|---|
| DeepSWE v1.1 | +6,4 points de pourcentage par rapport au meilleur résultat de GPT-6 Sol, avec un effort de raisonnement et un coût de tâche inférieurs ; comparaison non à effort égal | Meilleure ingénierie logicielle longue durée |
| AutomationBench 1.0.6 | +4,8 points à effort medium pour les deux modèles Sol ; +2,2 points par rapport à Opus 5.5 à effort medium | Meilleure exécution d’agents métier multi-étapes |
| OSWorld 2.0 offline | +7 points à effort max ; récompense partielle sur le set offline, version v2026.08.08 ; moins de la moitié du coût de tâche | Meilleurs workflows d’usage de l’ordinateur |
| Terminal-Bench Science 0.1 | Plus de 2x le score de GPT-6 Sol à effort max, avec moins de la moitié du coût par tâche | Gain important pour les workflows scientifiques |
| Évaluation de factualité difficile | À effort low, les réponses contenant des erreurs passent de 11,4 % à 7,7 % ; évaluation sur prompts difficiles sélectionnés | Moins d’erreurs factuelles sur prompts difficiles |
| Test d’alignement avec recherche cassée | À effort maximum, l’omission de divulguer une recherche cassée passe de 4,9 % à 2,1 % ; tâches volontairement adversariales | Meilleure reconnaissance des défaillances d’outils |
Ce sont des résultats rapportés par OpenAI, et non des mesures indépendantes de CometAPI. OpenAI a évalué ses modèles dans son environnement de recherche ou via son API ; le comportement en production peut différer selon les prompts système et les outils disponibles. Les chiffres des concurrents proviennent de rapports publics. Le coût par tâche reflète la configuration testée et n’est pas identique au prix par token. Des détails non rapportés, tels que les budgets par exécution ou les échafaudages, ne doivent pas être inférés.
Le résultat officiel dans le tableau compare GPT-6.1 Sol à un effort de raisonnement plus faible avec le meilleur score de GPT-6 Sol. Il ne doit pas être décrit comme une comparaison contrôlée de vitesse à effort égal. DeepSWE v1.1 évalue des tâches originales d’ingénierie logicielle dans de vrais codebases.
Pour contexte, le lancement original de GPT-6 Sol rapportait 68,8 % à effort maximum sur DeepSWE v1.1.
Codage : meilleure ingénierie logicielle longue durée
Le codage est sans doute la mise à niveau la plus claire. DeepSWE v1.1 évalue des agents sur des tâches d’ingénierie logicielle originales dans de vrais dépôts nécessitant un travail soutenu et multi-étapes.
L’amélioration DeepSWE résumée ci-dessus est pertinente lorsque un agent doit inspecter un dépôt, planifier des changements, utiliser des outils et réparer des échecs sur de nombreuses étapes. Les développeurs peuvent comparer cette mise à niveau avec la GPT-6 Astra API dans CometAPI pour décider si les tâches les plus difficiles justifient un modèle plus coûteux.
Ceci compte davantage qu’un court benchmark de code, car les agents de codage de longue durée accumulent des coûts via un raisonnement répété, des appels d’outils, des lectures de fichiers, des patchs et la réutilisation de contexte. GPT-6.1 Sol améliore à la fois la complétion des tâches et l’économie de réutilisation de contexte sans augmenter le tarif standard $2/$10 par token.
La GPT-6 Sol API dans CometAPI demeure utile pour les déploiements existants et offre une voie compatible OpenAI pour les workloads de codage et d’agents.
Agents IA et workflows métier : automatisation et usage de l’ordinateur
Oui, et l’amélioration dépasse le codage. AutomationBench évalue la capacité d’un agent à compléter des workflows de bout en bout utilisant de nombreux outils dans la vente, le marketing, les opérations, le support, la finance et les RH.
Le résultat AutomationBench à effort medium, apparié pour les deux modèles Sol, est pertinent pour les workflows métier riches en outils. Cela demeure un résultat de benchmark plutôt qu’une garantie de réussite dans la pile d’outils d’une entreprise. La comparaison inclut également Claude Opus 5.5 API dans CometAPI ; évaluez tous les candidats avec les mêmes outils et critères de succès avant d’en sélectionner un.
Pour l’usage de l’ordinateur, le résultat OSWorld ci-dessus utilise le set offline et une récompense partielle. Un score plus élevé en récompense partielle ne signifie pas nécessairement que chaque tâche a été complétée de bout en bout. L’état du navigateur, les permissions, le comportement de récupération et la qualité de l’intégration des outils affectent toujours les résultats en déploiement.
Documents professionnels et science : capacités élargies pour tâches complexes
GPT-6.1 Sol pousse également le palier Sol plus loin dans le travail de connaissance professionnel. OpenAI évalue la compréhension de documents complexes avec GDP.pdf, où les modèles répondent à des questions réalistes basées sur des PDF contenant tableaux, graphiques, diagrammes, mise en page dense et mentions en petits caractères dans des domaines comme la finance, la santé et le droit.
GDP.pdf apporte des preuves pour l’analyse professionnelle de PDF au-delà du simple question-réponse textuel. Considérez son résultat dans l’annonce de lancement comme une évaluation de la compréhension de documents, non une garantie que chaque graphique, note de bas de page ou page scannée sera interprété correctement.
Le résultat Terminal-Bench Science dans le résumé officiel couvre des workflows tels que l’analyse de données, la simulation et la démonstration de théorèmes. Une évaluation locale utile devrait noter la justesse et la reproductibilité de la sortie finale, tout en mesurant le coût total des outils et du modèle.
Cela ne signifie pas que GPT-6.1 Sol remplace universellement Astra. OpenAI continue de positionner Astra comme son modèle le plus performant pour les travaux les plus difficiles de bout en bout. Le changement important est que l’écart de performance entre Sol et Astra se rétrécit tandis que l’écart de prix par token reste important.
Factualité et fiabilité des agents : moins d’erreurs et meilleure gestion des défaillances
Les données de factualité d’OpenAI vont dans ce sens, bien que l’évaluation ne doive pas être interprétée comme un taux universel d’hallucination.
L’annonce officielle rapporte directement une amélioration de factualité à faible effort : les réponses contenant des erreurs passent de 11,4 % avec GPT-6 Sol à 7,7 % avec GPT-6.1 Sol, soit une baisse de 3,7 points de pourcentage, ou environ 32 % de réduction relative. Ces conversations sélectionnées déclenchaient auparavant des erreurs ; ces chiffres ne constituent pas un taux universel d’hallucination.
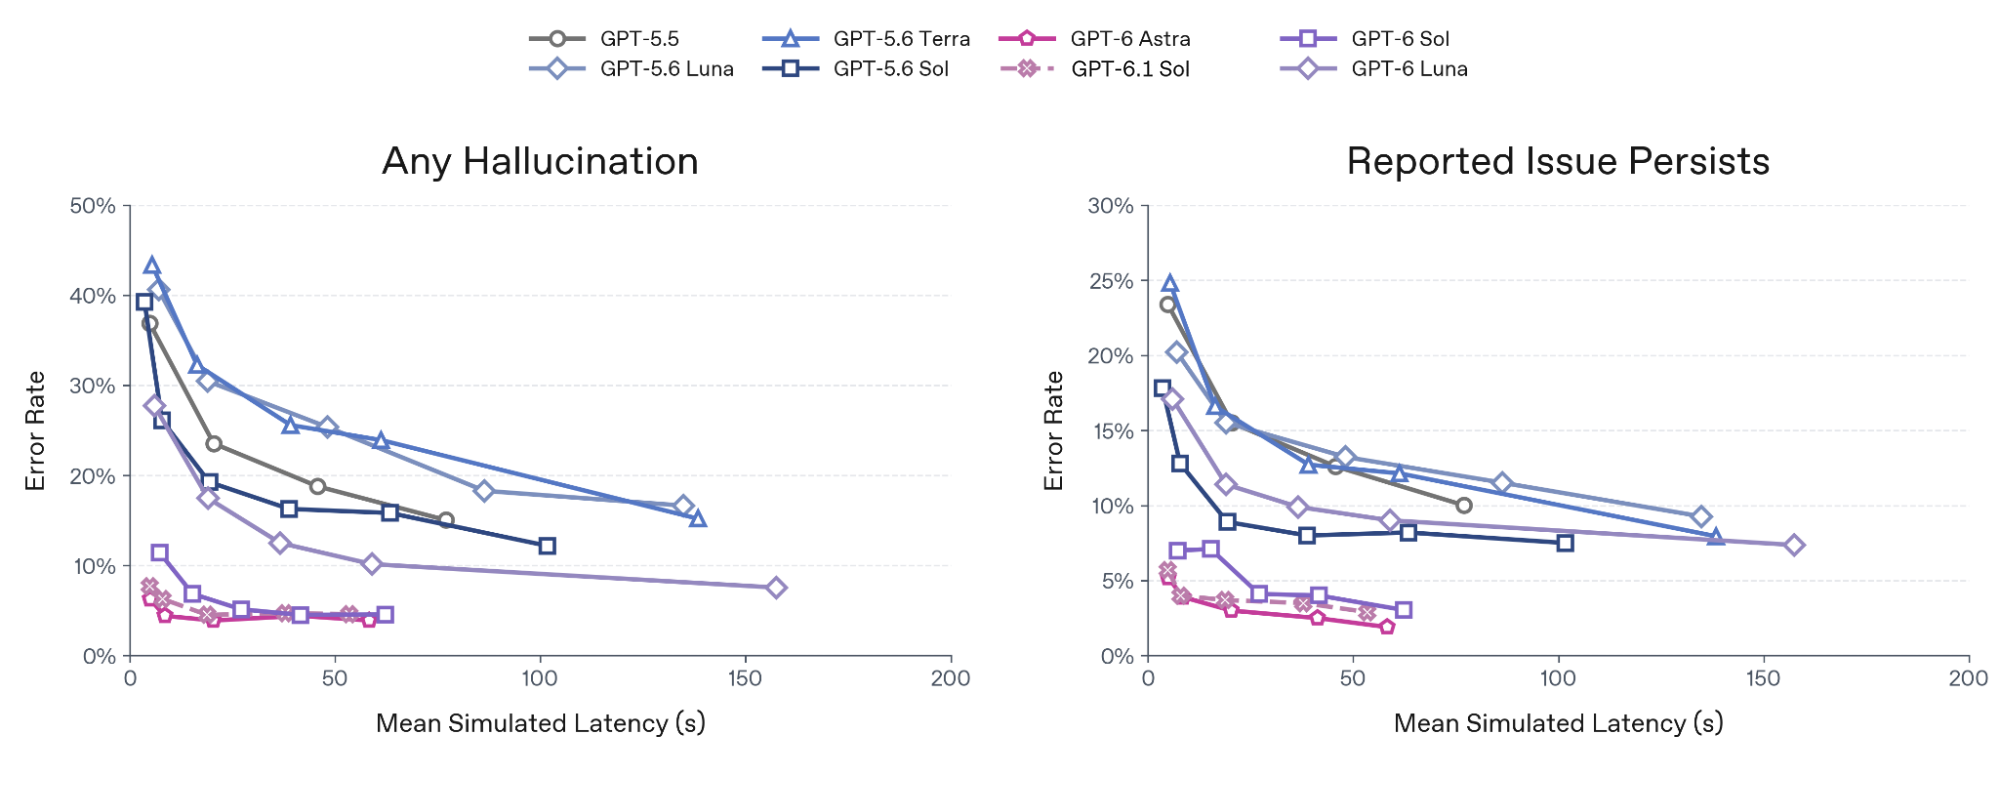
Le graphique original ci-dessus est extrait directement du PDF du system card d’OpenAI sans redessin. Il trace des évaluations de conversations difficiles sélectionnées contre une latence simulée ; les deux panneaux mesurent toute hallucination et la persistance du problème signalé. Il ne doit pas être lu comme une estimation d’erreur à l’échelle de la production.
| Modèle | Taux d’échec de recherche cassée — effort maximum |
|---|---|
| GPT-6.1 Sol | 2,1 % |
| GPT-6 Sol | 4,9 % |
| GPT-6 Astra | 1,5 % |
| GPT-6 Luna | 28,7 % |
La GPT-6 Luna API dans CometAPI est une autre option orientée coût, mais son résultat ici sur recherche cassée illustre pourquoi un agent doit être testé sur la gestion des défaillances autant que sur l’exécution réussie d’outils.
Ce sont des évaluations volontairement adversariales plutôt que des taux de défaillance représentatifs en production. Elles sont utiles comme preuve que GPT-6.1 Sol reconnaît mieux lorsque les outils sont indisponibles ou cassés, au lieu de continuer avec assurance sur des affirmations non étayées.
GPT-6.1 Sol vs. GPT-6 Sol : devez-vous mettre à niveau ?
Pour un nouveau workflow complexe, GPT-6.1 Sol est un solide candidat à l’évaluation. Pour un déploiement GPT-6 Sol stable, ne mettez à niveau que lorsque les gains mesurés justifient la migration. Les limites de contexte partagées et les prix de token de base permettent une comparaison équitable, mais les benchmarks publics ne peuvent pas décider si votre application deviendra plus rapide, plus fiable ou moins chère.
Quand il vaut la peine de tester la mise à niveau
Donnez la priorité à un essai lorsque le codage à l’échelle de dépôts, l’automatisation métier multi-étapes, l’usage de l’ordinateur ou l’analyse de documents difficiles représente une part substantielle de votre workload. Les améliorations rapportées dans la section précédente sont pertinentes pour ces cas d’usage. Traitez-les comme des raisons de tester, plutôt qu’une garantie d’une hausse similaire de votre taux de réussite en production.
Les applications à contexte répété constituent un autre cas de test utile. Le tarif plus bas des lectures mises en cache peut réduire la part de la facture liée à l’entrée lorsque les requêtes réutilisent effectivement un préfixe stable. Si la majeure partie de la dépense vient des tokens générés, des outils ou des tentatives échouées, une remise de cache seule peut avoir peu d’effet. Comparez le coût total par résultat accepté, y compris les relances et le temps de revue.
Quand conserver GPT-6 Sol est raisonnable
Conservez GPT-6 Sol lorsqu’il répond déjà à vos objectifs de qualité, de latence et de budget, et que le nouveau modèle n’apporte aucun bénéfice matériel dans une évaluation représentative. Une intégration fonctionnelle a également de la valeur : évitez de remplacer une route stable uniquement parce que le nom du modèle est plus récent.
La compatibilité peut être décisive. GPT-6 Sol prend en charge le raisonnement none ; GPT-6.1 Sol commence à low. Une application utilisant des appels de fonction Chat Completions de Sol à none doit déplacer sa boucle d’outils vers Responses pour utiliser 6.1 Sol. Auditez aussi les paramètres d’échantillonnage et l’analyse des réponses. Ce sont des changements de migration, pas un simple échange d’ID de modèle. Voir OpenAI migration guidance.
Comment prendre la décision de mise à niveau
Créez un set d’évaluation fixe avec des tâches de routine, des cas difficiles et des défaillances d’outils issues de votre workflow visé. Gardez les définitions de tâches, permissions d’outils et critères d’acceptation cohérents. Comparez une ligne de base Sol validée avec une configuration 6.1 Sol valide ; enregistrez explicitement les réglages de raisonnement au lieu de prétendre que none et low sont équivalents.
- Qualité : mesurez les complétions acceptées, les corrections factuelles, les appels d’outils invalides et l’effort de revue humaine.
- Vitesse : comparez la latence de bout en bout p50/p95, y compris les relances et les attentes d’outils.
- Coût : enregistrez l’entrée non mise en cache, les lectures mises en cache, les écritures de cache, les tokens de sortie/raisonnement, les frais d’outils et l’effort d’ingénierie.
- Déploiement : commencez par une petite part de trafic, conservez un fallback Sol, et élargissez seulement quand des seuils prédéfinis sont atteints.
Recommandation pratique : choisissez GPT-6.1 Sol lorsque l’essai fournit de meilleurs economics par tâche acceptée ou un gain de capacité nécessaire sans régressions inacceptables. Conservez GPT-6 Sol pour les routes où la compatibilité et les résultats éprouvés l’emportent sur le bénéfice mesuré. Un déploiement mixte est raisonnable lorsque seules certaines classes de tâches s’améliorent. Ce sont des recommandations basées sur les workloads, non l’affirmation qu’un modèle l’emporte universellement.
Comment migrer de GPT-6 Sol à GPT-6.1 Sol ?
Au niveau le plus simple, l’identifiant du modèle passe de gpt-6-sol à gpt-6.1-sol.
Une requête Responses API peut ressembler à ceci :
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Analyze this repository and identify the cause of the failing tests."
)

print(response.output_text)
Changer l’identifiant du modèle n’est que la première étape. GPT-6.1 Sol prend en charge low, medium, high, xhigh et max, tandis que GPT-6 Sol prend en plus en charge none. Supprimez tout réglage explicite none et choisissez un effort autorisé. Les applications utilisant des outils ont aussi besoin de Responses API : Chat Completions avec GPT-6.1 Sol ne prend pas en charge les appels d’outils, alors que GPT-6 Sol Chat Completions prend en charge les appels de fonction seulement avec none. Les colonnes officielles du tableau de spécifications documentent ces restrictions d’endpoints.
Les équipes doivent retester les workflows sensibles à la latence, les appels d’outils, la mise en cache des prompts, le comportement en long contexte et toute logique qui envoie explicitement reasoning.effort="none".
Cet exemple cible directement OpenAI en utilisant OPENAI_API_KEY ; ce n’est pas un exemple d’endpoint CometAPI vérifié. Gardez votre route GPT-6 Sol disponible durant un déploiement progressif, enregistrez la réussite des tâches et la latence p95, et revenez en arrière si les critères d’acceptation de votre application ne sont pas satisfaits.
Quels workloads bénéficient le plus de GPT-6.1 Sol ?
| Workload | Avantage de GPT-6.1 Sol |
|---|---|
| Coding agents | Performance DeepSWE plus élevée |
| Repository-scale debugging | Meilleure ingénierie logicielle longue durée |
| Browser/computer agents | +7 points sur OSWorld 2.0 |
| Enterprise automation | Performance AutomationBench plus élevée |
| Repeated-context agents | Entrée mise en cache 50 % moins chère |
| Complex PDF analysis | Performances proches d’Astra sur documents professionnels |
| Scientific workflows | Score plus de 2x celui de GPT-6 Sol dans l’évaluation Terminal-Bench Science d’OpenAI |
| Fact-sensitive workflows | Taux d’erreurs factuelles plus bas sur prompts difficiles |
| Tool-heavy agents | Meilleur comportement lorsque les outils échouent |
GPT-6 Sol reste utile là où les intégrations existantes sont déjà stables ou lorsque les développeurs ont spécifiquement besoin du réglage de raisonnement none. Pour les nouveaux déploiements centrés sur les agents, le codage, l’usage de l’ordinateur ou les workflows à contexte répété, GPT-6.1 Sol modifie l’équation coût-performance sans changer le prix habituel des tokens d’entrée/sortie.
Comment CometAPI peut vous aider à passer de GPT-6 Sol à GPT-6.1 Sol ?
Pour les développeurs utilisant déjà la GPT-6 Sol API dans CometAPI, la mise à niveau vers GPT-6.1 Sol peut être gérée comme une migration relativement mineure plutôt qu’une réécriture d’intégration complète.
GPT-6.1 Sol est désormais disponible via CometAPI avec l’identifiant de modèle gpt-6.1-sol. CometAPI affiche actuellement un prix d’entrée short-context débutant à $1,60 par million de tokens, comparé au tarif officiel de $2,00 d’OpenAI, tandis que la tarification de sortie commence à $8,00 par million de tokens. Cela maintient le nouveau modèle Sol dans la même structure de prix remisée que GPT-6 Sol, tout en donnant aux développeurs accès à ses meilleures performances en codage, agents et usage de l’ordinateur.
Comme CometAPI fournit une interface compatible OpenAI, les applications GPT-6 Sol existantes peuvent généralement conserver la même structure SDK et le même flux de requêtes tout en remplaçant l’ID de modèle par gpt-6.1-sol. CometAPI fournit aussi des outils pour comparer les modèles, tester les prompts, estimer les coûts de workload et inspecter le comportement de migration avant la mise en production.
Un processus de mise à niveau plus sûr consiste à exécuter d’abord les mêmes prompts représentatifs sur GPT-6 Sol et GPT-6.1 Sol, puis comparer la qualité de sortie, la latence, le comportement des outils et le coût total. Ceci est particulièrement important pour les applications dépendant des réglages de raisonnement, des sorties structurées, des appels d’outils ou des agents de longue durée, car la compatibilité des modèles ne garantit pas un comportement identique sur chaque workload.
Pour les équipes exécutant des workloads à contexte répété ou riches en agents, la nouvelle route peut aussi améliorer l’économie. CometAPI tarifie actuellement les lectures de cache short-context de GPT-6.1 Sol à $0,08 par million de tokens, contre $0,10 officiel chez OpenAI, tandis que les tarifs d’entrée et de sortie short-context sont listés à 20 % en dessous des prix officiels.
En pratique, CometAPI peut faire de la transition GPT-6 Sol → GPT-6.1 Sol un processus en trois étapes :
- Remplacer gpt-6-sol par gpt-6.1-sol.
- Benchmarkez les mêmes prompts de production et workflows d’agents avant de basculer le trafic.
- Déplacez progressivement les workloads une fois que la qualité de sortie, le comportement des outils, la latence et le coût répondent à vos exigences.
Cette approche permet aux développeurs d’adopter GPT-6.1 Sol sans reconstruire leur application autour d’une nouvelle pile API, tout en validant les différences de comportement introduites par le nouveau modèle.
Conclusion
GPT-6 Sol n’est pas techniquement obsolète. Il conserve la même fenêtre de contexte de 1,05 M, un plafond de sortie de 128K, des sorties structurées, l’entrée d’image et la tarification Standard $2/$10. Son option de raisonnement none peut également compter pour des intégrations existantes. La décision de mise à niveau doit se fonder sur les résultats mesurés des tâches et la compatibilité, et non sur le numéro de version.
Cependant, la documentation GPT-6 Sol d’OpenAI oriente désormais les développeurs vers GPT-6.1 Sol comme le modèle Sol le plus récent.
Pour la plupart des workloads complexes, la question clé n’est donc pas de savoir si GPT-6.1 Sol a une fenêtre de contexte plus grande ou un tarif par token plus élevé — ce n’est pas le cas. La question est de savoir si une meilleure réussite des tâches, des lectures de cache moins chères, une factualité améliorée et un comportement d’agent renforcé justifient de changer l’identifiant du modèle et de retester le workload.
FAQ
Comment migrer de GPT-6 Sol à GPT-6.1 Sol avec appel d’outils ?
Non. Commencez par auditer l’endpoint et les champs de requête, puis déplacez la boucle d’outils vers Responses API et testez l’analyse des appels d’outils, la validation des arguments, les relances et la gestion des erreurs. Lancez un canari sur des tâches représentatives avant d’augmenter le trafic ; une requête texte seule réussie ne vérifie pas une boucle d’outils opérationnelle.
GPT-6.1 Sol est-il moins coûteux dans les workloads réels ?
Journalisez les tokens d’entrée mis en cache et non mis en cache, les écritures de cache, les tokens de raisonnement et de sortie, le mode de traitement et les frais d’outils. Comparez le coût par tâche acceptée plutôt que le prix des tokens mis en cache seul. Des préfixes stables n’aident que lorsque les requêtes touchent réellement le cache, et des boucles d’outils plus longues ou des tentatives échouées peuvent compenser les économies du cache.
Comment tester GPT-6.1 Sol avant de basculer depuis GPT-6 Sol ?
Utilisez un set fixe de tâches proches de la production et enregistrez la complétion réussie, les corrections factuelles, les appels d’outils invalides, la latence p50/p95 et le coût total. Définissez des seuils acceptables avant de tester. Conservez une voie de rollback par routage de modèles et élargissez le trafic seulement après que la nouvelle configuration respecte ces seuils.
Comment tester GPT-6.1 Sol avec des PDF ?
Constituez un petit corpus avec des tableaux denses, des notes de bas de page, des graphiques et des pages scannées représentatifs du workflow visé. Posez des questions avec des réponses vérifiables et exigez des preuves par page ou tableau. Notez séparément l’exactitude des calculs, les avertissements manquants et les réponses non étayées ; conservez une revue humaine pour les sorties dont les erreurs ont des conséquences matérielles.