

En bref : GPT-6.1 Terra est le meilleur point de départ lorsque la qualité de raisonnement et les workflows visuels complexes sont prioritaires ; DeepSeek V4.1 Flash est intéressant lorsque le coût par jeton, la vitesse de génération ou l’auto‑hébergement priment. Cette comparaison utilise la mise à jour du 17 octobre de DeepSeek, Flash-1017.
DeepSeek Flash-1017 affiche des prix par jeton plus bas, mais le coût d’une tâche achevée dépend aussi de la longueur du raisonnement, des reprises et des appels d’outils.
La comparaison ci‑dessous couvre l’architecture, le contexte, le raisonnement, le code, la vision, la vitesse, la tarification et le déploiement. Les prix et les pages d’évaluation en direct ont été vérifiés le 28 octobre 2026.
Points clés
- Terra arrive en tête de l’Intelligence Index indépendant cité, ce qui en fait un premier candidat logique pour les tâches exigeantes en raisonnement.
- DeepSeek propose des prix par jeton plus faibles. Comparez la latence de bout en bout et le coût par tâche réussie, y compris les tarifs en heures de pointe, l’utilisation du cache, les jetons de raisonnement et les reprises.
- Évaluez le code par les correctifs acceptés et les workflows visuels par les tâches complétées. Les scores de benchmarks publiés apportent des éléments utiles, mais les configurations de test diffèrent.
- Terra est un modèle propriétaire hébergé. DeepSeek propose des poids téléchargeables sous licence MIT pour l’auto‑hébergement, avec le matériel et les coûts d’exploitation à prendre en compte.
- CometAPI fournit une interface texte partagée pour tester les deux modèles. Vérifiez la version de modèle résolue et la prise en charge des outils, des contrôles de raisonnement et de la sortie structurée avant le déploiement.
GPT-6.1 Terra vs DeepSeek V4.1 Flash : aperçu et caractéristiques
Les principales différences de spécifications concernent les limites de sortie, les contrôles de raisonnement, l’appel d’outils et le déploiement. Le tableau ci‑dessous résume les deux modèles.
Les spécifications de l’API Terra et les spécifications de l’API DeepSeek définissent les limites hébergées ci‑dessous ; une route tierce ou une configuration auto‑hébergée peut imposer des limites différentes.
Architecture et versions du modèle
Terra utilise une architecture propriétaire dont le nombre de paramètres n’est pas divulgué. DeepSeek-V4.1-Flash utilise une architecture MoE encodeur–décodeur causal, avec des budgets de paramètres actifs différents pour le traitement d’entrée et la génération de sortie.
La version V4.1 Flash de DeepSeek décrit une ossature MoE encodeur–décodeur causal de 552B paramètres, avec environ 8B de paramètres actifs pendant le traitement d’entrée et 16B pendant la génération de sortie. La mise à jour du 17 octobre améliore ses résultats publiés en code, agents et vision.
Dans tout cet article, Flash-1017 désigne ce point de contrôle d’octobre. Un alias générique de l’API peut ensuite pointer vers une autre version ; un enregistrement d’évaluation doit donc inclure la version du modèle réellement servie.
KV-cache et exigences de déploiement
DeepSeek indique une empreinte KV‑cache globale d’environ 890 octets par jeton, soit environ un quart de celle de DeepSeek‑V4‑Flash. Cela améliore l’efficacité du cache, même si l’auto‑hébergement requiert toujours des ressources substantielles pour les poids du modèle. Terra est disponible via des services hébergés, tandis que les poids téléchargeables de DeepSeek offrent une option d’auto‑hébergement supplémentaire.
Contrôles de raisonnement et appel d’outils
Les deux modèles prennent en charge des workflows d’agent, mais les contrôles de raisonnement et les exigences d’appel d’outils diffèrent. La prise en charge de l’appel d’outils de Terra documentée utilise la Responses API. La fiche du modèle DeepSeek décrit un effort de raisonnement numérique de 1 à 100 ; les contrôles de l’API hébergée doivent être vérifiés séparément. Lors du changement de modèle, adaptez les paramètres de raisonnement et les définitions d’outils à l’endpoint sélectionné.
GPT-6.1 Terra vs DeepSeek V4.1 Flash : performances
La comparaison ci‑dessous couvre le raisonnement, le code, la vision et les tâches à long contexte. Les évaluations indépendantes et les benchmarks rapportés par les fournisseurs sont identifiés séparément, avec une interprétation des résultats selon leurs configurations de modèle et leurs cadres d’agent.
Raisonnement et connaissances
Artificial Analysis rapporte un score Intelligence Index v5.0 de 51 pour GPT-6.1 Terra (Max) et de 32 pour DeepSeek Flash-1017 (Max) dans les configurations citées, au 28 octobre 2026. L’index combine neuf évaluations.
Le score agrégé plus élevé de Terra justifie de le tester en premier pour les tâches exigeantes en raisonnement. Pour des charges plus ciblées, DeepSeek peut rester le meilleur choix s’il atteint l’exactitude requise à un coût par tâche réussie plus bas.
Benchmarks officiels de code et d’agents
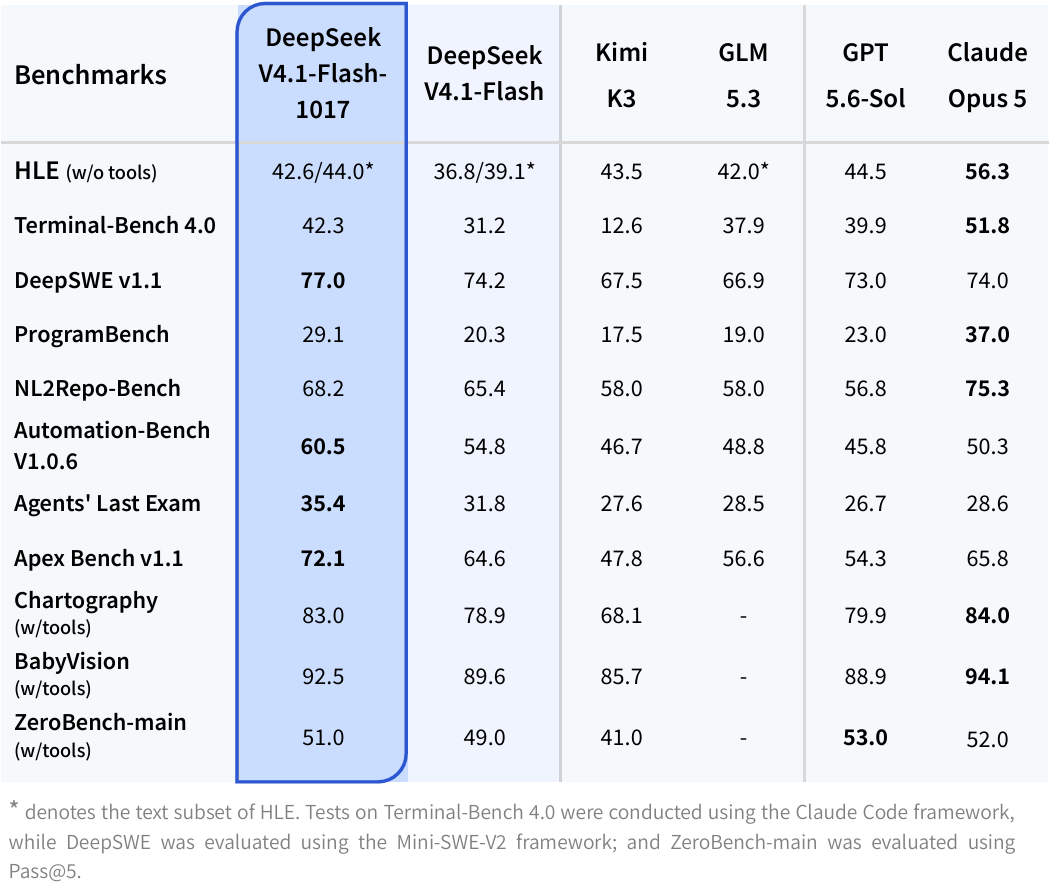
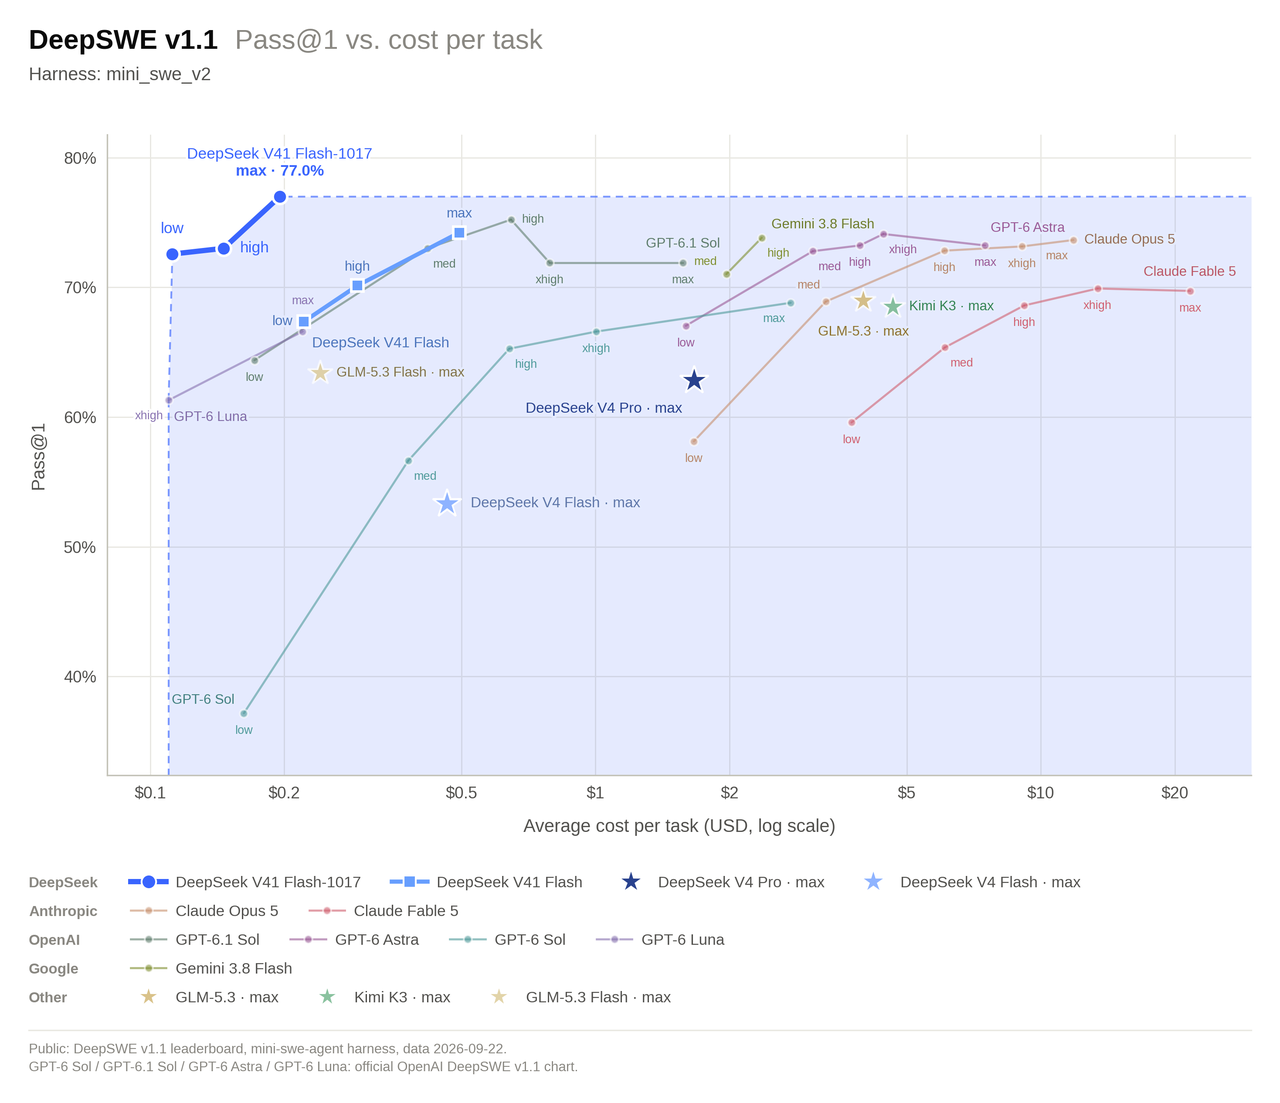
Terminal-Bench 4.0 et DeepSWE v1.1 fournissent des indications sur les performances en code et en agents. Lors de la comparaison des résultats des fournisseurs, identifiez la version exacte du modèle, le réglage de raisonnement, le cadre d’agent et la métrique de scoring ; des différences sur ces paramètres peuvent affecter sensiblement les scores.
Pour le travail de codage pratique, comparez si chaque modèle produit des correctifs qui passent les tests existants, préservent les interfaces publiques, gèrent les cas limites et évitent les changements sans rapport. La fiabilité des appels d’outils et la récupération après erreurs d’exécution influencent aussi la quantité de travail qu’un agent peut accomplir.
Les prix par jeton plus bas de DeepSeek en font un bon candidat pour la maintenance répétitive de dépôts avec des critères d’acceptation clairs. Pour des changements complexes, comparez les deux modèles sur les correctifs acceptés, le coût total de la tâche et le temps de correction humaine.
Vision et utilisation de l’ordinateur
Les deux modèles acceptent des entrées image, mais la compréhension d’images et l’interaction avec le bureau requièrent des capacités différentes. Le matériel de lancement de Terra évoque MMMU‑Pro et OSWorld 2.1, tandis que la fiche de DeepSeek rapporte des tâches visuelles incluant Chartography et BabyVision, avec des réglages assistés par outils.
Pour l’extraction de documents, comparez l’exactitude des champs, les textes manqués et la structure des tableaux. Pour l’automatisation de bureau, comparez les workflows terminés, les actions incorrectes et la récupération après des changements d’interface. Un modèle qui décrit correctement une capture d’écran peut encore peiner à opérer l’application qu’elle montre.
Choisissez selon le workflow : l’exactitude d’extraction est primordiale pour le traitement de documents, tandis que la fiabilité des actions et la récupération priment pour les agents d’utilisation de l’ordinateur. Comparez le coût seulement après que les deux modèles atteignent le seuil de qualité requis.
Raisonnement en long contexte et récupération
Les deux modèles prennent en charge des workflows sur longs documents, mais la capacité de contexte ne détermine pas à elle seule la qualité de la récupération. Comparez‑les sur la même collection de documents, en plaçant des preuves importantes au début, au milieu et à la fin.
Évaluez l’exactitude des réponses, les passages à l’appui, la cohérence à travers les documents et l’exhaustivité des réponses. Pour la recherche et l’analyse documentaire, préférez le modèle qui retrouve et relie de manière fiable les preuves pertinentes dans vos contraintes de latence et de coût.
GPT-6.1 Terra vs DeepSeek V4.1 Flash : vitesse
Débit de sortie et temps d’achèvement des tâches
La latence mérite un traitement distinct de la qualité de raisonnement.
Sur les pages Artificial Analysis du 28 octobre, la vitesse de sortie de Flash-1017 (Max) est de 173.4 tokens par seconde, tandis que la vitesse de sortie de Terra (Max) est de 90.9. Ces mesures décrivent les configurations servies chez l’évaluateur, sans garantir ces taux chez tous les fournisseurs.
Un modèle qui génère des jetons plus vite peut néanmoins mettre plus de temps à terminer s’il produit davantage de raisonnement, attend des outils ou effectue des reprises. Mesurez séparément le temps jusqu’au premier jeton, le temps total d’achèvement et la latence des tâches acceptées.
Latence interactive sur votre route API
Pour un produit interactif, testez des invites courtes et longues à une concurrence réaliste et enregistrez la latence médiane et au 95e centile. Conservez la région, la route API, la mise en cache des invites, les réglages de raisonnement et la politique de reprise dans les résultats. Cet enregistrement vous en dira davantage sur l’expérience utilisateur qu’une seule valeur de jetons par seconde.
GPT-6.1 Terra vs DeepSeek V4.1 Flash : coût
La tarification est l’une des différences les plus nettes entre ces modèles.
La grille tarifaire de Terra et la politique de prix de DeepSeek donnent les tarifs de première partie suivants, vérifiés au 28 octobre 2026. Tous les prix sont en dollars US par million de jetons.
Tarifs officiels de l’API
La tarification en pointe de DeepSeek s’applique du lundi au vendredi, 01:00–04:00 et 06:00–10:00 UTC, à l’exclusion des jours fériés chinois. Cela correspond à 09:00–12:00 et 14:00–18:00 en heure normale de Chine (UTC+8). Les autres périodes utilisent les tarifs hors pointe.
Pour les requêtes Terra au‑delà de 272,000 jetons d’entrée, OpenAI spécifie des tarifs de 2× pour l’entrée et l’entrée mise en cache et de 1.5× pour la sortie sur l’ensemble de la requête. Comparez ces conditions à la taille réelle de vos prompts avant de considérer le prix de base comme prix effectif.
Tarifs CometAPI
CometAPI indique comme fenêtres de pointe du lundi au vendredi, 01:00–04:00 et 06:00–10:00 UTC. Son calendrier indiqué n’établit pas la même exception de jours fériés que la politique de première partie de DeepSeek. Vérifiez les conditions de facturation de la route sélectionnée pour votre période d’exécution prévue.
Exemple de coût à jetons fixes
Considérons une requête qui consomme 100,000 jetons d’entrée non mis en cache et génère 10,000 jetons de sortie.
Si ce sont les totaux de jetons facturés complets, la facturation en jetons est de $0.150 pour Terra, $0.021 pour DeepSeek hors pointe, ou $0.042 pour DeepSeek en pointe. La réduction hors pointe est de 86 %. L’exemple exclut les frais d’outils additionnels, l’infrastructure et les reprises ; tout jeton de raisonnement compté séparément doit aussi entrer dans le calcul.
Aux tarifs de base listés par CometAPI, les mêmes 100,000 jetons d’entrée et 10,000 de sortie coûtent $0.120 pour Terra ou $0.0168 pour Flash. En appliquant le multiplicateur de pointe 2× listé, cela donne $0.0336 pour Flash. Il s’agit de calculs de jetons seuls utilisant les quantités indiquées, et non de mesures d’une tâche réelle.
Quand une sortie supplémentaire annule l’avantage du prix par jeton
Maintenez l’entrée non mise en cache à 100,000 jetons et la sortie totale facturée de Terra à 10,000 jetons. La facture standard de Terra est alors de $0.150. Flash atteint la même facture à 225,000 jetons de sortie facturés hors pointe, ou 100,000 en tarifs de pointe. Cette arithmétique isole le volume de sortie ; la mise en cache, les entrées répétées, les frais d’outils et les reprises modifient la comparaison.
Coût par tâche réussie
Évaluez un lot fixe de tâches et divisez toutes les dépenses API et d’outils facturées par le nombre de tâches qui passent vos vérifications d’acceptation. Comptez aussi les dépenses des tentatives échouées. Indiquez le taux de réussite à côté de ce coût, afin qu’un modèle ne soit pas récompensé pour avoir seulement terminé les tâches les plus faciles.
Coût par tâche réussie = Coût total API et outils / Tâches réalisées avec succès
Lequel choisir : GPT-6.1 Terra ou DeepSeek‑V4.1‑Flash ?
Choisissez en fonction des exigences de qualité de la tâche, des objectifs de coût et des besoins de déploiement. Utilisez les résultats de benchmarks ci‑dessus pour décider quel modèle tester en premier.
Quand choisir GPT-6.1 Terra
Donnez la priorité à Terra pour l’évaluation lorsque le raisonnement complexe est central à la tâche. Pour les workflows visuels ou d’utilisation de l’ordinateur exigeants, incluez‑le dans le jeu de test et mesurez les tâches complétées, les erreurs et la récupération.
La question clé est de savoir si Terra réduit suffisamment les tentatives échouées et la correction manuelle pour justifier son prix par jeton plus élevé.
Quand choisir DeepSeek‑V4.1‑Flash
Commencez par DeepSeek‑V4.1‑Flash pour des tâches répétitives et à grand volume avec des critères d’acceptation clairs et des objectifs de coût serrés. Choisissez‑le si les sorties répondent à vos exigences de qualité à un coût par tâche réussie inférieur.
Les poids sous licence MIT de DeepSeek en font également l’option pertinente lorsque l’auto‑hébergement est une exigence. Incluez les coûts matériels et d’exploitation dans cette décision.
Quand tester les deux modèles
Testez les deux lorsque la qualité du code, la fiabilité des outils, la latence ou l’exactitude sur longs documents est critique. Utilisez des tâches représentatives avec les mêmes entrées, outils, limites d’exécution et critères d’acceptation.
Comparez le taux de réussite, le coût total par tâche réussie, la latence de bout en bout et le temps de correction humaine. Enregistrez la version du modèle et les réglages de raisonnement pour que les résultats soient reproductibles.
Une configuration hybride peut lancer les tâches routinières avec DeepSeek et escalader certains échecs vers Terra. Mesurez le coût et le taux d’achèvement de l’ensemble du workflow pour confirmer que l’appel de modèle supplémentaire en vaut la peine.
Où accéder à GPT-6.1 Terra et DeepSeek V4.1 Flash ?
Utilisez l’API hébergée d’OpenAI pour Terra ou l’API hébergée de DeepSeek pour Flash. Confirmez l’identifiant de modèle actuel, les limites de compte et l’endpoint pris en charge avant l’intégration. Les poids téléchargeables de Flash-1017 offrent une option d’auto‑hébergement distincte.
Accès via CometAPI
CometAPI fournit une interface compatible OpenAI qui peut simplifier le développement d’applications multi‑modèles.
Utilisez la GPT-6.1 Terra API et la DeepSeek V4.1 Flash API avec un client texte partagé, puis ajoutez des contrôles spécifiques au modèle seulement après avoir vérifié la prise en charge de la route.
Comparer des réponses textuelles via CometAPI
Pour essayer les deux modèles via un seul client texte, utilisez le SDK Python OpenAI avec votre clé CometAPI et l’endpoint https://api.cometapi.com/v1. Conservez la clé dans une variable d’environnement, puis envoyez la même invite aux routes gpt-6.1-terra et deepseek-v4.1-flash et comparez les réponses et l’utilisation des jetons retournées.
Par exemple, demandez à chaque modèle d’examiner un workflow de paiement qui retente les requêtes expirées (timeout) sans clé d’idempotence et journalise l’intégralité des corps de requête. Comparez la clarté avec laquelle les réponses identifient les risques de fiabilité et de confidentialité et expliquent des correctifs pratiques. Une invite partagée facilite l’inspection des réponses, mais une requête texte par défaut n’égalise pas les budgets de raisonnement ni n’établit un classement de performance. Confirmez le point de contrôle servi par chaque route avant de considérer un résultat comme une preuve concernant Flash-1017.
Conclusion
GPT-6.1 Terra offre le meilleur résultat agrégé actuel en raisonnement, tandis que DeepSeek Flash-1017 combine des prix par jeton plus bas, une génération mesurée plus rapide et un déploiement à poids ouverts. Le bon choix est le modèle qui répond à vos exigences de qualité et de latence au coût total le plus bas.
Commencez par une charge de travail représentative, maintenez constants l’environnement d’outils et les critères d’acceptation, et comparez le coût des achèvements réussis. Une intégration texte partagée via CometAPI peut faciliter cette évaluation, tandis que les fonctionnalités spécifiques au modèle nécessitent encore leur propre configuration.
FAQ
Pourquoi la même tâche peut‑elle produire des facturations de jetons différentes avec Terra et Flash-1017 ?
Une invite texte ne se convertit pas nécessairement au même nombre de jetons dans deux modèles. Les réponses générées et les longueurs de raisonnement peuvent aussi différer. Comparez l’utilisation rapportée par chaque route pour des tâches identiques, y compris les jetons de raisonnement mis en cache et facturables lorsque c’est indiqué, plutôt que d’appliquer les deux grilles tarifaires à un même nombre de jetons estimé.
GPT-6.1 Terra et DeepSeek V4.1 Flash peuvent‑ils partager un cache d’invite ?
Vous pouvez réutiliser le texte de l’invite dans votre application, mais ne supposez pas qu’un cache créé pour un modèle ou un fournisseur réduit la facture de l’autre. L’éligibilité et la comptabilisation du cache sont spécifiques à chaque route. Vérifiez les champs d’usage de chaque réponse et testez les requêtes répétées avant d’intégrer des économies dans une prévision.
Comment valider les sorties structurées de Terra et Flash-1017 ?
Définissez les champs et types requis dans votre application avant de choisir un modèle. Si une route propose une sortie JSON ou contrainte par schéma, vérifiez le mode exact pris en charge, puis parsez la réponse et validez‑la par rapport à votre schéma. Traitez séparément les champs manquants, les valeurs invalides, les sorties tronquées et les refus. Un JSON valide n’établit pas à lui seul que les faits extraits sont corrects.