
TL;DR Claude Haiku 5.5 est présenté comme le modèle compact le moins cher, le plus rapide et le plus capable jamais livré. Conçu pour des charges à grand volume et sensibles à la latence comme la classification, l’extraction, le routage, le résumé et les tâches de sous-agents, il offre une fenêtre de contexte de 1 million de tokens, jusqu’à 128K tokens de sortie, une réflexion adaptative avec des niveaux d’effort ajustables.
En moyenne, son coût d’exécution est environ 75 % inférieur à celui de Haiku 4.5, tout en affichant de grands gains sur les benchmarks d’agentivité et d’usage de l’ordinateur. Les développeurs peuvent y accéder via l’API officielle Claude (claude-haiku-5-5), Amazon Bedrock, Google Cloud, Microsoft Foundry, ou des passerelles optimisées pour les coûts comme CometAPI (à partir de $0.08 / $0.40).
Points clés
- Publication et positionnement : Lancé le 7 octobre 2026 en tant que petit modèle à haut débit de la famille Claude 5.5 — idéal pour le support en temps réel, le traitement de documents et les étapes déléguées d’agents.
- Spécifications principales : Contexte de 1M tokens, sortie max 128K (300K via Batch API en bêta), réflexion adaptative (effort par défaut moyen), entrée texte + image → sortie texte, connaissance arrêtée en juin 2026.
- Avantage de prix : $0.10 en entrée / $0.50 en sortie par million de tokens pour des prompts jusqu’à 100K (≈90 % moins cher que Haiku 4.5 sur la plupart des requêtes) ; palier supérieur au-delà de 100K. Lectures de cache à partir de $0.01. CometAPI propose des tarifs Standard ≈20 % plus bas.
- Bond de performance : Gains majeurs vs Haiku 4.5 (par ex., OSWorld 72.4 % vs 15.7 %, Terminal-Bench 39.2 % vs 0 %, GDPval-AA 1620 vs 735 Elo), tout en restant compétitif face à ou devant GPT-6 Luna sur de nombreux tests.
- Fonctionnalités pour développeurs : Paramètre d’effort (
low–max), mise en cache des prompts, Batch API (–50 %), usage ordinateur/navigateur (support SDK en bêta). Temperature/top_p/top_k doivent être omis, sinon une erreur 400 survient.
Qu’est-ce que Claude Haiku 5.5 et pourquoi cela compte en 2026
Claude Haiku 5.5 est la dernière entrée d’Anthropic dans la catégorie légère de la famille Claude. Contrairement aux modèles plus coûteux Opus 5.5 et Sonnet 5.5 optimisés pour le raisonnement complexe et les agents de longue durée, Haiku 5.5 est conçu pour des charges à grand volume, sensibles aux coûts et à la latence. Anthropic le décrit comme « le modèle compact le moins cher, le plus rapide et le plus capable que nous ayons jamais publié ».
Usages typiques en production :
- Classification et routage de tickets en support client
- Extraction de champs et résumé de longs documents
- Compactage de l’historique de conversation pour des modèles plus grands
- Requêtes de type base de données et tâches de données structurées
- Sous-agents rapides gérant des étapes ciblées de code, d’outils ou de navigateur tandis qu’un modèle plus fort orchestre
Parce qu’il est nettement moins cher et plus rapide que son prédécesseur tout en comblant une grande partie de l’écart de qualité sur des tâches agentives pratiques, de nombreuses équipes réarchitecturent des pipelines afin que Haiku 5.5 traite la majorité des requêtes et n’escalade que les cas difficiles vers Sonnet ou Opus. Les premiers retours clients d’Asana, HubSpot, Box et autres mettent en avant des réductions de latence supérieures à 30 % et des gains mesurables de précision sur des évaluations internes à grand volume.
Spécifications techniques de Claude Haiku 5.5
| Spécification | Valeur | Notes |
|---|---|---|
| Model ID (Claude API) | claude-haiku-5-5 | Pas de suffixe de date |
| Amazon Bedrock | anthropic.claude-haiku-5-5 (ou profils global/us/eu/au/jp) | |
| Fenêtre de contexte | 1,000,000 tokens | ≈555k mots avec le nouveau tokenizer |
| Sortie max (Messages API) | 128,000 tokens | 300K avec Batch API + en-tête bêta |
| Modalités d’entrée | Texte + images | |
| Modalité de sortie | Texte | |
| Réflexion | Adaptative (activée par défaut) | Contrôlée via effort |
| Effort par défaut | medium | Options : low, medium, high, xhigh, max |
| Connaissance arrêtée | June 2026 | |
| Engagement de retrait | Not before October 7, 2027 | |
| Tokenizer | Plus récent (même famille que Claude 4.7+) | Même texte ≈30 % de tokens en plus que Haiku 4.5 |
Source : aperçu du modèle Anthropic et documentation de la plateforme.
La plus grande capacité de contexte et de sortie, combinée à la réflexion adaptative, rend Haiku 5.5 bien plus exploitable pour de vrais systèmes de production que les petits modèles antérieurs qui nécessitaient des troncatures agressives ou des budgets de réflexion fixes.
Réponses et vérifications de complétion
Lisez les blocs de contenu par type, plutôt que de supposer que content[0] est la réponse visible. Inspectez stop_reason avant d’accepter la sortie : max_tokens indique une génération tronquée et un refus requiert une réponse explicite de l’application. Pour les requêtes avec outils, traitez les blocs d’usage d’outil et retournez les résultats d’outil au format natif au lieu de les considérer comme une réponse texte terminée.
Qu’est-ce qui a changé par rapport à l’API Claude Haiku 4.5 ?
Changements de capacité, comportement et tarification
| Dimension | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| Fenêtre de contexte | 200K | 1M | 1M |
| Sortie maximale | 64K | 128K | 128K |
| Effort adaptatif | No | Yes | Yes |
| Entrée Anthropic / MTok | $1.00 | $0.10 | $2.00 |
| Sortie Anthropic / MTok | $5.00 | $0.50 | $10.00 |
| Positionnement | Ancien modèle rapide | Travail de routine à grande échelle | Tâches complexes plus difficiles |
Les prix de Haiku 5.5 dans cette comparaison s’appliquent aux prompts jusqu’à 100,000 tokens ; les prompts plus longs coûtent davantage. Ce sont des tarifs Standard Anthropic, pas les tarifs CometAPI. La comparaison sert de point de départ au routage, sans prétendre que les modèles performent de façon identique.
Pour les intégrations Haiku 4.5, les changements clés d’implémentation sont la réflexion adaptative au lieu d’un budget manuel, les contrôles d’effort, l’analyse sélective des blocs de contenu et des décomptes de tokens mis à jour. Le même texte peut utiliser environ 30 % de tokens d’entrée en plus. Recomptez des prompts représentatifs plutôt que de réutiliser les estimations de tokens de Haiku 4.5. La section de migration transforme ces changements en liste de contrôle de déploiement.
Améliorations de benchmarks rapportées
| Benchmark | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| OSWorld 2.1 (sous-ensemble hors ligne ; crédit partiel) | 15.7% | 72.4% | 83.9% |
| Terminal-Bench 4.0 | 0.0% | 39.2% | 70.6% |
| Humanity’s Last Exam (sans outils) | 10.2% | 45.9% | 56.9% |
| Chartography (sans outils) | 6.4% | 46.4% | 61.6% |
| GDPval-AA v2.1 (Elo) | 735 | 1,620 | 1,840 |
Anthropic rapporte les scores ci-dessus dans son résumé de lancement des benchmarks. Il s’agit de résultats d’évaluation rapportés, pas de tests en direct des exemples CometAPI de ce guide. Le 72.4 % d’OSWorld est un crédit partiel, pas un taux strict d’accomplissement de tâches.
La system card Haiku 5.5 décrit les conditions d’évaluation. Les évaluations standard de Haiku 5.5 utilisent la réflexion adaptative à effort max et l’échantillonnage par défaut sauf mention ; le défaut produit est medium. OSWorld utilise 82 tâches hors ligne, pas d’accès internet, une résolution 1080p et une limite de 500 actions. Terminal-Bench 4.0 utilise Claude Code en mode bare, sans sortie internet et 10 essais par tâche pour Haiku 5.5 ; la configuration de Sonnet diffère. Les lignes HLE et Chartography ci-dessus sont sans outils. GDPval-AA rapporte une cote Elo issue des évaluations Artificial Analysis. Adoptez le harnais, l’effort et les paramètres d’outils pertinents lors de la comparaison des résultats.
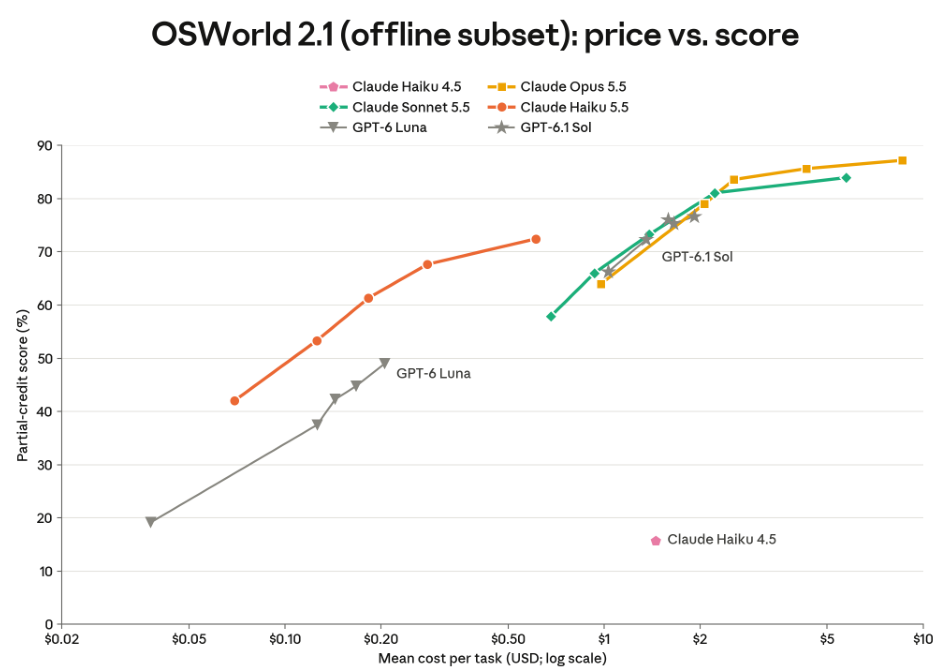
Le graphique OSWorld original d’Anthropic montre la relation entre effort, coût par tâche et score de crédit partiel. Il ne mesure pas la latence de l’API ni ne garantit les mêmes performances sur votre charge.
Les scores indiquent des performances nettement plus fortes en usage ordinateur et sur des tâches générales que Haiku 4.5, mais ils ne garantissent pas les mêmes résultats dans votre application. Exécutez un ensemble d’évaluation représentatif avant d’engager du trafic de production.
Le tableau de benchmarks et le graphique fourni sont conservés comme comparaisons de modèles. Ce sont des évaluations rapportées, et non des tests en direct des exemples CometAPI. Utilisez la même distribution de tâches, les mêmes paramètres d’effort et d’outils pour évaluer une application ; un score de benchmark n’établit pas la latence d’une passerelle ni votre propre taux de réussite.
Comment utiliser l’API Claude Haiku 5.5 via CometAPI
Créer une clé et choisir la route native
Créez un compte CometAPI, confirmez l’accès à claude-haiku-5-5 et générez une clé API côté serveur. Définissez COMETAPI_KEY dans votre environnement. Conservez la clé hors du contrôle de source et du code navigateur. Les clés Anthropic et CometAPI appartiennent à des fournisseurs différents ; utilisez la clé CometAPI pour chaque exemple de ce guide révisé.
export COMETAPI_KEY="your_cometapi_api_key"
pip install --upgrade anthropic
$env:COMETAPI_KEY="your_cometapi_api_key"
| Intégration | URL de base SDK | Chemin de requête | Identifiant |
|---|---|---|---|
| Messages compatibles Anthropic | https://api.cometapi.com | /v1/messages | COMETAPI_KEY |
| Chat Completions compatibles OpenAI | https://api.cometapi.com/v1 | /chat/completions | COMETAPI_KEY |
CometAPI supporte le format natif Messages et les blocs de contenu de Claude. Utilisez le SDK Anthropic avec l’URL racine de CometAPI. La route native Messages est privilégiée dans ce guide pour la réflexion spécifique à Claude et les blocs de contenu. La route compatible Chat Completions est une option pour une application de style OpenAI existante. Confirmez la prise en charge des champs avancés sur la route exacte de la passerelle.
Envoyer une requête minimale et vérifier le résultat
curl https://api.cometapi.com/v1/messages \
  -H "Content-Type: application/json" \
  -H "x-api-key: $COMETAPI_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -d '{
    "model": "claude-haiku-5-5",
    "max_tokens": 2048,
    "output_config": {"effort": "low"},
    "messages": [{"role": "user", "content": "Summarize three AI uses in customer support."}]
  }'
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",
    timeout=60.0,
    max_retries=2,
)

response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket: I cannot log in."}],
)
if response.stop_reason != "end_turn":
    raise RuntimeError(f"Unaccepted completion: {response.stop_reason}")
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
Enregistrez l’exemple Python comme example.py et exécutez python example.py. Un point de contrôle réussi est une réponse terminée avec du texte visible et des champs d’usage. Une erreur d’authentification signifie que la clé doit être vérifiée ; une erreur de modèle/route signifie que l’ID de modèle, l’endpoint ou l’accès au compte doit être vérifié.
Utiliser le même format natif depuis JavaScript
npm install @anthropic-ai/sdk
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com",
  timeout: 60_000,
  maxRetries: 2,
});
const response = await client.messages.create({
  model: "claude-haiku-5-5",
  max_tokens: 2048,
  output_config: {effort: "low"},
  messages: [{role: "user", content: "Extract product, quantity and price: 3 laptops at $900 each."}],
});
if (response.stop_reason !== "end_turn") {
  throw new Error("Unaccepted completion: " + response.stop_reason);
}
for (const block of response.content) {
  if (block.type === "text") console.log(block.text);
}
Utilisez une version Node.js prise en charge. Enregistrez le fichier sous example.mjs, définissez COMETAPI_KEY et exécutez node example.mjs. Enregistrez la version du SDK que vous validez pour le déploiement.
Adapter une application compatible OpenAI existante
Si votre application utilise déjà Chat Completions, installez le package openai et configurez le client séparé ci-dessous. Cette route retourne des choices au lieu de blocs de contenu natifs. Conservez une analyse spécifique à la route et testez la réflexion, les images et les outils avant de compter sur la traduction de passerelle.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    messages=[
        {"role": "system", "content": "Be concise and helpful."},
        {"role": "user", "content": "Explain API rate limits."},
    ],
)
print(response.choices[0].message.content)
Envoyer des images à l’API Claude Haiku 5.5
Utilisez une image avec une instruction qui précise les preuves et la sortie souhaitées. L’interface vision officielle accepte des blocs de contenu image avec des données base64, une URL d’image ou une référence de fichier téléversé prise en charge. Cet exemple lit un PNG local, place l’image avant la question et demande des valeurs vérifiables par rapport à la source.
Analysez un vrai PNG local via l’API native Anthropic Messages.
import os
import base64
from pathlib import Path
import anthropic

# Replace dashboard.png with a real PNG file you are authorized to analyze.
image_data = base64.b64encode(Path("dashboard.png").read_bytes()).decode("ascii")
anthropic_client = anthropic.Anthropic(api_key=os.environ["ANTHROPIC_API_KEY"])
response = anthropic_client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    output_config={"effort": "low"},
    messages=[{
        "role": "user",
        "content": [
            {"type": "image", "source": {
                "type": "base64", "media_type": "image/png", "data": image_data
            }},
            {"type": "text", "text": (
                "Read the visible dashboard metrics. List anomalies with their "
                "labels and values, and state when text is unreadable."
            )},
        ],
    }],
)
for block in response.content:
    if block.type == "text":
        print(block.text)
Utilisez le type MIME qui correspond au fichier réel. Vérifiez la lisibilité, les dimensions de l’image et les limites de taille de requête avant la soumission ; évitez d’envoyer des médias haute résolution qui n’aident pas la tâche. Pour CometAPI, changez la clé et l’URL de base racine comme indiqué dans l’exemple Messages, et vérifiez la prise en charge des images sur la route exacte.
Contrôler le raisonnement de Claude Haiku 5.5
Haiku 5.5 utilise la réflexion adaptative par défaut. La configuration officielle de la réflexion explique quand disabled est accepté et comment les blocs de réflexion sont retournés. Définissez l’effort via output_config.effort ; ne réutilisez pas l’ancien budget_tokens.
| Effort | Bon cas d’usage de départ | Compromis |
|---|---|---|
| low | Courte classification, extraction simple | Typiquement moins de tokens et latence |
| medium | Réponses de support, travail agentif courant | Équilibre par défaut |
| high | Analyse documentaire multi-étapes | Raisonnement potentiellement accru |
| xhigh | Évaluations difficiles | Plus de traitement et coût |
| max | Cas à forte intensité de raisonnement | Dépense de raisonnement potentielle la plus élevée |
Configurez la réflexion adaptative avec un effort low.
import osimport anthropicanthropic_client = anthropic.Anthropic( api_key=os.environ["ANTHROPIC_API_KEY"],)response = anthropic_client.messages.create( model="claude-haiku-5-5", max_tokens=4096, thinking={"type": "adaptive"}, output_config={"effort": "low"}, messages=[{"role": "user", "content": "Classify as billing, technical, or account: cannot log in."}],)for block in response.content: if block.type == "text": print(block.text)
Les développeurs peuvent désactiver la réflexion aux efforts low, medium et high, mais pas à xhigh ou max. La réflexion consomme des tokens de sortie facturés et le budget max_tokens même lorsque son texte est masqué. Un champ de réflexion vide peut toujours porter une signature ; cela ne prouve pas qu’aucun raisonnement n’a eu lieu. Conservez les blocs de contenu retournés inchangés lors de la poursuite de conversations avec outils.
Exemple de requête avec réflexion désactivée
Envoyez un corps de requête natif avec réflexion désactivée.
{ "model": "claude-haiku-5-5", "max_tokens": 1024, "thinking": {"type": "disabled"}, "output_config": {"effort": "low"}, "messages": [ {"role": "user", "content": "Return sentiment only: positive, neutral, negative."} ]}
Diffuser en streaming les réponses de Claude Haiku 5.5
Le streaming délivre le texte visible de façon incrémentale et améliore la réactivité des applications interactives. Considérez le texte diffusé comme provisoire jusqu’à ce que la requête se termine avec succès.
Diffusez le texte visible avec le SDK Python Anthropic.
import osimport anthropicanthropic_client = anthropic.Anthropic( api_key=os.environ["ANTHROPIC_API_KEY"],)with anthropic_client.messages.stream( model="claude-haiku-5-5", max_tokens=4096, output_config={"effort": "low"}, messages=[{"role": "user", "content": "Explain API caching."}],) as stream: for text in stream.text_stream: print(text, end="", flush=True)
Tarification de l’API Claude Haiku 5.5
Comparer les tarifs par token et les paliers de longueur de prompt
Tarifs vérifiés le 8 octobre 2026. Le tableau compare la tarification Standard Anthropic avec les tarifs CometAPI publiés, en USD par million de tokens. Le palier est déterminé par la longueur du prompt : jusqu’à 100,000 tokens contre plus de 100,000. Les requêtes plus longues utilisent les tarifs du palier applicable, et pas simplement une majoration sur les tokens excédentaires. La facturation du compte, l’usage du cache et les outils optionnels doivent être rapprochés séparément.
| Catégorie de tokens | Anthropic ≤100K | CometAPI ≤100K | Anthropic >100K | CometAPI >100K |
|---|---|---|---|---|
| Entrée | $0.10 | $0.08 | $0.50 | $0.40 |
| Sortie | $0.50 | $0.40 | $2.50 | $2.00 |
| Lecture de cache | $0.01 | $0.008 | $0.05 | $0.04 |
| Écriture cache 5 min | $0.125 | $0.10 | $0.625 | $0.50 |
| Écriture cache 1 h | $0.20 | $0.16 | $1.00 | $0.80 |
L’instantané de tarifs de l’article original est conservé ci-dessus. Vérifiez la liste actuelle CometAPI et la facturation du compte avant achat ou déploiement ; le tarif d’entrée initial de la liste n’est pas une citation complète pour chaque palier de longueur de prompt, opération de cache ou outil optionnel.
Exemple : coût de 100,000 requêtes de support
Supposons 100,000 requêtes mensuelles, chacune avec 2,000 tokens d’entrée et 300 tokens de sortie facturés, y compris toute réflexion générée. Chaque prompt relève du palier jusqu’à 100K. Exclure la mise en cache, les frais d’outils et les retours.
| Composant | Usage | Anthropic | CometAPI |
|---|---|---|---|
| Entrée | 200M tokens | $20.00 | $16.00 |
| Sortie | 30M tokens | $15.00 | $12.00 |
| Total | 100,000 requêtes | $35.00 | $28.00 |
Dans ces hypothèses, l’écart illustratif est de $7 par mois, soit 20 %. Les coûts de production dépendent des longueurs de requête, de la réflexion masquée, de la mise en cache et des comportements de retry.
Utilisez les décomptes de tokens actuels du modèle dans le calcul. Coût = tokens d’entrée × tarif d’entrée applicable / 1,000,000 + tokens de sortie facturés × tarif de sortie applicable / 1,000,000, plus les frais distincts de cache, d’outils et de retours. Les tokens de réflexion font partie de la sortie facturée.
Réduire le coût sans perdre la qualité des tâches acceptées
| Optimisation | Action | Bénéfice |
|---|---|---|
| Réglage d’effort | Utiliser low là où la qualité le permet | Moindre overhead de raisonnement |
| Réduction de prompt | Retirer l’historique redondant | Moins de tokens d’entrée |
| Mise en cache des prompts | Garder le contexte réutilisé stable | Coût d’entrée répété plus bas |
| Streaming | Afficher les tokens au fil de l’eau | Meilleure réactivité perçue |
| Validation de schéma | Rejeter tôt les enregistrements malformés | Moins de retouches aval |
| Routage de modèles | Escalader les cas complexes | Meilleur équilibre coût/qualité |
| Traitement par lots | Batch des requêtes éligibles hors ligne | Économies potentielles supplémentaires |
Ne sélectionnez pas automatiquement l’effort le plus bas. Un appel individuel moins cher peut augmenter les coûts totaux s’il entraîne davantage de retours. Évaluez la précision, la latence p50/p95, l’usage de tokens et le coût par tâche réussie.
Pour la mise en cache des prompts, réutilisez un préfixe stable et inspectez la création de cache et l’usage de lecture de cache plutôt que de supposer un hit. Haiku 5.5 a un prompt minimum de 512 tokens cacheable sur l’API Claude documentée. Changer l’effort peut invalider des préfixes mis en cache ; conservez des réglages stables au sein d’une conversation. Une fenêtre de contexte de 1M est un plafond de capacité, pas une recommandation d’envoyer chaque document à chaque tour.
Conservez un préfixe réutilisable stable pour la mise en cache, raccourcissez les entrées inutiles et évaluez les changements d’effort. Le streaming améliore la réactivité perçue plutôt que de réduire automatiquement la facturation. Comparez le coût par tâche acceptée sur l’ensemble du flux, y compris les retours et les appels d’outils.
Guide de migration de Claude Haiku 4.5 vers Haiku 5.5
Mettre à jour l’intégration et le format de requête
| Domaine | Action de migration |
|---|---|
| Model ID | Remplacer par claude-haiku-5-5 |
| Réflexion | Remplacer le budget_tokens manuel par la réflexion adaptative |
| Effort | Utiliser output_config.effort si nécessaire |
| Échantillonnage | Omettre temperature, top_p et top_k ; toute valeur top_k n’est pas prise en charge |
| Analyse de réponse | Gérer plusieurs types de blocs de contenu |
| Budget de sortie | Laisser assez de marge pour la réflexion et la sortie finale |
| Prefill | Retirer le préremplissage assistant non pris en charge |
| Mise en cache | Retester les prompts lors d’un changement d’effort |
| Intégrations d’outils | Vérifier les versions d’outils prises en charge |
Pour la route CometAPI utilisée ici, conservez COMETAPI_KEY et l’URL de base native tout en changeant l’ID de modèle et la configuration de requête. Remplacez la réflexion activée avec budget par la réflexion adaptative et l’effort. Retirez le préremplissage assistant et omettez les paramètres d’échantillonnage. Préservez la distinction entre le tableau de contenu natif de Claude et la réponse choices de la route compatible.
Préserver l’état et recalculer les budgets
Le guide de migration officiel Haiku 5.5 rapporte environ 30 % de tokens d’entrée en plus pour un texte identique par rapport à Haiku 4.5. Recomptez des prompts représentatifs et retunez les limites avant de déplacer du trafic. Les blocs de réflexion retournés ne fonctionnent que dans le compte qui les a produits ou un compte lié ; un changement de compte peut silencieusement supprimer ces blocs. Préservez un préfixe de conversation en append-only plutôt que de modifier les messages antérieurs après génération. Inspectez stop_reason, y compris max_tokens et refusal, et traitez-les explicitement avant d’accepter la sortie.
Recomptez des prompts représentatifs avec le modèle cible et retunez max_tokens, les limites de latence et les estimations de coût de requête. Testez les conversations stockées sur le compte et la route de passerelle qui les rejoueront ; n’assumez pas que des blocs de réflexion signés sont portables entre des comptes non liés ou des préfixes de conversation réécrits.
Conclusion
Claude Haiku 5.5 représente un véritable point d’inflexion pour une IA à haut débit et rentable. En offrant des performances agentives et d’usage ordinateur nettement meilleures à environ un dixième du prix de la précédente version Haiku sur la majorité des requêtes, Anthropic rend pratique le déploiement à grande échelle de modèles compacts capables. Que vous appeliez l’API officielle, passiez par Amazon Bedrock, ou utilisiez une passerelle unifiée comme CometAPI pour des économies et une simplicité opérationnelle supplémentaires, la combinaison de vitesse, de capacité et de prix ouvre de nouvelles possibilités produits auparavant peu économiques.