Construire avec CometAPIBesoin d'une seule API pour plusieurs modèles ?Testez le workflow dans Playground, puis créez une clé API lorsque le modèle et le coût correspondent à votre cas d'usage.
Hy4 vs GPT-6.1 Terra : benchmarks, tarification de l'API et quel modèle choisir
Comparez Hy4 et GPT-6.1 Terra sur la programmation, la recherche, les spécifications officielles de l’API et la tarification de CometAPI. Trouvez le modèle adapté à votre charge de travail.
Deon GoodwinÉquipe de recherche sur les modèles IA et API
Hy4 est un excellent point de départ pour la recherche financière et la génération de texte à grand volume ; GPT-6.1 Terra est un excellent point de départ pour le codage en terminal et le débogage. Les deux acceptent du texte et des images et prennent en charge l'utilisation d'outils. Les différences les plus claires concernent la performance par tâche, la capacité de sortie et le prix : Terra mène le test de codage en terminal ci-dessous, tandis que Hy4 mène les tests de finance et de recherche et coûte moins cher aux tarifs CometAPI indiqués.
Points clés
Choisissez selon la charge de travail : Hy4 pour la recherche et les applications à forte production ; Terra pour le codage en terminal et le débogage.
Les deux offrent des fenêtres de contexte d'environ un million de jetons. Terra fournit un budget de sortie maximal plus important.
Revu pour la clarté, l'attribution des sources et la terminologie API actuelle.
Terra mène Terminal-Bench 4.0 de 10.10 points de pourcentage ; le modèle de Tencent mène Finance Agent v2.1 de 8.74 points dans les résultats de Vals AI.
L'exemple CometAPI de 10M jetons en entrée et 2M en sortie coûte $10.672 contre $16.00 aux tarifs de base affichés.
Alignez le point de terminaison, le comportement des outils et les paramètres de raisonnement sur votre application avant de changer de fournisseur.
Spécifications, instantanés de benchmarks et prix vérifiés le 6 novembre 2026.
Hy4 vs GPT-6.1 Terra : spécifications et capacités
Hy4 combine compréhension du texte et de l'image avec raisonnement et utilisation d'outils, y compris des workflows à travers des interfaces en ligne de commande et graphiques. GPT-6.1 Terra prend en charge le raisonnement visuel, l'utilisation de l'ordinateur et la rédaction, avec des contrôles explicites de l'effort de raisonnement et un budget de sortie plus large. Le tableau ci-dessous compare les spécifications de Tencent et d'OpenAI.
Spécifications API officielles
Les deux modèles peuvent travailler avec de grandes collections de documents et des bases de code. Pour les prompts longs, réservez aussi du budget pour la réponse : Tencent indique une entrée maximale de 960K pour Hy4. La petite différence de capacité de contexte annoncée est moins utile pour la sélection que la façon dont chaque modèle utilise correctement votre matériel.
Terra offre plus d'espace pour une longue réponse, avec jusqu'à 128,000 jetons de sortie contre la limite publiée de 64K pour Hy4. Cela aide lorsqu'un rapport ou un livrable de code doit tenir en une seule réponse. Les jetons de raisonnement consomment également le budget de sortie de Terra.
Contrôles de raisonnement
Terra propose six réglages d'effort de raisonnement : none, low, medium, high, xhigh et max, avec medium par défaut. Cela donne aux applications un moyen explicite d'ajuster l'effort d'inférence selon la tâche. Une requête de classification et une tâche de débogage difficile n'ont pas à utiliser le même budget.
Le lancement de Tencent décrit un raisonnement combiné à la perception visuelle et à l'utilisation d'outils, mais ne définit pas un contrôle équivalent en six niveaux dans cette annonce. Traitez les paramètres de raisonnement comme spécifiques à l'endpoint : ne copiez pas le réglage d'effort d'un fournisseur dans une autre requête en supposant qu'il a la même signification.
Hy4 vs GPT-6.1 Terra : performances
Vals AI fournit des résultats directs pour les deux modèles sur des tâches de codage, de finance, de recherche juridique et de fiscalité. Ces scores montrent où chaque modèle est un candidat utile pour votre charge de travail.
Résultats indépendants des benchmarks et conditions de test
Les résultats suivants du Vals Index v2.2 ont été vérifiés le 10 novembre 2026. Des scores plus élevés sont meilleurs.
Vals AI indique une température de 0.9, top_p 1.0 et une limite de sortie de 65,536 jetons pour Hy4 ; Terra utilise un effort de raisonnement max et une limite de sortie de 128,000 jetons. Ces réglages diffèrent, donc lisez les résultats comme des comparaisons des configurations testées plutôt que des exécutions à budget égal.
L'avance de Terra est plus grande sur les tâches en terminal que sur la génération de code : 10.10 points de pourcentage sur Terminal-Bench 4.0 contre 2.99 points sur Vibe Code Bench. Cela fait du débogage et du développement en ligne de commande les endroits les plus clairs pour commencer à évaluer Terra.
Hy4 mène Finance Agent, Legal Research Bench et Tax Agent Bench de 8.74, 15.39 et 17.32 points. Les workflows de recherche qui rassemblent des preuves et appliquent des règles métier sont donc des points de départ prometteurs pour Hy4.
L'écart global est de 1.19 point de pourcentage, et les intervalles d'incertitude publiés se chevauchent.
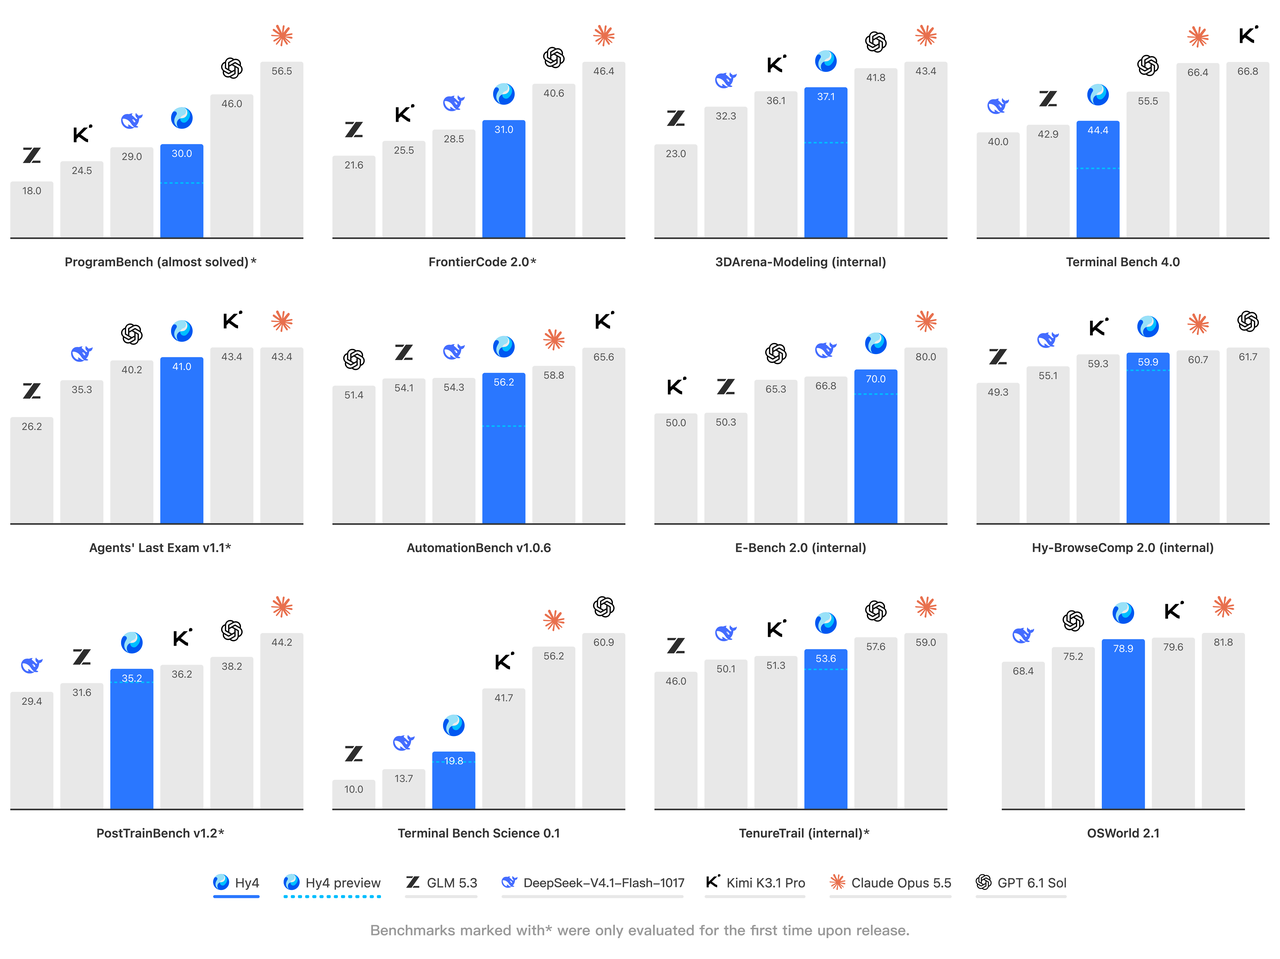
Benchmarks de lancement de Hy4 par Tencent
Le graphique de lancement de Tencent ajoute des résultats pour le codage et l'utilisation de l'ordinateur. Il compare Hy4 avec GPT-6.1 Sol ; utilisez le tableau Vals AI ci-dessus pour la comparaison directe avec GPT-6.1 Terra.
Résultats de benchmarks Hy4 rapportés par Tencent, novembre 2026. Le modèle OpenAI montré est GPT-6.1 Sol.
Dans le graphique de lancement de Tencent, Hy4 obtient 44.4 sur Terminal Bench 4.0 et 78.9 sur OSWorld 2.1. Ces chiffres décrivent l'environnement d'évaluation de Tencent et sont distincts des scores Vals AI ci-dessus.
Flux de travail de vision et d'utilisation de l'ordinateur
Tencent présente la compréhension d'images dans la version officielle et décrit un entraînement pour des workflows couvrant des outils en ligne de commande, des interfaces graphiques, Blender et CAD. Cela place l'analyse de graphiques et les tâches logicielles visuelles au centre de son positionnement.
OpenAI positionne son modèle pour des workflows basés sur l'écran, la rédaction concise et des corrections de code ciblées. Pour une application de catalogue, testez l'appariement photo-produit ; pour un travail technique, utilisez des dessins avec de petites étiquettes et mesures ; pour l'automatisation de bureau, vérifiez les fichiers enregistrés et l'état de l'application.
Un bon jeu de tests visuels devrait séparer la lecture de l'action. Mesurez d'abord si le modèle extrait les bonnes valeurs ou identifie le bon élément d'interface. Puis mesurez si le workflow complet atteint le résultat requis sans clics incorrects, fichiers manquants ou intervention humaine inutile.
Vitesse et latence de bout en bout
Pour le chat, les mesures de vitesse pertinentes sont le délai avant le début de la réponse et le temps jusqu'à la fin. Pour les agents, mesurez la tâche complète, y compris l'exécution des outils et d'éventuelles réparations.
Comparez les deux modèles sur des tâches types et exigeantes au niveau de concurrence attendu. Suivez la latence médiane et de queue en parallèle du taux de réussite : une réponse rapide n'est utile que si elle accomplit le travail.
Hy4 vs GPT-6.1 Terra : coût
Comparez d'abord les tarifs de jetons, puis tenez compte du travail nécessaire pour obtenir un résultat exploitable. Les prix ci-dessous sont les tarifs de base CometAPI en dollars américains par million de jetons ; ils sont distincts des coûts par test rapportés par Vals AI.
Tarification CometAPI pour l'entrée et la sortie
Cost item
Hy4 API in CometAPI
GPT-6.1 Terra API in CometAPI
Input per million tokens
$0.6672
$0.80
Output per million tokens
$2.00
$4.00
Le tableau ci-dessous utilise les tarifs de base listés par CometAPI en dollars américains par million de jetons. Comparez l'entrée et la sortie séparément, puis calculez le coût de votre requête type.
Exemple de coût pour 10,000 requêtes
Considérez 10,000 requêtes, chacune utilisant 1,000 jetons d'entrée non mis en cache et 200 jetons de sortie facturables. Sur l'ensemble des requêtes, cela représente 10 millions de jetons d'entrée et 2 millions de jetons de sortie. En utilisant les prix de base CometAPI ci-dessus :
Hy4 coûte environ 33.3% de moins dans cet exemple. Cette estimation couvre l'entrée non mise en cache et la sortie facturable ; ajoutez les coûts de cache, d'outils et de réessais lors de la budgétisation d'un workflow complet.
Facturation directe fournisseur et requêtes à contexte long
Pour les documents longs sur l'API directe d'OpenAI, les prompts dépassant 272K jetons d'entrée déclenchent des tarifs d'entrée et de cache à 2× et des tarifs de sortie à 1.5× pour la requête complète. Appliquez les règles de facturation du service que vous utilisez ; l'exemple CometAPI ci-dessus utilise les tarifs de base CometAPI. OpenAI pricing details.
Coût par tâche acceptée
Une tâche acceptée est une tâche qui répond aux contrôles de qualité et de complétion de votre application. Comptez toutes les tentatives, l'utilisation d'outils et le travail de revue nécessaires pour atteindre ce résultat, y compris les dépenses sur les tentatives qui échouent.
Coût par tâche acceptée = total des coûts de modèle, de réessai, d'outils et de revue humaine ÷ tâches qui passent les contrôles d'acceptation.
Un appel plus cher peut rester économique s'il évite plusieurs tentatives de réparation. À l'inverse, lorsqu'un modèle moins coûteux atteint le seuil de qualité, payer un tarif plus élevé pour chaque tâche peut apporter peu de valeur.
Quel modèle choisir : Hy4 ou GPT-6.1 Terra ?
Commencez par le modèle dont les points forts correspondent à votre charge de travail principale. Utilisez les choix suivants pour établir une présélection, puis comparez la qualité et le coût des tâches terminées.
Quand choisir Hy4
Choisissez Hy4 en priorité pour la recherche financière, l'analyse de documents juridiques ou fiscaux et les applications qui génèrent beaucoup de texte. Ses avances sur les trois benchmarks de domaine en font un candidat utile pour la recherche riche en preuves. Aux tarifs CometAPI indiqués, son prix de sortie est la moitié de celui de Terra, ce qui peut faire une différence importante pour la rédaction et le reporting à grand volume.
Pour le travail de recherche, jugez la réponse finale par l'exactitude des sources, les calculs et la couverture de la question. Hy4 est le meilleur choix lorsqu'il répond à ces exigences à un coût total inférieur, incluant revue et réessais.
Quand choisir GPT-6.1 Terra
Choisissez GPT-6.1 Terra en priorité pour le codage en terminal, le débogage et les corrections de code. Son avance de 10.10 points sur Terminal-Bench est le signal de codage le plus fort dans cette comparaison. Le budget de sortie plus large le rend également digne d'un test pour des rapports longs et des réponses de code substantielles.
Évaluez Terra selon que ses correctifs passent vos tests et que ses livrables sont complets. Pour le travail visuel ou de bureau, comparez les deux modèles sur vos écrans, graphiques et fichiers réels, en vérifiant le résultat final enregistré.
Routage de la recherche et du code vers différents modèles
Une charge de travail mixte peut bénéficier de l'utilisation des deux modèles. Un assistant d'analyse financière pourrait utiliser Hy4 pour la recherche et la rédaction de rapport, puis appeler Terra lorsqu'un script d'analyse nécessite un débogage :
Envoyez la collecte de preuves et la rédaction de rapport à Hy4.
Vérifiez les citations, les valeurs sources et les calculs avant d'accepter le rapport.
Routez un script d'analyse défaillant vers Terra avec le code, la sortie d'erreur et le comportement attendu.
Exécutez le script corrigé et appliquez les mêmes vérifications des preuves avant de renvoyer le résultat final.
Utilisez un second modèle lorsqu'il améliore suffisamment le résultat final pour couvrir le coût supplémentaire et le travail d'intégration.
Où accéder à Hy4 et GPT-6.1 Terra ?
Accès via les fournisseurs officiels
Accédez à Hy4 via Tencent Cloud TokenHub et à GPT-6.1 Terra via l'API d'OpenAI. Utilisez la documentation du fournisseur pour l'authentification, les IDs de modèles et la facturation.
Accès via CometAPI et compatibilité des outils
CometAPI propose les deux modèles sous les IDs hy4 et gpt-6.1-terra. Ses pages modèles listent des exemples de requête et les prix pour chaque route : Hy4 et GPT-6.1 Terra.
Pour les applications avec outils, vérifiez la prise en charge des appels de fonctions et des sorties structurées sur la route sélectionnée. Sur l'API directe d'OpenAI, l'appel d'outils de Terra nécessite l'API Responses.
Comment tester et déployer votre choix
Avant de modifier le trafic de production, comparez les modèles sur des tâches représentatives en utilisant les mêmes entrées, outils et critères de réussite. Enregistrez les réussites, le coût total et le temps écoulé, puis déployez progressivement la route la plus robuste.
Incluez des requêtes de routine et des cas difficiles importants pour vos utilisateurs.
Vérifiez les arguments d'outil, les sorties structurées, les erreurs et le statut de complétion.
Définissez des limites de réessai et des déclencheurs de rollback avant d'envoyer du trafic réel.
Conclusion
Choisissez Hy4 lorsque la qualité de recherche et des coûts de génération de texte plus faibles sont vos priorités. Choisissez GPT-6.1 Terra lorsque le codage en terminal, le débogage et un budget de sortie plus important comptent le plus.
Pour une application mixte, commencez par un modèle par grande charge de travail et ajoutez une seconde route lorsqu'elle améliore les résultats. Le meilleur choix est celui qui accomplit vos tâches avec précision à un coût soutenable.
Specification
Hy4 · Tencent Cloud official specifications
GPT-6.1 Terra · OpenAI official specifications
Developer
Tencent
OpenAI
API model ID
hy4
gpt-6.1-terra
Input / output
Texte et images / texte
Texte et images / texte
Context window
1024K jetons (notation Tencent)
1,050,000 jetons
Maximum output
64K jetons (notation Tencent)
128,000 jetons
Tool calling
Pris en charge (Function Calling)
Pris en charge ; nécessite l'API Responses
Structured outputs
Pris en charge
Pris en charge
Main applications
Génie logiciel, analyse financière et tâches d'agent de longue durée
Raisonnement visuel, usage de l'ordinateur, rédaction et tâches de code ciblées
Benchmark or metric
Hy4: Vals AI results
GPT-6.1 Terra: Vals AI results
Interpretation
Vals Index
59.35% ± 1.08
60.54% ± 0.99
Terra +1.19 points de pourcentage
Terminal-Bench 4.0
39.39%
49.49%
Terra +10.10 points
Vibe Code Bench v1.1
81.01%
84.00%
Terra +2.99 points
Finance Agent v2.1
64.70%
55.96%
Modèle Tencent +8.74 points
Legal Research Bench
41.35%
25.96%
Modèle Tencent +15.39 points
Tax Agent Bench
34.40%
17.08%
Modèle Tencent +17.32 points
Hy4 vs GPT-6.1 Terra : benchmarks, tarification de l'API et quel modèle choisir - CometAPI