
TL;DR
Au 9 octobre 2026, des rapports suggèrent que Kimi K3.1 pourrait arriver ce mois-ci, mais les sources examinées n’établissent ni une date de lancement officielle, ni une tarification finale, ni des résultats de benchmarks spécifiques à K3.1. Les indicateurs Low / High / Max, Extra Long, Agent et Swarm signalés recoupent des fonctionnalités déjà présentes dans K3. La mise à niveau potentielle n’a d’intérêt que si elle améliore l’efficacité du raisonnement, la fiabilité en long contexte et le coût par tâche achevée ; des libellés de configuration, à eux seuls, ne peuvent pas démontrer ces gains.
Key Takeaways
- Calendrier de sortie : octobre est une possibilité rapportée par les médias, sans engagement de lancement officiel établi par les sources citées.
- Indices techniques : Low / High / Max et une option annoncée à 1M tokens se recoupent avec les capacités de K3 ; l’architecture et les limites finales de K3.1 restent non confirmées.
- Flux d’agent : les indicateurs Agent, Swarm, search et batch suggèrent des travaux d’intégration possibles plutôt que des améliorations mesurées.
- Performances et tarification : les résultats et tarifs publiés pour K3 servent de références, pas de benchmarks ni de tarifs pour K3.1.
- Prêt API : confirmez les IDs de modèle activés, les paramètres documentés et l’accès du compte avant de déployer K3.1 via CometAPI.
What is Kimi K3.1?
Kimi K3.1 est une itération annoncée de la famille de modèles Kimi de Moonshot AI. Des identifiants de configuration divulgués suggèrent des travaux sur le raisonnement, le long contexte et les flux d’agent. Ses spécifications finales, sa date de sortie et sa tarification ne sont pas établies par les sources examinées ; il convient donc de le considérer comme un modèle prospectif plutôt qu’une sortie publique confirmée.
What Do We Know About Kimi K3.1?
La publication d’origine montre un identifiant lié à K3.1
Le 23 septembre 2026, @MaxForAI a publié une capture d’écran de configuration montrant k3d1-agent. Il s’agit de l’image originale associée à la publication ; sa provenance interne et son statut de production n’ont pas été authentifiés de manière indépendante.
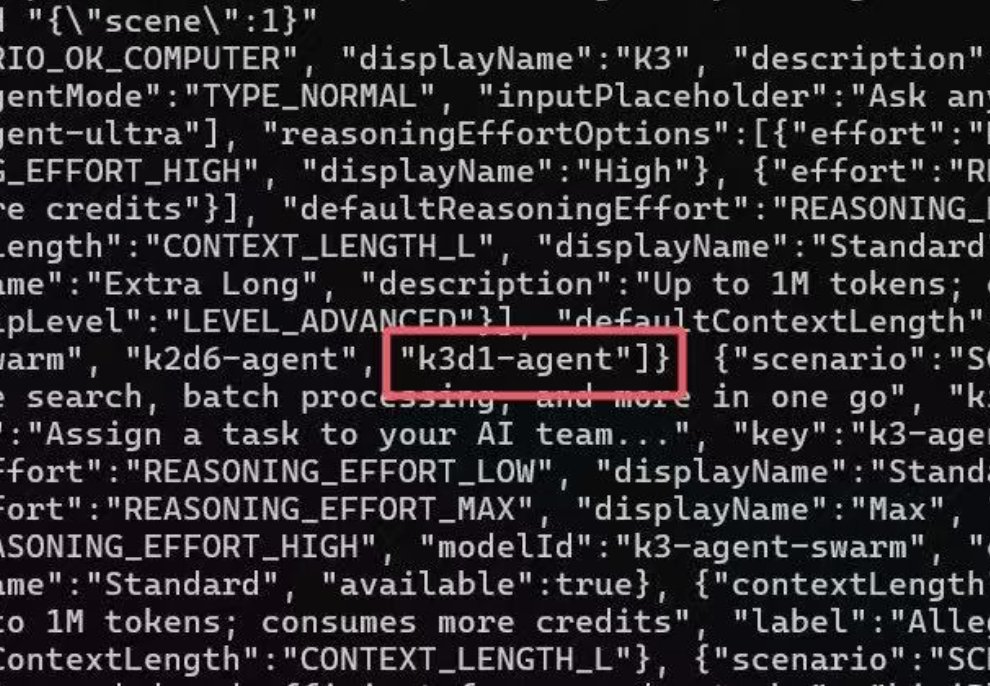
Source de l’image : publication originale de @MaxForAI. L’image contient des réglages d’effort de raisonnement et de contexte, ainsi que des identifiants d’agent. Les chaînes de configuration visibles ne prouvent pas que chaque option appartient à K3.1.
Le rapport du 23 septembre de Wccftech interprète la capture comme un signal de développement de K3.1. Le suivi du 24 septembre d’IT Home reprend les options signalées. Ces articles sont des interprétations secondaires de la même fuite, et non une confirmation indépendante de l’état de préparation au lancement.
Les options signalées pointent vers le raisonnement et des flux d’agent
Les rapports décrivent des réglages de raisonnement Low / High / Max, une option Extra Long allant jusqu’à 1M tokens, ainsi que des indicateurs Agent, Swarm, search et batch. Ces indices suggèrent une intégration de flux possible. Ils ne révèlent ni une architecture finale, ni un gain de performance validé, ni un schéma d’API publique pris en charge.
Les rapports médiatiques divergent sur la fenêtre de lancement
Wccftech décrit une arrivée possible avant octobre, tandis qu’IT Home indique octobre 2026. Cette divergence limite l’utilité de l’un ou l’autre pronostic. Aucun des deux articles ne fournit une annonce de sortie datée de Moonshot.
Un identifiant de modèle peut représenter un checkpoint privé, une voie inachevée, un déploiement par étapes ou un aperçu contrôlé par accès. Il ne peut pas, à lui seul, établir une sortie API commerciale. Les significations précises et la disponibilité des indicateurs divulgués restent incertaines.
When Will Kimi K3.1 Be Released?
Les sources examinées n’établissent pas de date de sortie officielle pour Kimi K3.1. IT Home indique octobre 2026, tandis que la couverture antérieure de Wccftech évoque une arrivée avant octobre. Il s’agit de prévisions médiatiques divergentes, et non d’un calendrier de développement vérifié. Une capture d’écran ne peut pas établir des dates de déploiement, l’éligibilité des comptes ou l’état de préparation au déploiement.
Recherchez une annonce Moonshot datée, des IDs de modèle pris en charge, une documentation développeur et des conditions d’accès avant de considérer qu’une date de lancement est confirmée. La tarification et des évaluations reproductibles spécifiques à K3.1 sont des preuves distinctes nécessaires pour les décisions de déploiement.
What Specifications Could Kimi K3.1 Offer?
La base technique la plus solide est l’actuel Kimi K3, une sortie de juillet 2026 avec une architecture sparse MoE à 2,8 billions de paramètres, une entrée visuelle native, et une fenêtre de contexte communément décrite comme 1M tokens. Les sources citées n’établissent ni l’architecture de K3.1, ni le nombre de paramètres, ni des résultats d’évaluation spécifiques au modèle.
Le résumé officiel du modèle de Moonshot précise 104B de paramètres activés et une fenêtre de contexte de 1,048,576 tokens. Son annonce d’open-weight du 27 juillet confirme la publication des poids de K3. Ces spécifications s’appliquent à K3, pas au K3.1 supposé.
| Spécification | Kimi K3 | Kimi K3.1 |
|---|---|---|
| Sortie | juillet 2026 | Potentiellement octobre 2026 |
| Paramètres totaux | 2,8 billions | Non divulgué |
| Paramètres activés | 104 billions (résumé officiel du modèle) | Non divulgué |
| Architecture | Sparse MoE, KDA, AttnRes | Non divulgué |
| Contexte | 1,048,576 tokens (environ 1M) | Jusqu’à 1M suggéré |
| Raisonnement | Low / High / Max dans la documentation actuelle de Kimi Code | Indicateurs Low / High / Max |
| Vision | Entrée visuelle native | Non confirmé |
| Swarm | Fonctionnalité Kimi Swarm existante | Indicateur Swarm signalé |
| Tarif API | Tarif K3 publié | Tarification finale inconnue |
| Poids | Poids de K3 publiés | Inconnu |
What Features Are Reported for Kimi K3.1?
Les trois thèmes ci-dessous combinent les indices rapportés sur K3.1 avec les capacités documentées de K3. Ils expliquent ce que les réglages pourraient signifier sans présenter des fonctionnalités supposées de K3.1 comme des spécifications confirmées.
Trois niveaux de raisonnement offrent un compromis d’effort
Low, High et Max sont des libellés de configuration rapportés pour K3.1. Ils décrivent un compromis d’effort, pas une nouvelle architecture. La documentation actuelle de Kimi Code prend en charge low / high / max pour K3, avec high comme valeur par défaut. Il s’agit d’un réglage de Kimi Code ; il ne faut pas supposer que les valeurs par défaut et les droits sont identiques dans toutes les API ou tous les produits.
Low peut convenir à l’extraction, aux questions-réponses simples et à la classification courante lorsque la latence plus faible est importante. High peut offrir un équilibre pratique pour le développement en plusieurs étapes et le travail documentaire. Max peut allouer un budget de raisonnement supérieur aux tâches de codage ou de recherche difficiles, avec une latence plus élevée et un coût possible. Ces correspondances de tâches sont des interprétations à tester, pas des garanties vérifiées pour K3.1.
Ces exemples de charges de travail sont des interprétations analytiques, et non des garanties de service vérifiées pour K3.1. Les développeurs doivent comparer la qualité par unité de dépense : une exécution à effort élevé peut coûter davantage par tentative, mais moins de reprises peuvent réduire le coût global du flux. La mise à niveau significative serait une réussite accrue des tâches avec un budget de tokens et d’outils comparable.
Une option à 1M tokens étend la base du long contexte
Une fenêtre d’un million de tokens peut accueillir des dépôts de code substantiels, de longs documents techniques, des historiques de projet et de vastes traces d’outils. Mais la longueur maximale du contexte n’est pas synonyme d’utilisation précise d’informations éloignées. Un modèle productif doit toujours retrouver les bons faits, maintenir la cohérence entre documents et conserver une latence de préremplissage gérable.
Évaluez le long contexte en testant la récupération à différentes positions de prompt, la cohérence entre documents et le temps jusqu’au premier token. Mesurez également la réutilisation du cache et le coût de la conservation ou de la compression de l’historique de l’agent. Une limite nominale de 1M tokens n’est utile que si le modèle peut retrouver des preuves éloignées avec précision, dans une latence et un budget acceptables.
Moonshot rapporte un score BrowseComp de K3 de 90,4 avec un contexte de 1M tokens et sans gestion de contexte. Il s’agit d’une condition d’évaluation spécifique à K3, distincte des résultats en contexte compacté et de toute revendication de performance de K3.1.
Les indicateurs Agent et Swarm suggèrent une exécution coordonnée des tâches
Les identifiants liés aux agents et les indicateurs Swarm sont sans doute plus intéressants que le nombre de contexte. Kimi prend déjà en charge le travail multi-agent ; par conséquent, la mise à niveau supposée devrait améliorer le routage, la délégation, l’agrégation des résultats et le contrôle des coûts plutôt que de simplement ajouter un libellé Swarm.
Dans un flux orchestré plausible, un coordinateur décompose une requête complexe en sous-tâches de recherche, codage, test et synthèse. Des agents spécialisés travaillent en parallèle, renvoient des preuves, et sont conciliés par le coordinateur. Un tel parallélisme peut réduire le temps écoulé tout en augmentant le nombre total d’appels au modèle ; la vitesse murale et le coût doivent donc être rapportés séparément.
La documentation officielle Agent Swarm de Kimi décrit l’exécution parallèle d’agents existante. L’exemple ci-dessous illustre comment une telle orchestration peut répartir le travail ; il n’établit pas la configuration finale de K3.1 ni une topologie Swarm requise.
Un agent de recherche peut récupérer des sources et vérifier des citations ; un agent de codage peut modifier des modules et renvoyer des preuves d’exécution ; un agent d’analyse peut comparer des alternatives avec des calculs reproductibles. Un coordinateur assigne les tâches, résout les désaccords et plafonne le budget. La sortie de chaque agent nécessite une vérification avant que le résultat combiné soit accepté.
Pour K3.1, les développeurs doivent rechercher des benchmarks reproductibles de tâches agent de bout en bout réussies, la reprise après échec, la gestion des désaccords entre agents, le nombre d’appels d’outils et la dépense totale. Des indicateurs de configuration seuls ne peuvent pas établir une amélioration.
How Does Kimi K3.1 Compare with K3 on Benchmarks?
Aucun tableau de benchmarks spécifique à K3.1 vérifié n’est disponible. Les chiffres suivants proviennent des évaluations officielles de K3 par Moonshot, présentés uniquement comme base de comparaison. Des harnais de modèle et des paramètres d’évaluation différents limitent les inférences strictement comparables.
| Benchmark | Kimi K3 | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| DeepSWE | 67.5 | 73.0 | 70.0 |
| Terminal-Bench 2.1 | 88.3 | 88.8 | 88.0 |
| FrontierSWE | 81.2 | 71.3 | 86.6 |
| Program Bench | 77.8 | 77.6 | 76.8 |
| Kimi Code Bench 2.0 | 72.9 | 64.8 | 76.9 |
| SWE Marathon | 42.0 | 39.0 | 35.0 |
Écart de source : le visuel original affiche Fable 5 à 84,6 sur Terminal-Bench 2.1, tandis que le tableau d’évaluation du dépôt officiel indique 88,0. Le tableau ci-dessus suit le dépôt ; l’image officielle est reproduite sans altération.
Les notes d’évaluation précisent K3 en effort max, temperature 1.0 et top-p 1.0. DeepSWE v1.1 utilise Kimi Code ici ; le résultat mini-SWE-agent cité séparément est 67,3. Terminal-Bench utilise Kimi Code pour K3, Terminus 2 pour Fable 5, et Codex pour Sol. FrontierSWE utilise Kimi Code/Codex et des scores de dominance du 16 juillet ; ProgramBench utilise Kimi Code pour K3. KCB 2.0 utilise Kimi Code/Claude Code pour K3 et Claude Code/Codex pour Fable/Sol. SWE Marathon utilise une branche v1.1 calibrée H20 avec Claude Code/Codex ; Fable a utilisé des fallbacks sur 35 % des tâches. Ce sont des résultats rapportés par les fournisseurs sous des harnais différents.
Consultez les notes d’évaluation officielles pour le protocole complet de chaque benchmark ; ces chiffres ne constituent pas une comparaison K3.1 contrôlée.
K3 est particulièrement compétitif sur Program Bench et SWE Marathon dans cet ensemble, tandis que les leaders comparatifs varient selon les tests. K3.1 ne peut pas être déclaré plus rapide ou plus précis avant que des tests avec un harnais d’agent documenté, un budget de raisonnement et une date d’évaluation aient été publiés.
What Could Kimi K3.1 API Pricing Look Like?
Le tarif officiel de lancement de K3 est de US$0.30 en input mis en cache, US$3 en input non mis en cache, et US$15 en output par million de tokens. Le tableau suivant reprend ce barème de référence, et non une tarification K3.1 actuelle vérifiée. Les tarifs de K3.1 et d’éventuels frais d’orchestration nécessitent une confirmation distincte.
| Compteur | API Kimi K3 dans CometAPI (référence du tarif de lancement officiel) | API Kimi K3.1 dans CometAPI (tarif non confirmé) |
|---|---|---|
| Input mis en cache | US$0.30 / 1M tokens | Non confirmé |
| Input non mis en cache | US$3.00 / 1M tokens | Non confirmé |
| Sortie | US$15.00 / 1M tokens | Non confirmé |
| Orchestration d’agent | Dépend de l’usage réel | Non confirmé |
À ces tarifs de référence K3, 100,000 tokens d’input non mis en cache plus 10,000 tokens d’output coûteraient US$0.45. Il s’agit d’un exemple arithmétique illustratif pour K3, pas d’une tarification K3.1. La planification entreprise devrait utiliser le coût par tâche vérifiée plutôt que les tokens seuls.
How Can Developers Prepare for Kimi K3.1 API Access?
Les vérifications d’accès précèdent l’intégration
Les développeurs peuvent suivre Kimi K3.1 API dans CometAPI pour les mises à jour d’accès. Au 9 octobre 2026, la section disponibilité de la page indique toujours Coming Soon, avec des textes génériques d’endpoint et de health. Considérez cette page incohérente comme un lien de découverte ; confirmez un ID de modèle activé et un test réussi au niveau du compte avant de supposer un accès en production.
Une checklist de lancement guide la décision de déploiement
| Question | Preuve disponible à ce jour | Confirmation requise |
|---|---|---|
| Sortie ? | Rapports de fuite de septembre | Annonce de sortie de Moonshot |
| Nouvelle architecture ? | Aucune model card K3.1 | Rapport technique et paramètres |
| Meilleur raisonnement ? | Trois modes d’effort connus | Qualité/coût vs K3 à chaque niveau |
| Meilleur long contexte ? | Option 1M signalée | Précision et latence à 1M |
| Meilleur multi-agent ? | Indicateurs de configuration Agent/Swarm | Benchmarks de réussite et de coût des agents |
| Accès API en production ? | Indicateur Coming Soon | IDs pris en charge, docs, tarification |
La préparation peut commencer par des évaluations portables et un budget de test plafonné. La migration doit attendre un accès documenté et des gains reproductibles au niveau des charges de travail. La décision porte sur la capacité de K3.1 à produire des résultats acceptés de manière plus fiable et économique, plutôt que sur l’existence d’une page de catalogue ou d’un indicateur de configuration.
FAQs
Comment les développeurs peuvent-ils vérifier l’accès à Kimi K3.1 ?
Confirmez l’ID de modèle pris en charge par le fournisseur et le droit d’accès du compte, puis exécutez une petite requête et inspectez l’identifiant de modèle retourné, l’usage et les erreurs. Un appel réussi vérifie l’accès pour ce compte et cette route à ce moment-là ; une entrée de catalogue ou un libellé de health seul n’établit pas un lancement public ni un quota stable.
Kimi K3.1 peut-il remplacer K3 dans un agent existant ?
Considérez la migration comme un changement de compatibilité. Vérifiez les schémas d’outils, la gestion de l’historique de raisonnement, les formats de sortie et le comportement des timeouts avant de rejouer des tâches représentatives. Utilisez une base fixée et conservez un routage de rollback. Un nom de modèle similaire ou une limite de contexte ne constituent pas une preuve suffisante que des sessions de longue durée se comporteront de manière identique.
Comment les équipes doivent-elles budgéter un pilote Kimi K3.1 ?
Commencez par un ensemble de tâches plafonné plutôt que d’extrapoler un prix de token supposé. Suivez l’input non mis en cache, les hits de cache, les tokens de raisonnement/sortie, les appels d’outils, les reprises et le temps de correction humaine. Réservez un budget d’évaluation fixe et comparez le coût par résultat accepté une fois les tarifs finaux documentés.
Qu’est-ce qui constituerait une mise à niveau Kimi K3.1 significative ?
Exigez des gains reproductibles sur votre charge de travail avec des budgets de raisonnement et d’outils comparables. Testez la récupération de preuves éloignées, les documents contradictoires, la reprise des agents et l’acceptation de tâches de bout en bout. Enregistrez ensemble le taux d’échec, la latence et la dépense totale ; une fenêtre nominale plus grande ou un indicateur de configuration supplémentaire, seul, est insuffisant.
Conclusion
Kimi K3.1 doit être considéré comme une sortie prospective rapportée. Les éléments examinés identifient des travaux de configuration possibles, tandis que K3 fournit déjà un long contexte, un effort ajustable et une exécution Swarm. L’opportunité pratique réside dans une meilleure qualité des tâches à coût soutenable. Préparez des évaluations portables maintenant, et prenez des décisions de migration après la publication des spécifications officielles, des conditions d’accès, de la tarification et de résultats K3.1 reproductibles.