

TL;DR
MiMo-V2.5 est le choix par défaut plus performant pour le travail multimodal, les agents de routine et la production sensible aux coûts. MiMo-V2.5-Pro est l’option spécialisée pour le raisonnement difficile, le codage à l’échelle d’un dépôt et l’usage prolongé d’outils. Les deux offrent une fenêtre de contexte de 1 M de jetons et jusqu’à 128 K jetons de sortie, mais Pro utilise une base linguistique bien plus grande et coûte environ 3,1× plus cher pour les jetons d’entrée et de sortie ordinaires.
MiMo-V2.5 vs. Pro: Décision rapide
| Spécifications — version officielle | MiMo-V2.5 | MiMo-V2.5-Pro | Modèle recommandé | Raison |
|---|---|---|---|---|
| Positionnement principal | Modèle omni-modal et agents efficaces | Agent phare et codage complexe | À choisir selon la charge de travail | Les entrées omni-modales favorisent V2.5 ; un travail textuel difficile et soutenu favorise Pro. |
| Architecture | MoE clairsemé | MoE clairsemé | À choisir selon la charge de travail | La taille du modèle ne suffit pas à déterminer le meilleur choix pour chaque tâche. |
| Paramètres totaux | 310B | 1,02T | À choisir selon la charge de travail | Le modèle plus grand cible le raisonnement difficile, mais la taille n’est pas un résultat de tâche. |
| Paramètres activés | 15B | 42B | À choisir selon la charge de travail | Utilisez l’accomplissement de la tâche et le coût pour décider. |
| Couches LLM | 48 | 70 | À choisir selon la charge de travail | Le nombre de couches décrit l’architecture, pas un gain universel. |
| Experts routés | 256 | 384 | À choisir selon la charge de travail | La différence n’a d’importance que si elle améliore la charge de travail visée. |
| Experts activés par jeton | 8 | 8 | L’un ou l’autre | Les deux activent huit experts par jeton. |
| Fenêtre de contexte | 1 M de jetons | 1 M de jetons | L’un ou l’autre | Les deux annoncent une fenêtre de 1 M de jetons ; testez la récupération effective. |
| Sortie maximale | 128 K jetons | 128 K jetons | L’un ou l’autre | Les deux annoncent jusqu’à 128 K jetons de sortie. |
| Modalités d’entrée | Texte, image, vidéo et audio | Texte | MiMo-V2.5 | Il accepte les entrées image, vidéo et audio ; Pro est centré sur l’entrée texte. |
| Appel d’outils | Oui | Oui | À choisir selon la charge de travail | Les deux appellent des outils ; testez le taux de succès sur la trajectoire réelle. |
| Poids ouverts et licence | Oui ; MIT | Oui ; MIT | L’un ou l’autre | Les deux offrent des poids ouverts sous MIT ; les coûts de service diffèrent. |
La différence décisive : multimodal vs agent d’abord
V2.5 accepte nativement texte, images, vidéo et audio. Xiaomi associe la base linguistique à un encodeur vision de 729 M de paramètres et un encodeur audio de 261 M, permettant aux informations multimodales de participer directement au même flux de raisonnement.
- Analyser des captures d’écran avant d’appeler des outils.
- Comprendre une vidéo et sa piste audio ensemble.
- Extraire des informations de schémas et d’images de documents.
- Exploiter des agents à interface visuelle et à support multimodal.
- Raisonner sur de longues séquences vidéo.
V2.5-Pro suit une conception différente. Xiaomi spécifie actuellement le texte comme modalité d’entrée et met l’accent sur le raisonnement profond, le développement de code et l’orchestration d’outils de longue durée.
Si le flux de travail contient des entrées image, vidéo ou audio, commencez avec V2.5. Testez Pro lorsque la difficulté réside dans le raisonnement sur du texte, du code source, des outils ou une longue trajectoire d’agent.

Comparaison officielle des benchmarks multimodaux de Xiaomi.
Pourquoi V2.5-Pro peut mieux réussir sur les tâches difficiles
Échelle du modèle : 310B/15B vs 1,02T/42B
Les deux modèles utilisent des bases Mixture-of-Experts clairsemées, une attention hybride fenêtre coulissante et globale, et trois modules de prédiction multi-jetons (MTP). La fiche modèle V2.5 de Xiaomi documente une base de 310 B au total, 15 B actifs ; la fiche modèle Pro étend cela à 1,02 T de paramètres totaux avec 42 B activés par jeton.
| Architecture — fiche modèle officielle | V2.5 | Pro | Différence |
|---|---|---|---|
| Paramètres totaux | 310B | 1,02T | Environ 3,3× |
| Paramètres actifs | 15B | 42B | 2,8× |
| Taille cachée | 4 096 | 6 144 | 1,5× |
| Couches LLM | 48 | 70 | 22 de plus |
| Têtes d’attention | 64 | 128 | 2× |
| Experts routés | 256 | 384 | 1,5× |
| Experts par jeton | 8 | 8 | Identique |
| Couches MTP | 3 | 3 | Identique |
V2.5 utilise un schéma d’attention 5:1, tandis que Pro adopte un schéma local-vers-global 6:1. Xiaomi indique que ces conceptions réduisent les besoins de cache KV d’environ 6× et 7× respectivement par rapport à une attention complète sur tout le réseau.
Les paramètres totaux ne se traduisent pas linéairement en qualité de réponse. La base plus grande de Pro compte surtout lorsque la difficulté du raisonnement ou la longueur de la trajectoire fait que de petits gains de fiabilité par étape se cumulent.
Pourquoi de petits gains de fiabilité se cumulent
Une tâche d’agent longue comporte de nombreuses étapes dépendantes. Une erreur lors d’un appel d’outil précoce peut forcer des réessais ou invalider le travail ultérieur ; un gain modeste de fiabilité par étape peut donc avoir un effet plus important sur la complétion de bout en bout. Évaluez cet effet sur des tâches représentatives plutôt que de supposer que la taille du modèle le garantit.
Où V2.5-Pro s’améliore-t-il réellement ?
La comparaison numérique la plus nette est l’évaluation du modèle de base de Xiaomi, où les deux modèles apparaissent sous les mêmes réglages. Cela évite de combiner des résultats produits par des harnais ou des configurations post-entraînement sans rapport.
Connaissances générales : gains faibles à modérés
Dans la comparaison des modèles de base de Xiaomi, Pro gagne 1,2 point sur BBH, 3,1 sur MMLU et 2,7 sur MMLU-Pro. Ce sont des gains mesurables mais plus modestes que ses gains sur les tâches de raisonnement plus difficiles.
Mathématiques et sciences : gains plus importants
Pro gagne 8,6 points sur GPQA-Diamond, 16,3 sur GSM8K et 18,5 sur MATH dans la même évaluation de base. C’est la preuve la plus claire en faveur de Pro lorsque le succès de la tâche dépend d’un raisonnement difficile.
Programmation : mieux, mais pas uniformément mieux
Les gains rapportés sont de 4,3 points sur HumanEval+, 3,2 sur MBPP+, 4,1 sur LiveCodeBench v6 et 4,9 sur SWE-Bench AgentLess. Testez séparément les tâches au niveau du dépôt et l’usage d’outils : ces scores de modèles de base ne mesurent pas tous les flux d’agents en production.
Résultat de benchmark : Pro n’est pas trois fois meilleur parce qu’il coûte environ trois fois plus. Sa valeur augmente progressivement à mesure que la difficulté du raisonnement et la durée des tâches augmentent.
Ces lignes sont des évaluations de modèles de base, pas une promesse qu’une API de production reproduira les mêmes scores. Les résultats d’agents dépendent des outils, des prompts, des réessais, de l’environnement d’exécution et des budgets de jetons.
Post-entraînement et agents à long horizon
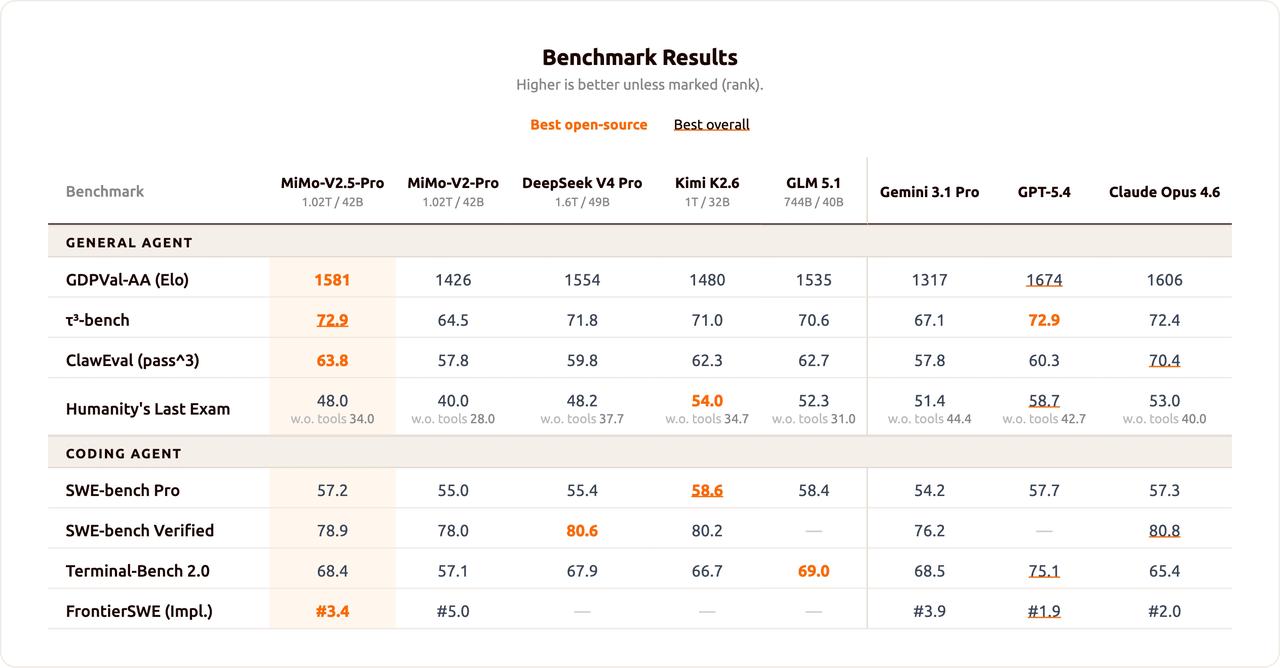
Les modèles de production ajoutent un affinement supervisé, un apprentissage par renforcement agentique et une distillation sur politique à multiples enseignants. Xiaomi rapporte des scores post-entraînement de 56,1 sur SWE-bench Pro, 65,8 sur Terminal-Bench 2.0 et 62,1 Pass³ sur la partie générale de Claw-Eval pour V2.5.
Pro est plus explicitement optimisé pour l’ingénierie logicielle à long horizon. Xiaomi décrit des centaines d’appels d’outils dans des trajectoires soutenues et publie un résultat de 78,9 % sur SWE-bench Verified.
Une étude de cas officielle montre Pro réalisant un compilateur SysY en 4,3 heures avec 672 appels d’outils et l’ensemble des 233 tests validés. La leçon n’est pas que chaque demande de codage nécessite Pro ; c’est que de petites différences de fiabilité peuvent déterminer si un flux de travail avec des centaines d’actions dépendantes aboutit.

Figure officielle des benchmarks de codage et d’agents de Xiaomi.
Long contexte : même capacité, charges de travail différentes
Les deux modèles offrent une fenêtre de contexte de 1 M de jetons et jusqu’à 128 K jetons de sortie via l’API actuelle de Xiaomi. La taille brute du contexte ne les différencie donc pas.
V2.5 est attrayant lorsque le long contexte inclut du matériel multimédia tel que de la vidéo, des images de documents ou des traces d’agents visuels. Pro est le modèle à tester lorsque le contexte lui-même devient le problème de raisonnement : un grand dépôt, un long contrat, un corpus de recherche ou une trajectoire d’agent contenant de nombreuses actions séquentielles.
Une grande fenêtre de contexte décrit une capacité, pas une fidélité de raisonnement garantie. Évaluez la récupération, la rétention d’instructions et l’usage des preuves aux longueurs qui comptent pour l’application.
Prix et efficacité coût
Les tarifs à l’usage à l’étranger de Xiaomi rendent le compromis clair.
| Tarification — grille tarifaire officielle | V2.5 | Pro | Ratio |
|---|---|---|---|
| Entrée non mise en cache par 1 M de jetons | 0,14 $ | 0,435 $ | 3,11× |
| Entrée mise en cache par 1 M de jetons | 0,0028 $ | 0,0036 $ | 1,29× |
| Sortie par 1 M de jetons | 0,28 $ | 0,87 $ | 3,11× |
| Fenêtre de contexte | 1 M | 1 M | Identique |
| Sortie maximale | 128 K | 128 K | Identique |
Une requête avec 1 M de jetons d’entrée non mis en cache et 200 K jetons de sortie coûte environ 0,196 $ sur V2.5 et 0,609 $ sur Pro avant les hits de cache, les frais de recherche web ou la facturation spécifique au fournisseur.
La différence de prix sur le cache est plus faible : Pro est environ 29 % plus cher pour l’entrée avec cache-hit plutôt que 211 % plus cher. Les agents de longue durée avec des invites système stables, des définitions d’outils ou des préfixes de dépôt devraient donc mesurer leur taux réel de cache-hit.
Estimez le coût par tâche réussie. Un agent Pro qui achève un flux de travail difficile une fois peut coûter moins cher que des tentatives répétées échouées sur un modèle moins cher.
Quel modèle devez-vous utiliser ?
| Charge de travail — recommandations officielles | Meilleur choix | Pourquoi |
|---|---|---|
| Chat texte de routine | V2.5 | Coût plus faible ; Pro souvent inutile |
| Génération à haut volume | V2.5 | Prix standard des jetons environ 3,1× plus bas |
| Compréhension d’images, vidéo ou audio | V2.5 | Entrée multimodale native |
| Appel d’outils de routine | V2.5 | Forte capacité d’agent à moindre coût |
| Mathématiques et sciences difficiles | Pro | Gains de benchmark plus importants |
| Programmation à l’échelle d’un dépôt | Pro | Conçu pour l’ingénierie logicielle complexe |
| Centaines d’appels d’outils dépendants | Pro | Meilleure adéquation pour l’exécution soutenue |
| Fenêtre de contexte de 1 M sensible au coût | V2.5 | Même contexte nominal à un coût bien plus faible |
Résultat de la sélection : V2.5 est le défaut pour les applications multimodales, les agents de routine et les charges sensibles aux coûts. Pro est la mise à niveau pour le raisonnement difficile, l’ingénierie logicielle complexe et les trajectoires autonomes longues.
Une meilleure stratégie de production : router entre les deux
Un choix de modèle global unique est souvent inutile. Routez les requêtes multimodales et de routine vers V2.5, puis n’escaladez vers Pro que le raisonnement textuel difficile, le codage complexe ou l’exécution à long horizon.
| Dimension d’évaluation | Mesure | Pourquoi c’est important | Signal de routage |
|---|---|---|---|
| Achèvement | Tâches réussies / tentatives | Capture la fiabilité de bout en bout | Escalader les classes à faible achèvement |
| Qualité | Score humain ou selon une grille | Empêche le coût en jetons de dominer | Escalader les tâches à enjeux élevés |
| Fiabilité des outils | Erreurs et réessais | De petites erreurs se cumulent dans les agents | Escalader les longues trajectoires |
| Latence | Temps jusqu’au résultat accepté | Inclut la surcharge de réessai | Garder les tâches interactives légères |
| Coût | Dépense par tâche acceptée | Reflète les échecs et relances | Utiliser le modèle le moins cher qui réussit |
Tester les deux API dans CometAPI
API MiMo-V2.5 dans CometAPI et API MiMo-V2.5-Pro dans CometAPI permettent une évaluation côte à côte via une couche d’agrégation unique. Envoyez les mêmes prompts, instructions système, outils et limites de sortie aux deux modèles, puis comparez le succès des tâches et le coût.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["mimo-v2.5", "mimo-v2.5-pro"]
prompt = """
Review this implementation plan.
Identify hidden technical risks and propose the three highest-priority fixes.
"""

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=2000,
    )
    print(f"\n--- {model} ---")
    print(response.choices[0].message.content)
Exécutez un lot représentatif contenant des requêtes simples, du raisonnement difficile, de l’édition de code, des tâches à long contexte et des appels d’outils d’agents. Enregistrez le taux d’achèvement, les jetons, la latence, les erreurs d’outils, les réessais, la qualité des réponses et le coût par tâche réussie.
Limitations
Limitations de V2.5
La base linguistique plus petite laisse des performances sur la table à mesure que la difficulté du raisonnement augmente. L’écart est modeste sur BBH mais devient bien plus grand sur GPQA-Diamond et MATH. Une fenêtre de contexte de 1 M de jetons ne doit pas non plus être confondue avec une fidélité de raisonnement garantie à 1 M de jetons.
Limitations de Pro
Les prix ordinaires d’entrée et de sortie de Pro sont environ 3,1× ceux de V2.5, et son entrée uniquement texte le rend inadapté comme remplacement direct pour les applications multimodales. Le modèle à poids ouverts de 1,02 T de paramètres est aussi un projet exigeant en auto-hébergement, même si 42 B de paramètres sont activés par jeton.
Verdict final
Choisissez V2.5 pour les applications multimodales, les agents de routine et la production sensible aux coûts. Choisissez Pro pour le raisonnement difficile, l’ingénierie logicielle complexe et les agents autonomes de longue durée. Pour des charges mixtes, routez la plupart du trafic vers V2.5 et n’escaladez que les requêtes dont la difficulté ou la longueur de trajectoire justifie le coût accru.
FAQ
Le modèle Pro est-il toujours meilleur que V2.5 ?
Non. Pro est plus performant sur le raisonnement textuel difficile et la programmation, mais V2.5 prend en charge l’entrée image, vidéo et audio et est nettement moins cher.
Les deux modèles prennent-ils en charge une fenêtre de contexte de 1 M de jetons ?
Oui. Les deux annoncent 1 M de jetons de contexte et jusqu’à 128 K jetons de sortie. Les applications doivent néanmoins tester la récupération et le raisonnement aux longueurs réellement utilisées.
Quel modèle un agent multimodal doit-il utiliser ?
Commencez avec V2.5 car il accepte nativement les entrées visuelles et audio. Pro cible actuellement les flux de travail à entrée texte.
Quand le Pro justifie-t-il son prix plus élevé ?
Il est le plus défendable lorsque de meilleures fiabilités de raisonnement affectent la complétion de mathématiques difficiles, de programmation à l’échelle d’un dépôt ou de longues trajectoires contenant de nombreux appels d’outils dépendants.
Les systèmes de production doivent-ils n’utiliser qu’un seul modèle ?
Pas nécessairement. Une couche de routage peut conserver le travail de routine et multimodal sur V2.5 tout en escaladant le raisonnement textuel difficile et les tâches d’agents vers Pro.