Construire avec CometAPIBesoin d'une seule API pour plusieurs modèles ?Testez le workflow dans Playground, puis créez une clé API lorsque le modèle et le coût correspondent à votre cas d'usage.
Qu'est-ce que Gemini 4 Hydrogen ? Tout ce que vous devez savoir.
Explorez les fonctionnalités, les benchmarks, la tarification de l'API et la configuration de Gemini 4 Hydrogen. Apprenez où il s'intègre dans la programmation, l'analyse de documents et les flux de travail des agents.
Deon GoodwinÉquipe de recherche sur les modèles IA et API
Mis à jour Nov 14, 2026 14 min de lecture
Réponse d'abord
Explorez les fonctionnalités, les benchmarks, la tarification de l'API et la configuration de Gemini 4 Hydrogen. Apprenez où il s'intègre dans la programmation, l'analyse de documents et les flux de travail des agents.
Utilisez ce résumé pour une réponse rapide, puis lisez le guide pour le contexte, les exemples et les détails d'implémentation.
Gemini 4 Hydrogen est le modèle de Google axé sur l’exécution pour les développeurs qui construisent des assistants de codage, des workflows documentaires et des agents. Il combine un budget de contexte partagé d’un million de tokens avec quatre niveaux de raisonnement, ce qui rend la vitesse, la qualité des tâches et le coût ajustables au sein d’un même modèle. Son principal atout est de mener à bien un travail pratique avec efficacité ; le bon réglage dépend de la quantité de raisonnement dont votre application a réellement besoin.
Key Takeaways
Gemini 4 Hydrogen vise le codage itératif, le débogage et l’exécution pilotée par des outils, seul ou aux côtés d’un modèle de planification.
Son budget de contexte de 1,048,576 tokens est partagé entre l’entrée, le raisonnement, les appels d’outils et la réponse finale.
LOW, MEDIUM, HIGH et XHIGH offrent des profils différents en termes de qualité, de latence et de coût ; HIGH est la valeur par défaut.
Le texte, les images, l’audio, la vidéo et les documents bureautiques pris en charge peuvent être des entrées ; la sortie générée est du texte.
Revu pour la clarté, l'attribution des sources et la terminologie API actuelle.
Le tarif Global Standard PayGo est de $1.50 par million de tokens d’entrée et $7.50 par million de tokens de sortie, raisonnement inclus.
What Is Gemini 4 Hydrogen?
Google DeepMind a présenté Gemini 4 Hydrogen le 12 novembre 2026 pour le codage, les tâches agentiques et le travail de connaissance au quotidien. Le modèle est propriétaire et disponible via les produits développeur et entreprise de Google.
La fiche modèle indique que Hydrogen est adapté de Gemini 4 Carbon. Cela établit sa lignée, mais ne décrit pas à lui seul tous les changements architecturaux ou d’entraînement. Pour les développeurs, la distinction utile est son accent sur l’exécution rapide à travers des éditions répétées, des appels d’outils et des vérifications.
What Are the Main Features of Gemini 4 Hydrogen?
Fast Coding, Debugging, and Repository Work
Hydrogen est conçu pour le travail sur dépôt : localiser un bug, modifier les fichiers pertinents, exécuter les tests et vérifier le résultat. Google rapporte que Gemini 4 Hydrogen achève des tâches de benchmark 2,5 fois plus vite que Gemini 3.8 Flash au niveau de réflexion par défaut HIGH. Cela renvoie à la performance d’achèvement de tâches dans l’évaluation de Google, et non à une réduction universelle de 2,5× de la latence de réponse de l’API. Les résultats réels dépendent de la longueur de l’invite, de l’exécution des outils, de la complexité de la tâche et du workflow de l’application, parallèlement à une hausse de Terminal-Bench 4.1 de 18.2% à 57.0%. Il s’agit de résultats d’évaluation au lancement, pas d’une garantie pour chaque base de code.
Les lectures et recherches de fichiers en parallèle peuvent aider un agent à inspecter des parties indépendantes d’un dépôt avant modification. En pratique, le bénéfice dépend des outils, des dépendances de la tâche et du volume de travail pouvant être exécuté en toute sécurité en concurrence.
Four Adjustable Thinking Levels
Hydrogen prend en charge quatre niveaux de raisonnement : LOW, MEDIUM, HIGH et XHIGH. HIGH est la valeur par défaut. Le paramètre contrôle la quantité de raisonnement appliquée par le modèle avant de produire une réponse ; il affecte donc la qualité de la tâche, le temps de réponse et l’usage de tokens de sortie.
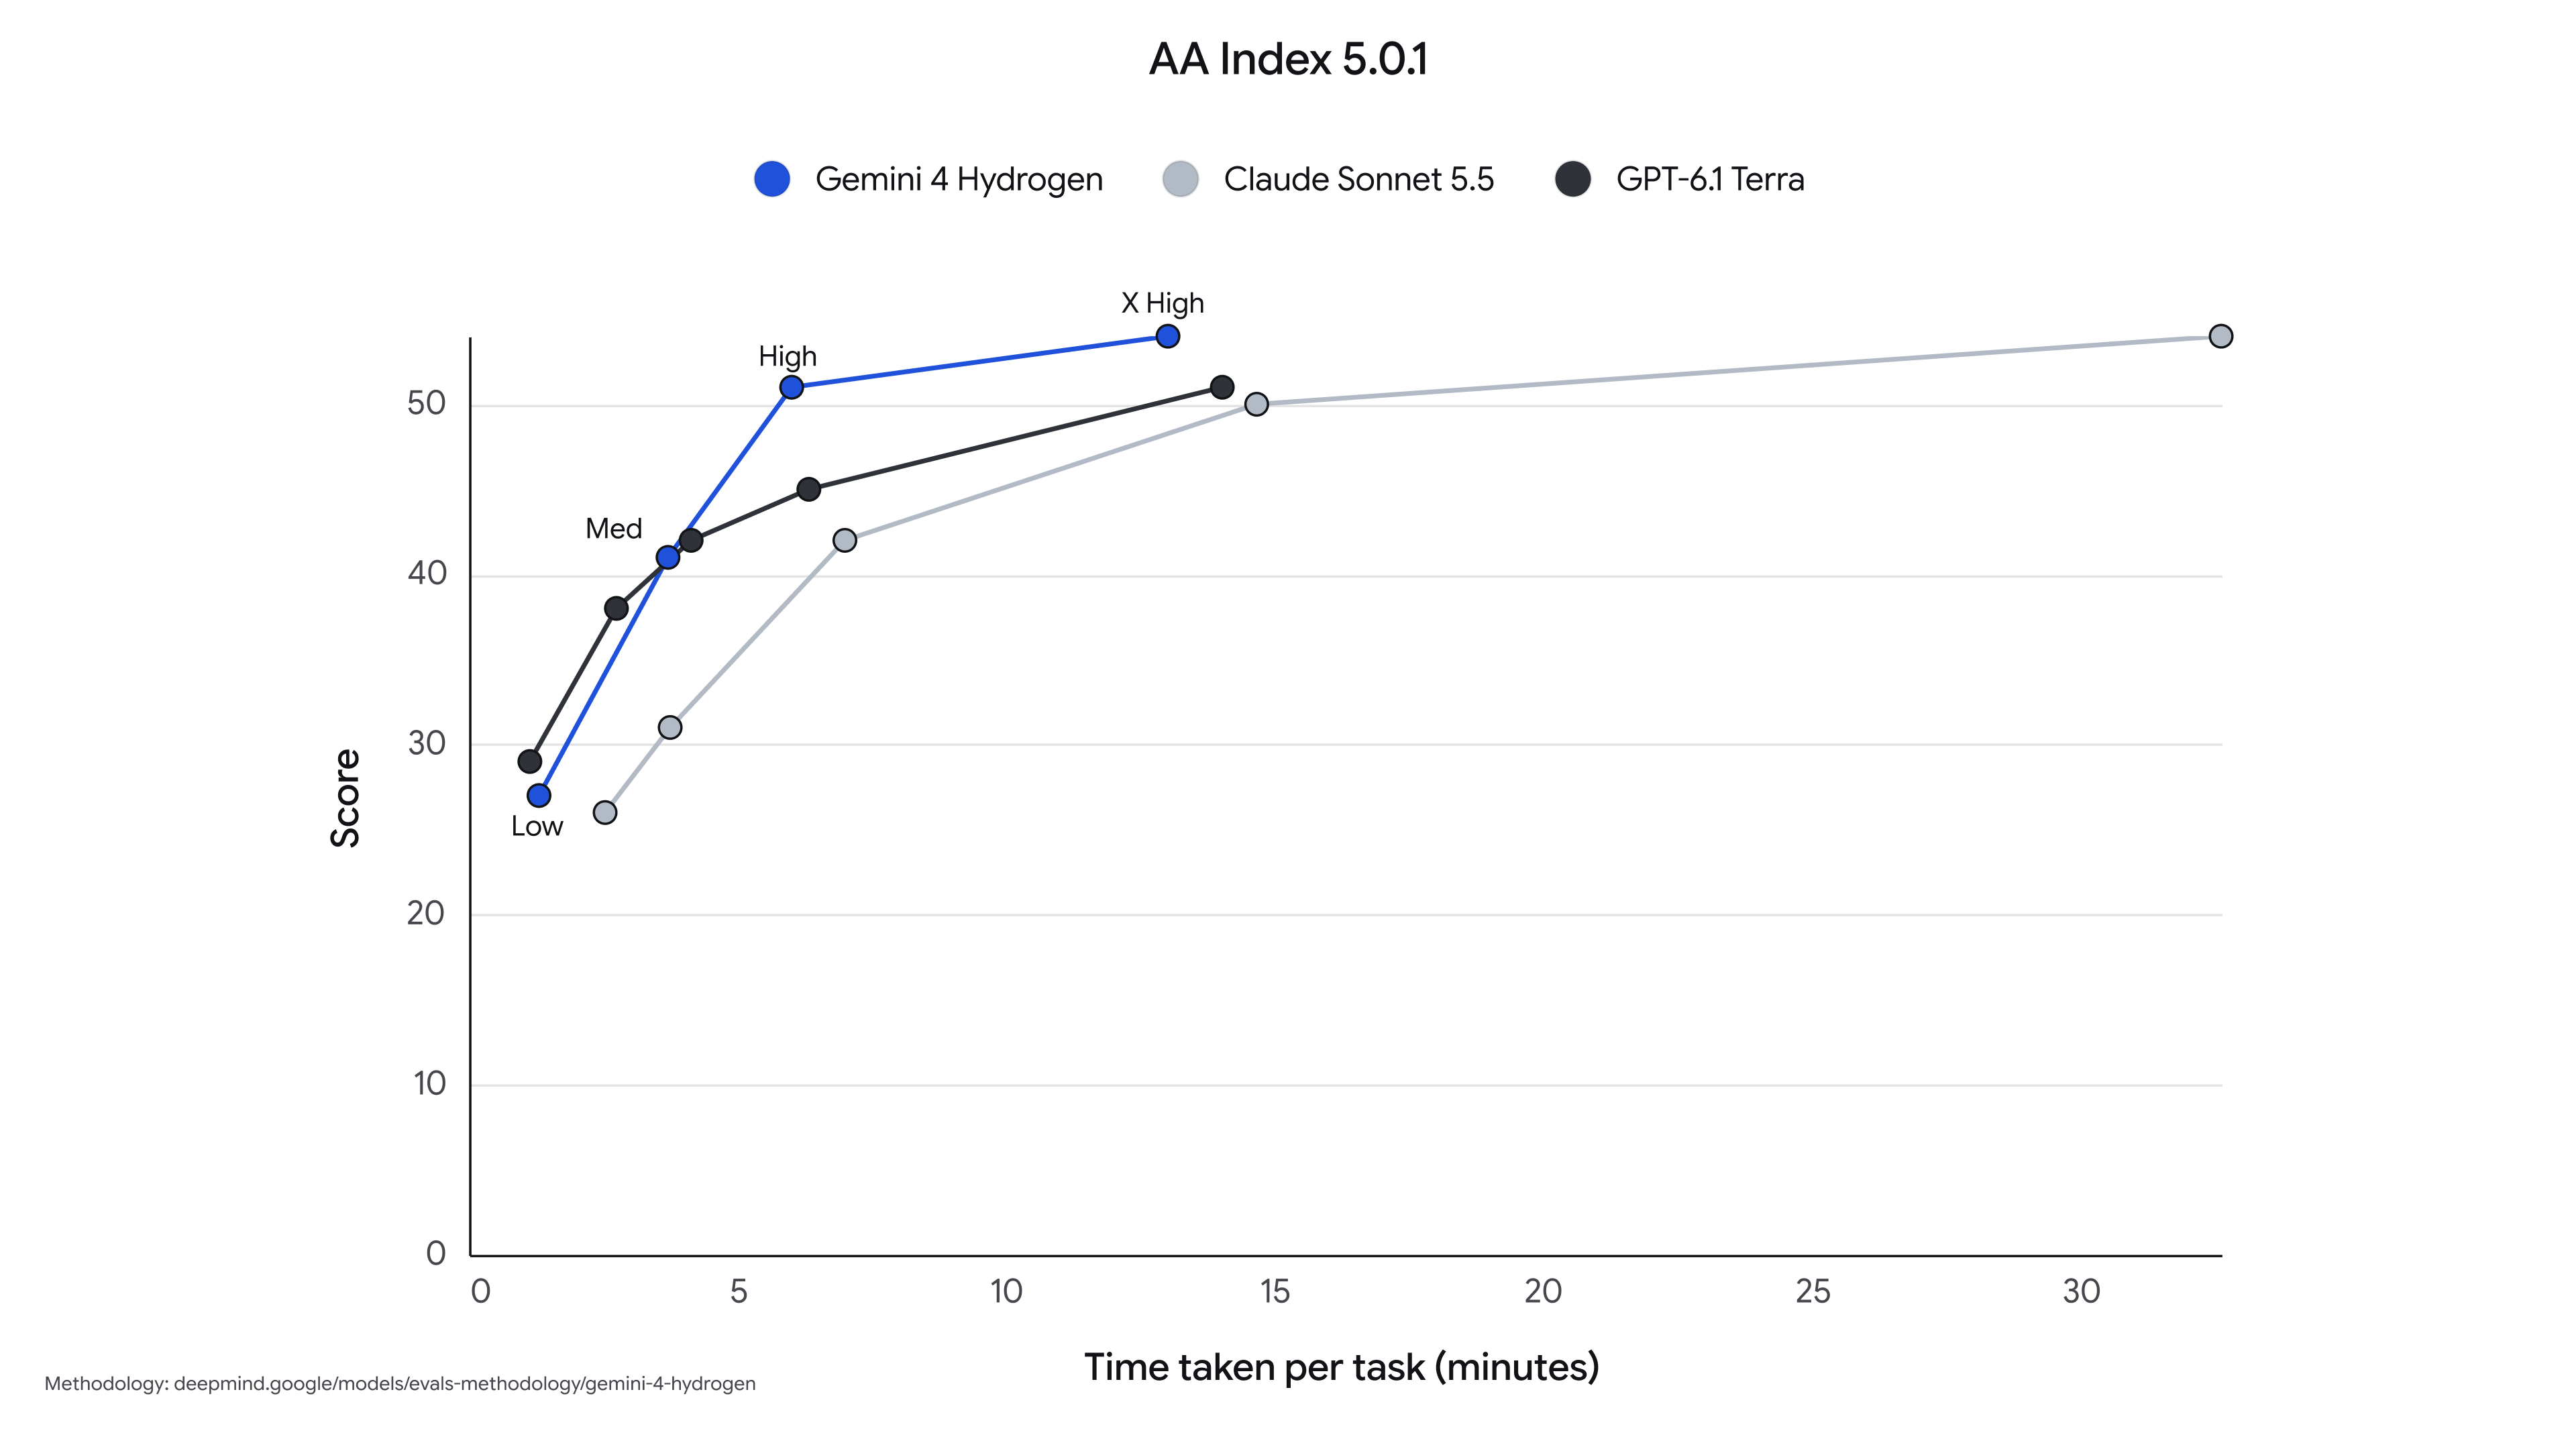
Ces mesures de l’Artificial Analysis Intelligence Index datent du 13 novembre 2026 et portent sur des tâches de benchmark, pas sur le coût ni la latence d’un appel API ordinaire. Les scores de l’index, le mix de charge et les performances du fournisseur peuvent évoluer ; utilisez la même version de benchmark et le même niveau de raisonnement pour comparer les résultats.
La décision pratique se joue souvent entre MEDIUM et HIGH, plutôt qu’entre HIGH et XHIGH. Passer de HIGH à XHIGH n’ajoute que trois points d’Artificial Analysis Intelligence Index tout en augmentant le coût mesuré par tâche de $1.87 à $3.16. Pour des charges d’agents à volume élevé, l’effort de raisonnement supplémentaire doit se justifier par une amélioration mesurable de la qualité d’achèvement des tâches.
Le schéma pratique est clair : LOW convient aux tâches simples où la vitesse compte ; MEDIUM est un réglage interactif utile ; HIGH est un bon défaut pour le codage et l’exécution d’agents ; XHIGH est à réserver aux tâches où le raisonnement supplémentaire améliore sensiblement le résultat.
Le graphique de lancement de Google trace le score AA Index 5.0.1 en fonction du temps de tâche. C’est un instantané fixe au lancement ; ses valeurs de temps ne doivent pas être considérées comme un engagement de niveau de service en temps réel.
Multimodal Knowledge Work and Office Documents
Google documente les entrées PDF, Microsoft Office et OpenDocument aux côtés du texte, des images, de l’audio et de la vidéo. Une application peut combiner une feuille de calcul, un rapport, des captures d’écran et un enregistrement de réunion, puis renvoyer une analyse écrite ou un résultat structuré.
Hydrogen renvoie du texte plutôt que des images, de l’audio ou de la vidéo générés. La compréhension vidéo agentique est disponible mais désactivée par défaut ; activez-la délibérément lorsque le workflow nécessite un traitement vidéo actif.
Tool Calling, Grounding, and Computer Use
Les appels de fonction, l’exécution de code, le contexte d’URL, l’utilisation de l’ordinateur et le grounding relient les réponses du modèle aux outils et preuves externes. Sélectionnez les outils adaptés à la surface d’API que vous utilisez : une capacité de modèle seule ne configure pas les identifiants, les permissions d’outils ni les fonctions d’application.
Consultez la matrice des fonctionnalités prises en charge avant de réutiliser une intégration existante. Hydrogen ne prend pas en charge RAG Engine ni le model tuning, et son workflow de cache utilise un cache implicite plutôt que des ressources explicites de contenu en cache.
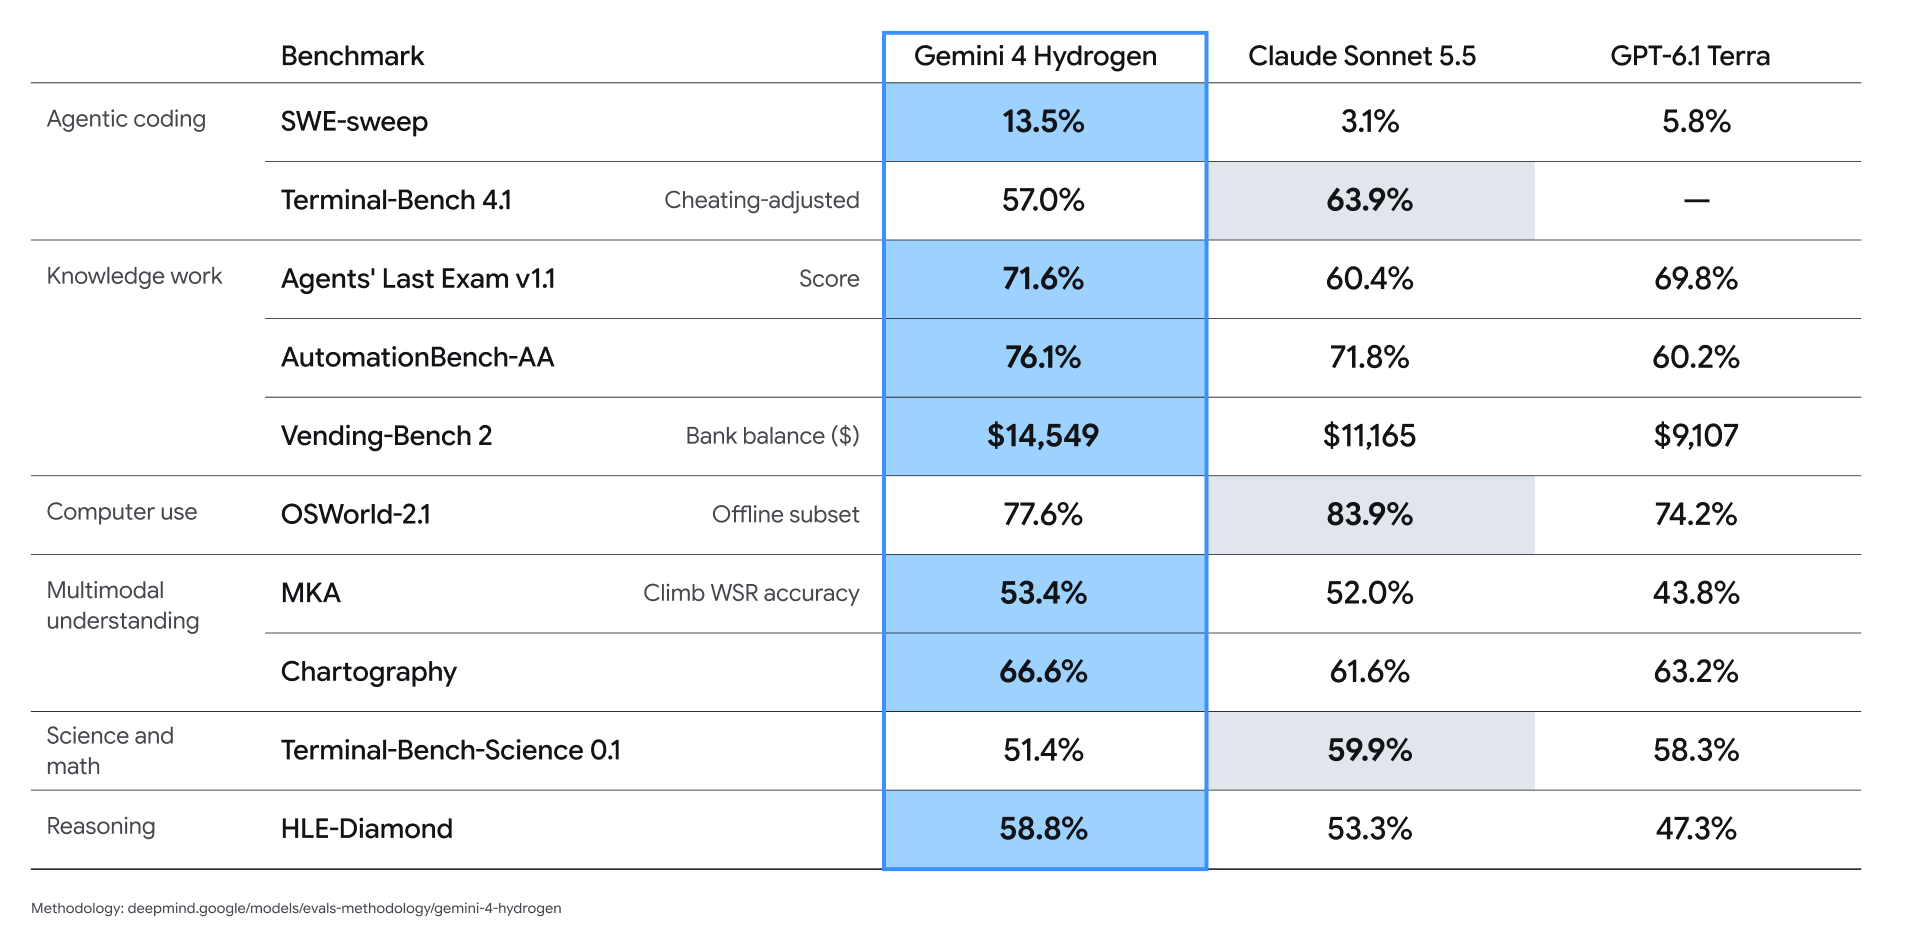
Lisez chaque ligne dans le cadre d’évaluation indiqué : Terminal-Bench 4.1 est ajusté pour la triche ; OSWorld-2.1 utilise le sous-ensemble hors ligne ; MKA rapporte la précision Climb WSR ; et Vending-Bench 2 rapporte un solde bancaire simulé, pas un pourcentage de précision. Un tiret signifie qu’aucun résultat n’est fourni dans cette comparaison. Le résumé de la fiche modèle ne précise pas un harnais complet par modèle, un budget d’outils ni une configuration matérielle, de sorte que ces résultats n’établissent pas une latence ni un coût d’API en conditions égales.
Hydrogen affiche le score le plus élevé sur sept des dix lignes, y compris Chartography. Sonnet 5.5 est en tête sur Terminal-Bench 4.1, OSWorld-2.1 et Terminal-Bench-Science 0.1. Ces différences plaident pour des évaluations ressemblant à votre charge de travail, plutôt que de considérer un modèle comme vainqueur universel.
La comparaison de lancement originale de Google conserve les étiquettes de benchmark et les notes d’évaluation. Les chiffres sont des résultats rapportés par les fournisseurs, non des mesures indépendantes réalisées pour cet article.
Gemini 4 Hydrogen vs Gemini 4 Carbon, Gemini 4 Argon, and Gemini 3.8 Flash
La comparaison la plus utile n’est pas simplement le modèle au score le plus élevé. Les développeurs doivent considérer la qualité des tâches, la latence, le coût par tâche accomplie, les besoins en contexte et la capacité du modèle à utiliser les outils indispensables à leur application.
Le tableau compare des rôles opérationnels plutôt que des détails d’architecture non documentés. Google identifie Hydrogen comme adapté de Carbon ; les noms de famille de modèles ne suffisent pas à établir des internes identiques ni un comportement d’API interchangeable.
Les conditions tarifaires promotionnelles de Google prévoient les remises indiquées via des crédits de 50% sur les dépenses nettes éligibles. Les tarifs effectifs temporaires ci-dessus ne doivent pas être lus comme une réduction inconditionnelle de chaque facture. Les tarifs sont en USD par million de tokens d’entrée/sortie.
Pour une migration depuis Gemini 3.8 Flash, le principal changement d’intégration est le budget d’entrée/sortie partagé. Hydrogen modifie aussi les valeurs par défaut de raisonnement et le comportement de cache, donc un simple échange d’ID de modèle n’est pas une migration complète. Comparez les résultats de tâches acceptées, les relances et l’usage total de tokens avant de remplacer un déploiement fonctionnel.
Carbon et Argon restent des options de planification utiles pour le travail difficile et ambigu. Une division du travail pragmatique consiste à confier une tâche d’implémentation bornée à Hydrogen et à escalader les décisions non résolues. L’évaluation Orchestrator sur Terminal-Bench 4.0 a rapporté un succès proche de Carbon avec 24% de quota en moins et une achèvement 19% plus rapide ; il s’agit d’un résultat de système multi-modèles qui ne doit pas être attribué à Hydrogen seul.
Where Can You Access Gemini 4 Hydrogen?
Official Google Access
Vous pouvez essayer Gemini 4 Hydrogen dans Google AI Studio et créer des applications avec l’API Gemini. Pour des déploiements entreprise par projet, utilisez Gemini Enterprise Agent Platform avec l’authentification et la configuration décrites dans le guide développeur Hydrogen de Google. L’ID du modèle est gemini-4-hydrogen.
Pour un usage quotidien, Hydrogen est également disponible via l’application Gemini et la recherche Google. Les développeurs disposant d’abonnements Google AI payants éligibles peuvent l’utiliser dans Google Antigravity. Choisissez une voie API lorsque vous devez intégrer le modèle à votre propre application, et une interface Google lorsque vous souhaitez travailler directement avec lui.
CometAPI Access
Vous pouvez également accéder à l’API Gemini 4 Hydrogen dans CometAPI. Cela offre aux développeurs une voie d’accès CometAPI pour ajouter Hydrogen à leurs applications aux côtés d’autres modèles pris en charge. Utilisez votre compte et votre clé API CometAPI, et suivez les instructions d’intégration pour le format de requête pris en charge.
How Much Does Gemini 4 Hydrogen Cost?
Le tableau compare les tarifs de l’endpoint Google Cloud Global avec l’API Gemini 4 Hydrogen dans CometAPI. Les prix sont en USD par million de tokens au 13 novembre 2026. Les tarifs d’entrée et de sortie standard de CometAPI sont 20% inférieurs aux tarifs Global Standard de Google ; les frais de sortie incluent les tokens de raisonnement ainsi que la réponse finale.
La remise de 20% compare uniquement l’usage standard d’entrée et de sortie. Les tarifs Priority, Batch et d’entrée en cache de Google sont affichés séparément et ne servent pas de base à cette remise. Le tiret signifie qu’un tarif d’entrée en cache CometAPI n’est pas cité ici, plutôt que des lectures de cache gratuites.
Le tarif non‑global Standard est de $1.65 par million de tokens d’entrée et $8.25 par million de tokens de sortie. Les tarifs d’entrée en cache se réfèrent aux lectures de cache. La tarification des écritures de cache doit entrer en vigueur le 12 janvier 2027 et est exclue de l’exemple ci‑dessous.
Gemini 4 Hydrogen API Cost Example
Cet exemple suppose une requête avec 100,000 tokens d’entrée facturables et 20,000 tokens de sortie facturables, y compris les éventuels tokens de raisonnement, sans remise de cache ni outils facturés séparément.
La même charge coûte $0.24 via CometAPI : $0.12 pour l’entrée plus $0.12 pour la sortie, soit une économie de $0.06 (20%) par rapport à Google Global Standard. Google Batch coûterait environ $0.15 et Priority $0.54 à leurs tarifs respectifs, avant tout outil facturé séparément. Les dépenses réelles dépendent de la longueur de l’invite, de l’usage de tokens de raisonnement, des appels d’outils et du niveau de service.
Les tarifs de grounding incluent 5,000 requêtes de grounding Google Search par mois partagées entre Gemini 3 et Gemini 4, puis $14 par 1,000 requêtes. Google Maps a sa propre allocation de 5,000 requêtes et le même tarif au‑delà. Une invite utilisateur peut générer plusieurs requêtes facturables.
What Are the Limitations of Gemini 4 Hydrogen?
It Can Still Hallucinate or Refuse Benign Requests
La fiche modèle de Google identifie des hallucinations et rapporte une hausse de 5.57 points de pourcentage des refus injustifiés par rapport à Gemini 3.8 Flash dans son évaluation de sécurité automatisée. Ce chiffre concerne des requêtes bénignes ou limites dans un test particulier ; ce n’est pas le taux de refus sur l’ensemble du trafic en production. Utilisez des preuves à jour pour les tâches factuelles et évaluez à la fois les réponses incorrectes et les refus inutiles sur vos propres entrées.
Short-Term GA Lifecycle
Hydrogen est une version GA de courte durée avec une politique de préavis de retrait minimal de 45 jours. Gardez le modèle configurable et planifiez comment évaluer un remplaçant. La politique de préavis n’est pas une promesse que tel endpoint restera disponible indéfiniment.
Conclusion
Commencez avec un petit jeu d’évaluation tiré de votre charge réelle : une modification de code devant passer des tests, une tâche documentaire avec des réponses vérifiables, et une séquence d’outils avec des critères de réussite clairs. Enregistrez la qualité d’achèvement, le temps écoulé, les relances et le total de tokens facturés. Adoptez Hydrogen là où il améliore ces résultats, et conservez un repli pour les cas qu’il ne gère pas de manière fiable. Cela transforme une comparaison prometteuse au lancement en une décision de déploiement défendable.
FAQ
How Can I Recover an Interrupted Gemini 4 Hydrogen Long Decode?
Avec un SDK Python compatible, une poursuite interrompue peut exposer une sortie partielle et un jeton de continuation via ContinuationInterruptedError. Conservez cet état et suivez la procédure de récupération de long décodage adaptée à votre surface d’API. Relancer la requête initiale depuis le début peut répéter du travail et des frais ; des segments achevés peuvent déjà avoir été facturés.
How Should I Organize Gemini 4 Hydrogen Prompts for Caching?
Placez les instructions stables et le matériel de référence partagé au début, avec l’entrée utilisateur changeante ensuite. Le seuil de cache implicite documenté est de 4,096 tokens. La réutilisation d’un préfixe peut améliorer l’éligibilité au cache, mais les économies réelles dépendent des hits de cache et de l’usage facturé ; n’assumez pas que chaque invite répétée bénéficie du tarif d’entrée en cache.
How Can I Make Gemini 4 Hydrogen Agent Results Easier to Verify?
Donnez à chaque outil un but étroit et définissez une condition d’achèvement observable avant que le modèle ne démarre. Pour une édition de dépôt, exigez les tests pertinents et inspectez le diff ; pour une extraction documentaire, validez la sortie contre un schéma et conservez le passage justificatif. Évaluez l’artefact final et les preuves d’outils plutôt que d’accepter un message de réussite confiant comme preuve.