Construire avec CometAPIBesoin d'une seule API pour plusieurs modèles ?Testez le workflow dans Playground, puis créez une clé API lorsque le modèle et le coût correspondent à votre cas d'usage.
Qu'est-ce que Step 5 Preview ? Caractéristiques techniques, benchmarks, tarifs et poids ouverts
Explorez StepFun Step 5 Preview, son architecture MoE de 600B, son contexte de 1M de jetons, ses benchmarks de codage, sa tarification, ses poids ouverts et l'accès à l'API.
Deon GoodwinÉquipe de recherche sur les modèles IA et API
Step 5 Preview est le modèle d’IA phare de StepFun pour l’ingénierie logicielle, la recherche financière et les flux d’agents complexes. Il combine des performances compétitives avec une inférence économique, bien que ses résultats varient selon les benchmarks. Les développeurs peuvent y accéder via une API hébergée ou déployer ses poids ouverts, selon leur budget, leur infrastructure et leurs exigences de performance.
Principaux enseignements
Architecture : Step 5 Preview utilise une architecture MoE clairsemée avec 600B de paramètres au total et 27B actifs par jeton, équilibrant capacité du modèle et efficacité d’inférence.
Contexte et prise en charge multimodale : le modèle prend en charge une fenêtre de contexte de 1M de jetons, des entrées texte, image et vidéo, et jusqu’à 64K jetons de sortie via son API hébergée.
Performances sur benchmarks : Step 5 Preview atteint 67.7% sur DeepSWE v1.1 et 66.4% sur FrontierFinance, bien qu’il soit derrière plusieurs concurrents sur Terminal-Bench v4.
Revu pour la clarté, l'attribution des sources et la terminologie API actuelle.
Tarification API : StepFun facture 1.00 $ pour l’entrée non mise en cache, 0.10 $ pour l’entrée mise en cache et 2.70 $ pour la sortie par million de jetons.
Flexibilité de déploiement : les développeurs peuvent accéder à Step 5 Preview via l’API hébergée de StepFun ou auto-héberger ses poids publiés avec des frameworks compatibles tels que vLLM, SGLang et Transformers.
Qu’est-ce que Step 5 Preview ?
Step 5 Preview est un grand modèle de raisonnement multimodal développé par StepFun (阶跃星辰). Il cible des charges de travail nécessitant un raisonnement étendu, des exécutions d’outils répétées et des analyses sur de larges ensembles d’informations. StepFun propose un accès API hébergé et publie des poids téléchargeables.
Contrairement aux assistants généralistes principalement optimisés pour des réponses conversationnelles, Step 5 Preview met l’accent sur l’exécution agentique : la capacité à planifier, utiliser des outils, inspecter des résultats intermédiaires, corriger des erreurs et poursuivre vers un objectif complexe.
Spécifications clés
La fiche modèle officielle documente son architecture clairsemée, le nombre de paramètres et les configurations de déploiement. Les spécifications de l’API hébergée définissent séparément les entrées prises en charge, les limites de génération et les fonctionnalités de service. Ce sont des couches différentes du contrat de déploiement.
Spécification (fiche modèle et doc API ci-dessus)
Step 5 Preview
Développeur
StepFun
Identifiant du modèle
step-5-preview
Catégorie du modèle
Raisonnement multimodal et LLM agentique
Architecture
Sparse Mixture-of-Experts
Paramètres totaux
Environ 600B
Paramètres actifs par jeton
Environ 27B
Proportion de paramètres actifs
Environ 4.5%
Fenêtre de contexte
Jusqu’à 1M de jetons
Entrées prises en charge
Texte, images et vidéo via l’API hébergée
Sortie maximale de l’API hébergée
64k jetons
Sortie principale
Texte
Modes de raisonnement
low, medium, high; reasoning_effort sur Chat Completions
Appel d’outils
Pris en charge
Sortie structurée
Mode JSON et Schéma JSON sur l’API hébergée
Mise en cache des invites
Pris en charge
Statut de l’API hébergée
Disponible au 19 octobre 2026
La documentation de l’API hébergée indique une sortie maximale de 64k jetons, tandis que la fiche modèle liste une capacité de génération de séquence jusqu’à 1M de jetons. Cette dernière n’implique pas que l’endpoint hébergé accepte une complétion de 1M de jetons. Pour les exemples vLLM auto-hébergés, le budget de séquence configuré à 1M couvre l’entrée et la sortie ensemble ; la mémoire de cache KV disponible et la concurrence peuvent réduire la capacité utilisable.
Fonctionnement de l’architecture MoE 600B/27B
Un transformeur dense conventionnel active la plupart de ses paramètres pendant l’inférence. Step 5 Preview utilise à la place un routage clairsemé pour sélectionner les experts pertinents. Avec environ 27B de paramètres actifs sur 600B, environ 4.5% du total des paramètres participe au calcul d’un jeton typique.
Cette distinction éclaire la stratégie d’efficacité des coûts du modèle. Toutefois, 27B actifs ne signifie pas une empreinte de déploiement de 27B. Les poids de tous les experts doivent toujours être stockés et accessibles, ce qui rend la capacité mémoire GPU, le parallélisme des experts et la bande passante des interconnexions essentiels.
Entrées prises en charge et limites de sortie
L’API hébergée accepte le texte, les images et la vidéo, avec une fenêtre de contexte allant jusqu’à 1M de jetons et une sortie maximale de 64k jetons. Ces entrées prennent en charge des tâches telles que l’analyse de dépôts, la recherche documentaire financière et l’interprétation visuelle. En auto-hébergement, la longueur de séquence utilisable dépend de la configuration du runtime, de la mémoire disponible et de la concurrence.
Le support multimodal et les capacités API peuvent différer entre les configurations hébergées et auto-déployées.
Comment Step 5 Preview se comporte-t-il sur les benchmarks ?
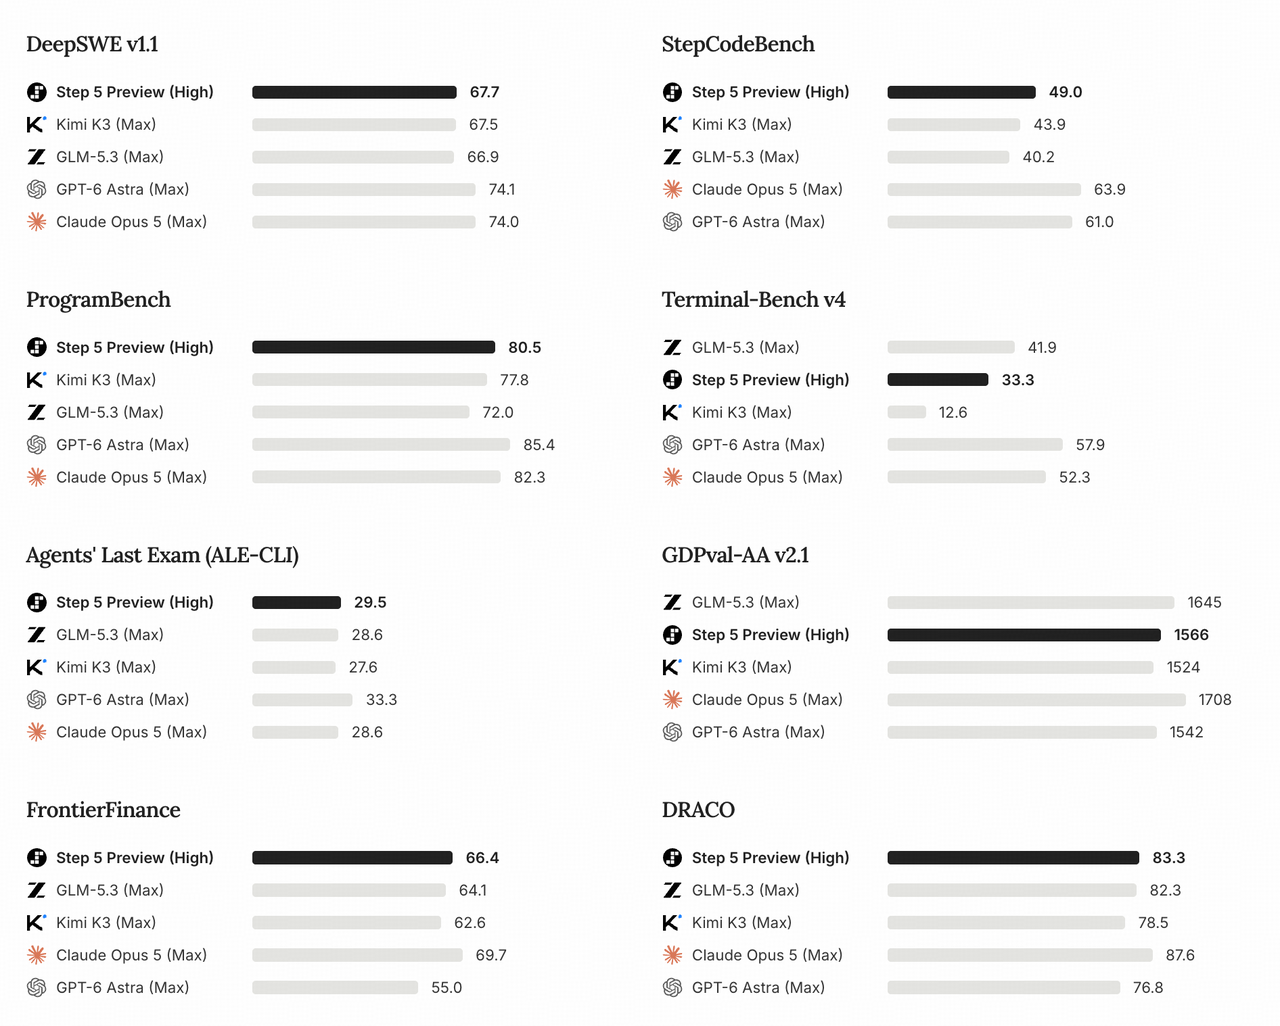
Ce qui suit correspond aux résultats rapportés par StepFun. Step 5 Preview utilise le réglage High de raisonnement ; les modèles de comparaison utilisent Max. Harmoniser les noms d’étiquettes ne garantit pas une charge de calcul égale, et ces scores publiés ne mesurent ni la latence applicative ni le coût par tâche réussie.
Le graphique officiel original résume les résultats d’évaluation de l’éditeur. Les tableaux ci-dessous extraient les scores de codage, de raisonnement et de finance pertinents pour cette analyse.
Performances en codage et agentiques
Benchmark
Step 5 Preview (High)
Kimi K3 (Max)
GLM-5.3 (Max)
GPT-6 Astra (Max)
Claude Opus 5 (Max)
DeepSWE v1.1
67.7
67.5
66.9
74.1
74.0
StepCodeBench
49.0
43.9
40.2
61.0
63.9
ProgramBench
80.5
77.8
72.0
85.4
82.3
Terminal-Bench v4
33.3
12.6
41.9
57.9
52.3
Agents’ Last Exam (ALE-CLI)
29.5
27.6
28.6
33.3
28.6
Les scores sont des pourcentages, des valeurs plus élevées indiquant de meilleures performances sur chaque benchmark. DeepSWE v1.1 utilise le harnais SWE-agent avec temperature=1.0 et top_p=0.95 ; StepCodeBench rapporte avg@4, tandis que ProgramBench rapporte le taux de réussite. Chaque benchmark mesure une tâche différente dans sa propre configuration d’évaluation, donc ces pourcentages ne sont pas des mesures d’exactitude interchangeables. La comparaison publiée n’établit pas un matériel ou des budgets d’exécution identiques entre modèles.
Sur DeepSWE v1.1, Step 5 Preview atteint 67.7%, dépassant de peu Kimi K3 et GLM-5.3. Cela suggère des performances compétitives pour des agents de codage travaillant avec des dépôts et des tâches d’ingénierie logicielle automatisées.
ProgramBench fournit un autre signal positif. Step 5 Preview atteint 80.5%, contre 77.8% pour Kimi K3 et 72.0% pour GLM-5.3.
Cependant, Terminal-Bench v4 révèle une limitation notable : le résultat de 33.3% de Step 5 Preview est derrière GLM-5.3 à 41.9%, tandis que GPT-6 Astra atteint 57.9%. L’implication est que Step 5 Preview est compétitif pour l’ingénierie logicielle orientée dépôt, mais son avantage relatif ne s’étend pas uniformément à l’exécution orientée terminal et au débogage complexe.
Performances en raisonnement et connaissances
Benchmark
Step 5 Preview (High)
GLM-5.3 (Max)
Kimi K3 (Max)
GPT-6 Astra (Max)
GPQA Diamond
93.5%
91.7%
93.5%
96.1%
Humanity’s Last Exam
46.5%
42.3%
46.9%
54.7%
AA-LCR v1.1
88.3%
79.7%
88.7%
80.7%
CritPt
20.9%
19.1%
23.4%
31.7%
Step 5 Preview atteint 93.5% sur GPQA Diamond, égalant Kimi K3 et derrière GPT-6 Astra à 96.1%. Sur AA-LCR v1.1, son résultat de 88.3% est légèrement inférieur aux 88.7% de Kimi K3 et supérieur aux 80.7% de GPT-6 Astra. Il est également derrière Kimi K3 et GPT-6 Astra sur Humanity’s Last Exam et CritPt. Les résultats indiquent un savoir et un raisonnement long-contexte compétitifs, avec des forces relatives variables selon la tâche.
Performances en recherche financière et valorisation
La recherche financière est l’un des domaines d’application les plus distinctifs de Step 5 Preview. Le modèle est conçu pour combiner raisonnement quantitatif, récupération d’éléments probants et analyse structurée. Ces capacités sont particulièrement pertinentes pour la valorisation, l’interprétation de documents financiers et la recherche d’investissement.
StepFun a introduit FinStepBench pour évaluer la recherche financière à plusieurs étapes, de la collecte d’informations à la production de conclusions défendables.
Benchmark
Step 5 Preview (High)
Kimi K3 (Max)
GLM-5.3 (Max)
GPT-6 Astra (Max)
Claude Opus 5 (Max)
FrontierFinance
66.4
62.6
64.1
55.0
69.7
FinStepBench LiveSearch
74.5
70.9
73.3
74.5
76.2
FinStepBench CorporateValuation
60.6
60.6
56.1
77.3
69.7
FinStepBench DeepResearch
55.8
48.9
53.3
45.0
59.1
Des scores plus élevés indiquent une performance plus forte sur les benchmarks. FinStepBench est développé par StepFun, donc une validation indépendante est particulièrement importante.
Step 5 Preview atteint 66.4% sur FrontierFinance, dépassant Kimi K3, GLM-5.3 et GPT-6 Astra dans les configurations rapportées. Toutefois, Claude Opus 5 reste devant avec 69.7%.
Le résultat FinStepBench DeepResearch est particulièrement notable. Step 5 Preview atteint 55.8%, contre 48.9% pour Kimi K3 et 53.3% pour GLM-5.3. Cela suggère que le modèle peut convenir aux flux de recherche financière nécessitant récupération, synthèse et analyse étendue.
Son score CorporateValuation raconte une histoire plus nuancée. À 60.6%, Step 5 Preview est significativement derrière les 77.3% de GPT-6 Astra. Par conséquent, Step 5 Preview ne doit pas être considéré comme universellement supérieur pour l’analyse financière. Son classement relatif est plus fort sur DeepResearch que sur CorporateValuation, ce qui plaide pour une évaluation spécifique à la tâche plutôt qu’une affirmation générale de supériorité financière.
Pour les applications en production, les sorties financières nécessitent toujours des calculs validés de manière indépendante, des hypothèses documentées et des preuves justificatives traçables.
Step 5 Preview vs autres modèles d’IA
Step 5 Preview concurrence à la fois des alternatives hébergées et des services propriétaires de pointe. Les résultats de benchmark aident à identifier des modèles candidats ; l’accès API, la prise en charge des entrées, le contrôle du déploiement et le coût réel de charge de travail déterminent le modèle le mieux adapté à une application de production.
CometAPI propose l’accès à Kimi K3, GLM-5.3, GPT-6 Astra, et Claude Opus 5. Ces alternatives offrent des points de comparaison utiles pour la qualité de charge de travail, la latence et le coût.
Step 5 Preview propose un checkpoint MoE clairsemé documenté 600B/27B et une option d’auto-hébergement. Pour les alternatives, la disponibilité des poids, le nombre de paramètres, les limites de contexte et les entrées acceptées dépendent du modèle et de l’endpoint. Des benchmarks publiés peuvent aider à établir une présélection ; des tâches représentatives de codage et de recherche révèlent comment chaque service se comporte en pratique.
Step 5 Preview vs Kimi K3
Step 5 Preview performe légèrement mieux sur DeepSWE v1.1, ProgramBench et FrontierFinance. Kimi K3 reste compétitif en raisonnement et dans certaines autres évaluations techniques. La différence pratique tient moins à un avantage d’intelligence décisif qu’au coût, aux conditions de service et à la fiabilité spécifique aux tâches disponibles pour les développeurs.
Step 5 Preview vs GLM-5.3
Step 5 Preview devance GLM-5.3 dans plusieurs évaluations financières et de développement logiciel. Cependant, le score plus élevé de GLM-5.3 sur Terminal-Bench v4 suggère un avantage dans les tâches orientées terminal rapportées. Pour les agents de codage, comparez les modifications de dépôt réussies, les erreurs d’appel d’outils, le temps d’exécution et la correction des patchs plutôt que de s’appuyer sur un score agrégé unique.
Step 5 Preview vs GPT-6 Astra et Claude Opus 5
Les modèles propriétaires de pointe performent généralement mieux sur les benchmarks d’ingénierie logicielle les plus difficiles. L’attraction principale de Step 5 Preview est qu’il approche une capacité compétitive sur certaines charges tout en offrant une option de déploiement avec poids ouverts et une tarification API relativement accessible.
Choisissez un modèle premium lorsque le coût de l’échec est élevé et que l’exactitude incrémentale des tâches justifie une dépense supplémentaire. Envisagez Step 5 Preview lorsque le prix, le contrôle du déploiement et l’exécution répétée des agents pèsent plus.
Combien coûte l’API Step 5 Preview ?
La valeur de Step 5 Preview dépend à la fois des capacités de la tâche et des coûts d’exploitation. Les flux d’agents peuvent impliquer des dizaines d’appels, des récupérations de documents répétées et des réessais ; un prix par jeton inférieur n’aide que lorsque le modèle complète la tâche de manière fiable. Le coût par tâche réussie est un complément utile aux tarifs ci-dessous.
Disponibilité API et tarification des jetons
Cette vue au 19 octobre 2026 compare les tarifs API natifs de StepFun avec les tarifs CometAPI liés dans la section de comparaison des modèles. Tous les prix sont en dollars US par million de jetons. Les services ont des conditions différentes de facturation, de cache et d’endpoint ; “not listed” signifie que l’instantané source de cet article ne fournit pas de tarif d’entrée mise en cache.
Modèle
Canal de service
ID du modèle
Entrée non mise en cache / 1M jetons
Entrée mise en cache / 1M jetons
Sortie / 1M jetons
Step 5 Preview
API native StepFun
step-5-preview
$1.00
$0.10
$2.70
Kimi K3
CometAPI
kimi-k3
$2.40
Not listed
$12.00
GLM-5.3
CometAPI
glm-5.3
$1.12
Not listed
$3.53
GPT-6 Astra
CometAPI
gpt-6-astra
$8.00 (short-context tier)
Not listed
$40.00 (short-context tier)
Claude Opus 5
CometAPI
claude-opus-5
$4.00
Not listed
$20.00
Le palier short-context de GPT-6 Astra s’applique jusqu’à 272,000 jetons ; les tarifs long-context indiqués sont de 16 $ pour l’entrée et 60 $ pour la sortie par million de jetons. Les tarifs listés excluent les outils, réessais et l’infrastructure. La disponibilité de Step 5 Preview via CometAPI n’est pas établie par cette comparaison ; l’exemple Step 5 Preview ci-dessous utilise l’endpoint natif de StepFun.
Le tarif d’entrée en cache est inférieur de 90% au tarif non mis en cache. Le prix non mis en cache inclut l’écriture de nouveau contenu dans le cache, tandis que la facturation de sortie inclut les jetons de raisonnement et de réponse finale. Un texte d’invite répété ne bénéficie du tarif inférieur que lorsque le service signale un hit de cache qualifiant ; la longueur visible de la réponse sous-estime les sorties facturables.
Exemples de calculs de coûts
Charge API
Entrée non cache
Entrée cache
Sortie
Coût estimé
Demande analytique courte
10K
0
5K
$0.0235
Flux de codage moyen
100K
0
20K
$0.154
Requête agent répétée
10K
90K
20K
$0.073
Analyse de grand document
500K
0
30K
$0.581
Flux long-contexte en cache
100K
400K
50K
$0.275
Formule de coût : C = (Tu × Pu + Tc × Pc + To × Po) / 1,000,000, où Tu/Tc/To représentent respectivement les jetons d’entrée non mis en cache, d’entrée mise en cache et de sortie facturable, et Pu/Pc/Po leurs prix par million de jetons.
Considérez deux requêtes StepFun avec les mêmes 100,000 jetons d’entrée et 20,000 jetons de sortie facturables :
Cache manqué : les 100,000 jetons d’entrée sont non mis en cache. Coût = (100,000 × $1.00 + 20,000 × $2.70) / 1,000,000 = $0.154.
Cache touché : 90,000 jetons d’entrée bénéficient du tarif cache et 10,000 restent non mis en cache. Coût = (10,000 × $1.00 + 90,000 × $0.10 + 20,000 × $2.70) / 1,000,000 = $0.073.
L’exemple avec hit de cache économise $0.081, soit environ 52.6%, avec les mêmes volumes d’entrée et de sortie. L’économie dépend d’un hit de cache qualifiant signalé par le service. Les deux exemples excluent les outils externes, les réessais et les coûts d’infrastructure.
Les prix par jeton ne déterminent pas à eux seuls le modèle au meilleur rapport valeur. Un agent nécessitant plusieurs réessais peut coûter plus cher qu’un modèle à prix plus élevé qui réussit du premier coup. Pour une comparaison fiable des coûts, utilisez le coût par tâche réussie en parallèle de la tarification par jeton.
Step 5 Preview est-il open source et peut-il fonctionner localement ?
StepFun publie des poids téléchargeables via ses dépôts officiels Hugging Face, avec des variantes FP8, BF16 et NVFP4 disponibles au 19 octobre 2026. L’accès aux poids permet l’auto-déploiement, mais ne rend pas le modèle équivalent à un petit modèle dense en exigences mémoire.
Les fichiers disponibles incluent le checkpoint Step 5 Preview, la version BF16 et la version NVFP4.
La terminologie est importante : Step 5 Preview propose des poids ouverts sous StepFun Model License 1.0. La licence inclut une attribution spécifique au modèle et des conditions de licence commerciale. Évaluez ces termes pour votre usage et distribution prévus avant déploiement.
FP8 avec vLLM : 4 × NVIDIA B300 ou 8 × NVIDIA H200, servant une API compatible OpenAI.
BF16 avec vLLM : 8 × NVIDIA B300 ou 16 × NVIDIA H200, servant une API compatible OpenAI.
FP8 avec SGLang : 4 × NVIDIA B300, servant une API compatible OpenAI ; FP8 avec Transformers : 8 × NVIDIA H200 pour génération hors ligne.
Ce sont des configurations de référence, pas des garanties minimales pour chaque checkpoint, runtime, longueur de contexte ou réglage de concurrence. L’activation clairsemée réduit le calcul, mais le stockage des poids d’experts et la mémoire de cache KV restent des considérations majeures.
Un modèle 600B présente aussi des défis au-delà de la capacité mémoire, notamment la communication multi-GPU, la compatibilité framework, le chargement des checkpoints et le débit en long contexte. Pour les équipes sans grands clusters GPU, une API hébergée est généralement le point de départ le plus pratique.
Comment les développeurs peuvent-ils utiliser l’API Step 5 Preview ?
StepFun prend en charge une interface Chat Completions compatible OpenAI. Définissez STEPFUN_API_KEY dans l’environnement avant d’exécuter l’exemple Python suivant ; max_tokens borne la sortie générée de cette requête. Utilisez la clé API et les conditions de facturation pour la plateforme régionale sélectionnée : cet exemple conserve l’endpoint api.stepfun.ai, tandis que les prix en dollars ci-dessus proviennent de la plateforme internationale de StepFun.
Exemple Python : envoyer une requête texte bornée à l’API StepFun et imprimer la réponse renvoyée.
import os
from openai import OpenAI
client = OpenAI(
    api_key=os.environ["STEPFUN_API_KEY"],
    base_url="https://api.stepfun.ai/v1",
)
response = client.chat.completions.create(
    model="step-5-preview",
    messages=[{
        "role": "user",
        "content": (
            "Analyze the architectural risks of migrating "
            "a monolithic application into microservices."
        ),
    }],
    max_tokens=4000,
)
print(response.choices[0].message.content)
Avant un usage en production, confirmez les paramètres acceptés et les limites de génération de l’endpoint StepFun sélectionné. L’effort de raisonnement, la mise en cache des invites, les schémas d’outils et les budgets de sortie peuvent tous affecter la fiabilité, la latence et la facture finale.
Step 5 Preview dans les flux d’agents
Lire la documentation du dépôt et les fichiers pertinents.
Identifier la modification demandée et proposer un plan.
Modifier le code sélectionné et exécuter des tests via des outils externes.
Inspecter les échecs et réviser l’implémentation.
Produire une explication finale des changements validés.
Le modèle génère du raisonnement et des requêtes d’outils ; l’application fournit l’accès réel aux fichiers, les environnements d’exécution, les autorisations et les contrôles de sécurité. La capacité du modèle seule ne garantit pas une exécution autonome.
APIs de modèles alternatives dans CometAPI
CometAPI fournit l’accès aux modèles alternatifs liés ci-dessus via un service d’intégration partagé. Sélectionnez l’endpoint et le format de requête documentés de chaque modèle, puis comparez taux de succès, utilisation des jetons, réessais et latence de bout en bout sur la même charge de travail.
L’exemple ci-dessus utilise l’endpoint natif de StepFun. Passer à une passerelle nécessite de confirmer la disponibilité de Step 5 Preview et l’identifiant de modèle, l’endpoint et les conditions de facturation documentés de la passerelle.
Quand choisir Step 5 Preview ?
Choisissez-le pour le codage de dépôts et la recherche riche en documents lorsque des tests représentatifs confirment des résultats fiables. Sa longue fenêtre de contexte et ses scores publiés en codage et finance en font un candidat, tandis que les résultats Terminal-Bench v4 et CorporateValuation montrent pourquoi des tests spécifiques à la charge de travail comptent.
Choisissez l’API hébergée si vous voulez démarrer sans opérer un grand cluster GPU. Comparez le coût par tâche acceptée, les taux de hit de cache, les réessais et la latence ; une grande fenêtre de contexte ne garantit pas des réponses rapides ni un coût total plus bas.
Choisissez l’auto-hébergement lorsque le contrôle du déploiement justifie la charge matérielle et opérationnelle. Préparez un budget pour le stockage complet des poids d’experts, le cache KV, la communication multi-GPU et les exigences de licence. Pour des travaux financiers ou d’ingénierie lourds de conséquences, incluez des vérifications de source, la détection d’erreurs et une relecture humaine.
FAQ
Comment choisir l’effort de raisonnement de Step 5 Preview ?
Commencez avec un petit ensemble de tâches représentatives et comparez low, medium et high avec les mêmes critères d’acceptation. Enregistrez la justesse, la sortie facturable, la latence et les échecs d’outils. Utilisez le réglage le plus bas qui répond constamment au seuil de qualité ; les scores de benchmark High publiés ne prédisent pas le comportement des modes low ou medium. Suivez le guide de configuration du raisonnement et définissez reasoning_effort explicitement sur Chat Completions lors de la comparaison des configurations.
Pourquoi une requête Step 5 Preview peut-elle s’arrêter avant 64k jetons de sortie ?
Le maximum documenté est un plafond, pas une longueur cible. Une requête peut s’arrêter plus tôt parce qu’elle a atteint son budget max_tokens, a renvoyé un arrêt naturel, ou a produit un appel d’outil que l’application doit traiter. Inspectez la raison de fin renvoyée et toute requête d’outil avant de relancer automatiquement. Une réponse plus courte complétée n’indique pas un échec de fenêtre de contexte.
Comment tester les entrées vidéo de Step 5 Preview ?
Commencez avec un clip court et représentatif et une question dont vous pouvez vérifier la réponse. La spécification d’entrée vidéo de l’API hébergée accepte la vidéo par URL, Base64 ou une référence stepfile ; ses formats documentés incluent MP4, QuickTime et Matroska. Pour une entrée par URL, la documentation spécifie des fichiers MP4 individuels de moins de 128 MB et recommande moins de cinq minutes. Confirmez les limites de format et de taille avant le batching, et testez des questions temporelles ainsi que la reconnaissance image par image.
Quelles métriques révèlent le véritable coût agent de Step 5 Preview ?
Mesurez les tâches acceptées, le total des jetons d’entrée et de sortie sur tous les tours, les hits de cache, les réessais, les charges d’outils externes et le temps écoulé. Divisez le coût total d’exécution par les réussites, en gardant le critère de succès fixe entre modèles. Cela capture l’effet économique d’un appel moins cher nécessitant plus de tentatives, ou d’un run à effort élevé qui réduit les échecs ultérieurs.
Conclusion
Step 5 Preview mérite une évaluation lorsqu’une application nécessite un traitement long-contexte, une utilisation répétée d’outils ou un contrôle sur le déploiement du modèle. Les résultats publiés par StepFun en font un candidat pour le codage de dépôts et la recherche financière, tandis que Terminal-Bench v4 et CorporateValuation montrent des domaines où des alternatives listées obtiennent de meilleurs scores. Comparez les modèles avec des critères d’acceptation fixes, le coût total par tâche acceptée et la latence de bout en bout. Pour l’auto-hébergement, incluez les coûts d’infrastructure et les exigences de licence dans la décision.