
TL;DR
L’OpenAI Decisions API est un endpoint spécialisé qui transforme du texte et des images en décisions exploitables et lisibles par machine, plutôt qu’en prose générée. Il utilise GPT-6 Luna et prend en charge des questions de type predicate, choice et score. OpenAI annonce des performances environ 10× plus rapides que son Responses API pour les tâches de décision prises en charge et une tarification standard des entrées à $0.10 par million de tokens.
Points clés
- Décisions conçues à dessein : questions prédéfinies plutôt que conversation libre.
- Trois types de décisions : predicate, choice et score.
- Automatisation consciente des probabilités : diriger les entrées ambiguës ou à fort enjeu vers une revue humaine.
- Des gains de vitesse rapportés par le fournisseur et une tarification standard des entrées à $0.10 par million de tokens (sans facturation de sortie) rendent l’endpoint pertinent pour des volumes élevés.
- Idéal pour le routage, la classification, les vérifications visuelles et les garde-fous de décision d’agents IA.
Qu'est-ce que l'OpenAI Decisions API ?
L’OpenAI Decisions API évalue des informations et renvoie des décisions bornées et lisibles par machine. OpenAI l’a mise en bêta le 6 octobre 2026 (https://developers.openai.com/api/docs/changelog). Ce guide s’adresse aux développeurs qui maîtrisent déjà les clés d’API et JSON et souhaitent évaluer des workflows de classification ou de routage. Les détails produit ont été vérifiés le 12 octobre 2026.
Le schéma de requête POST /v1/decisions accepte un modèle, une entrée partagée (texte ou image) et des questions définies par le développeur. L’endpoint dédié renvoie des jugements typés plutôt que de la prose explicative.
Spécifications de l'OpenAI Decisions API
| Spécification | Détails documentés de l’endpoint |
|---|---|
| Type de produit | Endpoint d’API spécialisé, pas un modèle de base autonome |
| Endpoint | POST /v1/decisions |
| Modèle sous-jacent | gpt-6-luna |
| Entrées | Texte et images |
| Types de décision | predicate, choice, score |
| Sorties | Décisions typées et informations de probabilité |
| Performances | Environ 10× plus rapide que Responses API (déclaration du fournisseur) |
| Prix standard d’entrée | $0.10 / 1M tokens |
| Facturation de sortie | Aucune pour Decisions API |
| Appels d’outils/streaming | Non pris en charge directement par ce point de terminaison |
Disponibilité et accès actuels
Au 15 octobre 2026, le guide officiel mentionne un accès en bêta publique, avec gpt-6-luna comme seul modèle pris en charge. Envoyez des requêtes à POST /v1/decisions ; le statut bêta ne garantit pas la stabilité en production.
Utilisez un projet OpenAI API et vérifiez l’accès au modèle, l’état de facturation et les limites de débit avant le déploiement. Le guide mentionne le SDK Python 3.26.0 ou ultérieur ; l’accès spécifique au compte doit être confirmé avec une petite requête de test.
Les clients éligibles peuvent utiliser Zero Data Retention et des dispositions HIPAA. Le guide mentionne un traitement régional aux États-Unis et en Europe ; l’éligibilité et les exigences contractuelles s’appliquent. L’accès via une interface Luna tierce ne garantit pas la compatibilité avec cet endpoint dédié.
Comment fonctionne l'OpenAI Decisions API ?
Une requête combine des éléments de preuve d’entrée partagés avec des questions définies par le développeur. L’API évalue l’entrée via GPT-6 Luna et renvoie des réponses que le code applicatif peut utiliser pour automatiser, réviser ou escalader. Plusieurs questions peuvent partager la même entrée, bien que les questions dépendantes doivent être séquencées par l’application.
Évaluation predicate
Un predicate évalue si une condition spécifiée est vraie. Un commerçant pourrait demander si une photographie montre des dommages visibles au produit ; la réponse fournit une probabilité entre 0 et 1.
Extrait illustratif de réponse predicate.
{
  "type": "predicate",
  "name": "visible_damage",
  "probability": 0.92
}
Sélection choice
Une question de type choice sélectionne parmi des catégories fournies explicitement, telles que Facturation, Support technique ou Accès au compte. Les champs de distribution et de confiance soutiennent les politiques de routage et d’escalade en aval.
Évaluation score
Une question de type score évalue l’entrée selon une grille ordonnée. Le score attendu peut refléter les indices pondérés par la probabilité des niveaux définis ; cela ne représente pas automatiquement un risque réel calibré.
| Indice | Gravité | Interprétation |
|---|---|---|
| 0 | Faible | Aucune action immédiate |
| 1 | Modérée | Suivi de routine |
| 2 | Élevée | Impact client significatif |
| 3 | Critique | Escalade immédiate |
Quelles sont les principales fonctionnalités de l'OpenAI Decisions API ?
Exécution rapide et bornée
Des sorties typées évitent en grande partie de générer de la prose, d’analyser du texte ou de réessayer des réponses malformées. OpenAI évoque un gain de vitesse d’environ un facteur dix sur les tâches de décision prises en charge ; les gains réels dépendront de la longueur d’entrée, de la latence réseau et de la concurrence.
Plusieurs questions sur un contexte partagé
Un ticket de support peut être évalué pour le service, l’urgence et l’éligibilité à la revue dans une seule requête. Les applications doivent néanmoins faire respecter des règles métier déterministes et des contrôles d’autorisation.
Compréhension du texte et de l’image
Le texte et les images permettent le routage de tickets, le tri de captures d’écran et l’inspection visuelle. Consultez la documentation officielle pour les formats d’image pris en charge, les limites de taille et les structures de charge utiles acceptées actuellement.
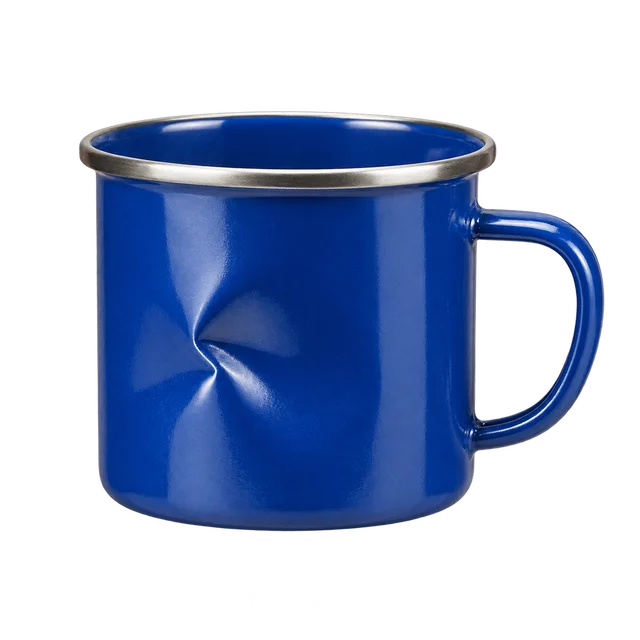
OpenAI utilise cette tasse cabossée dans son exemple de décision visuelle. L’image illustre un dommage observable ; elle ne constitue pas une preuve d’un taux de précision mesuré. Cet endpoint accepte des URL d’images en data URL base64 intégrées, et non des URL d’images hébergées ou des IDs de fichier.
Automatisation consciente des probabilités
La confiance rapportée n’est pas une garantie d’exactitude. Les équipes doivent ajuster les seuils sur des données annotées de réserve, avec des seuils distincts pour les cas à fortes conséquences de faux positifs ou de faux négatifs.
Sécurité et contrôles des données
La rétention des données, le traitement régional et l’usage réglementé dépendent de la configuration du compte et des exigences contractuelles applicables. Confirmez l’éligibilité avant de traiter des informations réglementées ou sensibles.
Combien coûte l'OpenAI Decisions API ?
Le tarif standard rapporté est de $0.10 par million de tokens d’entrée sans facturation des tokens de sortie via l’endpoint Decisions dédié. Les multiplicateurs de traitement régional ou de long contexte peuvent modifier la facture finale.
| Composant | Tarification de l’endpoint dédié |
|---|---|
| Entrée standard | $0.10 par 1M tokens |
| Tokens de sortie | $0 |
| Lectures/écritures cache | $0 |
| Traitement régional | Une majoration peut s’appliquer |
| Contexte long | Un multiplicateur peut s’appliquer |
| Unité de facturation | Tokens d’entrée |
Combien Decisions API peut-elle faire économiser par rapport à Responses API ?
Comparez des tâches équivalentes sur le même modèle. Le guide Decisions indique $0.10 par million de tokens d’entrée et aucune facturation de sortie ou de cache. La page du modèle Luna indique une tarification Standard pour le texte de $0.10/M d’entrée non mise en cache et $0.50/M de sortie pour l’usage général du modèle.
Calcul illustratif, pas un benchmark : 1,000,000 requêtes texte, 500 tokens d’entrée facturables non mis en cache par requête sur chaque endpoint, une classification par requête, et aucune majoration régionale ou de long contexte. Pour Responses, utilisez le total des tokens de sortie facturés, y compris les tokens de raisonnement facturés, et pas seulement la longueur visible de la réponse.
Dans ces hypothèses : Coût Decisions = N × I × $0.10 / 1,000,000. Coût Responses = N × (I × $0.10 + O × $0.50) / 1,000,000. Pourcentage d’économies = (Coût Responses − Coût Decisions) / Coût Responses × 100 %, où N est le nombre de requêtes, I les tokens d’entrée/requête et O les tokens de sortie facturés/requête.
| Sortie facturée Responses / requête | Coût Decisions / 1M requêtes | Coût Responses / 1M requêtes | Économies estimées |
|---|---|---|---|
| 5 tokens | $50.00 | $52.50 | $2.50 (4.8%) |
| 20 tokens | $50.00 | $60.00 | $10.00 (16.7%) |
| 100 tokens | $50.00 | $100.00 | $50.00 (50.0%) |
Les économies ci-dessus proviennent de la facturation supposée de la sortie Responses ; ce ne sont pas une remise fixe d’endpoint. Recalculez avec l’usage d’entrée mesuré, les hits du cache, les écritures de cache, le palier de traitement et les réessais. Les taux d’entrée mise en cache ou Batch/Flex peuvent changer le résultat. Ajoutez séparément les frais d’outils, la revue humaine et l’infrastructure. Comparez le coût par décision correcte acceptée après vérification de la qualité et de la latence ; une étiquette courte et une explication plus longue sont des charges de travail différentes.
OpenAI Decisions API vs Responses API vs Jev et Aplomb 1
Le tableau se concentre sur les services de décision dédiés. Pour des explications générées, des schémas d’extraction personnalisés ou des workflows d’outils, utilisez le Responses API comme décrit dans le guide de décision OpenAI. Une décision peut sélectionner une branche de workflow, tandis que Responses génère du contenu ou demande un appel d’outil, avec un code applicatif gérant l’exécution d’outils personnalisés.
Aperçu des capacités et de la tarification
| Dimension | OpenAI Decisions API | Jev 1.13 | Aplomb 1 |
|---|---|---|---|
| Entrées | Texte et images | Texte ; images expérimentales avec opt-in | Texte, JSON, images, vidéo et audio |
| Prix standard d’entrée / 1M tokens | $0.10 | $0.042 | $0.02 |
| Accès | API OpenAI hébergée | API TypeSafe hébergée | API hébergée ; poids téléchargeables sous la EmpirioLabs Model License |
| Adéquation à l’évaluation | Routage, filtrage et scoring dans les workflows OpenAI | Classification et routage d’intention | Décisions multimédia ; déploiement nécessitant des poids |
Périmètre de sélection : Jev et Aplomb sont inclus pour leurs capacités de décision publiées, et non comme un classement de popularité. Les spécifications et prix standard d’entrée ont été vérifiés le 16 octobre 2026. TypeSafe mappe toujours jev-latest vers 1.13 et jev-preview vers 1.14, donc cette comparaison fixe 1.13. La prise en charge des images par Jev est expérimentale. Les poids Aplomb sont soumis à des restrictions de licence ; vérifiez les conditions pour un déploiement commercial. Les prix publiés par token ne constituent ni un classement de qualité ni une estimation du coût total du workflow.
Sélection du flux de travail
Sélectionnez les services selon les entrées requises et les options de déploiement, puis testez-les sur les mêmes cas annotés. Alignez la préparation des entrées, les grilles de décision, les mesures de latence de bout en bout et les politiques de revue humaine. Comparez la précision de routage, les cas manqués, la charge de revue et le coût par décision correcte acceptée. Présentez ces résultats ensemble afin qu’un prix par token plus bas ou une réponse plus rapide ne masque pas des erreurs supplémentaires ou des coûts de revue.
Comment utiliser l'OpenAI Decisions API ?
Étape 1 : Configurer les identifiants
Créez une clé d’API et fournissez-la via la variable d’environnement OPENAI_API_KEY. Ne codez jamais des clés secrètes en dur dans des dépôts ou des applications front-end.
Étape 2 : Envoyer une requête avec cURL
La requête suivante suit le schéma d’exemple officiel choice. Définissez OPENAI_API_KEY avant de l’exécuter ; une réponse réussie contient un tableau answers. Les commandes shell utilisent la syntaxe Bash.
Diriger une demande d’assistance avec cURL.
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [
      {
        "type": "choice",
        "name": "department",
        "instructions": "Which department should handle this complaint?",
        "choices": [
          {"value": "billing", "description": "Payments and refunds"},
          {"value": "technical", "description": "Product issues"},
          {"value": "other", "description": "Everything else"}
        ]
      }
    ]
  }'
Étape 3 : Intégrer avec Python
Installez le SDK Python requis.
pip install --upgrade "openai>=3.26.0"
Demander et inspecter une décision choice.
from openai import OpenAI

client = OpenAI()
result = client.decisions.create(
    model="gpt-6-luna",
    input="I was charged twice for my order.",
    questions=[{
        "type": "choice",
        "name": "department",
        "instructions": "Which team should handle this request?",
        "choices": [
            {"value": "billing", "description": "Payments and refunds"},
            {"value": "technical", "description": "Product issues"},
            {"value": "other", "description": "Other requests"}
        ]
    }]
)
answer = result.answers[0]
if answer.type == "refusal":
    print("Decision refused")
elif answer.type == "choice":
    print(answer.choice, answer.confidence)
Étape 4 : Définir une règle d’escalade
Appliquer un seuil de routage illustratif.
if answer.type == "choice":
    if answer.choice != "other" and answer.confidence >= 0.90:
        print("Eligible for automatic routing")
    else:
        print("Send to human review")
Le seuil de 0.90 est illustratif, ce n’est ni une garantie du fournisseur ni une valeur par défaut officiellement recommandée. Validez-le sur des exemples réels et selon le risque métier.
Comment accéder à GPT-6 Luna via CometAPI ?
Les développeurs peuvent utiliser la GPT-6 Luna API dans CometAPI pour des tâches générales sur le modèle. Cela ne doit pas être confondu avec la prise en charge de l’endpoint OpenAI Decisions dédié, qui nécessite une vérification de compatibilité distincte.
Classifier du texte via CometAPI Responses.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)
response = client.responses.create(
    model="gpt-6-luna",
    input=(
        "Classify as billing, technical, or other. "
        "Return only the category. "
        "Request: I was charged twice for my order."
    )
)
print(response.output_text)
Cet exemple illustre une classification générale via l’interface modèle compatible CometAPI ; il ne renvoie pas la structure de probabilité native de Decisions API et n’hérite pas de sa tarification « entrée uniquement ».
Quels sont les meilleurs cas d’usage pour l’OpenAI Decisions API ?
Ce sont des workflows applicatifs illustratifs, pas des déploiements rapportés ni des résultats de benchmark. Ils utilisent les types de question predicate, choice et score du guide officiel Decisions. Le code applicatif exécute les actions en aval.
Classification du support client
Fournissez le texte du ticket, l’historique de conversation pertinent et une liste prédéfinie d’équipes de support. Une question choice peut sélectionner Facturation, Support technique ou Accès au compte ; une question score séparée peut évaluer l’urgence selon une grille écrite. Le code applicatif peut affecter la file suggérée et envoyer les cas incertains ou incomplets à un réviseur.
Évaluez le workflow sur des tickets annotés par le support, en mesurant la précision de routage par catégorie, les cas urgents manqués, les taux de réaffectation et la charge de revue. Comparez ces résultats au processus de routage existant avant d’étendre le déploiement.
Modération de contenu et files de revue
Fournissez le texte ou les images soumis avec des catégories de revue clairement définies. Des questions predicate peuvent évaluer l’apparition de conditions particulières dans le contenu, tandis qu’une question score peut prioriser la revue selon une grille de gravité documentée. L’application peut ensuite placer les éléments signalés dans la file appropriée et présenter le contenu pertinent aux réviseurs ; l’endpoint lui-même ne supprime pas le contenu et n’applique pas les règles de la plateforme.
Évaluez les violations manquées, les signalements inutiles, l’accord entre réviseurs et les délais de file sur des exemples représentatifs annotés. Ajustez les seuils séparément pour les catégories aux conséquences différentes.
Inspection d’images e-commerce
Fournissez des photos de produit et les critères d’inspection pertinents, tels que fissures visibles, déchirures ou emballage endommagé. Des questions predicate peuvent déterminer si chaque condition apparaît, et une question score peut appliquer une grille de gravité définie lorsque les images contiennent des preuves suffisantes. Le code applicatif peut demander une autre photo ou créer une tâche d’inspection humaine lorsque les preuves sont ambiguës.
Évaluez la précision de détection par rapport aux articles inspectés, y compris les dommages manqués et les fausses alertes selon les catégories de produits et les conditions d’image. Conservez les décisions de remboursement ou de remplacement dans le flux d’approbation existant du détaillant.
Garde-fous d’action d’agent IA
Fournissez l’action proposée, ses arguments, la demande utilisateur concernée et les règles écrites d’exécution de l’application. Des questions predicate peuvent évaluer si la proposition correspond à la tâche demandée ou nécessite une revue. Le code applicatif peut utiliser le résultat pour sélectionner une branche prédéfinie : continuer, demander une clarification ou escalader. Des contrôles d’autorisation indépendants doivent toujours déterminer si l’exécution est autorisée ; le jugement du modèle n’est qu’un des intrants.
Évaluez le garde-fou avec des propositions d’action annotées, en mesurant les actions non autorisées manquées, les escalades inutiles et la sensibilité au contexte incomplet ou contradictoire avant de le connecter à l’exécution.
Triage de documents et d’e-mails
Fournissez le texte du document ou de l’e-mail, les métadonnées pertinentes et un ensemble fixe de catégories telles que facture, demande de support, demande de réunion ou autre. Une question choice peut sélectionner la catégorie, tandis que des questions predicate peuvent identifier des conditions comme des informations obligatoires manquantes. Le code applicatif peut envoyer l’élément vers l’extraction, la recherche ou la revue appropriée sans demander à l’endpoint de décision d’exécuter ces étapes ultérieures.
Évaluez l’exactitude des catégories, le routage aval erroné, le volume de revue et le temps de traitement à l’aide d’enregistrements représentatifs annotés, y compris des éléments ambigus et des formats inconnus.
Quelles sont les limites de l’OpenAI Decisions API ?
L’API ne génère pas de contenu explicatif arbitraire, n’exécute pas d’outils directement et n’élimine pas le besoin de tester les prédictions. Des catégories manquantes et des grilles de décision mal conçues peuvent produire des résultats inappropriés. Les valeurs de confiance peuvent être mal calibrées ; l’automatisation à fort enjeu nécessite toujours des garde-fous, une revue humaine et une logique d’autorisation.
Conclusion
Le Decisions API est prometteur pour des jugements bornés à grand volume, car il combine des sorties typées probabilisées avec un modèle de tarification par tokens simplifié. Les équipes devraient le comparer à Structured Outputs et à des modèles de décision alternatifs sur les mêmes cas annotés, mesures de latence et coûts complets de workflow. L’opportunité clé est d’identifier les étapes d’une application d’IA qui nécessitent un choix plutôt qu’une prose générée.
FAQ
Comment faut-il gérer les refus de l’OpenAI Decisions API ?
Traitez un refus comme un résultat de workflow distinct. Vérifiez answer.type avant de lire les champs choice, score ou probability. Journalisez le nom de la question et dirigez la requête vers un parcours de revue ou de récupération ; n’interprétez jamais un refus comme un predicate négatif ou un score nul.
Comment maintenir les seuils de Decisions API dans le temps ?
Choisissez des seuils sur des exemples annotés de réserve, puis surveillez la précision parmi les décisions acceptées et la part envoyée en revue. Réévaluez après toute modification des catégories, des instructions, des sources d’entrée ou du comportement du modèle. Conservez une grille versionnée pour que les changements de routage soient traçables à la configuration qui les a produits.
Comment rapporter les tests de latence de l’OpenAI Decisions API ?
Enregistrez la date, la région, l’identifiant du modèle, le nombre de questions, la longueur du texte, la taille d’image, la concurrence, la version du client, la politique de réessai et la configuration de l’endpoint de comparaison. Rapportez les p50 et p95 de bout en bout avec le nombre d’échantillons et les résultats de qualité, afin qu’un gain de vitesse ne provienne pas simplement de l’acceptation de plus d’erreurs.
Comment faire évoluer les catégories du Decisions API sans casser les intégrations ?
Utilisez des valeurs stables lisibles par machine et maintenez une correspondance explicite avec les files aval. Ajoutez une catégorie de repli et testez les cas limites historiques avant de déployer de nouvelles descriptions. Si une catégorie est renommée, mettez à jour la table de routage et la grille ensemble au lieu de laisser des valeurs inconnues atteindre les actions de production.
Que faut-il journaliser pour un audit de routage du Decisions API ?
Enregistrez la version de la grille, la catégorie sélectionnée, les probabilités ou la confiance pertinentes, le seuil, l’identifiant du modèle, l’horodatage et l’action entreprise. Limitez le contenu d’entrée stocké à ce que le workflow nécessite et appliquez la politique de rétention de l’organisation. Un enregistrement d’audit doit montrer pourquoi la logique applicative a routé ou escaladé le cas.