
TL;DR: Quale alternativa all'API GPT-6 Astra dovresti scegliere?
Scegli il modello in base al carico di lavoro: Claude Opus 5 come sostituto premium più vicino, Claude Fable 5.1 per il ragionamento prolungato più difficile, GPT-5.6 Sol per la migrazione OpenAI con il minor attrito, Claude Sonnet 5 per produzioni ad alto volume, Gemini 3.8 Flash per lavori multimodali a basso costo e DeepSeek V4.1 Flash quando il costo dei token è il vincolo principale.
Mantieni GPT-6 Astra per i carichi in cui il suo migliore uso del computer, l’esecuzione autonoma, il ragionamento scientifico o le prestazioni in cybersecurity riducono sensibilmente i retry e l’intervento umano.
Punti chiave: Cosa conta quando si sostituisce GPT-6 Astra?
- GPT-6 Astra è difficile da sostituire nei suoi compiti agentici più forti. La tabella di benchmark ufficiale di GPT-6 Astra riporta 57.9% su Terminal-Bench 4.0, 97.6% su FrontierMath Tier 4 e 96.0% su GPQA Diamond.
- Claude Opus 5 è l’alternativa diretta più equilibrata da testare per prima. Anthropic prezza Opus 5 a $5/$25 per milione di token input/output, metà delle tariffe base di Astra.
- Claude Fable 5.1 non è un’alternativa economica. Il suo prezzo di $10/$50 per input/output corrisponde alla tariffa di Astra, mentre alcune valutazioni di conoscenza e ragionamento di lungo orizzonte favoriscono Fable 5.1.
- GPT-5.6 Sol è il downgrade più semplice piuttosto che un vero cambio di piattaforma. La finestra di contesto da 1,05M, l’output massimo da 128K e i prezzi $4/$20 riducono l’attrito di migrazione per le applicazioni OpenAI.
- Gemini 3.8 Flash offre un forte rapporto prezzo/prestazioni in hosting. La sua tariffa introduttiva 2026 è $0.75/$3.75 per milione di token input/output.
- DeepSeek V4 Flash è in una classe di costo diversa. Le sue tariffe ufficiali di punta e fuori picco sono molto inferiori ai prezzi dei modelli premium, ma un costo token più basso non implica tassi di successo agentico equivalenti.
- La metrica di produzione migliore è di solito il costo per task completato accettato. Includi retry, errori degli strumenti, latenza, uso di token di output e rilavorazioni umane.
Che cos’è l’API GPT-6 Astra?
OpenAI posiziona GPT-6 Astra come il suo modello di punta per lavori complessi end-to-end. La specifica API include una finestra di contesto da 1.050.000 token e un output massimo da 128.000 token, input di testo e immagini, supporto ai token di ragionamento e cinque livelli di sforzo di ragionamento: low, medium, high, xhigh e max.
Astra si differenzia da un chatbot convenzionale perché è progettato per esecuzioni di lunga durata. La panoramica ufficiale delle capacità enfatizza uso del computer e lavoro professionale, insieme a ingegneria del software, navigazione, scienza, cybersecurity e ragionamento complesso.
| Specifiche di GPT-6 Astra | Valore |
|---|---|
| ID modello API | gpt-6-astra |
| Provider | OpenAI |
| Finestra di contesto | 1,050,000 token |
| Output massimo | 128,000 token |
| Input | Testo, immagini |
| Output | Testo |
| Data di aggiornamento conoscenze | April 30, 2026 |
| Sforzo di ragionamento | Low, medium, high, xhigh, max |
| Prezzo standard input | $10 / 1M token |
| Input in cache | $1 / 1M token |
| Prezzo standard output | $50 / 1M token |
| Soglia long-context | Oltre 272K token di input |
Nota sui prezzi per long-context:
le richieste sopra i 272K token di input
vengono riprezzate per l’intera richiesta a $20/M input e $75/M output. Consideratele a parte nel budget.
Perché i team guardano oltre GPT-6 Astra
Astra è più convincente quando la sua capacità aggiuntiva elimina tentativi falliti, errori degli strumenti, interventi manuali o chiamate ripetute a modelli più deboli. Il suo prezzo premium è più difficile da giustificare per riassunto, estrazione, classificazione, RAG di routine, chat ordinaria e generazione di codice standard.
I team quindi valutano alternative per ridurre i costi, restare in un ecosistema di provider esistente, migliorare l’economia della cache, aggiungere supporto multimodale, o usare un modello più veloce per traffico di routine riservando Astra all’escalation.
Confronto dei benchmark e limitazioni
Nota sulle evidenze: la tabella usa il framework di confronto pubblicato da OpenAI per mettere diverse alternative sotto un setup comune. Questi punteggi riportati dai vendor possono cambiare con snapshot di modello, prompt, strumenti e metodologia di valutazione; usali per creare una shortlist, poi valida i finalisti su task di produzione rappresentativi.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | 52.6% | 19.1% |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | 73.7% | 73.8% |
| FrontierCode 1.1 Extended | 64.5% | 60.6% | 63.6% | 63.6% | 56.3% |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | 93.7% | 95.3% |
| FrontierMath Tier 4 | 97.6% | 83.0% | 87.8% | 73.2% | — |
| Humanity’s Last Exam, with tools | 57.2% | — | 65.0% | 63.6% | — |
I risultati spiegano perché definire un modello come “sostituto universale di Astra” sia fuorviante. Astra ha un vantaggio chiaro su diverse valutazioni agentiche e scientifiche, mentre Fable 5.1 rende meglio su Humanity’s Last Exam e alcune alternative restano molto vicine su DeepSWE.
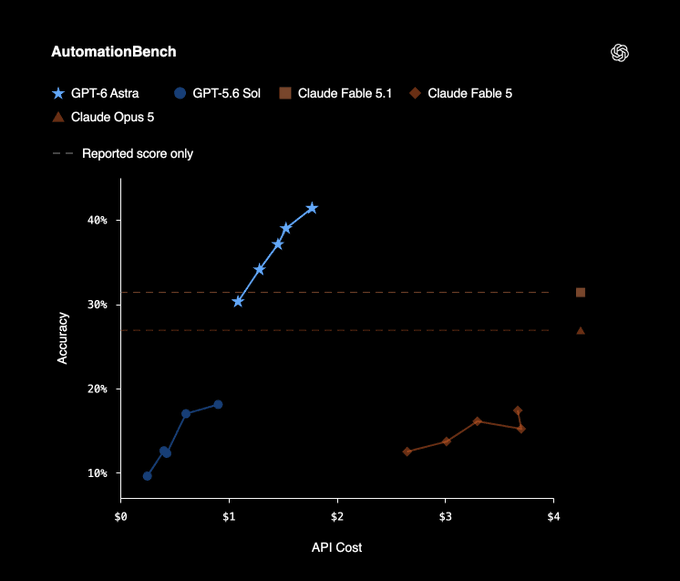
Grafico ufficiale del benchmark OpenAI AutomationBench.
Anche gli indici di benchmark pubblici possono cambiare man mano che metodologia e snapshot dei modelli vengono rivisti. Usali per creare una shortlist, non come sostituto di una valutazione specifica per il carico di lavoro.
Alternative a GPT-6 Astra
Nessun singolo modello sostituisce Astra in ogni carico di lavoro. La scelta più pratica dipende dalla capacità di cui hai bisogno, dall’ecosistema del provider che già usi e dal costo di esecuzioni fallite o ripetute.
| Alternativa | Prezzo ufficiale input/output per 1M token | Contesto | Motivo principale per sceglierlo |
|---|---|---|---|
| Claude Opus 5 | $5 / $25 | 1M | Sostituto premium complessivo più vicino |
| Claude Fable 5.1 | $10 / $50 | 1M | Ragionamento più difficile e agenti lunghi |
| GPT-5.6 Sol | $4 / $20 | 1.05M | Migrazione OpenAI con minor attrito |
| Claude Sonnet 5 | $2 / $10 | 1M | Produzione ad alto volume |
| Gemini 3.8 Flash | $0.75 / $3.75 promozionale | 1M | Multimodale a basso costo e batch |
| DeepSeek V4.1 Flash | $0.22–$0.44 / $0.66–$1.32 | 1M | Costo token più basso e alto volume |
Claude Opus 5
Perché prenderlo in considerazione
Claude Opus 5 è la prima alternativa da testare quando serve prestazione premium in ragionamento, coding o lavoro professionale a un prezzo di listino inferiore rispetto ad Astra.
Prezzo, contesto e cache
Anthropic elenca Claude Opus 5 a $5/M input e $25/M output con una finestra di contesto da 1M token. Conferma i termini di cache attuali prima del budgeting di produzione.
Dove rende meglio
È competitivo su coding, analisi, scrittura professionale e flussi agentici; la tabella di benchmark citata lo colloca vicino ad Astra su DeepSWE e FrontierCode.
Limitazioni
Non supera costantemente Astra. Astra resta il candidato più forte quando l’operatività al computer, l’esecuzione autonoma avanzata, la cybersecurity o gli strumenti nativi OpenAI sono centrali per il prodotto.
Ideale per / Evita quando
Ideale per: agenti di coding premium, analisi complesse e scrittura professionale. Evita quando: il flusso dipende fortemente da strumenti specifici di Astra o dalla capacità di uso del computer.
Claude Fable 5.1
Perché prenderlo in considerazione
Claude Fable 5.1 è un modello di punta concorrente per il ragionamento più difficile, la ricerca, il coding e i compiti agentici di lunga durata, non una sostituzione a basso costo.
Prezzo, contesto e cache
Le tariffe $10/M in input e $50/M in output eguagliano i prezzi di listino di Astra. La finestra di contesto da 1M token e il prezzo di lettura cache a $0.25/M possono migliorare l’economia quando grandi prompt vengono riutilizzati frequentemente.
Dove rende meglio
È particolarmente interessante per ragionamento sostenuto e agenti con uso intensivo della cache; nel confronto citato, supera Astra su Humanity’s Last Exam con strumenti.
Limitazioni
Non riduce la tariffa di listino per token e Astra mantiene vantaggi su diversi benchmark agentici e scientifici, oltre che sugli strumenti nativi OpenAI.
Ideale per / Evita quando
Ideale per: massima qualità di ragionamento e flussi long-context ripetuti. Evita quando: l’obiettivo primario è una forte riduzione delle tariffe standard per token.
GPT-5.6 Sol
Perché prenderlo in considerazione
GPT-5.6 Sol offre la migrazione con minor attrito per applicazioni già costruite attorno a comportamento e strumenti compatibili con OpenAI.
Prezzo, contesto e cache
La specifica citata indica $4/M input e $20/M output, finestra di contesto da 1,05M token e output massimo da 128K. Verifica i termini attuali dell’input in cache prima del budgeting finale.
Dove rende meglio
Resta vicino ad Astra su DeepSWE e GPQA Diamond pur costando significativamente meno nel tier standard a contesto breve.
Limitazioni
Il divario si amplia su compiti rappresentati da Terminal-Bench e FrontierMath, quindi i risparmi possono svanire se i task meno riusciti causano retry o riparazioni manuali.
Ideale per / Evita quando
Ideale per: applicazioni OpenAI esistenti e carichi generali che non richiedono le capacità agentiche più forti di Astra. Evita quando: il carico trae ripetutamente beneficio dai grandi vantaggi di Astra nei benchmark.
Claude Sonnet 5
Perché prenderlo in considerazione
Claude Sonnet 5 è una scelta di produzione pratica per lavoro di conoscenza competente e ripetibile che non richiede un modello di frontiera a ogni richiesta.
Prezzo, contesto e cache
La tariffa permanente citata è $2/M input e $10/M output con finestra di contesto da 1M token. Conferma i termini di cache attuali per distribuzioni con forte riuso di prompt.
Dove rende meglio
Si adatta a classificazione ticket, estrazione documentale, RAG standard, trasformazione di contenuti, spiegazione del codice, function calling di routine e generazione strutturata.
Limitazioni
Non può sostituire affidabilmente Astra in ogni problema di ragionamento a lungo orizzonte o di frontiera.
Ideale per / Evita quando
Ideale per: traffico di produzione ad alto volume e automazione aziendale di routine. Evita quando: il fallimento su un compito agentico difficile costa più del sovrapprezzo del modello di punta.
Gemini 3.8 Flash
Perché prenderlo in considerazione
Gemini 3.8 Flash combina input multimodale, ampio contesto e basso costo API hosted per documenti, media, coding e pipeline batch.
Prezzo, contesto e cache
La tariffa introduttiva citata è $0.75/M input e $3.75/M output fino al 31 dicembre 2026, con finestra di contesto da 1M token e caching scontato durante il periodo promozionale.
Dove rende meglio
È adatto a estrazione multimodale, PDF, audio, video, immagini, grandi collezioni di documenti, analisi batch e workload di coding sensibili al costo.
Limitazioni
La tariffa promozionale è a tempo limitato e i compiti agentici o di uso del computer più difficili richiedono comunque validazione specifica rispetto ad Astra.
Ideale per / Evita quando
Ideale per: multimodale a basso costo e batch ad alto volume. Evita quando: l’applicazione richiede la massima esecuzione autonoma a prescindere dal costo dei token.
DeepSeek V4.1 Flash
Perché prenderlo in considerazione
DeepSeek V4.1 Flash è l’opzione orientata al costo per throughput elevato in ragionamento, coding, riassunto, estrazione, classificazione e processi offline.
Prezzo, contesto e cache
Il prospetto di punta/fuori picco citato elenca input in cache a $0.007–$0.014/M, input senza cache a $0.22–$0.44/M e output a $0.66–$1.32/M, con finestra di contesto da 1M token. Ricontrolla la pagina prezzi V4.1 attuale prima della pubblicazione.
Dove rende meglio
È interessante quando il costo dei token domina e l’applicazione può usare instradamento, validazione o controlli qualità offline per gestire la variabilità.
Limitazioni
Un prezzo token molto più basso non implica un successo agentico equivalente. Affidabilità, comportamento degli strumenti, latenza e tasso di accettazione vanno misurati sul carico target.
Ideale per / Evita quando
Ideale per: elaborazioni su larga scala e sensibili ai costi con validazione. Evita quando: un run autonomo di alto valore fallito supererebbe i risparmi sui token.
GPT-6 Astra vs alternative: quale modello vince in ciascuna categoria?
Mettendo insieme prezzi, architettura, contesto ed evidenze dai benchmark si ottiene una tabella decisionale più utile che non una semplice classifica dal primo al sesto.
| Categoria | Scelta migliore | Perché |
|---|---|---|
| Alternativa complessiva ad Astra | Claude Opus 5 | Prestazioni quasi di frontiera a metà del prezzo di Astra |
| Massimo ragionamento | Claude Fable 5.1 | Ragionamento di punta e forte performance a lungo orizzonte |
| Restare nell’ecosistema OpenAI | GPT-5.6 Sol | Ecosistema API simile con prezzi token inferiori del 60% |
| Produzione ad alto volume | Claude Sonnet 5 | Qualità elevata a $2/$10 |
| Rapporto prezzo/prestazioni nel multimodale | Gemini 3.8 Flash | Contesto da 1M e prezzi introduttivi 2026 molto bassi |
| Costo API più basso | DeepSeek V4.1 Flash | $0.22–$0.44 input e $0.66–$1.32 output |
| Agenti con uso intensivo del computer | GPT-6 Astra | Uno dei differenziatori più chiari di Astra |
| Workflow scientifici e matematici difficili | GPT-6 Astra | Risultati molto forti su FrontierMath e agenti scientifici |
| Agenti lunghi con uso intenso della cache | Claude Fable 5.1 | Letture da cache a $0.25/M |
Il risultato più importante è che GPT-6 Astra vince ancora alcune categorie. Un articolo sulle alternative non dovrebbe implicare che un modello più economico lo sostituisca universalmente. Astra diventa costosa se usata ovunque; può comunque essere economica quando il suo tasso più alto di completamento dei task sostituisce diversi tentativi con modelli più deboli.
Quanto puoi davvero risparmiare sostituendo l’API GPT-6 Astra?
Considera un carico che consuma 1 milione di token di input non in cache e 200.000 token di output. Ignorando sconti di cache, costi degli strumenti, retry, prezzi batch e sovrapprezzi long-context:
| Modello | Costo API approssimativo |
|---|---|
| GPT-6 Astra | $20.00 |
| Claude Fable 5.1 | $20.00 |
| Claude Opus 5 | $10.00 |
| GPT-5.6 Sol | $8.00 |
| Claude Sonnet 5 | $4.00 |
| Tariffa promozionale Gemini 3.8 | $1.50 |
| DeepSeek V4.1 Flash off-peak | $0.35 |
Il calcolo di base è:
total_cost =
(input_tokens / 1,000,000 * input_rate)
+
(output_tokens / 1,000,000 * output_rate)
Questo semplice esempio mostra anche perché il prezzo per token non può essere l’unica metrica. Se una richiesta da $20 con Astra riesce al primo colpo mentre un modello da $4 richiede sei tentativi, molteplici retry degli strumenti e riparazione umana, Astra è stata in realtà più economica.
Una metrica di produzione migliore è:
cost_per_accepted_task =
total_model_and_tool_cost
/
number_of_tasks_accepted_without_rework
Tieni traccia di quel numero insieme a latenza, successo dei task, tasso di retry, errori di chiamata agli strumenti e tasso di escalation a un umano.
Come testare le alternative a GPT-6 Astra tramite CometAPI?
Un vantaggio pratico di un livello API multi-modello è che la valutazione non deve trasformarsi in un progetto di integrazione con il provider. CometAPI fornisce GPT-6 Astra API, GPT-5.6, Claude Fable 5.1, Claude Sonnet 5, Gemini 3.8 Flash e DeepSeek V4.1 Flash tramite un unico catalogo di modelli.
Con un client compatibile con OpenAI, il modello può essere reso configurabile invece che hard-coded:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

model = "claude-fable-5-1"

response = client.chat.completions.create(
    model=model,
    messages=[
        {
            "role": "user",
            "content": "Review this migration plan and identify the three highest-risk assumptions.",
        }
    ],
)

print(response.choices[0].message.content)
Puoi rieseguire lo stesso set di valutazione usando ID modello come:
gpt-6-astra
gpt-5.6
claude-fable-5-1
claude-sonnet-5
gemini-3.8-flash
deepseek-v4-flash
Questo è in genere più informativo che scegliere un’alternativa solo da una classifica di benchmark. Prendi 100–500 prompt rappresentativi di produzione e registra successo del task, accettazione umana, retry, errori degli strumenti, token totali, latenza e costo API totale.
Dovresti sostituire GPT-6 Astra con un solo modello o usare il model routing?
Per molte applicazioni, sostituire Astra con un unico modello universale è l’ottimizzazione sbagliata. Un’architettura più efficiente è questa:
- Traffico di routine → Claude Sonnet 5, Gemini 3.8 Flash o DeepSeek V4.1 Flash
- Ragionamento difficile → Claude Opus 5 o GPT-5.6 Sol
- Compiti molto difficili e a lungo orizzonte → Claude Fable 5.1 o GPT-6 Astra
- Uso del computer o workflow agentici specifici di Astra → GPT-6 Astra
Questo trasforma Astra in un modello di escalation anziché il modello predefinito. Se solo il 10% delle richieste richiede davvero prestazioni da modello di frontiera per agenti, instradare il 100% del traffico tramite Astra significa pagare il suo premium anche per l’altro 90%.
Quale alternativa all’API GPT-6 Astra dovresti scegliere?
Scegli Claude Opus 5 se vuoi il miglior equilibrio complessivo tra qualità e prezzo.
Scegli Claude Fable 5.1 se il massimo ragionamento conta più della riduzione delle tariffe di listino.
Scegli GPT-5.6 Sol se già usi OpenAI e vuoi il minor cambiamento d’integrazione.
Scegli Claude Sonnet 5 se la maggior parte del tuo traffico di produzione è lavoro di conoscenza competente ma ordinario.
Scegli Gemini 3.8 Flash se multimodalità, scala e basso costo API hosted sono importanti.
Scegli DeepSeek V4.1 Flash se il costo dei token è il vincolo dominante e il tuo carico può tollerare più valutazione e validazione.
E scegli GPT-6 Astra stesso quando la tua applicazione trae davvero beneficio da uso del computer più forte, lavori software autonomi difficili, ragionamento scientifico o altre capacità agentiche.
L’errore principale non è scegliere il “modello di frontiera sbagliato”. È pagare i prezzi di un modello di frontiera per richieste che non ne avevano bisogno.
FAQ
Qual è la migliore alternativa complessiva all’API GPT-6 Astra?
Claude Opus 5 è uno dei sostituti generali più forti. Offre una finestra di contesto da 1M, solide capacità di coding e agent e prezzi di listino $5/$25—metà delle tariffe standard di Astra.
Qual è l’alternativa a GPT-6 Astra più economica?
Tra i modelli trattati qui, DeepSeek V4.1 Flash ha i prezzi per token più bassi di prima parte. La sua tariffa off-peak attuale è $0.22/M input non in cache e $0.66/M output. Non si dovrebbe però assumere che eguagli il successo dei compiti autonomi di Astra solo perché è più economico.
Claude Fable 5.1 è migliore di GPT-6 Astra?
Nessuno dei due vince ogni carico di lavoro. Il confronto di OpenAI assegna ad Astra vantaggi significativi su FrontierMath Tier 4 e Terminal-Bench 4.0, mentre Fable 5.1 ottiene punteggi più alti su Humanity’s Last Exam con strumenti.
Vale ancora la pena usare GPT-5.6 Sol dopo GPT-6 Astra?
Sì. I suoi prezzi API standard $4/$20 sono sostanzialmente inferiori a quelli di Astra $10/$50 mentre mantiene una finestra di contesto da 1,05M. Può quindi essere un default migliore per carichi in cui i guadagni di Astra non migliorano materialmente il completamento dei task.
Gemini 3.8 Flash è abbastanza valido da sostituire GPT-6 Astra?
Per alcuni carichi di coding, multimodali, documentali e di elaborazione batch, sì. È drasticamente più economico e ha una finestra di contesto da 1M. Per i compiti agentici e di uso del computer più difficili, Astra resta la scelta più forte.
GPT-6 Astra ha uno svantaggio di prezzo per prompt molto lunghi?
Sì. OpenAI applica una fascia di prezzo più alta quando l’input supera 272K token, quindi le richieste long-context vanno pianificate a parte.
Dovrei confrontare i modelli in base al prezzo per token o ai punteggi di benchmark?
Usa entrambi solo come metriche di screening. La metrica di produzione che conta di più è di solito il costo per task completato accettato, includendo token di ragionamento, retry, chiamate agli strumenti, latenza e rilavorazioni umane.
Posso usare diverse alternative a GPT-6 Astra nella stessa applicazione?
Sì. In molte applicazioni, l’instradamento dei modelli è preferibile a impegnare ogni richiesta in un solo modello. Un modello a basso costo può gestire le richieste di routine mentre modelli più forti gestiscono le escalation sempre più difficili.