

TL;DR: Qual è il provider più economico?
Per richieste interattive normali a GPT-6 Astra, la GPT-6 Astra API in CometAPI ha la tariffa Standard a contesto breve più bassa chiaramente pubblicata in questo confronto: $8 per milione di token di input e $40 per milione di token di output. OpenAI Standard è $10/$50.
Per lavori tolleranti ai ritardi, l’economia cambia: OpenAI prezza Batch e Flex al 50% dello Standard, che equivale a $5/M input e $25/M output per richieste Astra a contesto breve. OpenRouter espone anche una route Batch a $5/$25. Queste route sono più economiche dell’inferenza interattiva Standard, ma non sono sostituti diretti per applicazioni sensibili alla latenza.
Per test prima di pagare, CometAPI afferma che i nuovi account ricevono crediti di registrazione gratuiti senza richiesta di carta di credito. Azure offre ai nuovi clienti idonei $200 di credito per 30 giorni, mentre AWS offre ai nuovi clienti fino a $200 in crediti nel suo programma Free Tier. L’idoneità ai crediti e l’accesso al modello dovrebbero essere verificati nell’account prima di presumere che l’uso di Astra sia coperto.
Nota sull’idoneità: i crediti promozionali e l’accesso a GPT-6 Astra variano per account, regione e programma. Verificare sia l’idoneità ai crediti sia l’accesso al modello prima di stimare una prova gratuita.
Punti chiave
- Tariffa interattiva più economica verificata qui: CometAPI Standard a $8/M input e $40/M output, il 20% in meno rispetto a OpenAI Standard.
- Route tollerante ai ritardi più economica: OpenAI Batch/Flex o OpenRouter Batch a $5/M input e $25/M output.
- OpenAI non ha un livello Free API per Astra; la tabella ufficiale dei rate limit indica che Free non è supportato.
- CometAPI è la prova più a basso attrito in questo confronto perché offre crediti di registrazione senza carta di credito; l’importo attuale del credito non è hard-coded intenzionalmente.
- Il confine dei 272K di input conta: oltre tale soglia, Astra passa alla tariffazione a contesto lungo per l’intera richiesta.
- Non confrontare solo i prezzi per token. Cache, strumenti, retry, latenza, crescita del contesto e successo dei task accettati possono dominare il costo totale.
Che cos’è GPT-6 Astra e perché la sua API ha un prezzo premium?
GPT-6 Astra è il modello di punta di OpenAI per lavori end-to-end difficili, piuttosto che per chat a basso costo e alto volume. OpenAI lo posiziona per ragionamento complesso, ingegneria del software, ricerca, uso del computer, flussi di lavoro professionali e agenti di lunga durata.
La specifica ufficiale del modello fornisce ad Astra una finestra di contesto da 1.050.000 token, un output massimo di 128.000 token, una data di aggiornamento della conoscenza al 30 aprile 2026, input di testo e immagini e output di testo. Supporta cinque impostazioni di livello di ragionamento: low, medium, high, xhigh e max.
| Specifica di GPT-6 Astra | Valore |
|---|---|
| Sviluppatore | OpenAI |
| ID modello | gpt-6-astra |
| Finestra di contesto | 1.050.000 token |
| Output massimo | 128.000 token |
| Data di aggiornamento | 30 aprile 2026 |
| Input | Testo, immagini |
| Output | Testo |
| Reasoning effort | Low, Medium, High, XHigh, Max |
| Function calling | Supportato |
| Structured outputs | Supportati |
| Uso del computer | Supportato |
| Ricerca web/file | Supportata |
| Fine-tuning | Non supportato |
| Prezzo Standard contesto breve | $10/M input; $50/M output |
| Input in cache | $1/M |
| Scrittura in cache | $12,50/M |
| Soglia contesto lungo | Oltre 272K token di input |
Il limite di contesto è anche un confine di prezzo. Per prompt oltre 272K token di input, OpenAI applica 2× per input/cache e 1,5× per output all’intera richiesta. Una richiesta che supera anche di poco i 272K può quindi aumentare materialmente nel costo totale.
Astra introduce anche funzionalità orientate agli agenti come chiamate asincrone agli strumenti e orientamento a metà turno. Ecco perché un confronto utile tra provider deve considerare strumenti, caching, livello di elaborazione e completamento dei task—non solo il prezzo di input in evidenza.
Quanto è valido GPT-6 Astra? Prestazioni ufficiali sui benchmark
La tabella dei benchmark ufficiali registra risultati solidi su uso del computer, automazione professionale, contesto lungo, scienza, coding e cybersecurity. Riporta 97,6% su FrontierMath Tier 4 (v2), 99,9% su ARC-AGI-3 e 100% su ExploitBench. Si tratta di risultati di valutazione pubblicati dal vendor e vanno interpretati secondo la metodologia dichiarata.
| Benchmark | GPT-6 Astra | Confronto / significato |
|---|---|---|
| FrontierMath Tier 4 (v2) | 97,6% | Matematica a livello di ricerca |
| ARC-AGI-3 | 99,9% | Ragionamento/Adattamento inedito |
| ExploitBench | 100,0% | Capacità di exploit in cybersecurity |
| OSWorld 2.0 | 72,6% | Compiti di uso del computer |
| ScreenSpot-Pro | 92,7% | Grounding dell’interfaccia visiva |
| AutomationBench | 41,4% | Automazione di flussi professionali |
| BenchCAD | 95,9% | Compiti CAD/di progettazione |
| BrowseComp | 91,5% | Recupero informazioni via browser |
| MRCR v2, 512K–1M | 96,3% | Retrieval su contesti molto lunghi |
| Terminal-Bench Science 0.1 | 64,6% | Flussi scientifici agentici |
Per la valutazione dei costi, i risultati OSWorld 2.0 di OpenAI riportano 72,6% a circa 40 minuti per task per Astra, contro 65,7% a circa 75 minuti per GPT-5.6 Sol. Questo sostiene la valutazione del costo per task completato piuttosto che trattare il prezzo per token come l’intero modello di costo.
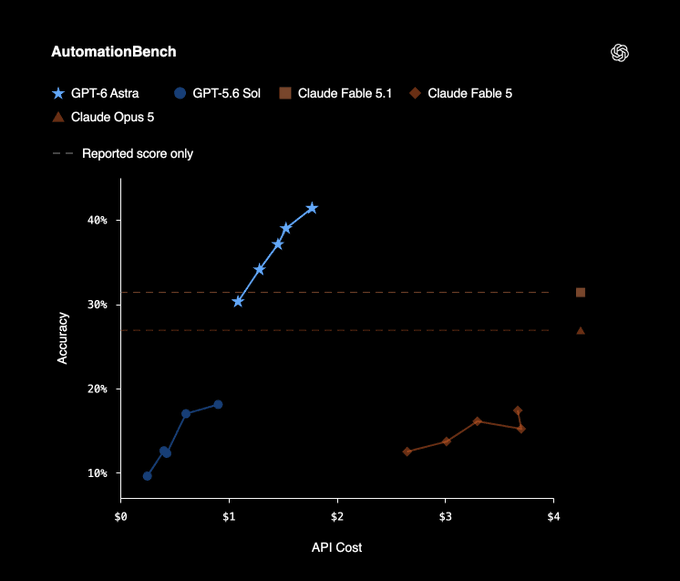
Grafico ufficiale del benchmark AutomationBench di OpenAI.
Qual è il provider GPT-6 Astra API più economico nel 2026?
La tabella seguente confronta i prezzi per token pubblicamente verificabili per lo stesso modello GPT-6 Astra. Esclude preventivi insolitamente economici da relay quando la provenienza del modello, i limiti di contesto, la privacy o il comportamento del servizio non possono essere verificati in modo indipendente. Il listino live dei modelli di CometAPI mostra $8/M input e $40/M output per l’accesso Standard a contesto breve.
| Provider / route | Input / 1M | Output / 1M | Prova / crediti | Miglior utilizzo |
|---|---|---|---|---|
| CometAPI Standard | $8 | $40 | Crediti di registrazione | Tariffa interattiva più bassa qui |
| OpenAI Standard | $10 | $50 | Nessun livello Free per Astra | Accesso nativo di prima parte |
| OpenAI Batch / Flex | $5 | $25 | Stesso account API | Tariffa di prima parte più bassa per job tolleranti ai ritardi |
| OpenRouter Standard | $10 | $50 | Nessuna prova specifica Astra verificata | Instradamento multi-provider |
| OpenRouter Batch | $5 | $25 | Nessuna prova specifica Astra verificata | Instradamento asincrono a basso costo |
| Azure Global | $10 | $50 | $200 / 30 giorni per nuovi idonei | Workload su cloud Microsoft |
| Azure US Data Zone | $11 | $55 | Crediti Azure soggetti a idoneità | Requisiti di data zone |
| AWS Global CRIS | $10 | $50 | Fino a $200 in crediti AWS generali | Workload nativi AWS |
| AWS In-Region | $11 | $55 | Crediti AWS soggetti a idoneità | Deployment regionale |
La tabella pubblicata di Azure per Astra conferma $10/$50 per Standard Global e $11/$55 per US Data Zone. I dettagli di prezzo di Microsoft Foundry mostrano anche le relative fasce per contesto lungo. AWS pubblica $10/$50 per Global CRIS e $11/$55 per In-Region/Geo CRIS. La documentazione prezzi di Amazon Bedrock afferma che queste sono tariffe di livello Standard.
Ci sono quindi due risposte diverse su “il più economico”. Per l’inferenza Standard interattiva, CometAPI è il leader di prezzo in questo set verificato. Per workload asincroni o flessibili, Batch/Flex a $5/$25 ha la tariffa per token più bassa.
Nota sui prezzi: tariffe dei provider e crediti promozionali possono cambiare. Ricontrollare la documentazione collegata subito prima della pubblicazione o della pianificazione di budget di produzione.
Quanto è più economica l’API GPT-6 Astra in CometAPI?
| Categoria di token | OpenAI Standard | CometAPI | Differenza |
|---|---|---|---|
| Input | $10,00/M | $8,00/M | -20% |
| Input in cache | $1,00/M | $0,80/M | -20% |
| Scrittura in cache | $12,50/M | $10,00/M | -20% |
| Output | $50,00/M | $40,00/M | -20% |
| Input contesto lungo | $20,00/M | $16,00/M | -20% |
| Output contesto lungo | $75,00/M | $60,00/M | -20% |
L’implicazione pratica è semplice: se la tua applicazione necessita di inferenza interattiva in stile Standard anziché Batch/Flex, le tariffe Astra pubblicate da CometAPI riducono del 20% la componente “per token” nelle categorie corrispondenti.
Quale provider GPT-6 Astra offre la migliore prova gratuita?
“Free GPT-6 Astra API” può significare o un livello gratuito permanente del modello o crediti promozionali temporanei. Non sono la stessa cosa. La tabella ufficiale dei rate limit di OpenAI segna il livello Free API come non supportato per Astra.
CometAPI: il percorso di prova più semplice senza carta
La guida rapida di CometAPI afferma che i nuovi account ricevono crediti di registrazione gratuiti e che non è richiesta la carta di credito per iniziare. Poiché l’importo promozionale può cambiare, la schermata live di registrazione o prezzi dovrebbe essere la fonte autorevole invece di hard-codificare una cifra.
Azure: la prova cloud a valore fisso più chiara
I nuovi clienti idonei di Azure possono ricevere $200 di credito Azure per 30 giorni. Se GPT-6 Astra è abilitato per l’account e la regione, quel credito può rendere Azure utile per test di proof-of-concept prima della fatturazione normale.
AWS: una finestra di credito generale più lunga
AWS offre ai nuovi clienti $100 in crediti alla registrazione e opportunità di guadagnarne altri $100—fino a $200 in sei mesi. Poiché il piano Free di AWS non espone ogni servizio e funzionalità, verificare l’idoneità del piano account e l’accesso al modello in Bedrock prima di considerare il credito come una prova garantita di Astra.
Quando è più economico OpenAI Batch per GPT-6 Astra?
L’errore di costo più grande è confrontare solo i provider ignorando il livello di elaborazione. OpenAI afferma che Batch e Flex costano il 50% di Standard, mentre la modalità Fast costa 2× la tariffa applicabile. Per richieste Astra a contesto breve, l’intervallo è quindi $5/$25 su Batch/Flex, $10/$50 su Standard e $20/$100 su Fast.
| Opzione di elaborazione | Input / 1M | Output / 1M | Rispetto a OpenAI Standard |
|---|---|---|---|
| Batch | $5 | $25 | 50% |
| Flex | $5 | $25 | 50% |
| CometAPI Standard | $8 | $40 | 80% di OpenAI Standard |
| OpenAI Standard | $10 | $50 | 100% |
| OpenAI Fast | $20 | $100 | 200% |
Batch/Flex andrebbe valutato prima per analisi notturne, revisione di codice offline, arricchimento dataset, run di valutazione e ricerca non urgente. Per applicazioni in cui l’utente sta aspettando attivamente, il confronto Standard resta più pertinente.
Quanto ti costerà davvero GPT-6 Astra?
Considera una richiesta agent a contesto breve che utilizza 100.000 token di input e 10.000 token di output. Ignorando cache e costi degli strumenti, il costo semplificato è token di input × tariffa input + token di output × tariffa output.
| Provider / route | Costo per richiesta | Costo per 1.000 richieste equivalenti |
|---|---|---|
| OpenAI Batch/Flex | $0,75 | $750 |
| CometAPI Standard | $1,20 | $1.200 |
| OpenAI Standard | $1,50 | $1.500 |
| OpenRouter Standard | $1,50 | $1.500 |
| Azure Global | $1,50 | $1.500 |
| AWS Global CRIS | $1,50 | $1.500 |
| AWS In-Region | $1,65 | $1.650 |
La differenza di $0,30 tra CometAPI Standard e OpenAI Standard sembra piccola su una richiesta. A 10.000 richieste equivalenti, diventa circa $3.000 prima dei costi degli strumenti o dei retry.
Il contesto lungo cambia di nuovo la matematica. A 300K input e 20K output, OpenAI Standard è circa $7,50 alla tariffa pubblicata per contesto lungo, mentre le tariffe corrispondenti di CometAPI portano a circa $6,00. Per questo la soglia dei 272K dovrebbe essere monitorata esplicitamente nella telemetria di produzione.
Come ridurre i costi dell’API GPT-6 Astra senza cambiare provider?
La cache dei prompt è una leva importante perché la tariffa Standard di Astra per l’input memorizzato in cache è un decimo dell’input “fresco”. Istruzioni di sistema stabili, definizioni degli strumenti, materiale di riferimento riutilizzabile e prefissi di prompt comuni sono candidati solidi per una progettazione “cache-aware”.
Il controllo del contesto è la seconda leva. Una finestra da 1,05M token è un tetto di capacità, non un obiettivo. Restare sotto la soglia di prezzo dei 272K quando la cronologia extra non è necessaria può avere un effetto maggiore di una compressione minima del prompt.
Il livello di elaborazione è la terza leva: Batch/Flex per lavoro tollerante ai ritardi, Standard per produzione interattiva ordinaria e Fast solo dove la latenza più bassa ha un valore di business misurabile. Infine, misurare il costo per task accettato—non solo il costo per token—perché retry, chiamate agli strumenti e correzioni umane possono ribaltare un semplice confronto di tariffario.
Quale provider GPT-6 Astra dovresti scegliere?
| La tua priorità | Miglior opzione iniziale | Motivo |
|---|---|---|
| Prezzo per token interattivo più basso | CometAPI | Tariffa Standard a contesto breve $8/$40 |
| Prezzo per token più basso tollerante ai ritardi | OpenAI Batch/Flex o OpenRouter Batch | $5/$25 |
| Prova senza carta | CometAPI | Crediti di registrazione; nessuna carta |
| Prova cloud fissa a breve termine | Azure | $200 per 30 giorni per nuovi idonei |
| Finestra crediti cloud più lunga | AWS | Fino a $200; verificare idoneità Astra/Bedrock |
| Accesso nativo di prima parte OpenAI | OpenAI | API diretta e capacità native più recenti |
| Architettura cloud Microsoft esistente | Azure Foundry | Governance e procurement Microsoft |
| Architettura AWS esistente | Amazon Bedrock | Sicurezza, fatturazione e controlli regionali AWS |
| Instradamento multi-provider | OpenRouter | Un livello di routing tra provider |
Per uno sviluppatore indipendente o un team sensibile ai costi che necessita di inferenza Astra interattiva, CometAPI è il punto di partenza più forte orientato al prezzo in questo confronto. Per grandi job offline, Batch/Flex andrebbe valutato prima di cambiare provider perché il suo sconto di livello di elaborazione del 50% è maggiore della differenza del 20% sulla tariffa Standard.
Per i team enterprise, la tariffa per token più bassa potrebbe non produrre il costo totale più basso. Azure o AWS possono comunque essere la scelta economicamente migliore quando un team dipende già da spesa cloud impegnata, networking privato, procurement centralizzato o controlli integrati di sicurezza e conformità. Valutare questi risparmi operativi separatamente dal prezzo per token del modello.
Come chiamare l’API GPT-6 Astra tramite CometAPI?
CometAPI utilizza un pattern di integrazione compatibile con OpenAI. Crea una chiave API CometAPI, punta l’SDK OpenAI alla base URL di CometAPI e chiama il modello gpt-6-astra. La documentazione del modello Astra di CometAPI pubblica sia gli endpoint Chat Completions sia Responses.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.responses.create(
    model="gpt-6-astra",
    reasoning={"effort": "medium"},
    input="Analyze this software architecture and identify the three highest-risk bottlenecks.",
)

print(response.output_text)
Per nuovi agent pesantemente basati sugli strumenti, la Responses API è l’interfaccia più importante perché le capacità agentiche di Astra sono progettate attorno a quel workflow.
Un relay GPT-6 Astra ultra-economico è davvero più economico?
Gli aggregatori di prezzi talvolta mostrano relay che quotano Astra molto al di sotto delle tariffe mainstream. Queste offerte non dovrebbero essere automaticamente trattate come equivalenti. Confermare la provenienza del modello, il pieno supporto del contesto, il comportamento degli strumenti, i termini di privacy, la policy di logging, la disponibilità, i limiti di frequenza e come il provider sostenga un prezzo al di sotto dell’economia upstream normale.
Nota sui rischi dei relay: per agent di produzione, codice sorgente, documenti aziendali, dati dei clienti o workload sensibili alla sicurezza, la provenienza del modello e la gestione dei dati fanno parte del prezzo effettivo. Verificare supporto del contesto, comportamento degli strumenti, termini di privacy, logging, disponibilità e limiti di frequenza prima di usare un relay a basso costo.
FAQ API GPT-6 Astra: prezzi, prove gratuite e provider
Qual è il provider GPT-6 Astra API più economico?
Per l’inferenza interattiva Standard tra i provider verificati qui, CometAPI è il più economico a $8/M input e $40/M output. Per workload tolleranti ai ritardi, OpenAI Batch/Flex e OpenRouter Batch sono più economici a $5/$25.
Esiste una GPT-6 Astra API gratuita?
Non esiste un livello Free API permanente di OpenAI per Astra. Crediti promozionali da CometAPI, Azure o AWS possono ridurre o coprire temporaneamente i costi di test, soggetti alle regole di idoneità di ciascun programma e all’accesso al modello.
CometAPI offre una prova gratuita di GPT-6 Astra?
CometAPI afferma che i nuovi account ricevono crediti di registrazione gratuiti e che non è richiesta la carta di credito per iniziare. Poiché le promozioni cambiano, verificare l’importo corrente del credito in fase di registrazione.
Quanto costa GPT-6 Astra tramite OpenAI?
La tariffa Standard a contesto breve di OpenAI è $10/M input, $1/M input in cache, $12,50/M scrittura in cache e $50/M output. Sopra 272K token di input, le tariffe Standard diventano $20/M input, $2/M input in cache, $25/M scrittura in cache e $75/M output per l’intera richiesta.
Perché Batch di GPT-6 Astra può essere più economico di CometAPI?
Batch/Flex è un livello di elaborazione diverso, non semplicemente un provider differente. OpenAI lo prezza alla metà di Standard, ovvero $5/M input e $25/M output per richieste Astra a contesto breve. La tariffa $8/$40 di CometAPI è una tariffa interattiva in stile Standard.
Azure è più economico di OpenAI per GPT-6 Astra?
Azure Standard Global è allineato a OpenAI Standard a $10/M input e $50/M output. Azure può comunque essere economicamente interessante grazie a credito per nuovi account, accordi enterprise, governance Microsoft ed esistente spesa impegnata.
AWS Bedrock è più economico di OpenAI per GPT-6 Astra?
AWS Global CRIS è $10/$50, mentre In-Region e Geo CRIS sono $11/$55 per contesto breve. AWS può comunque essere preferibile per team che valorizzano fatturazione cloud esistente, controlli regionali e integrazione infrastrutturale.
OpenRouter è più economico per GPT-6 Astra?
OpenRouter Standard è $10/$50, quindi non batte OpenAI sulla tariffa Standard per token. La sua route Batch è $5/$25; il suo vantaggio più ampio è l’instradamento multi-provider.
Qual è il maggiore costo nascosto dell’API GPT-6 Astra?
La soglia dei 272K di input è uno dei confini di costo nascosti più importanti. Chiamate agli strumenti, ricerca web/file, retry, cache miss e traiettorie di agent inutilmente lunghe possono anche aumentare materialmente il costo totale del task.
Dovrei scegliere un provider solo in base al prezzo per token?
No. Confronta costo per task riuscito, latenza, disponibilità, supporto del contesto, compatibilità degli strumenti, comportamento della cache, policy sui dati, limiti dell’account e rate limit. Il token più economico è utile solo se la route consegna in modo affidabile il workload di cui hai bisogno.
SEO Metadata
Meta title: Provider API GPT-6 Astra più economici: prova gratuita e opzioni budget
Meta description: Confronta i provider API GPT-6 Astra più economici nel 2026, inclusi CometAPI, OpenAI, OpenRouter, Azure, AWS Bedrock, crediti di prova, prezzi Batch e esempi reali di costo per token.
Keywords: prezzo API GPT-6 Astra, API GPT-6 Astra più economica, prova gratuita GPT-6 Astra, provider API GPT-6 Astra, CometAPI GPT-6 Astra, prezzi OpenAI Astra, API Batch GPT-6 Astra, Azure GPT-6 Astra, AWS Bedrock GPT-6 Astra, OpenRouter GPT-6 Astra
URL slug: cheapest-gpt-6-astra-api-providers-free-trial-budget-options