Crea con CometAPITi serve una sola API per più modelli?Testa il flusso di lavoro in Playground, poi crea una chiave API quando modello e costo sono adatti al tuo caso d'uso.
Eleven v4 vs Eleven v4 Turbo: Quale dovresti scegliere?
Confronta Eleven v4 e v4 Turbo in termini di qualità della voce, latenza, prezzi dell’API, streaming e accesso a CometAPI. Scegli il modello giusto per i contenuti o per gli agenti.
Scegli Eleven v4 per audiolibri, narrazione e interpretazioni di personaggi quando la qualità di produzione è prioritaria. Scegli Eleven v4 Turbo per agenti vocali e applicazioni interattive quando conta il tempo di risposta. ElevenLabs afferma che entrambi condividono lo stesso range espressivo; la tariffa per carattere pubblicata di Turbo è inferiore del 50%. Prendi la decisione finale usando i tuoi script, test d’ascolto e misurazioni della latenza end-to-end.
Key Takeaways
Per audio prodotto: inizia dalla variante standard e valuta resa, coerenza e sforzo di editing.
Per l’interazione live: inizia da Turbo e misura il tempo completo dall’input utente alla risposta udibile.
Per il costo: la tariffa per carattere pubblicata di Turbo è inferiore del 50%, prima di considerare retry o altri servizi.
Per i benchmark: i risultati di preferenza pubblicati confrontano il modello standard con sistemi concorrenti; non stabiliscono un margine di qualità diretto rispetto a Turbo.
Revisionato per chiarezza, attribuzione delle fonti e terminologia API aggiornata.
Per l’integrazione: lo streaming nativo e la generazione asincrona di terze parti hanno requisiti operativi diversi.
Eleven v4 vs v4 Turbo a colpo d’occhio
Dimensione — specifiche native; prezzo nativo
Eleven v4
Eleven v4 Turbo
Carico di lavoro primario
Narrazione prodotta, audiolibri e interpretazioni di personaggi
Agenti in tempo reale e parlato interattivo
Model ID
eleven_v4
eleven_v4_turbo
Lingue
90+
90+
Prezzo nativo
$0.08 / 1,000 characters
$0.04 / 1,000 characters
Latenza di inferenza mediana
Nessun valore direttamente comparabile identificato
~100 ms
Tempo mediano al primo audio
Nessun valore comparabile identificato
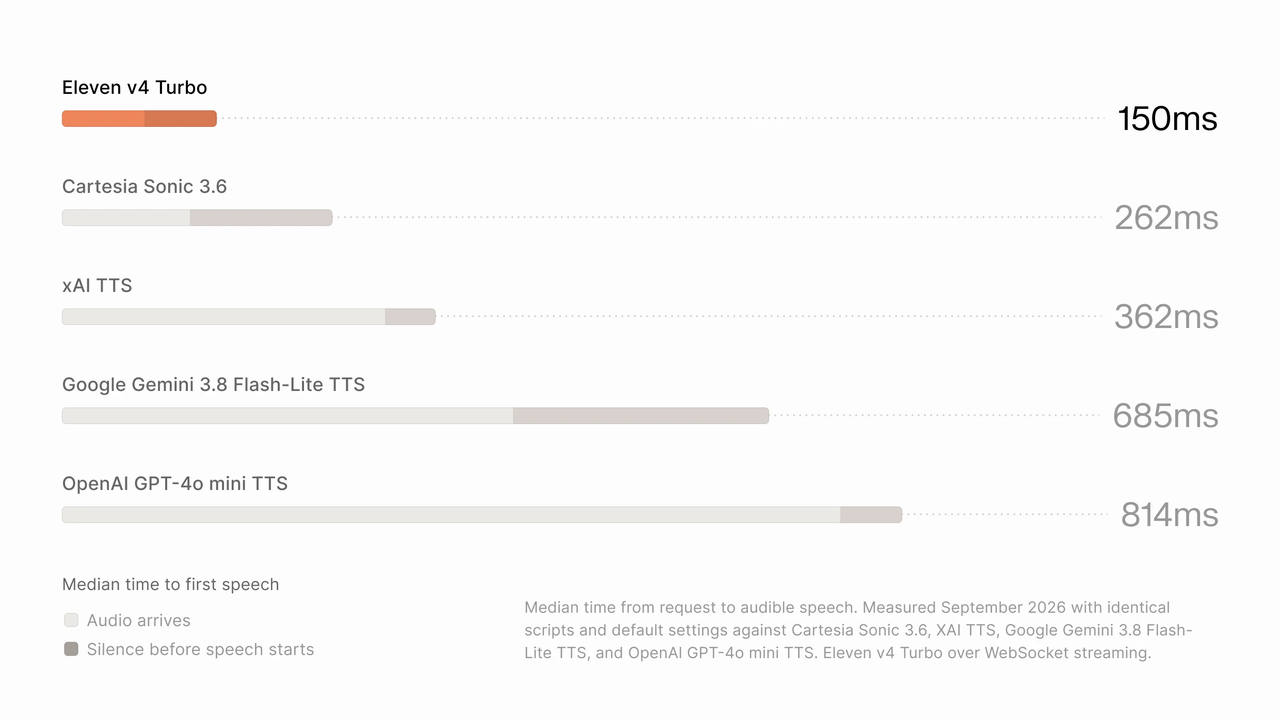
~150 ms tempo mediano dalla richiesta all’audio udibile via WebSocket; latenza di rete misurata esclusa
Voci registrate per connessione WebSocket Text to Dialogue
Fino a 10
Esattamente 1
La cifra di 150 ms proviene dal confronto di settembre 2026 di ElevenLabs usando script identici e impostazioni predefinite. Misura l’inizio dell’audio udibile, non il ritardo completo di una conversazione con un agente vocale. I limiti di registrazione voce si applicano all’endpoint Text to Dialogue WebSocket.
Eleven v4 vs v4 Tu
Eleven v4 vs v4 Turbo: Panoramica e specifiche
Eleven v4: audio prodotto e performance multi-speaker
Il posizionamento pubblicato del modello standard è la produzione vocale di massima qualità, inclusi dialoghi naturali multi-speaker e narrazione long-form. Questo lo rende il primo candidato sensato quando una registrazione può essere rivista ed editata prima della pubblicazione. La domanda rilevante è se la sua resa resta convincente su passaggi completi e rigenerazioni di battute.
Eleven v4 Turbo: parlato espressivo in tempo reale
Eleven v4 Turbo è progettato per agenti in tempo reale, assistenti e personaggi interattivi. ElevenLabs afferma che mantiene il pieno range espressivo di Eleven v4 e supporta Professional Voice Clones, dando priorità alla generazione a bassa latenza.
Valutalo mentre l’audio viene trasmesso e riprodotto, perché una clip isolata convincente non dimostra che l’intera conversazione risponde con prontezza. La sua bassa latenza di inferenza è una specifica di partenza, non una garanzia per un’applicazione completa.
Un breve voiceover istruttivo può risultare ugualmente accettabile su entrambi, mentre una scena drammatica può rivelare differenze che giustificano una generazione più costosa.
Architettura e ambito di valutazione
L’annuncio ufficiale dell’architettura descrive Eleven v4 come basato su un’architettura completamente nuova e afferma che Turbo porta la stessa tecnologia ai casi d’uso a bassa latenza. Non divulga dettagli sufficienti per confrontare il numero di parametri, la struttura dei layer, il compute di training o i cambiamenti specifici responsabili della differenza di velocità. Considera tali dettagli come non divulgati, senza dedurre che Turbo sia più piccolo o distillato.
Limiti nativi e controlli della voce
Verifica il limite di input per il modello e l’endpoint che intendi usare prima di suddividere uno script lungo. Un limite pubblicato per un’interfaccia non si applica automaticamente a un’altra e un limite omesso non significa input illimitato.
Entrambe le varianti offrono controlli Stability e Similarity. Quando selezioni un Professional Voice Clone con Eleven v4, un ulteriore Clone Strength slider regola quanto strettamente l’output segue le registrazioni di training del clone. Valori più bassi consentono una resa più flessibile con una leggera levigatura della voce; valori più alti preservano più dell’interpretazione originale e dei tratti vocali distintivi, inclusi gli accenti. ElevenLabs consiglia di partire da 0% per la maggior parte delle voci. Gli slider Style e Speed non sono disponibili nell’esperienza nativa v4 e SSML non è supportato.
L’implicazione pratica per la migrazione è semplice: preserva il significato delle tue istruzioni vocali esistenti, ma rivedi come sono espresse. Uno script in precedenza fortemente basato su SSML va adattato e provato in ascolto, non copiato invariato.
Eleven v4 vs v4 Turbo: Prestazioni
Benchmark pubblicati e confini delle fonti
Due risultati ufficiali contano qui: preferenza d’ascolto e latenza di risposta. Rispondono a domande diverse.
Prove pubblicate — metodologia ufficiale di benchmark
Risultato riportato
Cosa stabilisce
Test di preferenza in cieco del modello standard
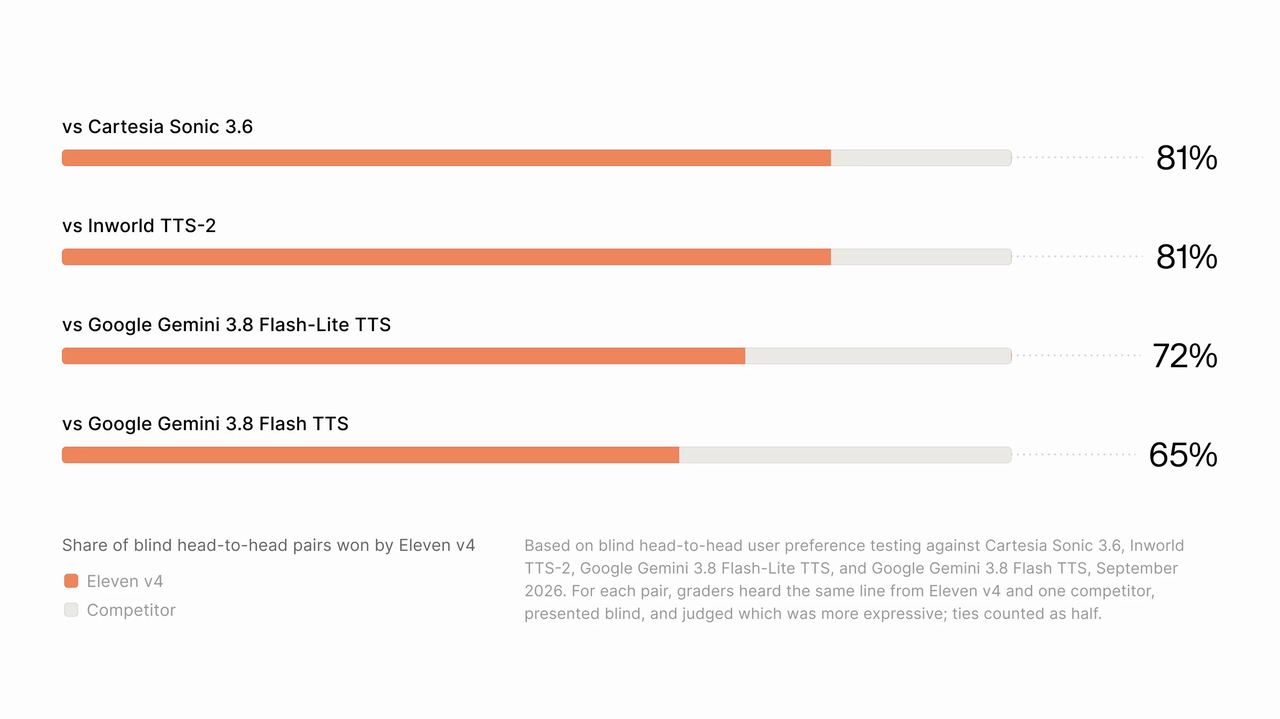
Preferenza complessiva ~75%; i risultati del grafico variano tra 65%–81%
Preferenza degli ascoltatori rispetto ai modelli concorrenti
Latenza di inferenza mediana di Turbo
Circa 100 ms
Una dichiarazione di timing di inferenza del modello
Tempo mediano al primo audio di Turbo
Circa 150 ms
Timing dalla richiesta all’audio udibile nelle condizioni di test dichiarate
I test d’ascolto pubblicati confrontano Eleven v4 con modelli di sintesi concorrenti. Non stabiliscono quanto, se mai, gli ascoltatori lo preferiscano rispetto a Eleven v4 Turbo. Per quella scelta, confronta entrambe le varianti usando gli stessi script e voci nel tuo test d’ascolto in cieco.
Grafico di preferenza ufficiale ElevenLabs. Confronta Eleven v4 con modelli di parlato concorrenti; non misura un divario di qualità diretto rispetto a Turbo.
Grafico di latenza ufficiale ElevenLabs. Il timing riportato esclude la latenza di rete misurata.
Condizioni di valutazione
Lo studio d’ascolto ufficiale di settembre 2026 ha usato confronti accoppiati in cieco della stessa battuta di Eleven v4 e di un modello concorrente, giudicando espressività e naturalezza; i pareggi contavano come metà. I sistemi confrontati e i tassi di preferenza per sistema compaiono nel grafico ufficiale qui sotto. Questi risultati dichiarati dal vendor confrontano Eleven v4 con sistemi concorrenti. Non quantificano una differenza di qualità d’ascolto tra Eleven v4 ed Eleven v4 Turbo.
Il confronto di latenza di settembre 2026 ha usato script identici e impostazioni predefinite, ha rimosso la latenza di rete misurata per ogni sistema e ha eseguito Turbo su streaming WebSocket. I 150 ms riportati misurano dalla richiesta all’audio udibile; è una metrica diversa dal valore di inferenza di circa 100 ms. La metodologia citata non fornisce un dettaglio completo su hardware, regione, carico e dimensione del campione, quindi non stabilisce una garanzia di latenza in produzione.
Qualità vocale e coerenza in produzione
ElevenLabs evidenzia il supporto ai Professional Voice Clone, una maggiore coerenza del parlante su rigenerazioni di battute e l’unione di richieste per audio long-form. Valuta queste affermazioni con un passaggio completo e una battuta di sostituzione inserita in una registrazione esistente.
Per audio registrato, separa la resa espressiva dalla coerenza di produzione. Ascolta enfasi, emozione, pronuncia e se lo stesso parlante resta riconoscibile sui passaggi. Il modello standard è l’opzione del vendor orientata alla qualità, ma uno script istruttivo semplice può non rivelare una differenza utile. Confronta clip accettate invece di presumere che una generazione più costosa richiederà sempre meno editing.
Direzione vocale e resa multilingue
Entrambe le varianti supportano una resa espressiva, ma l’espressività utile dipende dallo script e dalla voce scelta. Parti da un numero ridotto di indicazioni chiare, poi verifica se migliorano il significato voluto.
Una risposta di supporto rassicurante può combinare un tono caldo con una breve pausa:
[warm, reassuring] I found your reservation.
[short pause] Let me confirm the arrival time with you.
Questa è una traccia illustrativa, non un risultato di performance misurato. Provala accanto a una versione senza tag. Indicazioni aggiuntive sono utili solo quando migliorano l’output.
Anche la localizzazione merita un ascolto separato. Secondo la guida prodotto nativa, la generazione nella stessa lingua preserva l’accento originale della voce di riferimento, mentre la generazione cross-lingua adotta una pronuncia naturale nella lingua di destinazione invece di mantenere l’accento della lingua sorgente.
Questo comportamento può adattarsi a un tutorial di prodotto localizzato, ma un personaggio di finzione con un riconoscibile accento straniero deliberato può richiedere indicazioni aggiuntive. Valuta separatamente pronuncia, identità e accento previsto; una voce può suonare fluente pur mancando il brief creativo.
Latenza e affidabilità
Per un agente vocale in produzione, la sintesi vocale è solo parte del ritardo. Riconoscimento vocale, rilevamento del turno, output del language model, percorrenza di rete e buffering audio possono tutti influire su quando l’utente sente la risposta.
Misura sia i tempi di risposta mediani sia la coda lenta nella tua applicazione. Una mediana bassa può coesistere con pause occasionali che rendono la conversazione frustrante.
Eleven v4 vs v4 Turbo: Costi
Prezzi ufficiali per carattere API
Il confronto API nativo sotto usa tariffe pubblicate verificate il 19 ottobre 2026. I volumi totali sono calcoli basati su tali tariffe, non pacchetti separati.
Utilizzo — pricing API ufficiale
Variante standard
Variante Turbo
Risparmio calcolato con Turbo
1,000 characters
$0.08
$0.04
$0.04
100,000 characters
$8.00
$4.00
$4.00
1 million characters
$80.00
$40.00
$40.00
10 million characters
$800.00
$400.00
$400.00
Queste cifre descrivono la generazione del parlato basata sui caratteri, non l’intera fattura di un agente vocale. Le franchigie di abbonamento, altri servizi e le condizioni commerciali applicabili devono essere considerate separatamente.
Prezzi e condizioni di fatturazione CometAPI
CometAPI mostra prezzi denominati in token, mentre le tariffe native sopra sono per carattere. Confronta i costi solo dopo aver confermato come l’endpoint selezionato misura e fattura l’utilizzo. Se ti serve Turbo, conferma che il modello è disponibile sulla rotta CometAPI scelta prima di pianificare l’integrazione.
Costo per registrazione o interazione accettata
Per il budget, usa:
Costo di generazione del parlato = caratteri fatturabili ÷ 1,000 × tariffa per carattere applicabile
Per la produzione di contenuti, una misura operativa più utile è il costo per registrazione accettata. Includi rigenerazioni e tempo di editing. Se la variante più economica manca ripetutamente una performance difficile, il suo vantaggio di prezzo unitario può ridursi.
Per agenti live, confronta il costo delle interazioni completate alla qualità e al tempo di risposta richiesti. Una bolletta di sintesi bassa ha valore limitato se gli utenti abbandonano conversazioni lente o confuse.
Eleven v4 vs v4 Turbo: Confronto e selezione
Selezione basata su capacità e carico di lavoro
Le raccomandazioni seguenti combinano il posizionamento pubblicato con criteri di valutazione pratici. Sono punti di partenza per i test, non risultati di benchmark aggiuntivi.
Progetto
Punto di partenza consigliato
Valutazione decisiva
Audiolibro o documentario
Variante standard
Coerenza su passaggi e rigenerazioni di battute
Scena drammatica con personaggi
Variante standard
Resa emotiva e interazione tra i parlanti
Agente di customer support
Turbo
Tempo di risposta udibile, pronuncia e gestione delle interruzioni
Personaggio di gioco interattivo
Turbo
Responsività e performance durante turni brevi
Clip istruttive semplici
Testa entrambe
Se gli ascoltatori notano una differenza di qualità significativa
Produzione multilingue
Testa entrambe per lingua
Pronuncia, accento e identità vocale
Prodotto con audio registrato e live
Instradamento separato per carico di lavoro
Se ciascun percorso soddisfa i propri criteri di accettazione
Per audiolibri, pubblicità e scene drammatiche, testa Eleven v4 con un passaggio neutro, uno emotivo e una battuta rigenerata inserita in una registrazione esistente. Ascolta identità vocale, pacing e pronuncia coerenti attraverso le giunzioni. Scegli la variante standard quando la performance accettata o il tempo risparmiato in editing giustifica la tariffa per carattere più alta.
Per agenti di supporto e personaggi interattivi, testa Turbo sull’intera conversazione: parlato dell’utente, rilevamento del turno, generazione della risposta, sintesi e riproduzione. Includi connessioni lente, errori di connessione e interruzioni. Conferma che la riproduzione si interrompe prontamente quando l’utente interrompe e che la risposta successiva inizia pulita. Scegli Turbo quando soddisfa sia la soglia di qualità d’ascolto sia l’obiettivo di tempo di risposta.
Crea un set di test rappresentativo: includi una spiegazione neutra, una risposta rassicurante, un passaggio emotivo, nomi o abbreviazioni e testo multilingue usato dal tuo pubblico.
Mantieni script, voce e impostazioni di output quanto più comparabili possibile per ciascuna interfaccia.
Esamina le registrazioni senza etichette di modello. Registra errori di pronuncia, identità vocale incoerente e le correzioni necessarie per ciascuna take.
Misura separatamente il tempo di risposta live rispetto alla qualità d’ascolto, includendo sia la latenza mediana sia i ritardi di coda lenta.
Definisci soglie di accettazione prima di scegliere una rotta: pronuncia, coerenza vocale, sforzo di editing, latenza mediana e ritardi di coda lenta.
Fai passare traffico rappresentativo tramite l’endpoint che distribuirai. Traccia output rifiutati, retry e problemi di riproduzione o connessione.
Confronta il costo per registrazione accettata o interazione completata, includendo rigenerazioni e sforzo di editing.
Per prodotti con audio sia preregistrato sia live, testa l’instradamento separato e conferma che ciascun percorso soddisfi le proprie soglie di accettazione.
Dove puoi accedere a Eleven v4 e v4 Turbo?
Accesso tramite provider ufficiale
Usa la rotta nativa del provider che corrisponde al carico di lavoro: parlato e dialogo generati per audio prodotto, e streaming WebSocket Text to Dialogue per interazione Turbo. L’esempio ufficiale sotto documenta la connessione di streaming e le restrizioni di registrazione della voce. Verifica lo schema corrente dell’endpoint, i requisiti di autenticazione e i limiti dell’account prima di connettere un carico di lavoro in produzione.
Lo stesso riferimento specifica esattamente una voce registrata per connessione Turbo, rispetto a fino a dieci per la variante standard su quell’endpoint. Queste sono regole a livello di connessione, non un’affermazione universale su ogni interfaccia.
Accesso tramite CometAPI
Eleven v4 API in CometAPI fornisce una rotta per generare parlato tramite un’interfaccia compatibile con Runway. Il suo annuncio di integrazione del 10 ottobre 2026 documenta il comportamento specifico del provider riassunto sotto.
Dettaglio di integrazione — annuncio CometAPI
Comportamento pubblicato
Model ID
eleven_v4
Submission endpoint
POST /runwayml/v1/text_to_speech
Processing
Invio attività asincrono
Output
Audio MP3
Input limit
Fino a 2,500 caratteri per richiesta
Voice configuration
Voci predefinite
Additional exposed control
Velocità del parlato regolabile
Questi sono dettagli di integrazione specifici del provider. Il limite nativo di 10.000 caratteri e i controlli dell’interfaccia nativa non vanno sostituiti con il comportamento documentato di questa interfaccia. Allo stesso modo, il workflow asincrono non dimostra che le performance WebSocket native di Turbo siano disponibili tramite questa rotta.
Una sequenza pratica di integrazione è inviare uno script breve, seguire il workflow di stato dell’attività documentato, recuperare il risultato e verificare pronuncia e durata dell’output prima di aumentare il volume.
Conclusione
Scegli Eleven v4 quando le registrazioni accettate offrono qualità di performance o risparmi di produzione sufficienti a giustificare la tariffa per carattere più alta. Scegli Eleven v4 Turbo quando supera la tua soglia di ascolto e supporta la reattività necessaria per una conversazione live. Prendi la decisione finale sull’endpoint che distribuirai, includendo script rappresentativi, retry e il costo operativo totale.
FAQ
Come suddividere script lunghi di Eleven v4 per la produzione?
Dividi ai confini di paragrafo, frase o scena, non nel mezzo di una parola o di un turno di parlato. Lascia spazio per eventuali testi di direzione entro l’input consentito dall’endpoint, conserva un record dello script e delle impostazioni di voce per ciascun segmento e prova all’ascolto le giunzioni dopo aver assemblato l’audio. Confronta loudness, pacing, pronuncia e identità vocale attraverso i confini; accettare ogni clip individualmente non dimostra che la registrazione combinata sia uniforme. Usa il limite dell’endpoint del provider effettivo, poiché i limiti di richiesta nativi e CometAPI differiscono.
Come ritentare una richiesta Eleven v4 interrotta?
Tieni traccia dell’identificatore della richiesta o attività originale e determinane lo stato prima di inviare di nuovo lo stesso testo. Per un workflow asincrono del provider, verifica se l’attività originale è stata completata e se il suo risultato è ancora recuperabile. Per uno stream live, registra quale audio è già stato riprodotto e decidi se rigiocare l’enunciato o riprendere a un confine pulito. Conferma le regole di retry, idempotenza e fatturazione dell’endpoint; non presumere che ripetere una richiesta sia gratuito o produca audio identico.
Come possono i team eseguire test di regressione su una release vocale Eleven v4?
Mantieni un set di accettazione fisso contenente nomi di brand, abbreviazioni, numeri, pronunce difficili, passaggi emotivi e le lingue usate dal prodotto. Archivia lo script, l’identificatore del modello, l’identificatore della voce, le impostazioni disponibili, la data di generazione e le registrazioni di riferimento accettate. Quando cambiano modello, voce o integrazione, ascolta nuovi campioni rispetto a quei riferimenti e documenta le correzioni necessarie. Separa una procedura di test riproducibile dalla supposizione di forme d’onda identiche: superare una registrazione non garantisce che ogni generazione successiva supererà.