Crea con CometAPITi serve una sola API per più modelli?Testa il flusso di lavoro in Playground, poi crea una chiave API quando modello e costo sono adatti al tuo caso d'uso.
Google ha annunciato Gemini 4 Carbon il 28 ottobre 2026, con risultati pubblicati superiori rispetto a Gemini 4 Argon in ambiti di coding, ragionamento su contesti lunghi e cybersecurity. Per gli sviluppatori, la scelta immediata dipende dall’accesso: Argon è disponibile tramite la Gemini API a pagamento, mentre Carbon è ancora in rollout limitato. Questo confronto analizza benchmark, specifiche API, velocità e prezzi per aiutarti a decidere cosa distribuire ora e quando valutare Carbon.
Punti chiave
Prestazioni: Carbon ottiene 59 contro i 50 di Argon sull’Artificial Analysis Intelligence Index v5.0. I miglioramenti variano per benchmark: SWE-sweep sale di 5,3 punti percentuali, mentre GraphWalks BFS F1 migliora di 12,0 punti.
Specifiche API: Argon documenta una finestra unificata da 1.048.576 token condivisa tra input, ragionamento e output. I limiti e il supporto agli strumenti dell’API pubblica di Carbon non sono stati annunciati.
Prezzi: Entrambi i modelli hanno tariffe introduttive annunciate di $2 per milione di token in input e $10 per milione di token in output. L’offerta di Argon è valida fino al 30 novembre 2026; la fine del periodo introduttivo di Carbon non è stata annunciata.
Revisionato per chiarezza, attribuzione delle fonti e terminologia API aggiornata.
Decisione di aggiornamento: Confronta tasso di accettazione del task, latenza end-to-end e costo per risultato accettato quando valuti Carbon. Punteggi di benchmark più alti da soli non dimostrano se il passaggio migliorerà la tua applicazione.
Gemini 4 Carbon vs Gemini 4 Argon: panoramica e specifiche
Parti dalla decisione di deployment: Argon ha un’API documentata utilizzabile subito, mentre Carbon offre risultati pubblicati più forti con accesso iniziale limitato.
Gemini 4 Carbon è focalizzato su workflow di ingegneria avanzata e cybersecurity difensiva, con accesso iniziale riservato a partner selezionati. Gemini 4 Argon è disponibile tramite la Gemini API a pagamento per ragionamento, coding, problem solving scientifico e workflow di agenti. La tabella seguente confronta le specifiche API e le capacità annunciate.
Contesto, ragionamento e specifiche API
Argon ha una specifica per sviluppatori pubblicata. Carbon ha pubblicato risultati di valutazione, ma tali risultati non stabiliscono i limiti esatti o il supporto agli strumenti di una futura API pubblica. Né il branding di famiglia condiviso né punteggi più alti dimostrano che i modelli usino un’architettura identica.
Specifiche API
Gemini 4 Carbon
Gemini 4 Argon
Posizionamento del modello
Ragionamento frontier, cybersecurity, agenti a lungo orizzonte
Ragionamento frontier, coding, scienza, agenti
ID modello API pubblica
Non annunciato
gemini-4-argon
Finestra di contesto
1M token riportati da Artificial Analysis; limite API ufficiale non documentato
1.048.576 token condivisi tra input, ragionamento e output
Output massimo
Non ufficialmente documentato
Limite sincrono predefinito 65.536; long decode fino al restante della finestra unificata
Modalità di input
Capacità multimodale dimostrata; specifica API completa in attesa
Testo, immagine, audio, video, PDF
Modalità di output
Specifica dell’API pubblica in attesa
Testo
Livelli di ragionamento
Non ufficialmente documentati
Basso, medio, alto
Chiamata di funzioni ed esecuzione del codice
Supporto API pubblico non confermato
Supportato
Uso del computer
Supporto API pubblico non confermato
Anteprima
Caching del contesto
Sconto di prezzo annunciato; dettagli di implementazione in attesa
Caching implicito
Accesso pubblico per sviluppatori
Non ancora ampiamente disponibile
La finestra da 1.048.576 token di Argon è condivisa tra input, ragionamento e output generato, quindi un input più grande lascia meno spazio alla generazione. Il budget di generazione predefinito è di 65.536 token, inclusi ragionamento e output. Le generazioni più lunghe usano il long decode, che rielabora il contesto precedente tra gli step di continuazione e aggiunge addebiti per token di input; il contesto ripetuto può beneficiare di sconti di caching implicito.
Con l’Interactions API, le generazioni più lunghe richiedono la modalità in background e un’impostazione max_output_tokens più alta. Con GenerateContent, è il client a dover gestire le richieste di continuazione.
Gemini 4 Carbon vs Gemini 4 Argon: prestazioni
Carbon supera Argon in tutto il confronto riportato, ma l’entità e il significato dei guadagni differiscono per task.
Risultati ufficiali dei benchmark e condizioni di test
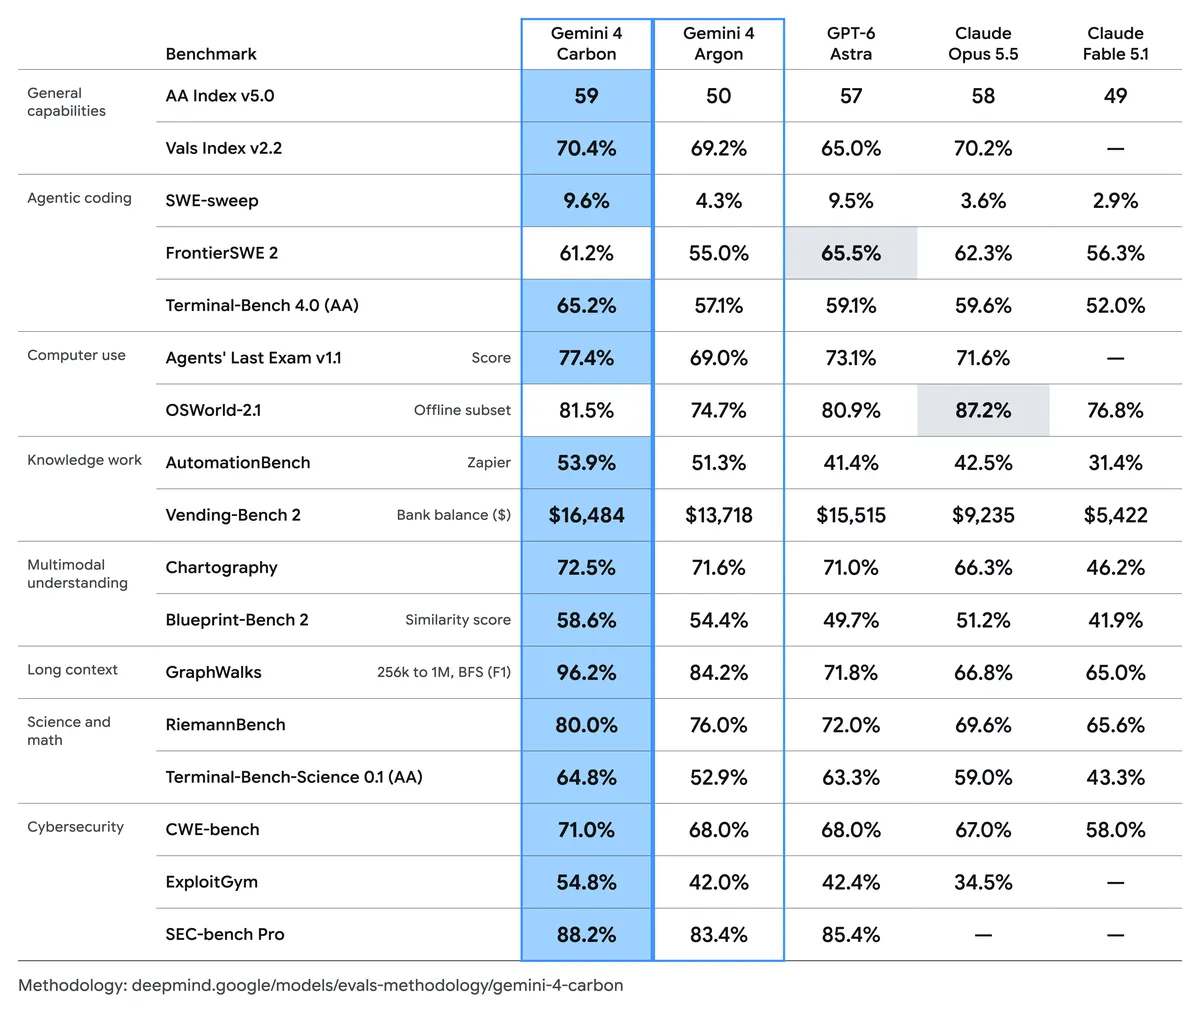
Il confronto pubblicato da Google mostra Carbon in vantaggio in tutte le 17 righe seguenti. Combina valutazioni eseguite da Google con punteggi di valutatori esterni e leaderboard di benchmark; non afferma che Google abbia eseguito indipendentemente ogni test.
La metodologia di valutazione utilizza generalmente l’impostazione di ragionamento più alta e pass@1 salvo diversa indicazione del benchmark. Impalcature per agenti, sottoinsiemi di task e definizioni di punteggio variano, quindi le percentuali tra benchmark diversi non sono intercambiabili.
Benchmark e metrica
Gemini 4 Carbon
Gemini 4 Argon
Vantaggio di Carbon
Artificial Analysis Intelligence Index v5.0
59
50
+9 punti
Vals Index v2.2
70.4%
69.2%
+1.2 pp
SWE-sweep
9.6%
4.3%
+5.3 pp
FrontierSWE 2
61.2%
55.0%
+6.2 pp
Terminal-Bench 4.0 (AA)
65.2%
57.1%
+8.1 pp
Agents' Last Exam v1.1
77.4%
69.0%
+8.4 pp
OSWorld-2.1 (offline subset)
81.5%
74.7%
+6.8 pp
AutomationBench (Zapier)
53.9%
51.3%
+2.6 pp
Vending-Bench 2 (bank balance)
$16,484
$13,718
+$2,766
Chartography
72.5%
71.6%
+0.9 pp
Blueprint-Bench 2
58.6%
54.4%
pp = punti percentuali. Vending-Bench 2 riporta un saldo bancario simulato anziché un’accuratezza.
GraphWalks: il sottoinsieme 256K–1M contiene 200 problemi e riporta BFS F1, non un tasso di accuratezza generico.
Agents' Last Exam: Google utilizza un set da 122 task v1.1, l’harness ALE-Claw, una finestra di cinque ore e filtri di sicurezza attivati.
OSWorld: la cifra riportata usa il sottoinsieme offline da 82 task, schermate a 1080p, limite di 500 step e il massimo su tre esecuzioni a singolo tentativo. Non rappresenta il benchmark online completo.
Prestazioni di coding e lavoro su repository
Su Terminal-Bench 4.0, Carbon ottiene il 65.2%, contro il 57.1% di Argon, un vantaggio di 8,1 punti percentuali. Il benchmark testa lavoro da riga di comando e problem solving tecnico multi-step.
Su SWE-sweep, Carbon ottiene il 9.6% rispetto al 4.3% di Argon, un vantaggio di 5,3 punti percentuali e oltre il doppio del punteggio.
Questo miglioramento relativo è notevole, ma il risultato assoluto resta sotto il 10%. Carbon è più forte, non universalmente affidabile su ogni difficile task di ingegneria del software.
I candidati pratici alla valutazione sono debugging su repository, migrazioni di codice e task che coinvolgono uso ripetuto di strumenti e verifiche. Per una codebase di produzione, superare i tuoi test resta più utile che estrapolare un tasso di successo da un benchmark diverso.
Prestazioni multimodali e a lungo contesto
Nella valutazione GraphWalks 256K–1M BFS F1, Carbon ottiene il 96.2% rispetto all’84.2% di Argon, un vantaggio di 12 punti percentuali. Questo rende la sintesi di documenti lunghi e l’analisi di repository candidati utili alla valutazione. Qualità del retrieval, struttura dei documenti e limiti effettivi di ciascun endpoint incidono comunque sul risultato.
Su Chartography, Carbon ottiene il 72.5% rispetto al 71.6% di Argon, un vantaggio di 0,9 punti percentuali. Su Blueprint-Bench 2, Carbon ottiene il 58.6% rispetto al 54.4% di Argon, un vantaggio di 4,2 punti percentuali. Questi risultati di comprensione visiva supportano il test di workflow su documenti e grafici, mentre i formati di input supportati dalla futura API pubblica di Carbon devono ancora essere confermati.
Cybersecurity e affidabilità degli agenti
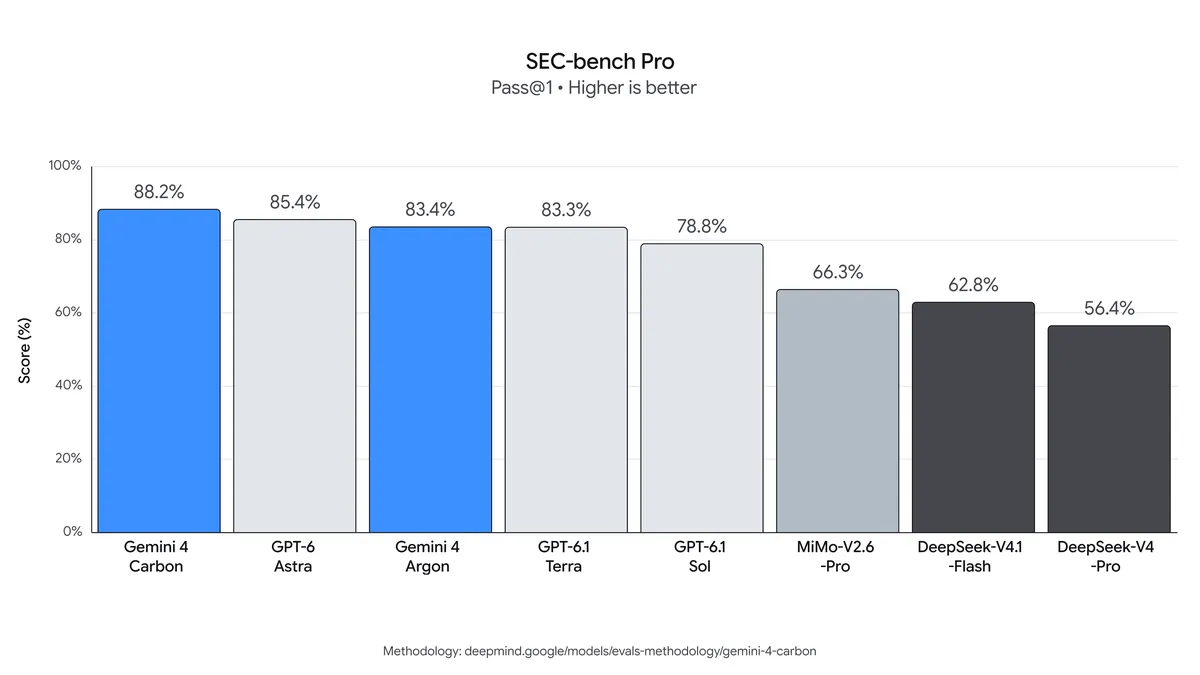
I risultati di sicurezza coprono discovery, validazione degli exploit e remediation: Carbon ottiene 88.2% su SEC-bench Pro, 54.8% su ExploitGym e 71.0% su CWE-bench. Il suo vantaggio maggiore su Argon è in ExploitGym, con 12,8 punti percentuali.
Le condizioni di valutazione della sicurezza contano: SEC-bench Pro utilizza lo split May 2026 del motore JavaScript con 183 task, mentre ExploitGym usa un setup offline, a singolo tentativo, con agente e mitigazioni disattivate. Google riporta valutazioni di sicurezza esterne senza guardrail di deployment; questi punteggi non stabiliscono il comportamento dell’API senza restrizioni.
Per agenti di lunga durata, un modello utile deve anche segnalare onestamente i fallimenti e restare entro il task autorizzato. Google riporta uno 0,0% di tasso osservato di imbrogli riusciti su Terminal-Bench 4.0, con tentativi di cheating al 0,4%. Le sue valutazioni interne hanno anche rilevato meno affermazioni non supportate e tassi inferiori di sconfinamento e sotto-servizio rispetto ad Argon. Si tratta di osservazioni specifiche delle valutazioni, non di garanzie valide per ogni applicazione.
In pratica, mantieni controlli di permesso, esecuzione isolata, revisione delle patch e validazione indipendente quando valuti entrambi i modelli su lavoro di sicurezza difensiva.
Velocità e latenza
Metrica di prestazione
Gemini 4 Carbon
Gemini 4 Argon
Throughput di output
Circa 102 token/s
Circa 82 token/s
Tempo al primo token
Circa 100 s
Circa 47 s
Token di output per task valutato
Circa 123K
Circa 116K
Token di ragionamento per task valutato
Circa 72K
Circa 68K
Queste misurazioni di terze parti descrivono la configurazione di test del valutatore e non sono una garanzia di latenza o throughput per il tuo deployment API. Il confronto può cambiare man mano che il valutatore aggiorna i risultati e Google amplia l’accesso a Carbon.
La maggiore velocità di generazione token di Carbon e il più lungo ritardo al primo token descrivono parti diverse di una richiesta. Per un’interfaccia chat, l’attesa prima dell’inizio dell’output può dominare l’esperienza; per un job autonomo, valuta il tempo di completamento end-to-end insieme al tasso di successo. Il throughput da solo non determina quale modello finisca prima un task utile.
Gemini 4 Carbon vs Gemini 4 Argon: costo
Confronta separatamente tariffe ufficiali per token e fatturazione del provider, quindi calcola il costo di un risultato accettato. Prezzi per token identici possono comunque produrre fatture diverse quando variano ragionamento, tentativi falliti e uso degli strumenti.
Prezzi API per provider
Entrambi i modelli hanno le stesse tariffe introduttive annunciate da Google. CometAPI elenca tariffe separate per Argon; non ha un prezzo confermato per Carbon in questo confronto. Tutti i prezzi dei provider riportati di seguito riflettono lo snapshot dell’articolo del 29 ottobre 2026.
Provider
Categoria di prezzo
Gemini 4 Carbon
Gemini 4 Argon
Google
Input introduttivo / 1M token
$2.00
$2.00
Google
Output introduttivo, inclusi i token di ragionamento / 1M token
$10.00
$10.00
Google
Input in cache introduttivo / 1M token
$0.10
$0.10
Google
Input successivo / 1M token
$4.00
$4.00
Google
Output successivo, inclusi i token di ragionamento / 1M token
$20.00
$20.00
Google
Input in cache successivo / 1M token
$0.20
$0.20
Google
Periodo introduttivo
Data di fine non annunciata
Fino al 30 novembre 2026
Google
Accesso in produzione pubblico
Rollout limitato
Disponibile
CometAPI
Input ordinario / 1M token
Non confermato
$1.60
CometAPI
Output ordinario / 1M token
Non confermato
$8.00
Il periodo introduttivo di Argon presso Google termina il 30 novembre 2026, con tariffe successive a partire dal 1° dicembre. Carbon non ha una data di fine introduttiva annunciata. Le cifre per input in cache sono calcolate dallo sconto annunciato del 95%; dettagli di implementazione e idoneità restano in attesa.
Prima di stimare una fattura, conferma tariffe, regole di caching, addebiti per lungo contesto e supporto degli strumenti per il provider e l’account scelti. Le tariffe annunciate da Google per Carbon non stabiliscono un prezzo Carbon su CometAPI.
Esempio di costo: 1,000 richieste
Per una richiesta con 100,000 token in input e 25,000 token totali fatturabili in output, inclusi i token di ragionamento, i prezzi introduttivi standard danno:
Totale: $0.45 per richiesta, ovvero $450 per 1,000 richieste identiche.
Alle tariffe successive, lo stesso task costa $0.90. Se 25,000 descrive solo la risposta finale visibile, aggiungi eventuali token di ragionamento conteggiati separatamente prima di stimare la fattura. L’esempio esclude grounding, strumenti esterni e altri oneri di servizio.
Alle tariffe CometAPI per Argon visualizzate, la stessa richiesta con 100,000 token in input e 25,000 token fatturabili in output costa $0.16 + $0.20 = $0.36, ovvero $360 per 1,000 richieste identiche. Questa stima esclude effetti di cache, retry e oneri di servizi separati; non stima un deployment Carbon tramite CometAPI.
Costo per task accettato = spesa totale per modello e strumenti ÷ completamenti di task accettati. Definisci i criteri di accettazione prima dei test, includi nelle spese tentativi falliti e retry, e registra separatamente il tempo di revisione umana.
Dove puoi accedere a Gemini 4 Carbon e Gemini 4 Argon?
Accesso tramite provider ufficiale
Al 29 ottobre 2026, Argon è disponibile tramite Gemini API e Google AI Studio. L’accesso a Carbon è inizialmente limitato a difensori della cybersecurity selezionati e partner fidati; un endpoint per sviluppatori generalmente disponibile e una data di rilascio più ampia non sono stati confermati. Parti dal percorso abilitato per il tuo account e verifica l’identificatore del modello e le funzionalità supportate.
Accesso tramite CometAPI
Gemini 4 Argon API in CometAPI fornisce una via di integrazione aggiuntiva per gli sviluppatori che usano un’interfaccia chat compatibile.
Per iniziare, crea una chiave API CometAPI, seleziona il modello gemini-4-argon e configura la tua applicazione per usare l’endpoint chat documentato dal provider. Inizia con una richiesta di testo rappresentativa, rivedi la risposta e verifica uso e addebiti prima di espandere il carico di lavoro.
CometAPI applica proprie tariffe di fatturazione. Conferma supporto a strumenti, controlli di ragionamento e risposte lunghe sul percorso che intendi usare. Un’interfaccia chat compatibile non stabilisce il supporto per ogni funzionalità nativa di Gemini.
La disponibilità di Carbon su CometAPI e l’identificatore del modello di produzione non sono confermati al 29 ottobre 2026. Mantieni operativo Argon e passa solo dopo che il provider documenta l’accesso a Carbon e la tua integrazione supera i controlli pertinenti.
Dovresti scegliere Gemini 4 Carbon o Argon?
Carico di lavoro
Punto di partenza pratico
Cosa validare
Un’applicazione da distribuire ora
Argon
Tasso di accettazione del task, comportamento dell’endpoint, costo operativo
Debugging complesso o migrazioni di codice
Valuta Carbon quando l’accesso è disponibile
Test su repository, qualità delle revisioni, e retry
Ricerca di vulnerabilità autorizzata
Valuta Carbon nel programma di accesso consentito
Controlli di sicurezza, validità dei riscontri e correttezza delle patch
Analisi di documenti o codebase grandi
Baseline con Argon; Carbon come candidato
Accuratezza delle evidenze e omissioni sugli stessi input sorgente
Un’interfaccia utente interattiva
Benchmark dell’endpoint Argon disponibile
Ritardo al primo token e tempo totale sotto traffico reale
Scelta di un punto di partenza e di un candidato all’upgrade
Scegli Argon quando devi distribuire ora. La sua API accessibile e il contesto, le modalità e gli strumenti documentati consentono di testare l’applicazione completa, inclusi latenza e costo.
Valuta Carbon quando l’accesso è disponibile e il lavoro lo giustifica. Dai priorità a cambiamenti difficili su repository, sintesi a lungo contesto o attività di sicurezza difensiva autorizzate. Aggiorna quando offre più patch o riscontri accettati, meno retry o minore sforzo di revisione entro i limiti di latenza e budget.
Una baseline con Argon e un percorso di upgrade a Carbon
Mantieni operativo il workflow con Argon costruendo un set fisso di task rappresentativi. Quando Carbon diventa accessibile tramite un percorso supportato, esegui gli stessi task con permessi agli strumenti comparabili e criteri di accettazione identici. Non creare un failover automatico verso un endpoint ristretto o non documentato; prendi decisioni di instradamento solo dopo che compatibilità e risultati sul carico di lavoro sono stati stabiliti.
Valutazione in produzione
Mantieni fisso il set di valutazione quando confronti i modelli. Registra versione del modello, impostazione di ragionamento, prompt, permessi degli strumenti, uso di token, ritardo al primo token, durata totale e se il risultato ha superato la revisione. Un punteggio di benchmark più alto è un indizio utile per scegliere cosa testare; la decisione di rilascio dovrebbe seguire i risultati sul tuo carico di lavoro.
Includi richieste di routine e casi difficili in cui il fallimento sarebbe costoso.
Ripeti i task e alterna l’ordine dei modelli per ridurre l’influenza di risultati estemporanei.
Misura latenza mediana e di coda, uso di token, retry e risultati accettati su tutto il workflow.
Imposta limiti ai nuovi tentativi e condizioni di escalation basati su risultati di validazione osservabili.
Conclusione
L’upgrade utile è quello che migliora il lavoro completato. Scegli un piccolo set di task rappresentativi, definisci cosa conta come risultato accettabile e misura insieme costo del modello e della revisione. Quando Carbon diventa disponibile per il tuo account, gli stessi task mostreranno se i guadagni nei benchmark si traducono in valore sufficiente da giustificare il passaggio.
Domande frequenti
Un prompt per Argon può essere riutilizzato invariato con Carbon?
Può essere un punto di partenza per la valutazione, ma non è una prova di compatibilità di comportamento dell’API. Mantieni costanti il task e i criteri di accettazione, quindi verifica l’identificatore del modello di Carbon, lo schema della richiesta, il formato degli strumenti e i limiti documentati quando l’accesso è disponibile. Il riuso del prompt e la compatibilità d’integrazione sono questioni separate.
Le impostazioni di ragionamento vanno allineate quando si confrontano i modelli?
Allineale dove gli endpoint espongono controlli comparabili e registra eventuali differenze. I risultati di benchmark al massimo ragionamento descrivono un setup di valutazione specifico; non predicono qualità o latenza di un deployment Argon che gira all’impostazione predefinita media. I controlli di ragionamento di Argon offrono livelli basso, medio e alto, quindi confronta sia l’impostazione più bassa che soddisfa la soglia di accettazione della tua applicazione sia una configurazione alla massima qualità.
Un vantaggio di benchmark può stabilire una garanzia di servizio in produzione?
No. Le prestazioni nei benchmark non stabiliscono impegni di uptime dell’endpoint, disponibilità regionale, termini di gestione dei dati o modalità di supporto. Rivedi tali condizioni con il provider scelto separatamente e testa dimensioni di richiesta e pattern di traffico attesi prima di affidarti a uno dei due modelli per un workflow critico.