Crea con CometAPITi serve una sola API per più modelli?Testa il flusso di lavoro in Playground, poi crea una chiave API quando modello e costo sono adatti al tuo caso d'uso.
Gemini API livello gratuito 2026: modelli gratuiti, limiti e guida ai prezzi
Vedi quali modelli dell'API Gemini sono gratuiti nel 2026, comprendi i limiti di RPM, TPM e RPD, consulta le linee guida per la configurazione in Python e per la fatturazione, e confronta i prezzi di Google con quelli di CometAPI.
Il livello gratuito della Gemini API è disponibile nell’ottobre 2026 per modelli selezionati, tra cui Gemini 3.8 Flash, Gemini 3.6 Flash, Gemini 3.5 Flash-Lite e Gemini 3.1 Flash-Lite. Puoi iniziare senza configurare la fatturazione, ma la quota disponibile per il tuo progetto determina quanto puoi effettivamente eseguire.
Inizia con Gemini 3.8 Flash per esperimenti impegnativi di coding e reasoning, oppure con un modello Flash-Lite per attività di estrazione e classificazione di routine. Prima di utilizzare dati reali dei clienti, verifica i termini sui dati applicabili. Se hai bisogno di capacità a pagamento, confronta le tariffe native di Google con l’accesso fatturato separatamente di CometAPI.
Key Takeaways
Gemini 3.8 Flash è l’opzione Flash più recente trattata qui, con input multimodale e sforzo di reasoning regolabile.
Gemini 3.6 Flash rimane un’opzione supportata per le integrazioni esistenti; Gemini 3.5 Flash-Lite e Gemini 3.1 Flash-Lite sono destinati a carichi più leggeri.
Gemini 4 Argon richiede accesso API a pagamento. La disponibilità gratuita in un altro prodotto Google non implica l’idoneità gratuita nell’API.
Revisionato per chiarezza, attribuzione delle fonti e terminologia API aggiornata.
Controlla le quote in AI Studio. La finestra di contesto di un modello è diversa dall’assegnazione di richieste e token del tuo progetto.
Confronta le vie di accesso. La quota gratuita di Google e i prezzi, i crediti e i limiti dell’account di CometAPI sono separati.
Is the Gemini API Free in 2026?
Google offre token di input e output gratuiti per modelli selezionati della Gemini API, soggetti a quote a livello di progetto. Puoi iniziare senza abilitare la fatturazione. Si tratta di un livello gratuito basato su quota, non di un credito promozionale una tantum.
È importante distinguere tra Google AI Studio, la Gemini API e gli abbonamenti consumer a Gemini: sono esperienze di accesso separate. Un modello disponibile in un’interfaccia non è necessariamente disponibile gratuitamente tramite un’altra.
Which Gemini API Models Are Free in October 2026?
I quattro modelli seguenti sono punti di partenza utili per applicazioni testuali e multimodali. Non sono un elenco esaustivo di tutti gli endpoint idonei al gratuito. Segui i link dei modelli per esplorare l’accesso tramite CometAPI; le specifiche Google sono collegate sotto la tabella.
Tutti e quattro accettano input di testo, immagine, video, audio e PDF e producono testo. Il limite di input pubblicato è 1,048,576 token, con fino a 65,536 token di output. Questi limiti del modello non garantiscono che il tuo progetto gratuito possa inviare una richiesta di tali dimensioni.
Audio, Embeddings and Image Generation: Access and Limits
Google elenca inoltre l’accesso gratuito per alcuni modelli specialistici, come Gemini 3.8 Live, Gemini 3.8 Flash TTS e Gemini Embedding 2. Controlla la voce di pricing per il modello e l’endpoint esatti prima di integrare: comprendere un’immagine o una clip audio è una capacità diversa dal generare un’immagine o una risposta vocale.
I metodi API, i formati di richiesta e i limiti variano in base alla capacità. Consulta la documentazione per il modello e l’operazione specifici che intendi utilizzare.
L’accesso gratuito non si estende a ogni modello Gemini o endpoint di generazione. Gemini 4 Argon richiede l’accesso a pagamento alla Gemini API, mentre gli endpoint premium di generazione di immagini e video hanno proprie regole di idoneità. Prima di integrare una funzionalità, verifica il modello e l’operazione esatti anziché presumere che condividano la stessa franchigia gratuita.
How Does Gemini 3.8 Flash Perform?
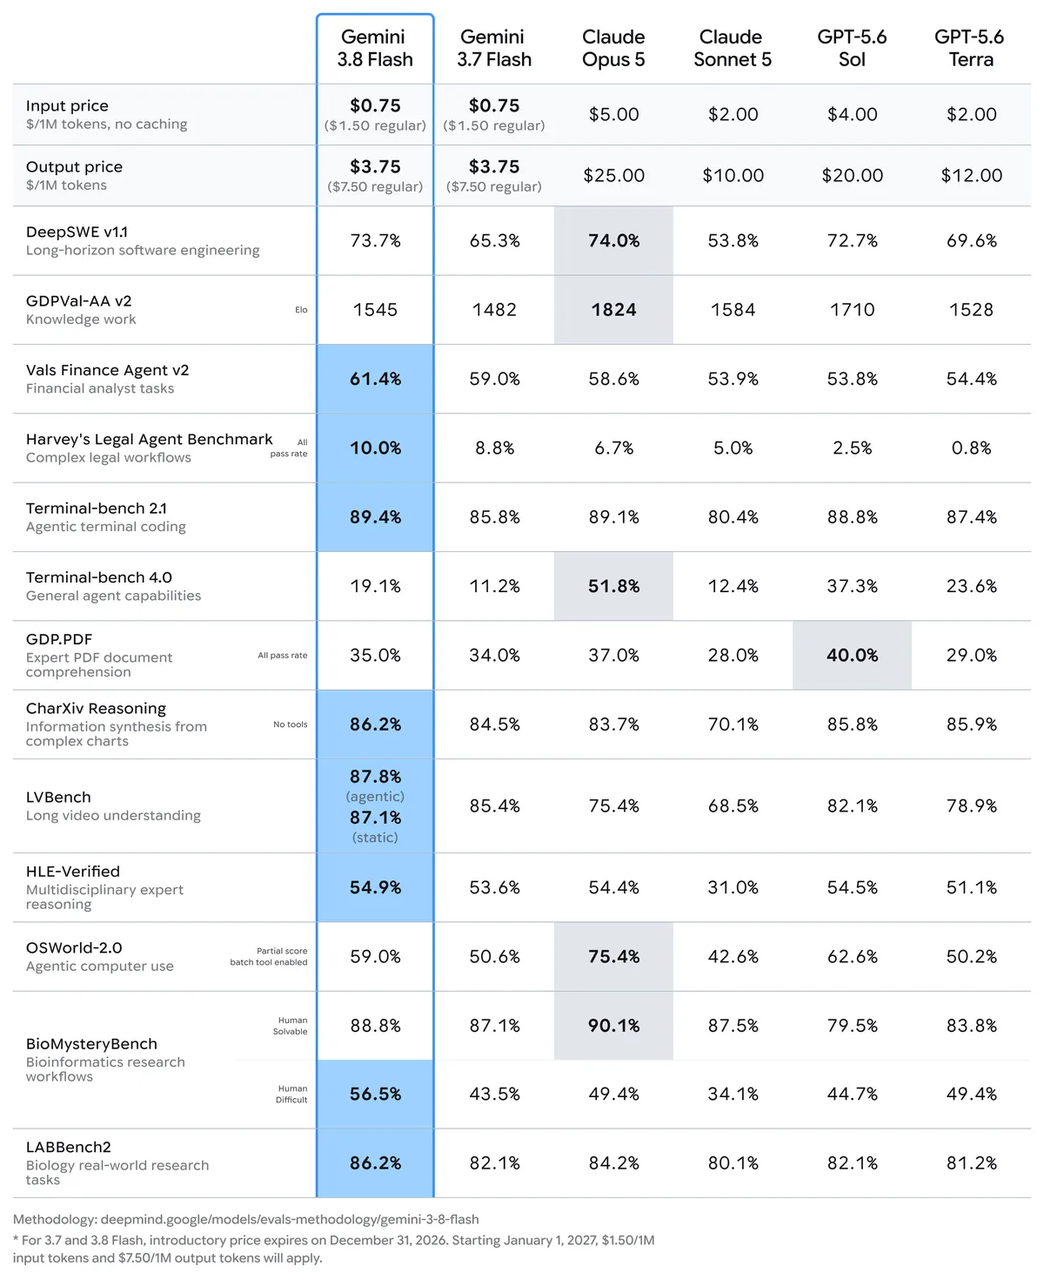
La valutazione pubblicata da Google confronta Gemini 3.8 Flash con Gemini 3.7 Flash e altri modelli. Riporta il 73,7% su DeepSWE v1.1, rispetto al 65,3% per 3.7 Flash—un incremento di 8,4 punti percentuali. Su HLE-Verified, il punteggio riportato sale da 53,6% a 54,9%.
Usa questi risultati per scegliere un modello da testare, quindi valutalo su esempi della tua applicazione. Per un estrattore di documenti, i campi corretti e la stabilità del formato in output possono contare più di un benchmark di coding. Per un assistente di coding, misura se la modifica proposta funziona, quanto tempo richiede e quanti token consuma.
What Are the Gemini API Free Tier Rate Limits in 2026?
Il malinteso più grande sul livello gratuito di Gemini è che ogni account riceva lo stesso numero fisso di richieste.
Apri Google AI Studio, scegli il progetto associato alla tua chiave API e rivedi i limiti attivi per il modello selezionato. La guida ai rate limit di Google spiega le dimensioni della quota; la dashboard mostra la franchigia applicata al tuo account.
RPM (requests per minute): limita quante richieste puoi inviare ogni minuto. Attenzione ai picchi brevi e ai worker paralleli che inviano troppe richieste in una volta.
TPM (input tokens per minute): limita il volume di token di input che puoi inviare ogni minuto. Prompt grandi, cronologie di conversazione e documenti possono usare questa franchigia anche quando il numero di richieste è basso.
RPD (requests per day): limita il numero totale di richieste giornaliere. Pianifica il carico di lavoro in base alla franchigia giornaliera e al suo orario di reset.
Un limite di input di un milione di token descrive la dimensione massima di input supportata dal modello. Non garantisce che un progetto nel livello gratuito disponga di sufficiente capacità TPM per inviare un milione di token in una singola richiesta. La capacità di contesto e la capacità dei rate limit devono essere valutate separatamente.
Le quote giornaliere di richieste si azzerano a mezzanotte (Pacific Time). Più chiavi nello stesso progetto condividono i limiti di utilizzo, quindi creare un’altra chiave non aggiunge capacità. Possono applicarsi altri limiti a modelli o operazioni specialistiche.
Handle Gemini API 429 Errors
Leggi il corpo dell’errore prima di ritentare. Nell’attuale Interactions API, un 429 può distinguere tra un limite a breve termine su richieste o token e una quota giornaliera esaurita. Per un limite a breve termine, rallenta la coda e usa un backoff esponenziale con jitter. Per l’esaurimento giornaliero, attendi il reset o modifica il piano di capacità dell’applicazione. Un 503 indica invece un’indisponibilità temporanea del servizio. Vedi il riferimento agli errori API di Google.
How Do Google and CometAPI Prices Compare?
When Gemini API Billing Begins
Consumare la quota gratuita non comporta automaticamente il passaggio all’uso a pagamento del tuo progetto. Senza un account di fatturazione attivo, le richieste che superano la franchigia gratuita disponibile incontrano restrizioni di accesso o capacità invece delle tariffe Standard per token a pagamento.
Per usare capacità a pagamento, devi collegare la fatturazione. Se il tuo account è assegnato a un piano prepagato, devi anche aggiungere crediti, a partire da $5 o l’equivalente locale. Verifica il piano assegnato e i controlli di spesa in AI Studio prima di eseguire l’upgrade. I saldi e la contabilizzazione dei consumi possono aggiornarsi con un ritardo, quindi un saldo prepagato visualizzato non è un limite di spesa istantaneo.
Il credito di benvenuto Cloud da $300 di Google è separato dal livello gratuito della Gemini API. Gli account aperti dopo il 2 marzo 2026 non possono utilizzare quel credito per addebiti della Gemini API o di AI Studio. Consulta la guida alla fatturazione per le regole applicabili al tuo account.
Google and CometAPI Token Prices
La tabella confronta i prezzi Standard per token di Google con le tariffe di modello pubblicate da CometAPI verificate il 26 ottobre 2026. Tutti gli importi sono in USD per un milione di token; l’output include il reasoning fatturabile ove applicabile. L’input e l’output gratuiti di Google si applicano solo alle richieste idonee entro la franchigia del progetto.
I prezzi introduttivi di Flash di Google sopra indicati terminano il 31 dicembre 2026; 3.8 Flash e 3.6 Flash passano quindi a $1.50 per l’input e $7.50 per l’output. Il prezzo introduttivo di Argon termina il 30 novembre 2026, dopo il quale diventa $4 per l’input e $20 per l’output. Le tariffe CometAPI devono essere verificate separatamente quando tali promozioni cambiano. Strumenti, caching, storage, tasse e altri servizi possono aggiungere costi.
A Small Workload Example
Supponiamo che tu invii 1,000 richieste di testo, ciascuna con 2,000 token di input e 500 token di output. Sono due milioni di token di input e mezzo milione di token di output. Alle tariffe sopra, Gemini 3.8 Flash costa $3.375 tramite Google, ovvero circa $3.38, e $2.70 tramite CometAPI. Un carico idoneo al livello gratuito di Google costa $0 solo se rientra nelle quote disponibili. Queste sono stime dei costi per token, non fatture misurate.
How Can You Start Using the Gemini API Free Tier?
Ti servono un account Google e una regione idonei, una chiave API e Python con pip disponibile. L’esempio seguente segue la guida introduttiva attuale di Google e usa l’Interactions API.
Create a Key and Install the SDK
In Google AI Studio, copia o crea una chiave API per un progetto che non abbia abilitato la fatturazione a pagamento. Installa l’SDK, quindi imposta la chiave nell’ambiente del tuo terminale. Conserva la chiave sul tuo server invece di incorporarla nel codice del browser.
pip install -U google-genai
Su macOS o Linux:
export GEMINI_API_KEY="your_api_key"
In Windows PowerShell:
$env:GEMINI_API_KEY="your_api_key"
Send a Request and Check the Result
from google import genai

client = genai.Client()
interaction = client.interactions.create(
    model="gemini-3.8-flash",
    input="Explain vector databases in 100 words."
)
print(interaction.output_text)
Salvalo come file Python ed eseguilo dallo stesso ambiente. Una richiesta riuscita stampa una breve spiegazione. Quindi controlla la dashboard di utilizzo di AI Studio per confermare il progetto e il modello che ricevono il traffico. In caso di errore, ispeziona il codice di errore e verifica chiave, accesso al modello, quota e stato di fatturazione prima di modificare il codice.
How Can Developers Access Gemini API Models Through CometAPI?
CometAPI fornisce un percorso di accesso separato per i modelli Gemini supportati e altri provider di AI.
Scegli questo percorso quando un’interfaccia condivisa tra provider semplifica la tua applicazione. Usa una chiave CometAPI con il relativo endpoint, quindi verifica l’ID modello supportato e i limiti dell’account. La quota gratuita di Google non si trasferisce a questo servizio. L’esempio seguente usa l’interfaccia compatibile con OpenAI documentata da CometAPI.
pip install -U openai
Imposta COMETAPI_KEY nel tuo ambiente usando lo stesso metodo specifico della shell mostrato sopra, quindi esegui:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)
response = client.chat.completions.create(
    model="gemini-3.8-flash",
    messages=[{
        "role": "user",
        "content": "Summarize the benefits of RAG."
    }]
)
print(response.choices[0].message.content)
Prima del deployment, conferma che l’ID modello previsto sia supportato dal tuo account CometAPI. Gli identificatori nativi di Google e gli alias specifici del provider non sono garantiti come corrispondenti per ogni modello.
What Privacy Restrictions Apply to the Gemini API Free Tier?
In base ai Termini aggiuntivi di servizio della Gemini API di Google, i prompt e gli output dei servizi non a pagamento possono essere utilizzati per migliorare i prodotti Google e i revisori umani possono esaminarli. Non inviare informazioni sensibili, riservate o personali ai servizi non a pagamento. I servizi API a pagamento hanno condizioni d’uso dei dati diverse.
Le regole regionali contano: le disposizioni sull’uso dei dati dei servizi a pagamento si applicano a determinate modalità d’uso non a pagamento nello SEE, in Svizzera e nel Regno Unito, ma rendere disponibile un client API agli utenti in tali regioni richiede i Paid Services. Sono condizioni separate. Verifica i termini attuali per i tuoi utenti e il tuo deployment prima del rilascio.
How Can You Optimize Gemini API Free Tier Usage?
Costruisci intorno alla quota che hai misurato. Mantieni un piccolo set di task rappresentativi e registra successo del task, latenza, token di input e output e retry. Quindi modifica una parte del carico di lavoro alla volta:
Instrada in base alla difficoltà. Prova Flash-Lite per l’estrazione di routine e usa un modello più grande solo dove migliora il risultato.
Riduci l’input. Invia la sezione pertinente del documento e la cronologia di conversazione necessaria invece di reinviare tutto ogni volta.
Controlla la generazione. Richiedi una lunghezza di output utile e regola lo sforzo di reasoning solo dove il modello e l’API lo supportano.
Riusa il lavoro. Archivia i risultati ripetuti dell’applicazione e verifica l’idoneità al caching specifico del modello prima di presumere che il caching API sia gratuito.
Gestisci la concorrenza. Mantieni i worker dietro una coda condivisa così i task indipendenti non creano un picco evitabile.
Infine, monitora la qualità oltre al consumo. Un modello più economico che fallisce spesso o richiede diversi tentativi può generare più lavoro di un modello leggermente più costoso che riesce al primo tentativo.
Una metrica interna di valutazione utile è:
Costo effettivo per task riuscito = Costo totale di inferenza / Numero di task riusciti
Per la sperimentazione nel livello gratuito, un’ulteriore metrica operativa è i task riusciti per finestra di quota disponibile.
FAQ
How can I tell whether a quota problem is caused by request bursts or large documents?
Confronta i timestamp dei fallimenti con il numero di richieste e il volume di token di input. Un picco di prompt brevi indica la frequenza delle richieste; alcuni documenti lunghi possono esaurire la capacità di token anche con RPM bassi. Nell’Interactions API, ispeziona il codice di errore machine-readable e distingui l’esaurimento della quota giornaliera da un limite a breve termine. Registra insieme l’uso dei token e la concorrenza dei worker così puoi modificare la parte rilevante della coda.
What should I do if a request times out after I submit it?
Un timeout non indica sempre se un’operazione remota è stata completata. Per un’interazione di cui hai un ID, verifica il suo stato prima di avviare un altro task costoso. Inserisci un ID di task a livello applicativo attorno al tuo workflow e deduplica le azioni a valle, specialmente email, scritture su database e chiamate agli strumenti. Un retry della generazione di testo non dovrebbe ripetere silenziosamente un’azione di business. La documentazione di Interactions di Google descrive il recupero delle interazioni e gli stati di esecuzione.
How should I compare Flash and Flash-Lite for document extraction?
Usa gli stessi documenti, i campi richiesti e le regole di accettazione per entrambi i modelli. Includi scansioni rumorose, campi mancanti e valori ambigui. Valuta l’accuratezza fattuale dei campi e la validità dell’output, quindi conta i retry e le correzioni manuali. Un modello che produce meno token può comunque consumare più sforzo se i suoi errori richiedono un’altra richiesta. Mantieni un set di documenti di holdout così le modifiche al prompt non sono giudicate solo su esempi già ottimizzati.
What should I check before switching an application from Google to CometAPI?
Testa l’endpoint esatto, l’ID modello, il formato dei messaggi e le funzionalità usate dalla tua applicazione. Una richiesta chat-completions compatibile non implica supporto identico per file, tool, caching o impostazioni di reasoning. Confronta i campi di utilizzo restituiti e la gestione degli errori oltre alla risposta testuale, e rivedi le politiche sui dati dell’intermediario e del provider a monte. Inizia con un piccolo carico non sensibile prima di spostare il resto del traffico.
How can I keep an integration stable as models and prices change?
Mantieni ID modello, impostazioni dell’endpoint e assunzioni di prezzo in configurazione. Registra il modello e la data con i risultati di valutazione, monitora gli avvisi di deprecazione e riesegui task rappresentativi prima di cambiare modello. Imposta avvisi di budget e rivedi le tariffe promozionali prima delle date di fine. Mantieni un fallback testato per i carichi essenziali invece di presumere che una quota gratuita o un particolare alias di modello rimangano disponibili a tempo indeterminato.
Conclusion
Il livello gratuito della Gemini API è un modo utile per convalidare un’applicazione prima di pagare per la capacità. Scegli un modello per il task, misura la quota disponibile per il tuo progetto e verifica i termini sui dati prima di usare input di produzione.
Per un primo esperimento, invia una piccola richiesta e confermala in AI Studio. Quindi misura un carico di lavoro rappresentativo. Se la capacità gratuita diventa il vincolo, confronta l’API a pagamento di Google con CometAPI usando gli stessi prompt, i requisiti di qualità e i costi per token completi.
Modello
ID modello
Un uso pratico iniziale
Gemini 3.8 Flash
gemini-3.8-flash
Coding complesso, reasoning e workflow guidati da tool
Gemini 3.6 Flash
gemini-3.6-flash
Applicazioni Flash esistenti e automazione generale
Gemini 3.5 Flash-Lite
gemini-3.5-flash-lite
Parsing di documenti e attività leggere per agent
Gemini 3.1 Flash-Lite
gemini-3.1-flash-lite
Classificazione, traduzione ed estrazione semplice
Modello
Input/output gratuiti Google
Input / output a pagamento Google
Input / output CometAPI
Gemini 3.8 Flash
Free
$0.75 / $3.75
$0.60 / $3.00
Gemini 3.6 Flash
Free
$0.75 / $3.75
$0.60 / $3.00
Gemini 3.5 Flash-Lite
Free
$0.30 / $2.50
Verifica il preventivo attuale nel catalogo
Gemini 3.1 Flash-Lite
Free
$0.25 / $1.50
$0.20 / $1.20
Gemini 4 Argon
Not available
$2.00 / $10.00
$1.60 / $8.00
Gemini API livello gratuito 2026: modelli gratuiti, limiti e guida ai prezzi - CometAPI