
TL;DR
GLM-5.3 Flash è la scelta predefinita migliore per la maggior parte dei carichi di produzione: aggiunge input visivi nativi e una finestra di contesto da 1M token, mentre il suo prezzo di listino standard è drasticamente inferiore. GLM-5.3 resta la scelta più solida quando profondità di coding massima, ragionamento su orizzonti lunghi o prestazioni in cybersecurity contano più del costo unitario.
Non è una contrapposizione tra modello piccolo e modello grande. Flash è un MoE da 320B totali/18B attivi, addestrato da una nuova base multimodale con attenzione ibrida sparsa e lineare. Il modello di punta è un MoE da 744B totali/40B attivi i cui progressi in GLM-5.3 derivano da post-training su scala sulla base GLM-5.2.
Punti chiave
- Scegli Flash per coding multimodale, comprensione di documenti, agenti per browser o GUI, automazione ad alto volume e applicazioni sensibili ai costi.
- Scegli il modello di punta per i compiti ingegneristici più difficili a livello di repository, ragionamento profondo assistito da strumenti e ricerca sulla sicurezza difensiva.
- Entrambi i modelli supportano contesto da 1M token, ragionamento sempre attivo, function calling, streaming e distribuzione con pesi open.
- Su benchmark riportati da Z.ai, il modello di punta guida DeepSWE, NL2Repo, HLE con strumenti e Agents’ Last Exam; Flash guida AutomationBench, Toolathlon e GDPval-AA v2.
- Test indipendenti assegnano al modello di punta un Intelligence Index più alto e output più veloce, mentre Flash ha un tempo al primo token leggermente migliore e un costo misto molto più basso.
GLM-5.3 Flash vs GLM-5.3 a colpo d’occhio
| Dimensione | GLM-5.3 Flash | GLM-5.3 | Risultato pratico |
|---|---|---|---|
| Posizionamento | Modello efficiente nativamente multimodale per coding e agenti | Modello di punta per ragionamento testuale, coding, agenti a lungo orizzonte, cybersecurity | Dipende dal carico di lavoro |
| Dimensione del modello | 320B totali / 18B attivi | 744B totali / 40B attivi | Flash attiva il 55% di parametri in meno |
| Modello di base | Nuova base multimodale addestrata su 30T token | Stessa base di GLM-5.2; i miglioramenti derivano dal post-training | Percorsi di sviluppo diversi |
| Input / output | Input testuali + visivi / output testuale | Input testuali / output testuale | Flash per i flussi di lavoro visivi |
| Contesto / output max | 1M / 128K | 1M / 128K | Parità |
| Sforzo di ragionamento | basso, alto, massimo; ragionamento sempre attivato | basso, alto, massimo; ragionamento sempre attivato | Parità |
| Indice di Intelligenza indipendente | 57 | 60 allo sforzo massimo | GLM-5.3 |
| Velocità di output indipendente | 50.2 token/s | 76.6 token/s | GLM-5.3 nell’API testata |
| Prezzo di listino ufficiale input/output | $0.15 / $0.50 per 1M token | $1.40 / $4.40 per 1M token | Flash |
| Corrispondenza ideale | Instradamento predefinito, agenti multimodali, scala | Compiti testuali e di sicurezza più complessi e critici | Usare instradamento selettivo |
Fonti: documentazione del modello Z.ai e confronto di Artificial Analysis.
Che cos’è GLM-5.3 Flash?
Z.ai presenta Flash come il primo modello nativamente multimodale della serie GLM-5. Ha 320B parametri totali e 18B attivi, ma “Flash” non va inteso come “piccolo”. Il checkpoint completo resta un modello molto grande; l’efficienza deriva dall’attivazione di un sottoinsieme di esperti e dalla riprogettazione dello stack di attenzione.
Il modello di base è stato addestrato su un corpus multimodale da 30 trilioni di token. La visione nativa è integrata nel ciclo di coding, consentendo al modello di ispezionare screenshot, interfacce renderizzate, grafici, impaginazioni e altri feedback visivi prima di affinare l’azione successiva.
Specifiche di GLM-5.3 Flash
| Specifica | GLM-5.3 Flash |
|---|---|
| Sviluppatore | Z.ai / Zhipu AI |
| ID modello | glm-5.3-flash |
| Tipo di modello | Mixture-of-Experts multimodale nativo |
| Parametri totali / attivi | 320B / 18B |
| Livelli | 45 |
| Architettura | Attenzione sparsa ibrida + attenzione lineare; mHC; MTP |
| Corpus di addestramento | Corpus di pre-training multimodale da 30T token |
| Modalità di input | Input testuali e visivi, incluse immagini e workflow video/file supportati |
| Modalità di output | Testo |
| Contesto / output massimo | 1M / 128K token |
| Ragionamento | Sempre attivato; sforzo basso, alto, massimo |
| Strumenti | Function calling, chiamate a strumenti in streaming, workflow strutturati |
| Pesi / licenza | Pesi open; Apache-2.0 nel repository ufficiale |
Fonti: documentazione di Flash di Z.ai e repository ufficiale GLM-5.
Che cos’è GLM-5.3?
Il modello di punta è ottimizzato per ingegneria software complessa, agenti su orizzonti lunghi e cybersecurity. Z.ai afferma che usa la stessa base di GLM-5.2; l’aggiornamento deriva dal post-training su scala piuttosto che da un nuovo pre-training.
Il repository ufficiale indica il checkpoint con 744B parametri totali e 40B attivi. Rispetto a Flash, attiva oltre il doppio dei parametri per token e alloca più capacità al ragionamento multi-step difficile.
Specifiche di GLM-5.3
| Specifica | GLM-5.3 |
|---|---|
| Sviluppatore | Z.ai / Zhipu AI |
| ID modello | glm-5.3 |
| Tipo di modello | Modello di punta Mixture-of-Experts testuale |
| Parametri totali / attivi | 744B / 40B |
| Modello di base | Base GLM-5.2; tutti i progressi di GLM-5.3 da post-training |
| Input / output | Testo / testo |
| Contesto / output massimo | 1M / 128K token |
| Ragionamento | Sempre attivato; sforzo basso, alto, massimo |
| Strumenti | Function calling, chiamate a strumenti in streaming, cache del contesto, output strutturato |
| Focus principale | Coding complesso, agenti a lungo orizzonte, ingegneria, cybersecurity |
| Pesi / licenza | Pesi open sotto l’apposita licenza GLM-5.3; codice del repository di supporto sotto Apache-2.0 |
Fonti: documentazione del modello di punta Z.ai e repository ufficiale GLM-5.
Architettura: perché Flash costa meno senza essere piccolo
Flash alterna blocchi di attenzione lineare con blocchi di attenzione sparsa e usa mHC attorno ai componenti di attenzione e MoE. Il meccanismo IndexPool comprime quattro vettori chiave indicizzatori in uno. Z.ai riporta 3.01× di calcolo per layer dell’attenzione in meno e una cache KV per layer 4.44× più piccola rispetto al modello di punta su una sequenza da 1M token.
Questi sono confronti a livello di architettura, non moltiplicatori di latenza end-to-end garantiti. La velocità reale dell’API dipende anche da hardware, quantizzazione, batching, lunghezza del ragionamento, software di serving e carico del provider.
Architettura di attenzione ibrida di GLM-5.3-Flash e confronto di compute/cache per contesto lungo.
Fonte: documentazione ufficiale sull’architettura di Z.ai
Prestazioni nei benchmark: dove ciascun modello eccelle
Il confronto più pulito separa i benchmark riportati dal vendor dalle misurazioni API indipendenti. Anche quando i nomi dei benchmark coincidono, versioni del harness, configurazioni degli strumenti, gestione del contesto e sforzo di ragionamento possono differire. La tabella seguente usa i valori meglio allineati nella valutazione del modello di punta e in quella di Flash, trattando i piccoli scarti come direzionali più che definitivi.
| Benchmark | GLM-5.3 Flash | GLM-5.3 | Punteggio più alto | Cosa misura |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 88.2 | GLM-5.3 | Coding su terminale e agentico |
| DeepSWE v1.1 | 63.4 | 66.9 | GLM-5.3 | Ingegneria del software |
| NL2Repo | 56.3 | 58.0 | GLM-5.3 | Generazione di repository |
| Toolathlon Verified | 78.4 | 73.0 | Flash | Uso degli strumenti |
| AutomationBench | 48.8 | 48.2 | Quasi parità / Flash | Automazione dell’uso del computer |
| Agents’ Last Exam | 26.3 | 28.5 | GLM-5.3 | Ragionamento di agenti a lungo orizzonte |
| HLE with tools | 55.3 | 62.5 | GLM-5.3 | Ragionamento difficile assistito da strumenti |
| GDPval-AA v2 | 1773 Elo | 1769 Elo | Quasi parità / Flash | Lavoro professionale basato sulla conoscenza |
Fonti: valutazione del modello di punta e valutazione di Flash. Confrontare in modo direzionale perché i setup di valutazione possono differire.
Coding e ingegneria dei repository
Il modello di punta ha un tetto prestazionale più alto. Supera Flash di 3.5 punti su DeepSWE e di 1.7 punti su NL2Repo. Su Z.ai Code Bench v1.0, con entrambi i modelli valutati usando Claude Code 2.1.207, il modello di punta raggiunge il 34.5% allo sforzo massimo, mentre Flash arriva al 29.0% — un vantaggio di 5.5 punti.
Flash resta comunque abbastanza competitivo da essere il primo modello testato per manutenzione di repository di routine, generazione di test, debug, refactoring e agenti di coding ad alto volume. Esegui escalation solo per i compiti più difficili o le traiettorie fallite verso il modello di punta.
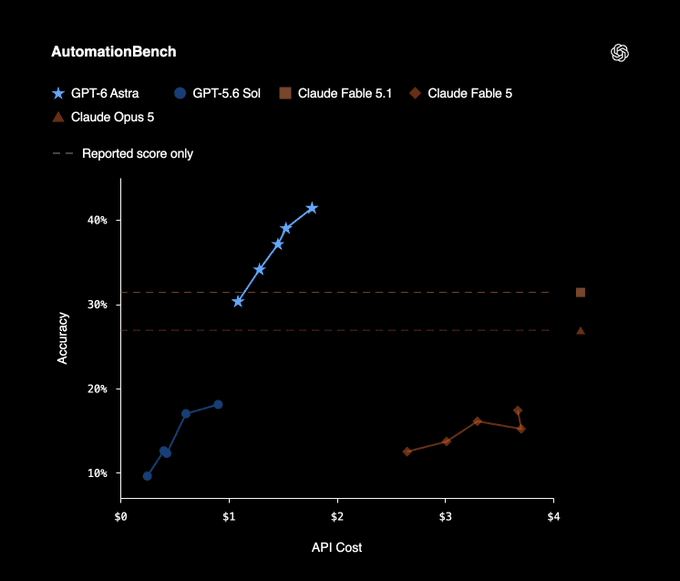
Valutazione a sei benchmark di Z.ai di GLM-5.3-Flash e altri modelli di coding/agent.
Fonte: documentazione ufficiale di Flash di Z.ai
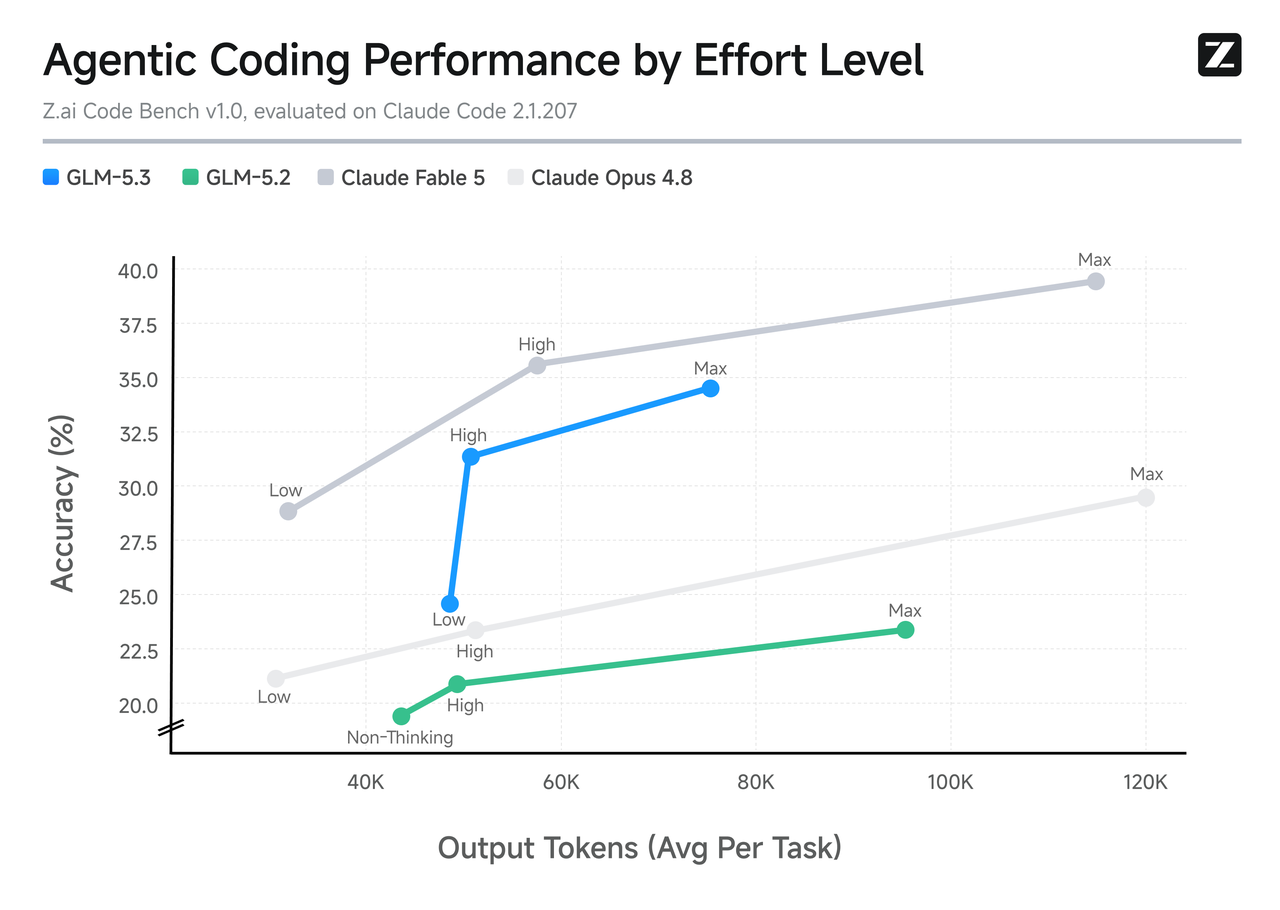
Accuratezza del coding agentico e utilizzo di token di output di GLM-5.3 ai vari livelli di sforzo di ragionamento.
Fonte: documentazione ufficiale del modello di punta
Uso degli strumenti, automazione e knowledge work
Flash non è uniformemente più debole. Ottiene 78.4 su Toolathlon Verified contro 73.0 del modello di punta, e supera di misura AutomationBench 48.8 a 48.2. È sostanzialmente in parità su GDPval-AA v2. Questo rende Flash particolarmente interessante quando il compito riguarda meno una singola catena di ragionamento estremamente difficile e più il coordinamento affidabile di strumenti su molte richieste economiche.
Intelligenza, velocità e latenza indipendenti
| Misurazione indipendente | GLM-5.3 Flash | GLM-5.3 (max) | Risultato |
|---|---|---|---|
| Artificial Analysis Intelligence Index | 57 | 60 | GLM-5.3 |
| Velocità di output | 50.2 token/s | 76.6 token/s | GLM-5.3 |
| Tempo al primo token | 1.49 s | 1.61 s | Flash |
| Finestra di contesto | 1M | 1M | Parità |
| Prezzo misto nel confronto AA | $0.10 / 1M token | $0.90 / 1M token | Flash |
Fonte: confronto API abbinato di Artificial Analysis.
Il risultato indipendente aggiunge una correzione importante all’assunzione “Flash significa più veloce”. Flash risponde leggermente prima, ma l’endpoint del modello di punta testato genera token più velocemente una volta iniziato l’output. Tratta queste misure come istantanee specifiche del provider, non come proprietà immutabili del modello.
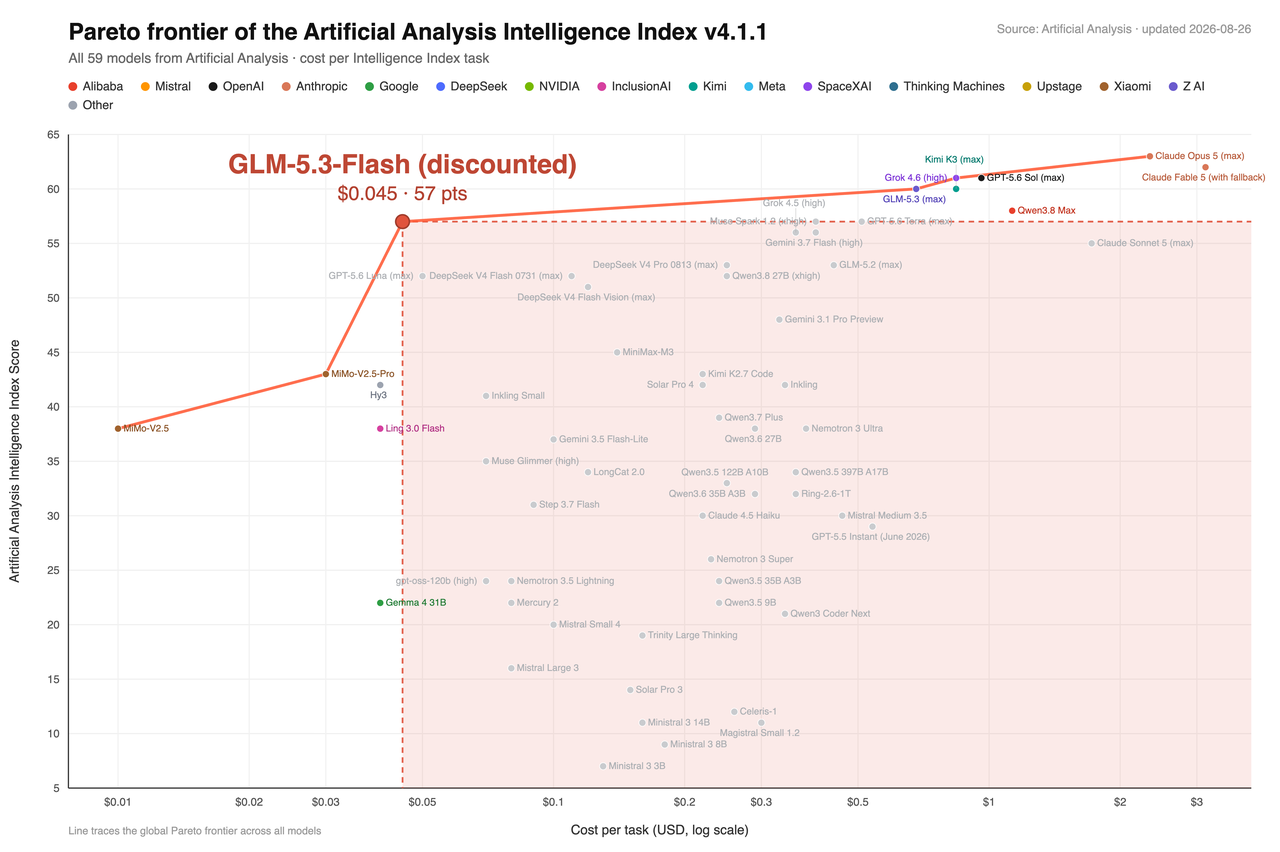
Frontiera costo–intelligenza di Artificial Analysis riprodotta nella documentazione ufficiale di Flash di Z.ai.
Fonte: documentazione ufficiale di Flash di Z.ai
Multimodalità: Flash ha un vantaggio netto
Flash accetta input visivi e li integra nei flussi agentici. Può ispezionare screenshot, immagini di pagine, grafici, stati di interfaccia, registrazioni schermo e file supportati, quindi usare le evidenze visive durante il coding o l’uso degli strumenti. Il modello di punta attualmente supporta solo input testuali.
- Frontend e design-to-code: Flash può ispezionare uno screenshot di riferimento e convalidare l’implementazione renderizzata.
- Workflow su documenti e Office: Flash può ragionare su struttura di pagina, grafici, layout e posizionamento delle immagini.
- Uso del browser e del computer: Flash può combinare stato visivo con chiamate a strumenti e correzioni iterative.
- Lavoro su repository solo testo: il modello di punta rimane preferibile quando l’input è codice e testo e il compito richiede massimo approfondimento nel ragionamento.
Contesto lungo e controlli del ragionamento
GLM-5.3 Flash supporta una finestra di contesto da 1M token e fino a 128K token di output; GLM-5.3 offre gli stessi limiti. Entrambi mantengono il ragionamento attivato e accettano sforzi basso, alto e massimo. Z.ai consiglia “max” per coding difficile e riproduzione di benchmark.
La capacità di contesto non è quindi il principale elemento distintivo. La differenza sta in quanto ciascun modello serve economicamente sequenze lunghe e in quanta capacità di ragionamento può portare ai compiti più ardui. Flash è architetturalmente più economico sul contesto lungo; il modello di punta ha un tetto qualitativo più alto.
Cybersecurity: GLM-5.3 è lo specialista
La cybersecurity è la capacità più distintiva del modello di punta. Z.ai riporta 84.5 su CyberGym e 54.4 su ExploitBench. Con budget normalizzati di due e sei ore, ha completato 105 e 130 task di ExploitGym.
Flash non ha un’enfasi di lancio equivalente né una suite cyber pubblica corrispondente. Per code review, sviluppo sicuro e scoperta autorizzata di vulnerabilità, usa il modello di punta come modello primario e mantieni nel workflow approvazione umana, strumenti isolati, log di audit e controlli di disclosure.
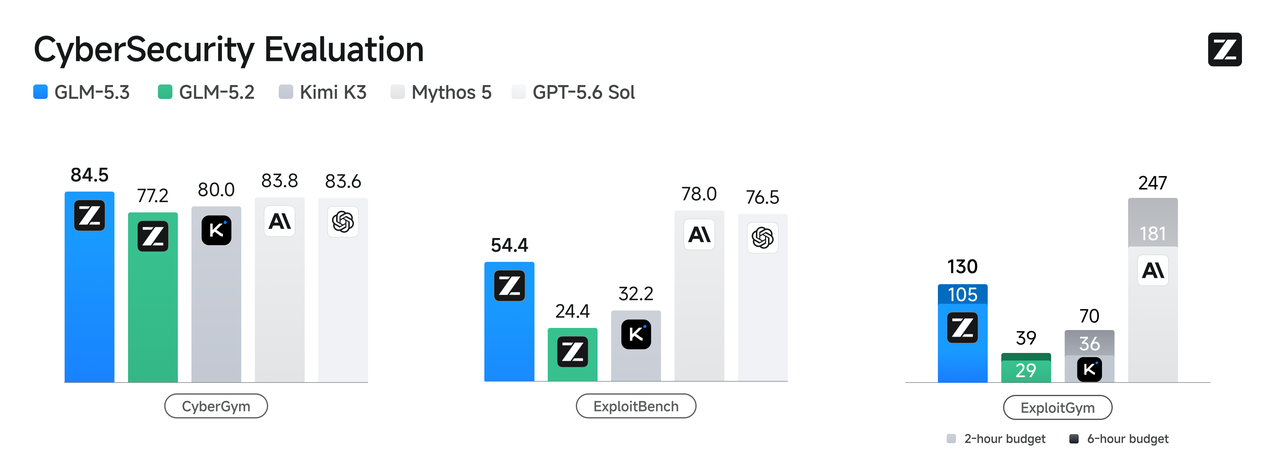
Prestazioni di GLM-5.3 su benchmark di scoperta di vulnerabilità e catene di exploit.
Fonte: documentazione ufficiale di cybersecurity di Z.ai
Costo e distribuzione
Prezzi API
Z.ai prezza Flash a $0.15 per milione di token in input e $0.50 per milione di token in output prima delle promozioni, rispetto a $1.40 e $4.40 per il modello di punta.
| Metodo di accesso | Flash input | Flash (in cache) | Flash output | 5.3 input | 5.3 (in cache) | 5.3 output |
|---|---|---|---|---|---|---|
| Listino standard Z.ai | $0.15 | $0.03 | $0.50 | $1.40 | $0.26 | $4.40 |
| Tariffa promozionale Z.ai per Flash | $0.075 | $0.015 | $0.25 | $1.40 | $0.26 | $4.40 |
| Percorso CometAPI | $0.06 | Verifica in tempo reale | $0.20 | $1.12 | Verifica in tempo reale | $3.528 |
I prezzi sono in USD per 1M token. Fonti: pricing Z.ai, route Flash e route GLM-5.3. Le promozioni possono cambiare.
Esempio di costo mensile
Per un carico che usa 100M token in input e 20M token in output, le tariffe CometAPI attuali producono una stima di $10.00 per Flash contro $182.56 per il modello di punta, prima degli effetti della cache o dei costi degli strumenti. In questo esempio, Flash riduce la spesa in token di circa il 94.5%.
| Componente di costo | GLM-5.3 Flash | GLM-5.3 |
|---|---|---|
| Costo input | 100 × $0.06 = $6.00 | 100 × $1.12 = $112.00 |
| Costo output | 20 × $0.20 = $4.00 | 20 × $3.528 = $70.56 |
| Totale | $10.00 | $182.56 |
Pesi open e self-hosting
Entrambi i modelli hanno checkpoint FP8 e BF16 scaricabili. I pesi di GLM-5.3 Flash sono rilasciati con licenza MIT. GLM-5.3 usa la licenza GLM-5.3, che richiede una revisione di sicurezza prima dell’uso commerciale da parte di operatori Model-as-a-Service con ricavi aggregati superiori a US$10 miliardi in qualsiasi periodo consecutivo di 12 mesi. Il repository GLM-5 su GitHub è sotto licenza Apache-2.0.
Flash è più facile da servire del modello di punta, ma non è un modello da GPU consumer. Il checkpoint da 320B, i componenti multimodali, la cache KV e il contesto da 1M richiedono comunque infrastruttura seria. Il self-hosting è più attraente quando controllo dei dati, serving personalizzato o utilizzo sostenuto elevato giustificano il costo operativo.
Quale modello dovresti scegliere?
Scegli GLM-5.3 Flash se:
- Ti servono comprensione di immagini, screenshot, grafici, documenti, browser o GUI.
- Esegui agenti di coding ad alto volume, workflow di ricerca o automazione aziendale.
- Vuoi ottime prestazioni su uso degli strumenti e knowledge work al minimo costo per token.
- Ti serve una finestra di contesto da 1M token senza economie da modello di punta per ogni richiesta.
- Prevedi il self-hosting e 320B/18B è più pratico di 744B/40B.
Scegli GLM-5.3 se:
- Stai affrontando i compiti di coding più difficili su scala repository o ingegneria a lungo orizzonte.
- La tua valutazione premia il ragionamento più profondo più che il basso costo unitario.
- Ti serve il risultato migliore su DeepSWE, HLE con strumenti o Agents’ Last Exam.
- Stai costruendo workflow autorizzati di sicurezza difensiva o scoperta di vulnerabilità.
- Un tasso di successo più alto può compensare un premio di prezzo per token di circa un ordine di grandezza.
Matrice decisionale per caso d’uso
| Carico di lavoro | Modello iniziale consigliato | Perché |
|---|---|---|
| Chat e automazione ad alto volume | GLM-5.3 Flash | Costo molto più basso; uso degli strumenti solido |
| Coding visivo e debug dell’interfaccia | GLM-5.3 Flash | Input visivo nativo |
| Analisi di documenti, grafici e Office | GLM-5.3 Flash | Workflow professionali multimodali |
| Manutenzione di repository di routine | Inizia con Flash | Esegui escalation dei compiti falliti o insolitamente difficili |
| Ingegneria a scala repository difficile | GLM-5.3 | Tetto di coding più alto |
| Ricerca a lungo orizzonte con strumenti | GLM-5.3 | Risultato migliore su HLE con strumenti |
| Sicurezza difensiva e scoperta di vulnerabilità | GLM-5.3 | Training e benchmark cyber dedicati |
| Self-hosting sensibile ai costi | GLM-5.3 Flash | Ingombro attivo e totale più contenuto |
| Carico misto incerto | Instradamento ibrido | Flash predefinito; escalation al modello di punta |
Una strategia di produzione migliore: instradare, non sostituire
Per la maggior parte dei team, la soluzione più robusta non è una scelta esclusiva. Usa Flash come route predefinita, poi esegui escalation solo dei compiti con alta complessità, validazione fallita, sensibilità alla sicurezza o valore economico atteso tale da giustificare il premio del modello di punta.
- Invia a Flash i compiti visivi, di routine e ad alto volume.
- Misura tasso di accettazione, token, latenza, errori degli strumenti e interventi umani.
- Esegui escalation dei compiti testuali falliti o ad alto rischio al modello di punta.
- Instrada il lavoro sensibile alla sicurezza tramite controlli di autorizzazione e sandbox aggiuntivi.
- Ottimizza per costo per risultato accettato, non solo per rank nei benchmark o prezzo.
Come testare entrambi i modelli tramite CometAPI
CometAPI espone la route GLM-5.3 Flash e la route GLM-5.3 dietro la stessa base URL compatibile con OpenAI. Crea una API key, quindi esegui lo stesso compito testuale su entrambi gli ID modello. Per un test equo, mantieni fissi prompt, sforzo di ragionamento, definizioni degli strumenti, output massimo e metrica di accettazione.
Python
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["glm-5.3-flash", "glm-5.3"]

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[
            {
                "role": "user",
                "content": "Esamina questo piano di migrazione e individua le sue tre ipotesi a maggior rischio.",
            }
        ],
    )
    print(model, response.choices[0].message.content)
Per la valutazione multimodale, usa la documentazione live della route Flash per verificare lo schema di contenuto immagine supportato. Il confronto con il modello di punta dovrebbe usare un equivalente solo testuale perché non accetta input visivi.
Limitazioni di questo confronto
- Diversi punteggi di coding e agent provengono dal vendor. La riproduzione indipendente può usare strumenti, prompt e impostazioni d’inferenza differenti.
- Nomi di benchmark corrispondenti non garantiscono sempre versioni identiche del harness o strategie di gestione del contesto.
- Le riduzioni a livello architetturale del compute di attenzione e della cache KV non predicono direttamente la latenza dell’API.
- Prezzi, promozioni, disponibilità dei modelli, limiti di rate e capacità delle route possono cambiare; verifica le pagine live dei modelli prima della distribuzione.
- Pesi open non rendono economico il self-hosting di nessuno dei due checkpoint a contesto pieno.
- La capacità in cybersecurity è dual-use e richiede autorizzazione, sandboxing, logging, revisione di esperti e disclosure responsabile.
Conclusione
GLM-5.3 Flash è la scelta pratica predefinita. Conserva il contesto lungo, aggiunge visione nativa, offre prestazioni solide su uso degli strumenti e lavori professionali e cambia l’economia abbastanza da consentire una distribuzione molto più ampia. GLM-5.3 è il modello di escalation specialistico: più costoso, solo testo, ma più forte sui compiti di coding, ragionamento e cybersecurity più difficili.
Il verdetto finale è quindi basato sul carico di lavoro: parti da Flash, misura il tasso reale di accettazione e instrada al modello di punta solo quando la sua capacità di ragionamento extra produce abbastanza esiti aggiuntivi di successo da giustificare il premio.
Domande frequenti
GLM-5.3 Flash è migliore di GLM-5.3?
Non universalmente. Flash è migliore per prezzo, multimodalità e diversi benchmark di strumenti/automazione. Il modello di punta è più forte sui compiti più difficili di coding, ragionamento assistito da strumenti e cybersecurity.
GLM-5.3 Flash è un modello piccolo?
No. Ha 320B parametri totali e ne attiva 18B per token. È più efficiente del modello di punta 744B/40B, ma richiede comunque hardware sostanziale per il self-hosting.
Quale modello è più economico?
Flash è drasticamente più economico. Il prezzo di listino standard di Z.ai è circa un decimo di quello del modello di punta, e gli attuali percorsi CometAPI mostrano un divario ancora maggiore durante la promozione.
Quale modello è più veloce?
Dipende da metrica e provider. Artificial Analysis ha misurato un tempo al primo token leggermente inferiore per Flash ma una velocità di output più alta per il modello di punta.
Quale modello supporta le immagini?
Flash supporta input visivi nativi. Il modello di punta attualmente supporta solo input testuali.
Entrambi i modelli supportano un contesto da 1M token?
Sì. Flash supporta 1M di contesto e fino a 128K di output; il modello di punta offre gli stessi limiti.
Quale modello è migliore per il coding?
Usa Flash per agenti di coding di routine e ad alto volume. Usa il modello di punta per i compiti ingegneristici più difficili su scala repository o quando il costo del fallimento supera la differenza di prezzo.
Quale modello è migliore per la cybersecurity?
Il modello di punta. Z.ai lo ha addestrato e valutato specificamente per la scoperta di vulnerabilità e il ragionamento sulle catene di exploit. Usalo solo in ambienti autorizzati e controllati.
Entrambi i modelli possono essere self-hosted?
Sì. Il repository di Z.ai elenca checkpoint scaricabili e framework di serving supportati, ma entrambi restano progetti infrastrutturali di grande portata.
Qual è la migliore strategia di distribuzione?
Usa Flash come route predefinita ed esegui escalation dei compiti testuali difficili, falliti o sensibili alla sicurezza al modello di punta. Misura il costo per risultato accettato.