Crea con CometAPITi serve una sola API per più modelli?Testa il flusso di lavoro in Playground, poi crea una chiave API quando modello e costo sono adatti al tuo caso d'uso.
GPT-6.1 Terra contro DeepSeek V4.1 Flash: Benchmark, Caratteristiche, Prezzi
Confronta GPT-6.1 Terra e DeepSeek V4.1 Flash su benchmark, programmazione, visione, contesto, prezzi dell’API e accesso a CometAPI, per determinare quale sia migliore.
TL;DR: GPT-6.1 Terra è il punto di partenza più solido quando la qualità del ragionamento e i workflow visivi complessi contano di più; DeepSeek V4.1 Flash è interessante quando la priorità è il costo per token, la velocità di generazione o il self-hosting. Questo confronto utilizza l’aggiornamento DeepSeek del 17 ottobre, Flash-1017.
DeepSeek Flash-1017 ha prezzi per token più bassi, ma il costo di un’attività completata dipende anche dalla lunghezza del ragionamento, dai retry e dalle chiamate agli strumenti.
Il confronto qui sotto copre architettura, contesto, ragionamento, coding, visione, velocità, prezzi e deployment. I prezzi e le pagine di valutazione live sono stati verificati il 28 ottobre 2026.
Punti chiave
Terra guida il confronto indipendente citato dell’Intelligence Index, rendendolo il primo candidato logico per task che richiedono ragionamento impegnativo.
DeepSeek ha prezzi elencati per token inferiori. Confronta latenza end-to-end e costo per task riuscito, includendo tariffe nelle ore di punta, uso della cache, token di ragionamento e retry.
Revisionato per chiarezza, attribuzione delle fonti e terminologia API aggiornata.
Valuta il coding dai patch accettati e i workflow visivi dai task completati. I punteggi dei benchmark pubblicati forniscono prove utili, ma i setup di test differiscono.
Terra è un modello proprietario ospitato. DeepSeek offre pesi scaricabili con licenza MIT per il self-hosting, considerando i costi hardware e operativi.
CometAPI fornisce un’interfaccia testuale condivisa per testare entrambi i modelli. Verifica la versione del modello effettivamente servita e il supporto per tool, controlli di ragionamento e output strutturato prima del deployment.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: panoramica e specifiche
Le principali differenze di specifiche riguardano limiti di output, controlli del ragionamento, chiamata di strumenti e deployment. La tabella seguente riassume i due modelli.
Architettura proprietaria; numero di parametri non divulgato
552B Encoder–Decoder causale MoE; circa 8B di parametri attivi in input e 16B in output
Finestra di contesto
1,050,000 token
1M token
Output massimo
128,000 token
384K token
Modalità di input
Testo, immagini
Testo, immagini
Modalità di output
Testo
Testo
Controlli del ragionamento
none, low, medium, high, xhigh, max
Interruttore Thinking; low, high, max in Chat Completions
Invocazione degli strumenti
Supportata tramite Responses API
Supportata; il comportamento dipende dall’endpoint e dalla modalità di ragionamento
Pesi aperti
No
Sì, licenza MIT
Architettura e versioni del modello
Terra utilizza un’architettura proprietaria il cui numero di parametri non è divulgato pubblicamente. DeepSeek-V4.1-Flash utilizza un’architettura Encoder–Decoder causale MoE, con budget di parametri attivi differenti per l’elaborazione dell’input e la generazione dell’output.
La release V4.1 Flash di DeepSeek descrive un backbone MoE Encoder–Decoder causale da 552B parametri, con circa 8B di parametri attivi durante l’elaborazione dell’input e 16B durante la generazione dell’output. L’aggiornamento del 17 ottobre migliora i risultati pubblicati su coding, agent e visione.
In tutto l’articolo, Flash-1017 indica quel checkpoint di ottobre. Un alias API generico può in seguito indirizzare a un’altra versione, quindi un record di valutazione dovrebbe includere la versione del modello effettivamente servita.
KV-cache e requisiti di deployment
DeepSeek riporta un’impronta globale di KV-cache di circa 890 byte per token, circa un quarto di quella di DeepSeek-V4-Flash. Questo migliora l’efficienza della cache, sebbene il self-hosting richieda comunque risorse sostanziali per i pesi del modello. Terra è disponibile tramite servizi ospitati, mentre i pesi scaricabili di DeepSeek offrono un’opzione aggiuntiva di self-hosting.
Controlli di ragionamento e invocazione degli strumenti
Entrambi i modelli supportano workflow agent, ma i controlli di ragionamento e i requisiti di invocazione degli strumenti differiscono. Il supporto per tool-calling documentato di Terra utilizza la Responses API. La scheda del modello di DeepSeek descrive un effort numerico di ragionamento da 1 a 100; i controlli dell’API ospitata vanno verificati separatamente. Quando si cambia modello, adatta i parametri di ragionamento e le definizioni degli strumenti all’endpoint selezionato.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: prestazioni
Il confronto seguente copre ragionamento, coding, visione e task a contesto lungo. Le valutazioni indipendenti e i benchmark riportati dai vendor sono identificati separatamente, con risultati interpretati insieme alle loro configurazioni di modello e framework agent.
Ragionamento e conoscenza
Artificial Analysis riporta un punteggio Intelligence Index v5.0 di 51 per GPT-6.1 Terra (Max) e di 32 per DeepSeek Flash-1017 (Max) nelle configurazioni citate, al 28 ottobre 2026. L’indice combina nove valutazioni.
Il punteggio aggregato più alto di Terra supporta la sua prova prioritaria per task di ragionamento impegnativi. Per carichi più ristretti, DeepSeek può comunque essere la scelta migliore se soddisfa l’accuratezza richiesta a un costo per task riuscito inferiore.
Benchmark ufficiali di coding e agent
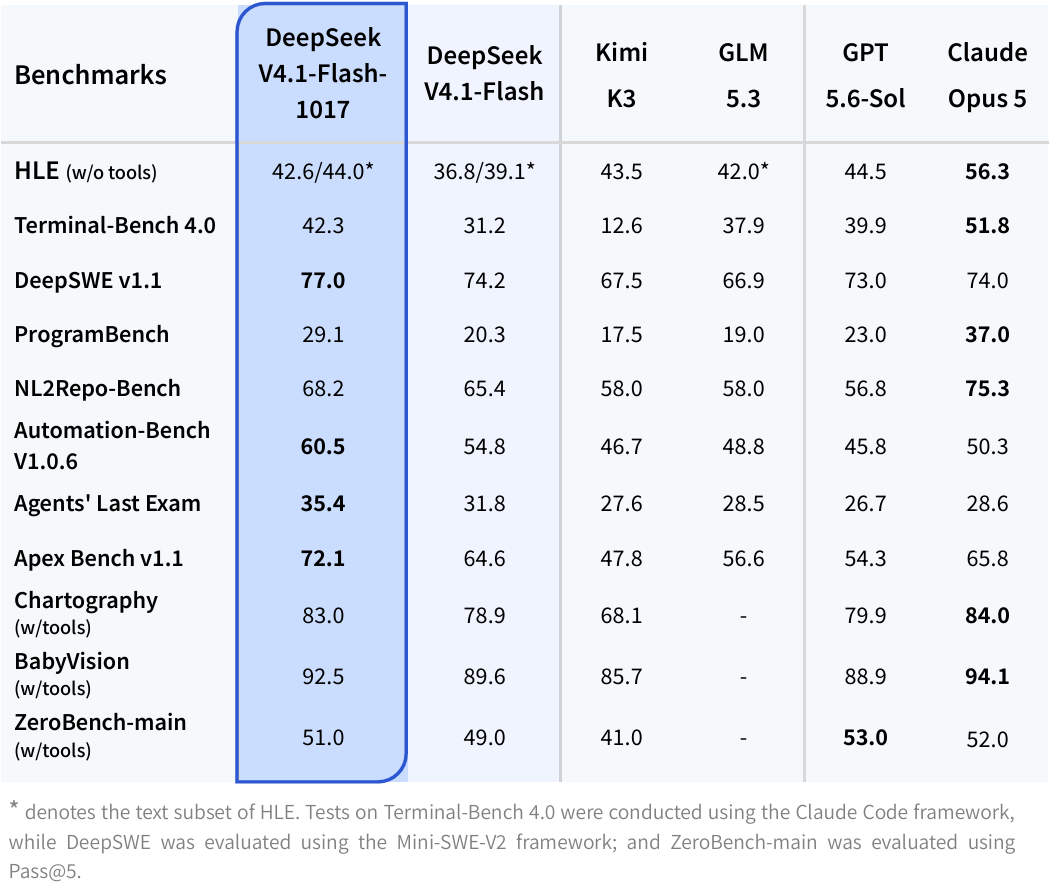
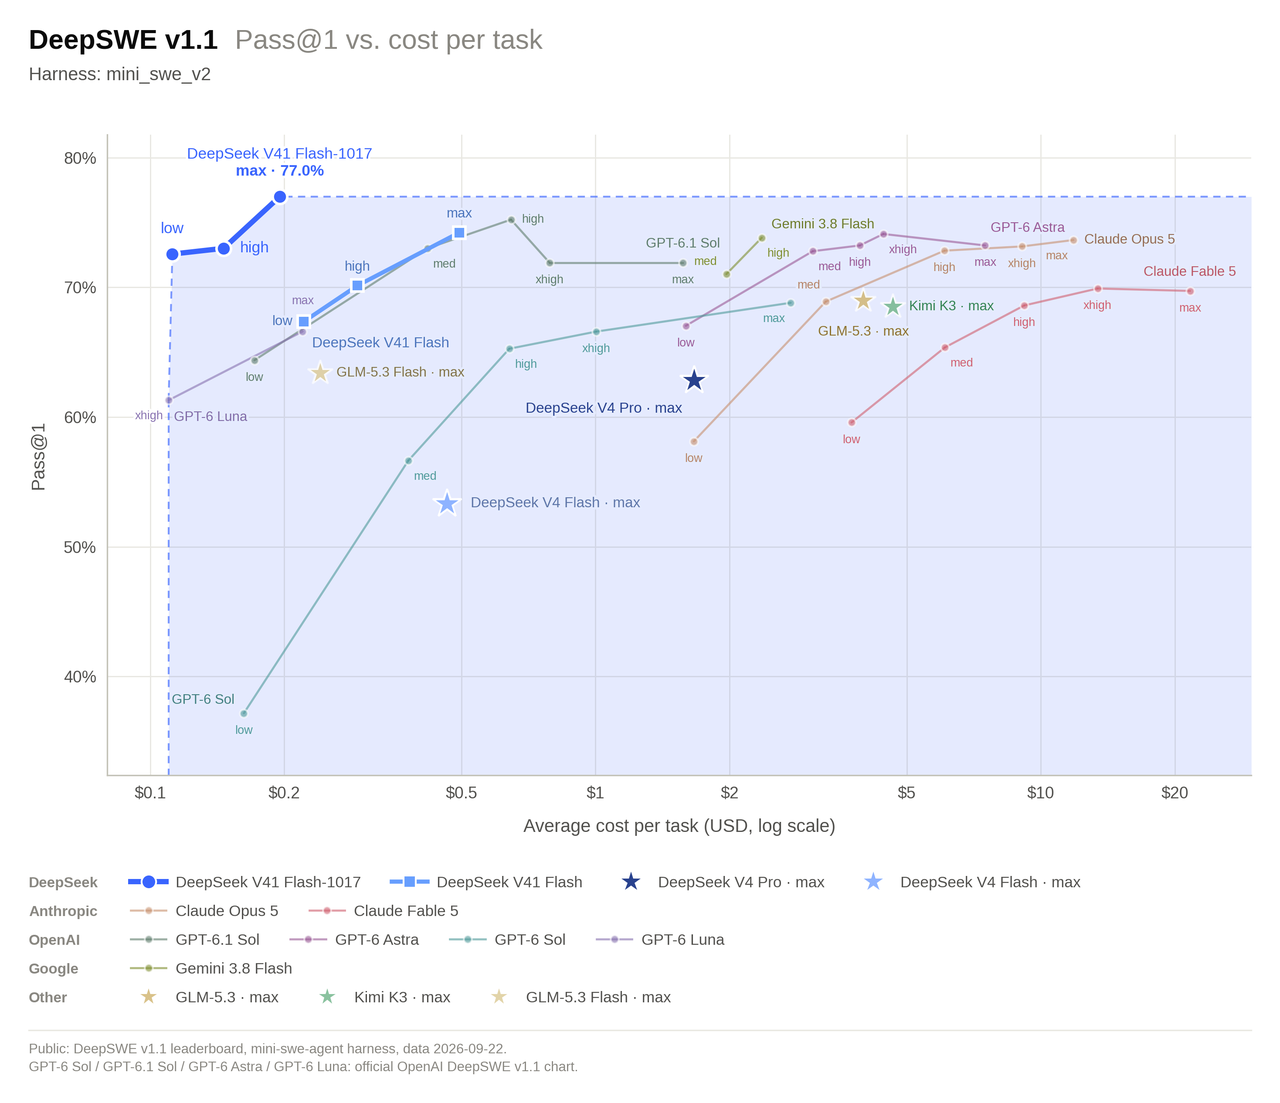
Terminal-Bench 4.0 e DeepSWE v1.1 forniscono evidenze su prestazioni di coding e agent. Confrontando i risultati dei vendor, identifica la versione esatta del modello, l’impostazione di ragionamento, il framework agent e la metrica di scoring; differenze in queste impostazioni possono influire materialmente sui punteggi.
Per il lavoro di coding pratico, confronta se ciascun modello produce patch che passano i test esistenti, preservano le interfacce pubbliche, gestiscono i casi limite e evitano modifiche non correlate. L’affidabilità delle chiamate agli strumenti e il recupero dagli errori di esecuzione influiscono anche sulla quantità di lavoro che un agent può completare.
I prezzi per token inferiori di DeepSeek lo rendono un candidato utile per la manutenzione ripetitiva dei repository con criteri di accettazione chiari. Per modifiche complesse, confronta entrambi i modelli su patch accettati, costo totale del task e tempo di correzione umana.
Visione e uso del computer
Entrambi i modelli accettano input di immagini, ma la comprensione delle immagini e l’interazione desktop richiedono capacità diverse. Il materiale di lancio di Terra discute MMMU-Pro e OSWorld 2.1, mentre la scheda del modello di DeepSeek riporta task visivi inclusi Chartography e BabyVision, con impostazioni assistite da strumenti.
Per l’estrazione di documenti, confronta accuratezza dei campi, testo mancante e struttura delle tabelle. Per l’automazione desktop, confronta workflow completati, azioni errate e recupero dopo modifiche dell’interfaccia. Un modello che descrive accuratamente uno screenshot può comunque faticare a operare l’applicazione mostrata.
Scegli in base al workflow: l’accuratezza di estrazione conta di più per l’elaborazione di documenti, mentre azioni affidabili e recupero contano di più per agent di uso del computer. Confronta i costi solo dopo che entrambi i modelli raggiungono la soglia di qualità richiesta.
Ragionamento a contesto lungo e retrieval
Entrambi i modelli supportano workflow su documenti lunghi, ma la capacità di contesto da sola non determina la qualità del retrieval. Confrontali sulla stessa raccolta di documenti, posizionando prove importanti all’inizio, al centro e alla fine.
Valuta accuratezza delle risposte, passaggi di supporto, coerenza tra documenti e completezza delle risposte. Per ricerca e analisi documentale, preferisci il modello che recupera e collega in modo affidabile le evidenze rilevanti entro i tuoi requisiti di latenza e costo.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: velocità
Throughput di output e tempo di completamento del task
La latenza merita un trattamento separato dalla qualità del ragionamento.
Un modello che genera token più velocemente può comunque impiegare più tempo a finire se produce più ragionamento, attende strumenti o effettua retry. Misura separatamente il tempo al primo token, il tempo totale di completamento e la latenza del task accettato.
Latenza interattiva sul tuo percorso API
Per un prodotto interattivo, testa prompt brevi e lunghi a una concorrenza realistica e registra latenza mediana e al 95° percentile. Mantieni in risultati regione, percorso API, caching del prompt, impostazioni di ragionamento e policy di retry. Quel record ti dirà più dell’esperienza utente rispetto a una singola cifra di token al secondo.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: costi
Il pricing è una delle differenze più nette tra questi modelli.
Il listino di Terra e la policy dei prezzi di DeepSeek forniscono le seguenti tariffe first-party, verificate il 28 ottobre 2026. Tutti i prezzi sono in dollari USA per milione di token.
Tariffe API ufficiali
Categoria di token
GPT-6.1 Terra Standard
DeepSeek Flash off-peak
DeepSeek Flash peak
Input, cache miss
$1.00
$0.15
$0.30
Input, cache hit
$0.05
$0.003
$0.006
Output
$5.00
$0.60
$1.20
Il pricing di picco di DeepSeek si applica da lunedì a venerdì, 01:00–04:00 e 06:00–10:00 UTC, escludendo le festività pubbliche cinesi. Ciò corrisponde a 09:00–12:00 e 14:00–18:00 in China Standard Time (UTC+8). Gli altri periodi utilizzano le tariffe off-peak.
Per richieste Terra oltre 272,000 token di input, OpenAI specifica tariffe di input e input in cache pari a 2× e tariffe di output pari a 1,5× per l’intera richiesta. Confronta tali condizioni con le dimensioni effettive dei tuoi prompt prima di considerare il prezzo base come prezzo effettivo.
Tariffe CometAPI
Tariffa base CometAPI per 1M token
GPT-6.1 Terra API
DeepSeek V4.1 Flash API
Input non in cache
$0.80
$0.12
Output
$4.00
$0.48
Input in cache
Non specificato separatamente
$0.0024
Moltiplicatore basato sul tempo
Non specificato nel pricing base
2× durante le finestre di picco elencate
CometAPI elenca le finestre di picco di DeepSeek come da lunedì a venerdì, 01:00–04:00 e 06:00–10:00 UTC. L’orario elencato non stabilisce la stessa eccezione per le festività come la policy first-party di DeepSeek. Verifica i termini di fatturazione del percorso selezionato per l’orario di esecuzione previsto.
Esempio di costo a token fissi
Considera una richiesta che consuma 100,000 token di input non in cache e genera 10,000 token di output.
Se questi sono i totali di token fatturati completi, l’addebito per token è $0.150 per Terra, $0.021 per DeepSeek off-peak, o $0.042 per DeepSeek a picco. La riduzione off-peak è dell’86%. L’esempio esclude costi aggiuntivi per strumenti, infrastruttura e retry; eventuali token di ragionamento conteggiati separatamente devono entrare anch’essi nel calcolo.
Alle tariffe base elencate da CometAPI, gli stessi 100,000 token di input e 10,000 di output costano $0.120 per Terra o $0.0168 per Flash. Applicando il moltiplicatore 2× per le finestre di picco elencate si ottengono $0.0336 per Flash. Questi sono calcoli solo sui token utilizzando i conteggi indicati, non misurazioni di un task reale.
Quando un output extra annulla il vantaggio di prezzo per token
Mantieni l’input non in cache a 100,000 token e l’output totale fatturato di Terra a 10,000 token. Il conto token standard di Terra è quindi $0.150. Flash raggiunge lo stesso conto a 225,000 token di output fatturati off-peak, o 100,000 a tariffe di picco. Questa aritmetica isola il volume di output; caching, input ripetuti, commissioni per strumenti e retry cambiano il confronto.
Costo per task riuscito
Valuta un batch fisso di task e dividi tutta la spesa fatturata per API e strumenti per il numero di task che superano i tuoi controlli di accettazione. Conta anche la spesa dei tentativi falliti. Riporta il tasso di successo accanto a questo costo, in modo che un modello non venga premiato semplicemente per aver completato solo i lavori più facili.
Costo per task riuscito = Costo totale API e strumenti / Task completati con successo
Quale dovresti scegliere: GPT-6.1 Terra o DeepSeek-V4.1-Flash?
Scegli in base ai requisiti di qualità del task, agli obiettivi di costo e alle esigenze di deployment. Usa i risultati dei benchmark sopra per decidere quale modello testare per primo.
Caso d’uso
Candidato iniziale
Cosa dovrebbe determinare la scelta
Ragionamento impegnativo
GPT-6.1 Terra
Accuratezza e lavoro correttivo su task difficili rappresentativi
Agent di coding
Testare entrambi
Patch accettati, check di regressione, failure degli strumenti e costo totale
Workflow visivi complessi
GPT-6.1 Terra
Workflow completati e recupero dagli errori d’interfaccia
Estrazione di testo o immagini ad alto volume
DeepSeek Flash-1017
Se l’accuratezza di estrazione soddisfa la soglia richiesta
Retrieval su documenti lunghi
Testare entrambi
Retrieval delle evidenze e accuratezza delle risposte in tutte le posizioni di input
Self-hosting
DeepSeek Flash-1017
Hardware disponibile, costi operativi e controllo sui pesi
Applicazioni interattive
Testare entrambi
Latenza mediana e di coda sul percorso provider selezionato
Quando scegliere GPT-6.1 Terra
Dai priorità a Terra per la valutazione quando il ragionamento complesso è centrale nel task. Per workflow visivi o di uso del computer impegnativi, includilo nel set di test e misura task completati, errori e recupero.
La domanda chiave è se Terra riduce i tentativi falliti e le correzioni manuali abbastanza da giustificare il suo prezzo per token più alto.
Quando scegliere DeepSeek-V4.1-Flash
Parti da DeepSeek-V4.1-Flash per task ripetitivi e ad alto volume con criteri di accettazione chiari e obiettivi di costo stretti. Sceglilo se gli output soddisfano i requisiti di qualità a un costo per task riuscito inferiore.
I pesi con licenza MIT di DeepSeek lo rendono anche l’opzione rilevante quando il self-hosting è un requisito. Includi nel calcolo i costi hardware e operativi.
Quando testare entrambi i modelli
Testa entrambi quando qualità del coding, affidabilità degli strumenti, latenza o accuratezza su documenti lunghi sono critici. Usa task rappresentativi con gli stessi input, strumenti, limiti di esecuzione e criteri di accettazione.
Confronta tasso di completamento, costo totale per task riuscito, latenza end-to-end e tempo di correzione umana. Registra la versione del modello e le impostazioni di ragionamento affinché i risultati siano riproducibili.
Un setup ibrido può iniziare task di routine con DeepSeek ed escalare determinati fallimenti a Terra. Misura il costo e il tasso di completamento del workflow completo per confermare che la chiamata extra al modello valga la pena.
Dove puoi accedere a GPT-6.1 Terra e DeepSeek V4.1 Flash?
Usa l’API ospitata di OpenAI per Terra o l’API ospitata di DeepSeek per Flash. Conferma l’identificatore del modello corrente, i limiti dell’account e l’endpoint supportato prima dell’integrazione. I pesi scaricabili di Flash-1017 offrono un’opzione separata per il self-hosting.
Accesso tramite CometAPI
CometAPI fornisce un’interfaccia compatibile con OpenAI che può semplificare lo sviluppo di applicazioni multi-modello.
Usa GPT-6.1 Terra API e DeepSeek V4.1 Flash API con un client testuale condiviso, quindi aggiungi controlli specifici del modello solo dopo aver verificato il supporto del percorso.
Confrontare risposte testuali tramite CometAPI
Per provare entrambi i modelli tramite un unico client testuale, usa l’OpenAI Python SDK con la tua chiave CometAPI e l’endpoint https://api.cometapi.com/v1. Mantieni la chiave in una variabile d’ambiente, quindi invia lo stesso prompt ai percorsi gpt-6.1-terra e deepseek-v4.1-flash e confronta le risposte e l’uso dei token restituiti.
Ad esempio, chiedi a ciascun modello di rivedere un workflow di pagamento che ritenta richieste scadute senza una idempotency key e registra i corpi delle richieste per intero. Confronta quanto chiaramente le risposte identificano rischi di affidabilità e privacy e spiegano correzioni pratiche. Un prompt condiviso facilita l’ispezione delle risposte, ma una richiesta testuale di default non equalizza i budget di ragionamento né stabilisce un ranking di performance. Conferma il checkpoint servito da ciascun percorso prima di considerare un risultato come evidenza su Flash-1017.
Conclusione
GPT-6.1 Terra offre l’attuale risultato aggregato di ragionamento più forte, mentre DeepSeek Flash-1017 combina prezzi per token più bassi, generazione di output più veloce misurata e deployment con pesi aperti. La scelta utile è il modello che soddisfa i tuoi requisiti di qualità e latenza al costo totale più basso.
Inizia con un workload rappresentativo, mantieni costanti l’ambiente degli strumenti e i criteri di accettazione, e confronta il costo dei completamenti riusciti. Un’integrazione testuale condivisa su CometAPI può rendere più facile tale valutazione, mentre le funzionalità specifiche del modello necessitano comunque della propria configurazione.
FAQ
Perché lo stesso task può produrre fatture di token diverse con Terra e Flash-1017?
Un prompt testuale non necessariamente viene tokenizzato nello stesso numero di token in due modelli. Anche le risposte generate e le lunghezze del ragionamento possono differire. Confronta l’uso riportato da ciascun percorso per task identici, includendo token di ragionamento in cache e fatturabili dove riportato, invece di applicare entrambi i listini a un unico conteggio stimato di token.
GPT-6.1 Terra e DeepSeek V4.1 Flash possono condividere una cache dei prompt?
Puoi riutilizzare il testo del prompt nella tua applicazione, ma non dare per scontato che una cache creata per un modello o provider riduca la fattura dell’altro. L’idoneità e la contabilizzazione della cache sono specifiche del percorso. Verifica i campi di utilizzo di ciascuna risposta e testa richieste ripetute prima di integrare i risparmi in una previsione.
Come dovrei convalidare l’output strutturato da Terra e Flash-1017?
Definisci i campi e i tipi richiesti nella tua applicazione prima di scegliere un modello. Se un percorso offre output JSON o vincoli di schema, verifica la modalità esatta supportata, quindi analizza la risposta e validala rispetto al tuo schema. Considera campi mancanti, valori non validi, output troncato e rifiuti come esiti separati. Un JSON valido da solo non stabilisce che i fatti estratti siano corretti.