
TL;DR
Inizia con GPT-6.1 Terra per attività ad alto volume, verificabili e sensibili ai costi. Valuta GPT-6.1 Sol per codice complesso, uso di strumenti in più passaggi e flussi di lavoro in cui gli errori sono costosi. Una impostazione pratica è usare prima Terra ed eseguire l’escalation a Sol quando i test predefiniti o i controlli di validazione falliscono.
Punti chiave
- Prezzi standard dei token: Su OpenAI Standard, Terra costa $1 per milione di token in input e $5 per milione di token in output; Sol costa rispettivamente $2 e $10.
- Prestazioni specifiche per attività: Al massimo sforzo di ragionamento, Terra è leggermente avanti su Agents’ Last Exam v1 e Terminal-Bench-Science 0.1, mentre Sol è in testa su Terminal-Bench 4.0 e OSWorld 2.1.
- Capacità di contesto condivisa: Entrambi i modelli offrono una finestra di contesto da 1,05 milioni di token e accettano input di testo e immagini.
- Controlli di ragionamento diversi: Terra supporta la disattivazione del ragionamento con
none; Sol richiede almeno uno sforzo di ragionamentolow. - Il costo operativo conta: Confronta la spesa per attività completata con successo, includendo ritentativi e chiamate agli strumenti, e traccia separatamente i costi di revisione umana.
GPT-6.1 Terra vs GPT-6.1 Sol: panoramica e specifiche
La panoramica seguente riassume i compromessi. Le sezioni dettagliate spiegano le evidenze, le ipotesi di fatturazione e i limiti alla base di ciascuna scelta.
| Fattore decisionale | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|
| Carico di lavoro iniziale | Lavoro visuale di routine e agenti ripetibili | Codifica complessa e ragionamento professionale sostenuto |
| Contesto e modalità | Stessa capacità totale di contesto; input di testo e immagini | Stessa capacità totale di contesto; input di testo e immagini |
| Controllo del ragionamento | Include un’opzione per disattivare il ragionamento | Richiede almeno uno sforzo di ragionamento low |
| Andamento delle prestazioni pubblicate | Prestazioni a costo inferiore su attività di agenti ripetibili | Più forte su diverse prove di codifica e automazione desktop difficili |
| Accesso API | OpenAI e CometAPI | OpenAI e CometAPI |
GPT-6.1 Terra: flussi di lavoro visuali e di agenti efficienti
OpenAI ha introdotto GPT-6.1 Terra il 26 ottobre 2026. Combina ragionamento visivo, uso del computer e generazione di testo generico per flussi di lavoro professionali di routine. Le sue tariffe token più basse lo rendono un utile punto di partenza quando le attività sono frequenti e i risultati possono essere verificati.
GPT-6.1 Sol: codifica complessa e ragionamento professionale
GPT-6.1 Sol è stato lanciato il 29 settembre 2026. È rivolto a attività di codifica e lavoro professionale impegnativi. Valutalo quando un repository poco familiare, una lunga catena di azioni dipendenti o correzioni costose rendono preziosa una capacità di ragionamento aggiuntiva.
Contesto, ragionamento e specifiche API
| Specifica | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|
| Data di rilascio ufficiale | October 26, 2026 | September 29, 2026 |
| ID modello API | gpt-6.1-terra | gpt-6.1-sol |
| Finestra di contesto | 1,050,000 token | 1,050,000 token |
| Data di cutoff della conoscenza | June 1, 2026 | April 30, 2026 |
| Input / output | Testo e immagini / testo | Testo e immagini / testo |
| Sforzo di ragionamento | none, low, medium, high, xhigh, max | low, medium, high, xhigh, max |
| Sforzo di ragionamento predefinito | medium | medium |
Funzionalità API: Entrambi i modelli supportano Structured Outputs, streaming e Batch API. Le chiamate agli strumenti utilizzano la Responses API e il fine-tuning non è supportato. Verifica che il provider e l’endpoint scelti offrano le funzionalità di cui la tua applicazione ha bisogno.
Entrambi i modelli consentono fino a 128,000 token di output all’interno di una finestra di contesto da 1,050,000 token. Riservare l’intera disponibilità di output lascia 922,000 token per il resto dello scambio, inclusi il tuo input, le istruzioni di sistema e la cronologia degli strumenti. Questo è un calcolo di pianificazione, non un limite di input fisso separato.
Dichiarazione sull’architettura: Le specifiche pubbliche dei modelli collegate non forniscono dettagli interni sufficienti per un confronto affidabile. La capacità di contesto e le impostazioni di ragionamento non devono essere considerate prova del numero di parametri o dell’architettura.
Controlli di ragionamento: L’impostazione none di Terra è utile per trasformazioni e estrazione semplici. Per il primo confronto, usa la stessa impostazione di ragionamento supportata su entrambi i modelli, quindi ottimizza ciascun modello in base alla qualità e alla latenza richieste dal tuo flusso di lavoro.
Entrambi i modelli hanno la stessa capacità di contesto pubblicata, ma ciò non implica identica accuratezza di recupero o qualità del ragionamento su contesti lunghi. La selezione del modello dovrebbe quindi considerare qualità del ragionamento, efficienza del flusso di lavoro, costo e prestazioni di recupero specifiche per l’attività.
GPT-6.1 Terra vs GPT-6.1 Sol: prestazioni
I risultati riportati mostrano un quadro misto: Terra è leggermente avanti in alcune valutazioni di agenti e codifica scientifica, mentre Sol ottiene punteggi più alti su coding da terminale, automazione desktop e visione. I confronti seguenti separano i risultati di lancio di OpenAI dalle valutazioni indipendenti e spiegano cosa ciascuna può — e non può — indicare sulle prestazioni in produzione.
Risultati di benchmark ufficiali e condizioni di test
I seguenti risultati provengono dalle valutazioni di lancio di Terra di OpenAI. Terra è mostrato con sforzo di ragionamento medium e maximum; Sol è mostrato con sforzo maximum. La colonna finale confronta solo le configurazioni a massimo sforzo.
OSWorld utilizza la valutazione offline 2.1. Il test di factualità usa prompt interni di OpenAI progettati per indurre errori. Sono risultati riportati dal fornitore provenienti da setup di valutazione specifici, non misurazioni del tuo flusso di lavoro di produzione.
| Benchmark | GPT-6.1 Terra (medium) | GPT-6.1 Terra (max) | GPT-6.1 Sol (max) | Confronto al massimo sforzo |
|---|---|---|---|---|
| Agents’ Last Exam v1 | 57.60% | 60.00% | 58.60% | Terra +1.4 pp |
| MMMU-Pro (Vision) | 84.60% | 85.50% | 86.30% | Sol +0.8 pp |
| OSWorld 2.1, offline | 66.70% | 74.20% | 78.00% | Sol +3.8 pp |
| Terminal-Bench 4.0 | 35.80% | 50.30% | 55.90% | Sol +5.6 pp |
| Terminal-Bench-Science 0.1 | 34.30% | 58.30% | 57.00% | Terra +1.3 pp |
| Factual error rate on difficult prompts | 10.10% | 4.30% | 4.40% | Terra 0.1 pp inferiore |
Tutti i punteggi sono percentuali; le differenze sono espresse in punti percentuali (pp). Più basso è meglio solo per il tasso di errore di factualità. La differenza di 0.1 punti nel tasso di errore, da sola, non stabilisce un vantaggio di affidabilità significativo.
Per l’ingegneria del software, il vantaggio di Sol su Terminal-Bench e il lieve vantaggio di Terra su Terminal-Bench-Science suggeriscono che i risultati dipendono dal tipo di attività di codifica. Per i flussi applicativi, il punteggio più alto di Sol su OSWorld supporta la sua valutazione per l’automazione desktop, mentre il risultato di Terra su Agents’ Last Exam lo rende un candidato per attività professionali di agenti. Nessuno dei due andamenti stabilisce un vincitore universale.
L’impalcatura degli agenti, l’accesso agli strumenti e la configurazione dell’ambiente possono influenzare questi risultati. Usa le cifre per identificare i candidati da testare, quindi validali rispetto alle modifiche del repository e ai flussi applicativi che devi effettivamente completare.
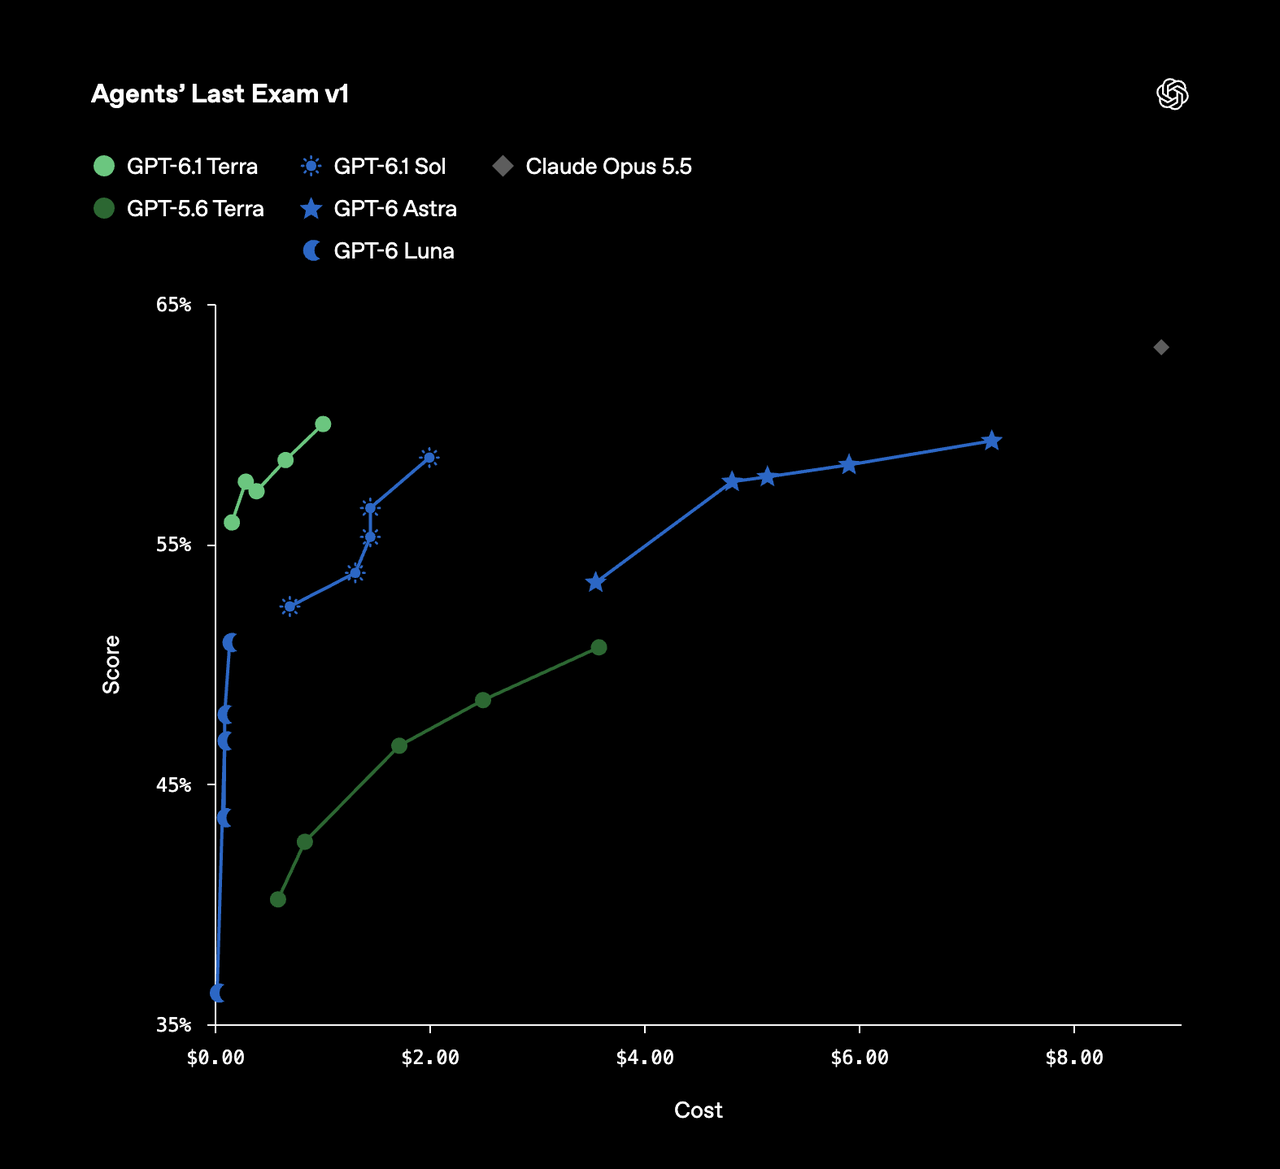
Il grafico Agents’ Last Exam v1 di OpenAI traccia i punteggi rispetto ai costi stimati delle attività attraverso le configurazioni dei modelli. Aggiunge una prospettiva di efficienza dei costi alla tabella dei punteggi sopra; i costi tracciati sono specifici per il setup di valutazione.
Valutazioni indipendenti di intelligenza e codifica
La valutazione di Artificial Analysis del 26 ottobre colloca Terra quattro punti sotto Sol nel suo Intelligence Index al massimo sforzo di ragionamento. Il suo Coding Agent Index v2.0 assegna a Terra 48 e a Sol 54. Sono valutazioni separate con propri metodi e scale di punteggio; non vanno combinate numericamente con i risultati di benchmark di OpenAI.
La stessa analisi identifica le impostazioni di ragionamento low e medium di Terra come particolarmente efficienti in termini di costo nella valutazione di intelligenza. Ciò supporta il test di configurazioni pratiche accanto alle impostazioni a massimo sforzo. I costi di valutazione restano specifici per il setup di test e non devono essere considerati stime della spesa della tua applicazione.
Velocità e latenza: completamento delle attività vs generazione di token
OpenAI riferisce che Terra completa le attività valutate di Agents’ Last Exam più di tre volte più velocemente di Sol. Si tratta di una misurazione end-to-end che include ragionamento e interazioni software. Non implica un throughput dei token di output tre volte più alto né lo stesso incremento di velocità per ogni richiesta API.
Per applicazioni interattive, distingui il tempo al primo token, che misura l’attesa prima dell’inizio dell’output, dai token di output al secondo, che misurano la velocità di prosecuzione della risposta. Per gli agenti, dai priorità al tempo di completamento end-to-end, includendo chiamate agli strumenti, ritentativi e recupero.
Confronta entrambi i modelli usando gli stessi prompt, strumenti, impostazione di ragionamento supportata e criteri di accettazione. Registra la latenza insieme al successo delle attività: una risposta più veloce ha valore limitato se richiede più correzioni o non completa il flusso di lavoro.
Visione e prestazioni su contesti lunghi: cosa stabiliscono i risultati
Il vantaggio di 0.8 punti percentuali di Sol su MMMU-Pro al massimo sforzo è un singolo risultato di visione riportato, non una garanzia di prestazioni migliori su ogni flusso di lavoro visivo. Metti alla prova etichette piccole, scansioni scadenti, diagrammi densi e layout non familiari usando input rappresentativi.
Le valutazioni sopra non stabiliscono quale modello sia migliore nel recupero su contesti lunghi o nel ragionamento. Sebbene entrambi abbiano la stessa capacità di contesto pubblicata, la capacità da sola non dimostra accuratezza di recupero o memoria tra sessioni. Verifica se ciascun modello può individuare e usare evidenze pertinenti nei tuoi documenti e mantieni esplicitamente lo stato dell’applicazione tra le richieste.
GPT-6.1 Terra vs GPT-6.1 Sol: costi
I prezzi dei token sono il punto di partenza per confrontare i costi. Ritentativi, token di ragionamento, chiamate agli strumenti e revisione umana influiscono su quanto spendi per completare un’attività con successo.
Le seguenti tariffe sono in USD per milione di token e pricing.
| Provider e categoria di token | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|
| OpenAI Standard — input | $1.00 | $2.00 |
| OpenAI Standard — cached input | $0.05 | $0.10 |
| OpenAI Standard — output | $5.00 | $10.00 |
| OpenAI Standard — 30-minute cache write | $1.25 | $2.50 |
| OpenAI Standard — 12-hour cache write | $2.50 | $5.00 |
| CometAPI ordinary input | $0.80 | $1.60 |
| CometAPI ordinary output | $4.00 | $8.00 |
Prezzi dell’API OpenAI
Le tariffe Standard elencate per Terra sono la metà di quelle di Sol in queste categorie. Gli addebiti effettivi dipendono dalla configurazione della richiesta: richieste con contesti lunghi, livelli di elaborazione, elaborazione regionale e uso degli strumenti possono avere termini diversi. Verifica la documentazione dei prezzi OpenAI applicabile prima di stimare i costi di produzione.
Prezzi CometAPI
CometAPI è un canale di accesso di terze parti con propri prezzi e disponibilità di funzionalità. Le sue tariffe ordinarie in input e output sono riportate separatamente sotto.
A queste tariffe, i prezzi ordinari di input e output di CometAPI sono inferiori del 20% rispetto alle tariffe OpenAI Standard sopra. Conferma prezzi correnti, addebiti per contesti lunghi, supporto alla cache e disponibilità degli strumenti per il tuo account prima della distribuzione.
Esempio di costo per 1.000 richieste
Supponiamo che un’applicazione effettui 1,000 richieste, ciascuna utilizzando 2,000 token di input non in cache e 500 token di output fatturabili. Questo produce un totale di 2 milioni di token di input e 500,000 token di output.
Per 1,000 richieste, ciascuna con 2,000 token di input non in cache e 500 token di output fatturabili, i costi stimati sono:
- Terra via OpenAI: $2.00 per l’input e $2.50 per l’output, per un totale di $4.50.
- Sol via OpenAI: $4.00 per l’input e $5.00 per l’output, per un totale di $9.00.
- Terra via CometAPI: $1.60 per l’input e $2.00 per l’output, per un totale di $3.60.
- Sol via CometAPI: $3.20 per l’input e $4.00 per l’output, per un totale di $7.20.
Questi calcoli usano le tariffe ordinarie sopra elencate, senza uno sconto Batch API. Escludono scritture in cache, addebiti separati per gli strumenti e ritentativi. Eventuali token di ragionamento fatturati come output devono essere inclusi nel totale dell’output.
Costo effettivo per attività riuscita
In questo articolo, un’attività riuscita è quella che supera i controlli di qualità predefiniti, lo schema quando applicabile e le verifiche di completamento senza correzioni umane aggiuntive.
Prezzi dei token più bassi non producono sempre costi operativi inferiori. I risparmi di Terra possono ridursi se richiede più tentativi, token di ragionamento o intervento umano. Le tariffe più alte di Sol possono essere giustificate se completa più attività con successo al primo tentativo.
Costo effettivo di modello e strumenti per attività riuscita = spesa totale per modello e strumenti su tutti i tentativi ÷ numero di attività riuscite.
Traccia separatamente i costi di revisione e correzione umana. Scegli il modello che soddisfa il tuo obiettivo di qualità al costo combinato più basso, invece di confrontare solo i prezzi dei token.
Quale modello scegliere: GPT-6.1 Terra o GPT-6.1 Sol?
Scegli in base alla complessità delle attività, alla qualità dell’output verificabile e al costo totale di completamento. Terra è un utile punto di partenza per flussi di lavoro di routine; vale la pena valutare Sol quando un ragionamento più difficile o errori costosi giustificano una spesa aggiuntiva.
Quando scegliere GPT-6.1 Terra
Inizia con Terra per estrazione ad alto volume, stesura di documenti, abbinamento di cataloghi e flussi di lavoro applicativi prevedibili. Queste attività sono buone candidate quando i risultati possono essere verificati rispetto a documenti sorgente, campi richiesti o regole di validazione automatizzate.
Scegli Terra quando soddisfa obiettivi di accuratezza e completamento entro il budget di ritentativi e revisione umana consentito. Le tariffe dei token più basse offrono scarso beneficio se fallimenti ripetuti annullano i risparmi.
Quando scegliere GPT-6.1 Sol
Valuta Sol per debugging difficile, modifiche a repository con molte dipendenze e flussi desktop con lunghe catene di azioni dipendenti.
Scegli Sol quando i test mostrano che produce più patch accettate, supera più test o richiede meno correzioni manuali. Il suo costo token più alto è giustificato quando tali miglioramenti riducono il costo totale di completamento del lavoro.
Quando usare prima Terra ed eseguire l’escalation a Sol
Un flusso ibrido può usare Terra per il tentativo iniziale ed eseguire l’escalation a Sol quando i controlli predefiniti falliscono. Basa l’escalation su risultati osservabili piuttosto che sulla sola confidenza del modello.
Per esempio, un flusso di generazione di codice potrebbe:
- Chiedere a Terra di produrre la modifica richiesta.
- Eseguire i test e i controlli di validazione pertinenti.
- Eseguire l’escalation a Sol se la modifica non supera tali controlli o esula dalla capacità verificata di Terra.
- Inviare i casi irrisolti alla revisione umana una volta esaurito il budget di ritentativi.
Durante l’escalation, conserva la richiesta originale, il contesto pertinente, l’output fallito e i risultati di validazione. Registra l’uso di entrambi i modelli in modo che il confronto dei costi includa l’intero flusso.
Checklist di valutazione per la produzione
Prima di scegliere un modello predefinito o distribuire un flusso di escalation:
- Usa attività rappresentative: Includi richieste di routine e casi in cui il fallimento è costoso.
- Mantieni confronti controllati: Usa istruzioni, evidenze, strumenti e criteri di accettazione comparabili. Registra ID modello, endpoint, impostazioni di ragionamento e date dei test.
- Misura gli esiti accettati: Controlla accuratezza, validità dello schema quando applicabile, risultati dei test e completamento senza correzione manuale.
- Misura tempo e spesa: Traccia latenza mediana e di coda, token fatturati, chiamate agli strumenti, ritentativi e sforzo di revisione umana.
- Ripeti il confronto: Esegui le attività più volte e alterna l’ordine dei modelli per ridurre l’influenza di risultati sporadici.
- Definisci limiti operativi: Imposta budget di ritentativi, trigger di escalation e requisiti di approvazione umana prima della distribuzione.
- Confronta l’intero flusso: Includi tentativi non riusciti e costi di escalation nel calcolo della spesa per attività riuscita.
Dove puoi accedere a GPT-6.1 Terra e GPT-6.1 Sol?
Accesso tramite provider ufficiale
Entrambi i modelli sono disponibili tramite l’API OpenAI. Per richieste di testo, Chat Completions è supportato; le chiamate agli strumenti richiedono la Responses API. Conferma i parametri supportati dal modello, i limiti del tuo account e gli strumenti disponibili sul percorso che intendi utilizzare.
Accesso CometAPI
Per usare uno dei due modelli tramite CometAPI, segui la sua guida rapida per configurare l’SDK compatibile con OpenAI. Fornisci la tua chiave CometAPI in modo sicuro tramite la variabile d’ambiente COMETAPI_KEY e imposta la base URL su https://api.cometapi.com/v1. Scegli gpt-6.1-terra o gpt-6.1-sol come identificatore del modello e conferma che la route sia abilitata per il tuo account.
Per un primo confronto, assegna a entrambi i modelli gli stessi compiti rappresentativi e usa sforzo di ragionamento medium. Mantieni coerenti le istruzioni e i criteri di accettazione, ripeti ogni attività e alterna l’ordine dei modelli. Confronta risultati riusciti, tempo trascorso, token fatturati e ritentativi invece di giudicare un modello da una singola risposta.
Conclusione
Inizia con GPT-6.1 Terra per flussi di lavoro frequenti e verificabili, dove contano prezzi dei token più bassi e completamento più rapido delle attività. Valuta GPT-6.1 Sol quando codifica difficile, uso di strumenti in più passaggi o errori costosi rendono utile una capacità di ragionamento superiore. La scelta finale dovrebbe basarsi sul costo per attività accettata su un set di valutazione rappresentativo, non sul prezzo o su un singolo benchmark.
Per molte applicazioni, il prossimo passo utile è una piccola prova rappresentativa con chiari criteri di superamento e un percorso di escalation limitato. Lascia che sia il risultato misurato a determinare il modello, invece di fare affidamento sul prezzo o su un unico benchmark.

