
TL;DR
Grok 4.6 è la scelta predefinita più solida se vuoi un’API frontier gestita per programmazione agentica e lavoro della conoscenza: ottiene 61 sull’Artificial Analysis Intelligence Index, genera più velocemente nelle misurazioni indipendenti attuali e parte da $2/$6 per milione di token in input/output.
Kimi K3 è la scelta più flessibile quando contano la lunghezza del contesto e l’apertura del modello. Combina 2,8 trilioni di parametri, 104B di parametri attivi e una finestra di contesto di circa 1M di token, oltre a pesi open e funzionalità multimodali native. Il prezzo ufficiale dell’API hosted è più alto a $3/$15 per milione di token in input/output, ma gli hit di cache costano solo $0,30 per milione di token.
In sintesi: scegli Grok 4.6 per un’API agent gestita e conveniente; scegli Kimi K3 per contesto da 1M, pesi open e controllo dell’infrastruttura. Per il coding, testa entrambi sui tuoi repository perché i vendor pubblicano versioni e harness di benchmark differenti.
Punti chiave
- Grok 4.6 è stato rilasciato il 12 agosto 2026 con enfasi specifica su agenti di lunga durata, lavoro su codebase, lavoro della conoscenza e progetti interattivi o visuali più ambiziosi.
- Kimi K3 è il modello open-weight di punta da 2,8T parametri di Moonshot AI con Kimi Delta Attention, Attention Residuals, visione nativa e una finestra di contesto da 1M di token.
- L’intelligenza complessiva indipendente è quasi alla pari: 61 per Grok 4.6 contro 60 per Kimi K3.
- Grok 4.6 ha il prezzo per token ufficiale più basso: $2 input / $6 output contro $3 input / $15 output per Kimi K3.
- Kimi K3 offre circa il doppio della capacità di contesto e pesi open; Grok 4.6 è proprietario ma più efficiente per turni e costo in diverse valutazioni agent indipendenti.
Grok 4.6 vs Kimi K3: confronto rapido
| Specifica | Grok 4.6 | Kimi K3 |
|---|---|---|
| Developer | SpaceXAI / xAI | Moonshot AI / Kimi |
| Release date | August 12, 2026 | July 16, 2026 |
| Model ID | grok-4.6 | kimi-k3 |
| Architecture | Non divulgata pubblicamente | MoE; KDA + AttnRes + Stable LatentMoE |
| Total parameters | Non divulgati | 2.8T |
| Active parameters | Non divulgati | 104B |
| Experts | Non divulgati | 896 totali; 16 attivati/token |
| Context window | 500,000 token | 1,048,576 / circa 1M token |
| Input / output | Testo + immagine → testo | Testo + immagine → testo |
| Reasoning | Configurabile | Sempre attivo; low / high / max |
| Function / tool use | Chiamata di funzioni + output strutturati | ToolCalls, tool_choice, caricamento dinamico degli strumenti |
| Open weights | No | Sì |
| AA Intelligence Index | 61 | 60 |
| Official input / output price | $2 / $6 per MTok | $3 / $15 per MTok |
| Best fit | API hosted per agenti, coding, knowledge work | Lungo contesto, deployment con pesi open, coding + ragionamento visivo |
Che cos’è Grok 4.6?
Grok 4.6 è il modello frontier di SpaceXAI per coding, compiti agentici e lavoro della conoscenza. L’azienda afferma che il rilascio è stato costruito intorno ad agenti di lunga durata e lavori interattivi e visivi più ambiziosi, invece di essere solo un aggiornamento di benchmark statici. In pratica, significa che il modello è pensato per restare su un compito per molti passaggi: ricercare un argomento, navigare una codebase, analizzare informazioni, chiamare strumenti e iterare verso un’applicazione o un artefatto di lavoro finito.
Cosa è cambiato rispetto a Grok 4.5?
SpaceXAI riporta un supplemental training più lungo utilizzando dati di ragionamento generati dal modello e curati, concetti tecnici avanzati, dati di ingegneria di alta qualità e un ottimizzatore e una ricetta di training migliorati. Il team ha poi rigenerato traiettorie SFT con Grok 4.5 su sforzi di ragionamento e harness agentici, filtrato tracce problematiche e applicato reinforcement learning agentico in ambienti che spaziano da coding generale, ottimizzazione di kernel, sviluppo web, CAD e lavoro della conoscenza.
Il risultato pratico è un modello che non solo ottiene punteggi più alti ma mostra anche più auto-test e verifica su traiettorie più lunghe. Questo comportamento conta per gli agenti perché il costo di un piccolo errore si amplifica quando a un modello è consentito modificare file, chiamare strumenti o eseguire un piano multi-step senza intervento umano costante.
Specifiche di Grok 4.6
| Proprietà | Grok 4.6 |
|---|---|
| Context | 500,000 token |
| Modalities | Input testo e immagine; output testo |
| Reasoning | Ragionamento configurabile |
| Native API capabilities | Chiamata di funzioni e output strutturati |
| Knowledge cutoff | February 1, 2026 |
| Short-context pricing | $2 input / $0.50 cached / $6 output per MTok |
| Long-context threshold | ≥200K token nel prompt; $4 / $1 / $12 |
Che cos’è Kimi K3?
Kimi K3 è il modello agentico multimodale open-weight di punta di Moonshot AI. Combina 2,8 trilioni di parametri totali con una finestra di contesto da 1M di token e visione nativa, posizionandosi per coding a lungo orizzonte, lavoro della conoscenza end-to-end, ragionamento e compiti software basati sulla visione.
A differenza di Grok 4.6, Kimi K3 espone i suoi pesi di modello. L’attuale model card ufficiale identifica 104B parametri attivi durante l’inferenza, quindi il percorso di calcolo è molto più piccolo del conteggio totale di 2,8T parametri, anche se il deployment del modello completo richiede comunque un’infrastruttura significativa.
KDA, AttnRes e un MoE più sparso
L’architettura è uno dei maggiori elementi differenzianti di K3. Moonshot afferma che Kimi Delta Attention (KDA) e Attention Residuals (AttnRes) sono progettati per migliorare il flusso di informazione su sequenze lunghe e livelli di modello profondi. Stable LatentMoE aumenta la sparsità così che 16 di 896 esperti vengono attivati per ogni token. Insieme ai cambiamenti di training e di ricetta dei dati, Moonshot riporta circa 2,5× di migliore efficienza di scaling complessiva rispetto a Kimi K2.
Specifiche di Kimi K3
| Proprietà | Kimi K3 |
|---|---|
| Total / active parameters | 2.8T / 104B |
| Architecture | MoE con KDA + AttnRes + Stable LatentMoE |
| Experts | 896; 16 attivati per token |
| Context | 1M token |
| Vision | Comprensione visiva nativa |
| Reasoning | Sempre abilitato; low / high / max |
| Tools | ToolCalls, vincoli tool_choice, caricamento dinamico tools |
| Open weights | Disponibili su Hugging Face |
| Official pricing | $0.30 cache hit / $3 input / $15 output per MTok |
Grok 4.6 vs Kimi K3: confronto dei benchmark
Il confronto diretto più pulito è l’Artificial Analysis Intelligence Index indipendente perché entrambi i modelli sono valutati nello stesso framework. I punteggi attuali sono 61 per Grok 4.6 (alto) e 60 per Kimi K3 (max). Un divario di un punto è troppo piccolo per giustificare l’affermazione che uno dei modelli sia “una generazione avanti” in senso categorico. La domanda più utile è dove ciascun modello guadagna il suo punteggio.
| Metrica indipendente | Grok 4.6 | Kimi K3 | Vantaggio |
|---|---|---|---|
| Artificial Analysis Intelligence Index | 61 | 60 | Grok 4.6 di 1 punto |
| Output speed | 65.8 tok/s | 40.7 tok/s | Grok 4.6 |
| Time to first token | ~32.3 s | 3.27 s | Kimi K3 |
| Context window | 500K | ~1.05M | Kimi K3 |
Prestazioni nel coding
SpaceXAI pubblica diversi risultati di coding e ingegneria del software per Grok 4.6: 69,9% su CursorBench 3.2, 65,9% su DeepSWE 1.1, 61,3% su FrontierCode 1.1 Extended, 56,4% su APEX-SWE e 26,0% su Terminal-Bench 3.0. Questi sono significativi perché coprono editing di repository, ingegneria software agentica e lavoro da terminale invece di sola trivia di completamento del codice.
| Benchmark di coding riportato dal vendor (Grok 4.6) | Punteggio |
|---|---|
| CursorBench 3.2 | 69,9% |
| DeepSWE 1.1 | 65,9% |
| FrontierCode 1.1 Extended | 61,3% |
| APEX-SWE | 56,4% |
| Terminal-Bench 3.0 | 26,0% |
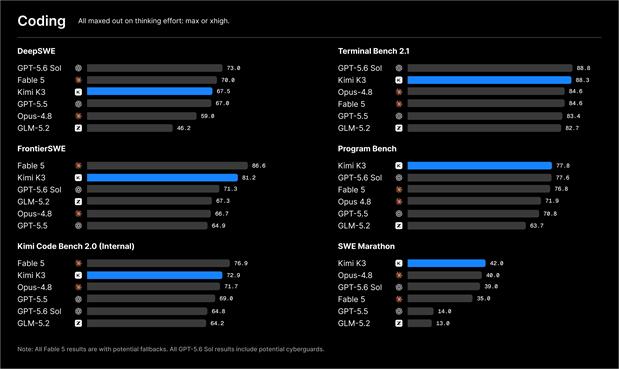
Per Kimi K3, Moonshot pubblica una suite di coding diversa ma ampia. Il materiale di lancio ufficiale riporta 67,5 su DeepSWE, 88,3 su Terminal-Bench 2.1, 81,2 su FrontierSWE, 77,8 su ProgramBench e 42,0 su SWE Marathon. L’avvertenza importante è che Terminal-Bench 2.1 e 3.0 sono versioni differenti e FrontierSWE non è la stessa valutazione di FrontierCode. Queste righe non dovrebbero essere trattate come vittorie “mele con mele” basate solo sul numero grezzo.
Fonte: Moonshot AI / Kimi
Lavoro agentico e knowledge work
Il lavoro agentico è dove Grok 4.6 appare più forte. SpaceXAI riporta 1753 Elo su GDPVal-AA v2, 57,5% su APEX-Agents e 1577 Elo su AA-Briefcase. Artificial Analysis evidenzia indipendentemente lo stesso schema: i guadagni più forti di Grok 4.6 sono su lavoro a lungo orizzonte con uso di strumenti, non solo sul ragionamento statico.
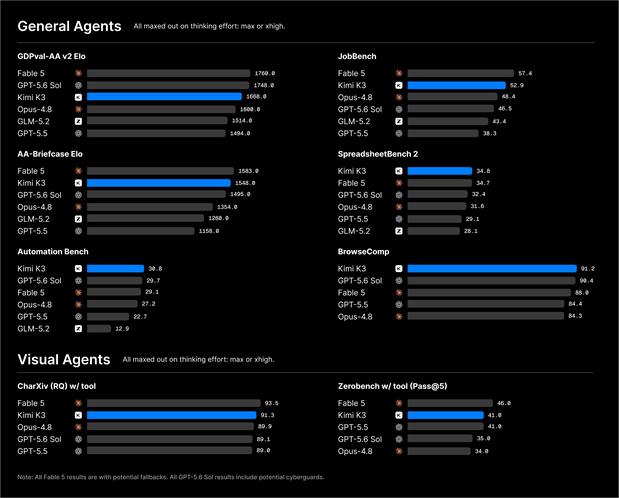
Anche Kimi K3 mira ad agenti per il lavoro della conoscenza. La suite di lancio di Moonshot mostra risultati solidi su BrowseComp, GDPval-AA v2, JobBench, SpreadsheetBench 2 e valutazioni di agent visivi. Ancora più importante per gli sviluppatori, l’API Kimi espone vincoli di scelta degli strumenti e caricamento dinamico degli strumenti, che sono controlli pratici quando un agente deve usare sistemi aziendali o recuperare fatti prima di rispondere.
Fonte: Moonshot AI / Kimi
Multimodalità e ragionamento visivo
Kimi K3 ha una storia multimodale a livello di architettura più chiara: Moonshot descrive capacità visive native e dimostra specificamente “vision in the loop” per sviluppo di giochi, engineering frontend e CAD, dove il modello può ispezionare feedback visivi e revisionare il codice.
Grok 4.6 accetta anche input testo e immagini e SpaceXAI afferma che il modello produce passaggi iniziali più solidi su progetti visivi e interattivi rispetto a Grok 4.5. La differenza riguarda meno il se i modelli possano “vedere” immagini e più la filosofia di deployment: Kimi espone un modello multimodale open, mentre Grok incapsula la comprensione visiva dentro un’API frontier gestita e un ecosistema di agent.
Finestra di contesto: 500K vs 1M
Grok 4.6 supporta 500.000 token, mentre Kimi K3 supporta circa 1 milione di token. Questo rende Kimi la scelta ovvia quando il carico richiede davvero più di 500K token in una sola richiesta—for esempio, repository molto grandi, raccolte di ricerca multi-libro o tracce di agent eccezionalmente lunghe.
Tuttavia, la dimensione del contesto è capacità, non una garanzia di qualità di retrieval o ragionamento. Per i sistemi in produzione, testa il modello sui tuoi reali failure mode di lungo contesto: tracciamento di dipendenze cross-file, retrieval di fatti lontani, rilevamento di contraddizioni e persistenza delle istruzioni. La retrieval-augmented generation può comunque essere più economica e controllabile che inviare un milione di token a ogni richiesta.
Velocità e latenza
Artificial Analysis misura attualmente Grok 4.6 a 65,8 token di output al secondo e Kimi K3 a 40,7 token al secondo. Una volta che la generazione inizia, Grok è materialmente più veloce in questa misurazione. Ma il pattern del primo token va nella direzione opposta: Kimi K3 ha un TTFT misurato di 3,27 secondi, mentre la misurazione attuale del provider per Grok 4.6 è molto più lenta a iniziare lo streaming.
Questo crea una distinzione di prodotto utile. Per esperienze interattive in chat o IDE, un time-to-first-token rapido può far percepire Kimi come reattivo anche se la risposta completa richiede più tempo. Per generazioni lunghe e run di agent, la maggiore velocità di generazione di Grok può ridurre la coda della richiesta. Provider, regione, effort di ragionamento, stato della cache e dimensione della richiesta possono tutti cambiare questi numeri, quindi trattali come un’istantanea attuale e non come proprietà permanenti.
Grok 4.6 vs Kimi K3: prezzi API
A lunghezze di contesto standard, Grok 4.6 costa $2 per milione di token in input, $0,50 per milione di token in cache e $6 per milione di token in output. Per prompt a o sopra 200K token, xAI fattura l’intera richiesta a tariffe long-context di $4 input, $1 cached e $12 output per milione di token.
Kimi usa prezzi pay-as-you-go uniformi su tutta la sua finestra di contesto da 1M. L’API Kimi elenca $0,30 per milione di token di cache-hit, $3 per milione di token in input e $15 per milione di token in output. Ciò significa che Kimi è più economico sugli hit di cache ma molto più costoso sui token di output freschi; il vantaggio di prezzo di Grok si riduce quando le richieste Grok superano la soglia long-context di 200K.
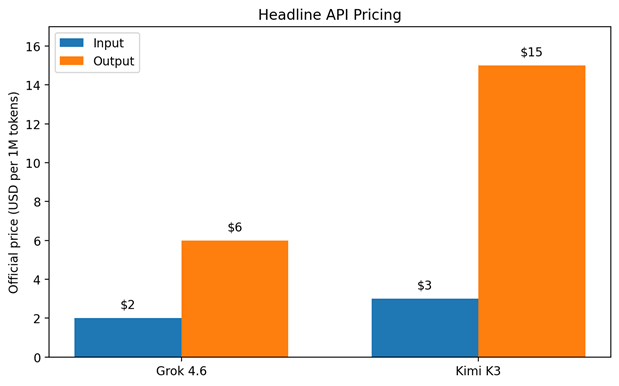
Prezzi ufficiali per 1M di token. Le richieste long-context di Grok (≥200K token nel prompt) usano tariffe più alte non mostrate nel grafico. Fonte: Prezzi API SpaceXAI e Kimi
| Prezzo / 1M token | Grok 4.6 | Kimi K3 |
|---|---|---|
| Official short-context input | $2.00 | $3.00 |
| Official cache hit | $0.50 | $0.30 |
| Official output | $6.00 | $15.00 |
| Long-context pricing | ≥200K: $4 / $1 / $12 | Prezzo uniforme fino a 1M contesto |
| CometAPI input | $1.60 | $2.40 |
| CometAPI output | $4.80 | $12.00 |
Su CometAPI, Grok 4.6 è attualmente elencato a $1,60 input / $4,80 output per milione di token, mentre Kimi K3 è elencato a $2,40 input / $12 output. Entrambi sono il 20% in meno rispetto ai prezzi ufficiali input/output dei provider mostrati sulle rispettive pagine modello CometAPI al momento della stesura.
Pesi open vs modello proprietario
Kimi K3 è un modello open-weight con pesi scaricabili. Questo abilita ricerca, controllo fine dell’infrastruttura, architetture di inferenza private e deployment tramite stack di inferenza di terze parti. Non significa che K3 sia leggero: un modello da 2,8T parametri è un progetto di sistemi serio anche con la sparsità MoE e formati a bassa precisione.
Grok 4.6 è proprietario. La sua architettura e il conteggio dei parametri non sono divulgati pubblicamente e gli sviluppatori vi accedono come servizio gestito. Il trade-off è la semplicità operativa: non devi costruire un cluster di inferenza, gestire pesi di modello o ottimizzare kernel per ottenere prestazioni agent di livello frontier.
Punti di forza e compromessi
| Modello | Punti di forza | Compromessi |
|---|---|---|
| Grok 4.6 | Prezzo API hosted più basso; 61 AA Intelligence; generazione misurata più veloce; forti risultati per agent a lungo orizzonte; stack di strumenti xAI integrato | Contesto 500K; pesi chiusi; prezzi raddoppiati per long-context; TTFT misurato più lento |
| Kimi K3 | ~1M contesto; pesi open; MoE 2,8T; multimodalità nativa; suite coding/agent solida | Prezzo output più alto; generazione misurata più lenta; self-hosting completo richiede molta infrastruttura |
Grok 4.6 vs Kimi K3: quale dovresti scegliere?
| Use case | Consigliato | Perché |
|---|---|---|
| API frontier predefinita | Grok 4.6 | Prezzo più basso con lieve vantaggio d’intelligenza indipendente |
| Agente per knowledge work di lunga durata | Grok 4.6 | Evidenza più forte da GDPVal-AA e AA-Briefcase |
| Coding a livello di repository | Testa entrambi | Entrambi progettati per coding a lungo orizzonte; suite benchmark diverse |
| Prompt >500K token | Kimi K3 | Circa 1M di contesto |
| Ricerca con pesi open | Kimi K3 | Pesi e architettura disponibili |
| Inferenza privata/autogestita | Kimi K3 | Pesi open abilitano deployment personalizzato |
| Costo basso per hit di cache | Kimi K3 | Prezzo $0,30/MTok per cache-hit |
| Costo inferiore per token di output freschi | Grok 4.6 | $6/MTok vs $15/MTok a contesto standard |
| Prima risposta visibile più rapida | Kimi K3 | TTFT misurato molto più basso |
| Generazioni lunghe più veloci | Grok 4.6 | Maggiore velocità di token/s di output misurata |
| Coding visivo / CAD / game workflow | Kimi K3 | Vision nativa + focus ufficiale su “vision-in-the-loop” |
Raccomandazione complessiva: Grok 4.6 è la migliore API hosted predefinita per la maggior parte degli sviluppatori di agent. Kimi K3 è il modello frontier più flessibile quando contesto da 1M, pesi open e controllo del deployment sono requisiti e non extra opzionali.
Come accedere a Grok 4.6 e Kimi K3 tramite CometAPI
Entrambi i modelli sono disponibili su CometAPI. La pagina modello di Grok 4.6 elenca l’ID modello grok-4.6 e supporto per accesso in stile Chat Completions / Responses, mentre la pagina modello di Kimi K3 espone kimi-k3 tramite l’endpoint unificato CometAPI. Questo rende l’A/B testing più semplice perché puoi cambiare gli ID modello mantenendo costanti autenticazione e gran parte dell’infrastruttura applicativa.
from openai import OpenAI
 import os

 client = OpenAI(
    base_url="https://api.cometapi.com/v1",
    api_key=os.environ["COMETAPI_KEY"],
 )

 for model in ["grok-4.6", "kimi-k3"]:
    response = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "user", "content": "Review this repository bug and propose a tested fix."}
        ],
    )
    print(model, response.choices[0].message.content)
Per una valutazione di produzione, mantieni identici prompt, strumenti, snapshot del repository e criteri di successo. Traccia non solo la qualità delle risposte ma anche il successo delle chiamate strumento, il numero di turni, i token totali in input/output, la latenza e il recupero da chiamate strumento fallite. Questo è più predittivo del costo reale dell’agente rispetto a un singolo punteggio di benchmark.
Conclusione
Il risultato più importante del confronto Grok 4.6 vs Kimi K3 è che la loro intelligenza di vertice è molto più vicina delle loro scelte di prodotto. La valutazione indipendente li posiziona attualmente a 61 contro 60, ma l’economia circostante e le scelte di deployment sono molto diverse.
Grok 4.6 è ottimizzato come servizio frontier gestito: prezzi più bassi per token freschi, forti benchmark agentici, generazione più veloce misurata e un percorso di tool/API maturo. Kimi K3 è ottimizzato per la flessibilità: finestra di contesto da 1M, scala MoE 2,8T, multimodalità nativa e pesi open.
Per la maggior parte degli sviluppatori che hanno semplicemente bisogno del miglior modello hosted predefinito per coding e agent di lunga durata, Grok 4.6 è il punto di partenza più sicuro. Se il tuo sistema dipende da >500K di contesto, deployment con pesi open, coding visivo o controllo sullo stack di inferenza, Kimi K3 può essere la scelta architetturale migliore anche quando il suo prezzo per token hosted è più alto.
FAQ
Grok 4.6 è più “smart” di Kimi K3?
Sull’attuale Artificial Analysis Intelligence Index, Grok 4.6 ottiene 61 e Kimi K3 60. È un vantaggio stretto, non un divario decisivo. Le prestazioni a livello di task possono invertirsi a seconda del carico.
Quale è migliore per il coding?
Entrambi sono modelli di coding credibili. Grok 4.6 ha forti risultati attuali nel coding agentico e prezzi hosted più bassi; Kimi K3 offre una finestra di contesto più grande, pesi open e solidi risultati nel coding su repository e visivo. Usa il tuo benchmark sul repository perché i vendor riportano versioni di benchmark differenti.
Quale modello ha la finestra di contesto più grande?
Kimi K3 supporta circa 1M token, circa il doppio dei 500K token di contesto di Grok 4.6.
Quale è più economico?
Per token freschi a contesto standard, Grok 4.6 è più economico a $2 input / $6 output per MTok contro $3 / $15 per Kimi K3. Kimi ha un prezzo di cache-hit più basso a $0,30/MTok, mentre Grok applica tariffe più alte una volta che il prompt raggiunge 200K token.
Posso auto-ospitare Kimi K3?
Kimi K3 ha pesi open disponibili su Hugging Face, quindi un deployment autogestito è possibile. Il modello completo da 2,8T rimane comunque estremamente grande e richiede infrastrutture multi-nodo o specialistiche per prestazioni pratiche.
Posso auto-ospitare Grok 4.6?
Non sono disponibili pesi pubblici di Grok 4.6. Grok 4.6 è fornito come modello proprietario gestito tramite SpaceXAI e API partner.
Posso accedere a entrambi da un’unica API?
Sì. CometAPI attualmente elenca sia Grok 4.6 sia Kimi K3, permettendo agli sviluppatori di confrontarli dietro un’API e un layer di billing unificati.