Crea con CometAPITi serve una sola API per più modelli?Testa il flusso di lavoro in Playground, poi crea una chiave API quando modello e costo sono adatti al tuo caso d'uso.
Come distribuire Qwen 3.8 Max in locale: guida a hardware, vLLM, SGLang e alla quantizzazione
Come effettuare il deployment locale di Qwen 3.8 Max con i pesi open Qwen3.8-2.4T-A95B, requisiti GPU, FP8/FP4, vLLM, SGLang, contesto da 1M, ottimizzazione per la produzione.
Eseguire in locale Qwen3.8-Max è ora possibile, ma l’espressione “Qwen 3.8 Max locally” richiede un’importante precisazione. Il prodotto Max ospitato da Alibaba e il checkpoint scaricabile sono strettamente correlati, ma non sono prodotti identici.
Qwen ha lanciato per la prima volta il servizio Max ospitato all’inizio di agosto 2026 e ha rilasciato Qwen3.8-2.4T-A95B come open weights il 12 agosto 2026. Quel checkpoint è il modello che effettivamente distribuisci sulla tua infrastruttura.
Questo non è un normale tutorial “Ollama su un PC da gaming”. Il checkpoint non quantizzato è un modello Mixture-of-Experts da 2,4 trilioni di parametri, e la ricetta vLLM attuale dimensiona i suoi pesi in BF16 a 4,45 TiB. Anche le varianti orientate alla produzione con floating point a 4 bit occupano comunque circa 1,3–1,5 TiB di pesi.
Revisionato per chiarezza, attribuzione delle fonti e terminologia API aggiornata.
Risposta rapida: l’auto-hosting completo della classe Qwen 3.8 Max è un deployment da datacenter. Un punto di partenza pratico per la produzione è un checkpoint FP4 su 8× B300 o 8× MI355X; i deployment su H200 necessitano di più GPU. Per una workstation normale, usa invece Qwen3.8-27B.
Qwen 3.8 Max vs. il modello open che effettivamente distribuisci
Il checkpoint scaricabile Qwen3.8-2.4T-A95B è ufficialmente descritto come un modello linguistico causale da 2,4T parametri con circa 95B parametri attivati per token. Il servizio Max ospitato aggiunge funzionalità a livello di prodotto che non sono presenti nell’attuale checkpoint open.
Specifica
Servizio ospitato Qwen3.8-Max
Checkpoint open Qwen3.8-2.4T-A95B
Parametri totali
2.4T
2.4T
Parametri attivi
~95B
~95B
Architettura
Sparse MoE
Sparse MoE
Input
Testo, immagine, video
Testo
Contesto
Contesto gestito da 1M
262,144 nativo; estendibile a ~1.01M
Comportamento di ragionamento
Ragionamento gestito/opzioni senza ragionamento
Ragionamento richiesto; sforzo configurabile
Strumenti integrati
Disponibili sul servizio gestito
L’applicazione deve fornire gli strumenti
Self-hosting
Nessuna gestione dei pesi richiesta
Sì; checkpoint open
Il prodotto ospitato espone input di testo, immagine e video con un contesto da 1.000.000 di token. Per contro, il checkpoint open è solo testo e ha un contesto nativo di 262.144 token. Questa differenza è importante se la tua applicazione dipende da input multimodali o da strumenti integrati gestiti.
Architettura e specifiche di Qwen 3.8
CometAPI copre già lo sfondo del modello in What is Qwen3.8 Max, quindi questa guida al deployment mantiene la discussione sull’architettura focalizzata sui dettagli che influiscono su memoria, parallelismo e serving.
Non interpretare “95B parametri attivi” come un footprint di memoria di un modello da 95B. L’attivazione sparsa riduce il compute per token, ma il sistema di serving deve comunque avere accesso all’intero set di pesi degli esperti.
Snapshot dei benchmark di Qwen 3.8 Max
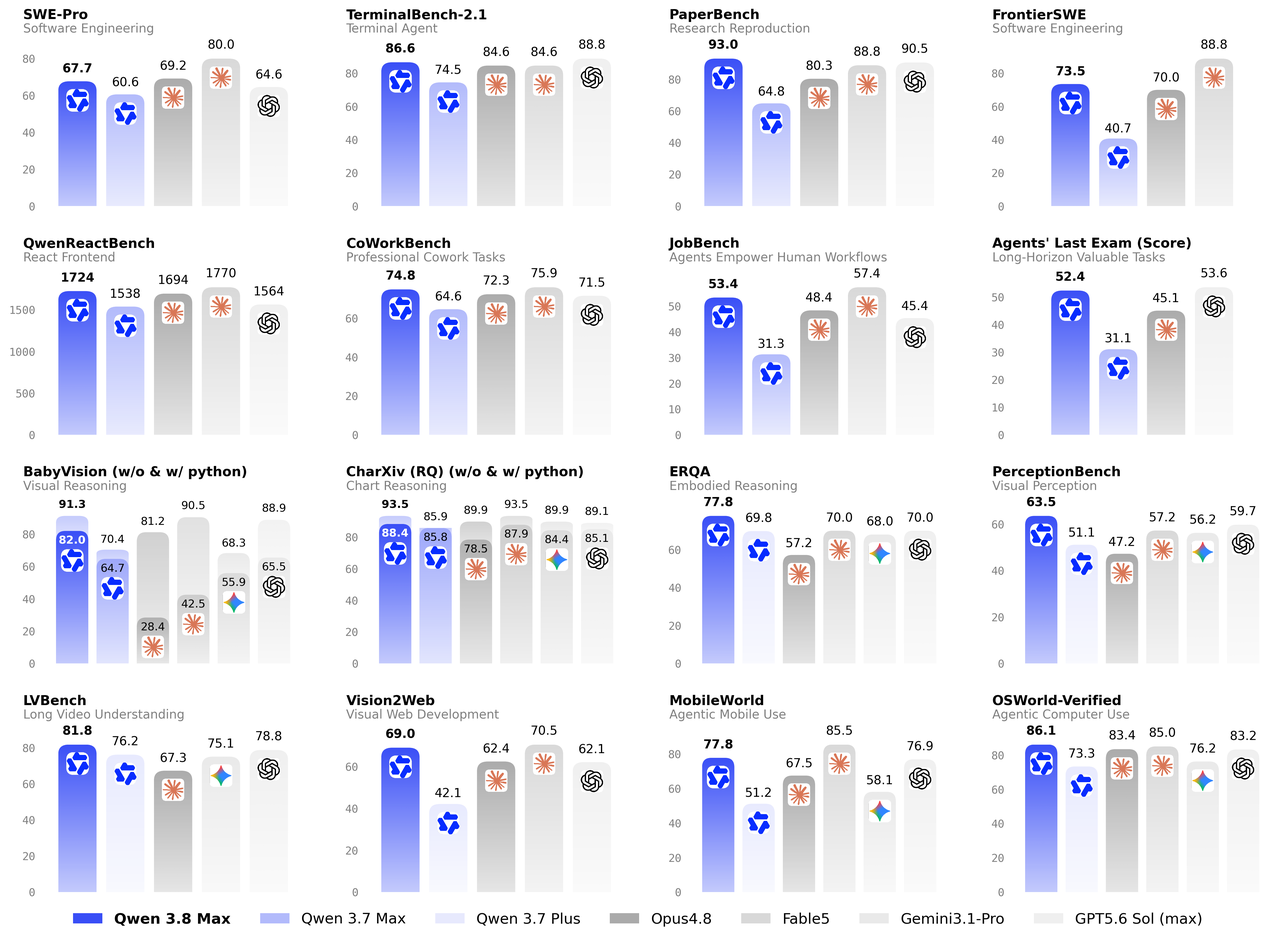
Poiché la panoramica esistente di Qwen3.8 Max su CometAPI discute già i benchmark in dettaglio, questo articolo usa solo un sottoinsieme rilevante per il deployment dalla tabella di benchmark della model card ufficiale di Qwen.
Benchmark
Qwen3.8-Max
Qwen3.7-Max
GPT-5.6 Sol (max)
Terminal Bench 2.1
86.6
74.5
88.8
SWE-bench Pro
67.7
60.6
64.6
PaperBench
93.0
64.8
90.5
FrontierSWE
73.5
40.7
—
CoWorkBench
74.8
64.6
71.5
GPQA Diamond
92.6
92.4
94.1
Grafico delle prestazioni ufficiale di Qwen3.8 pubblicato dalteam Qwen.
I maggiori incrementi riportati rispetto a Qwen3.7-Max in questo sottoinsieme sono PaperBench e FrontierSWE. Qwen3.8-Max supera anche GPT-5.6 Sol su SWE-bench Pro e PaperBench, mentre GPT-5.6 Sol rimane avanti su Terminal Bench 2.1. Per le decisioni di deployment, trattale come contesto di capacità; le misure di memoria e throughput di serving qui sotto sono più rilevanti operativamente.
Le tabelle di benchmark non sono classifiche universali. Harness, timeout, limiti di contesto, accesso agli strumenti e quantizzazione possono cambiare i risultati. Esegui benchmark dell’esatto checkpoint, precisione, motore di serving e distribuzione di prompt che intendi usare.
Quale hardware serve a Qwen3.8 per il deployment locale?
Requisiti GPU per Qwen3.8-2.4T-A95B
Questa è la domanda chiave di deployment. La ricetta vLLM attuale per Qwen3.8 pubblica i footprint dei checkpoint e conteggi GPU realistici con margine runtime, cosa più utile che stimare la VRAM solo dal numero di parametri.
Precisione
Footprint dei pesi
B300 (268 GB)
MI355X (288 GB)
H200 (141 GB)
Uso consigliato
BF16
4.45 TiB
24 GPU
24 GPU
48 GPU
Massima fedeltà / ricerca
FP8
2.27 TiB
16 GPU
16 GPU
32 GPU
Produzione ad alta fedeltà
MXFP4
1.45 TiB
—
8 GPU
16 GPU
Deployment pratico su AMD
NVFP4 W4A4
1.32 TiB
8 GPU
—
16 GPU
Deployment pratico su NVIDIA
Per la maggior parte delle organizzazioni che hanno realmente bisogno di auto-hostare Qwen3.8, FP4 è il punto di partenza pratico. La configurazione NVIDIA di riferimento è NVFP4 W4A4 su 8× B300; la corrispondente via AMD è MXFP4 su 8× MI355X.
Un server con 8× H200 non basta per questi deployment full-model raccomandati. La ricetta ufficiale dimensiona H200 a 16 GPU per FP4, 32 per FP8 e 48 per BF16.
Requisiti VRAM per Qwen3.8-27B
Qwen3.8-27B è l’alternativa praticabile per classe workstation. La memoria dei pesi grezzi è circa 54 GB in BF16, 27 GB in FP8 e 13,5 GB a precisione 4 bit. L’overhead runtime e la KV cache aumentano il requisito effettivo, specialmente a lunghe lunghezze di contesto.
Precisione
Memoria dei pesi approssimativa
Indicazioni pratiche di distribuzione
BF16
~54 GB
Usa una GPU da 64–80 GB, a seconda del contesto e dell’overhead.
FP8 / INT8
~27 GB
Una GPU da 40–48 GB offre maggiore margine runtime.
4-bit
~13.5 GB
Una GPU consumer da 20–24 GB può essere valida a contesti moderati.
Queste cifre sono stime di pianificazione derivate dal conteggio dei parametri. Conferma l’esatto checkpoint, formato di quantizzazione, motore di serving, lunghezza del contesto e impostazioni della KV cache prima di dimensionare l’hardware di produzione.
Qwen3.8 può girare su GPU consumer?
Il modello completo Qwen3.8-2.4T-A95B non è pratico su GPU consumer ordinarie, anche con quantizzazione aggressiva. Un progetto community ha dimostrato una build UD-Q1_0 aggressivamente compressa da 397 GB su quattro sistemi DGX Spark, ma quella strada è una quantizzazione estrema sperimentale più che una baseline per serving attento alla qualità.
Per una workstation o un home lab, il modello più appropriato è Qwen3.8-27B, i cui open weights sono stati rilasciati il 14 agosto 2026. Il modello è ordini di grandezza più semplice da ospitare ed è l’opzione giusta se “locale” significa una sola workstation invece di un cluster di GPU.
Prima di installare Qwen 3.8 Max
Pianifica l’infrastruttura prima di eseguire un comando di installazione. Ti servono Linux, uno stack acceleratore compatibile, spazio di archiviazione locale o condiviso sufficiente per il checkpoint, interconnessioni GPU a banda larga e—quando attraversi nodi—una rete progettata per l’inferenza distribuita. La ricetta vLLM attualmente consiglia vLLM nightly e Transformers 5.4.0 o superiore.
FP8 è una scelta sensata quando vuoi un checkpoint fornito da Qwen e puoi permetterti un’infrastruttura multi-nodo. Il checkpoint ufficiale è Qwen/Qwen3.8-2.4T-A95B-FP8.
Per un deployment a due nodi e 16 GPU classe B300, esegui il nodo head con:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr "$HEAD_ADDR" \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
On the worker node, use the same topology with a different node rank and no API server:
Non copiare l’esempio a 16 GPU su server H200 senza ridimensionare la topologia. La stessa variante FP8 è attualmente dimensionata a 32× H200 nella ricetta vLLM.
Come eseguire Qwen 3.8 su un server 8× B300
Per NVIDIA Blackwell, la configurazione full-model più pratica è NVFP4. vLLM attualmente valida NVFP4 W4A4 con parallelismo tensoriale su otto GPU B300.
La build NVFP4 di Inferact è un checkpoint quantizzato piuttosto che l’artefatto Qwen BF16 originale. Valida la qualità del modello sul tuo set di accettazione prima di trattarlo come un sostituto diretto di BF16 o FP8.
Come distribuire Qwen 3.8 con SGLang
SGLang ha aggiunto il supporto Day-0 per Qwen3.8 il 12 agosto ed è particolarmente interessante per serving ad alto throughput, prefix caching, expert parallelism, speculative decoding e disaggregazione prefill/decode.
SGLang riporta 346 token di output/s a batch size 1 su TP8 B300 con MTP, e throughput aggregato sostanzialmente più alto in layout di serving disaggregati. Considera quei numeri come misure dello stack di serving, non come benchmark di qualità del modello.
Testa l’endpoint locale compatibile con OpenAI
Sia vLLM sia SGLang espongono API compatibili con OpenAI, cosa che rende l’integrazione applicativa semplice.
python
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://localhost:8000/v1",
    timeout=3600,
)

response = client.chat.completions.create(
    model="Qwen/Qwen3.8-2.4T-A95B-FP8",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant Redis architecture for three regions."
        }
    ],
    temperature=1.0,
    top_p=0.95,
    max_tokens=8192,
)

print(response.choices[0].message.content)
La model card ufficiale raccomanda temperature=1.0, top_p=0.95 e top_k=20 come parametri di campionamento baseline. Per il lavoro agentico, lascia sufficiente budget di output per il ragionamento invece di dimensionare max_tokens solo per la risposta visibile finale.
Non rendere 1M il default solo perché è supportato. Massimi contesti più ampi riservano più capacità di cache e possono ridurre drasticamente la concorrenza. Dimensiona --max-model-len in base al carico reale.
Come migliorare le prestazioni di inferenza di Qwen3.8?
Usa MTP-3 per ridurre la latenza per utente singolo
Qwen3.8 include la Multi-Token Prediction. Nelle misurazioni pubblicate da vLLM, MTP-3 porta l’output per utente da 130 a 307 tok/s per FP8 TP16 e da 133 a 304 tok/s per NVFP4 TP8.
Per modelli dell’ordine dei terabyte, il tempo di avvio conta. In una misurazione vLLM, il caricamento dei pesi è sceso da 545 s a 306 s con fastsafetensors e lazy loading.
Usa l’expert parallelism per aumentare il throughput concorrente
Per alta concorrenza, Qwen3.8 beneficia di layout con expert-parallel perché ha 512 esperti instradati. vLLM riporta fino a 3.200 tok/s/GPU totali per FP8 EP e fino a 4.300 tok/s/GPU totali per una configurazione NVFP4 DEP16 ottimizzata.
Imposta --max-model-len per bilanciare VRAM e concorrenza
Imposta --max-model-len alla sequenza più lunga di cui il carico ha davvero bisogno. Un valore maggiore riserva più capacità di KV cache, aumenta la pressione sulla memoria e può ridurre il numero di richieste concorrenti anche quando i pesi del modello già ci stanno.
Inizia con una percentile rappresentativa della produzione invece del massimo contesto pubblicizzato del modello. Esegui load-test del limite scelto con la stessa precisione, pattern di batch e motore di serving usati in produzione, poi aumentalo solo quando richieste reali necessitano più contesto.
Qwen 3.8 Max: deployment locale vs. API
Open weights non rendono automaticamente economica l’inferenza locale. La decisione corretta dipende da utilizzo, residenza dei dati, organico, obiettivi di disponibilità e dal fatto che tu abbia realmente bisogno delle funzionalità multimodali del modello gestito.
Dimensione
Qwen3.8-2.4T-A95B self-hosted
Qwen3.8-Max via CometAPI
Infrastruttura
Server multi-GPU o cluster
Nessuna infrastruttura GPU
Modalità input
Testo
Testo, immagine, video
Contesto
262K nativo; ~1,01M esteso
1M gestito
Controllo dati
Massimo
API cloud
Operazioni
Gestisci tu monitoraggio, upgrade e HA
Gestito dal provider
Best fit
Residenza dati, utilizzo sostenuto, team infrastruttura
La maggior parte dei team applicativi e carichi variabili
Se possiedi già acceleratori adeguati e hai utilizzo costante elevato, l’auto-hosting può essere giustificato. Se acquisteresti un cluster solo per questo modello, Qwen3.8-Max su CometAPI è di solito la via a minor attrito. L’attuale guida API copre l’integrazione ospitata, mentre la guida ai prezzi copre il cost modeling; questo articolo resta quindi focalizzato sul deployment locale.
Problemi comuni nel deployment locale di Qwen 3.8
Il server esaurisce la memoria GPU durante lo startup
Riduci prima --max-model-len se il problema è la cache. Se i pesi stessi non ci stanno, la riduzione del contesto non risolverà la radice del problema; passa a un checkpoint a precisione inferiore validato o aggiungi GPU.
Il tensor parallelism fallisce con una dimensione non valida
Qwen3.8 ha 64 teste di attenzione nei suoi layer di full-attention, quindi vLLM richiede che TP divida 64. Dimensioni TP semplici sono 1, 2, 4, 8, 16 e 32. La sola VRAM aggregata non basta quindi per scegliere una topologia.
Il server impiega molto ad avviarsi
Caricare da uno a diversi terabyte di pesi più JIT dei kernel può richiedere minuti. Aumenta VLLM_ENGINE_READY_TIMEOUT_S e sonda un vero endpoint di inferenza invece di presumere una finestra di startup breve.
Il modello locale non può elaborare un’immagine
È previsto. Il checkpoint open Qwen3.8-2.4T-A95B è solo testo. Questa limitazione è specifica per Qwen3.8-2.4T-A95B. Qwen3.8-27B supporta input visivi quando si caricano i suoi file di proiezione visiva separati.
Un contesto da 1M riduce drasticamente il throughput
Riduci --max-model-len alla sequenza più lunga effettivamente necessaria dal carico. La finestra di contesto massima supportata non è necessariamente la migliore impostazione di produzione; scegli un limite di contesto che bilanci requisiti del carico, uso della KV cache e concorrenza.
Ollama o LM Studio possono eseguire Qwen 3.8 Max?
L’ecosistema può impacchettare pesi Qwen3.8 fortemente quantizzati per inferenza stile llama.cpp, ma non va confuso con un normale workflow desktop di Ollama. Una build quantizzata che occupa centinaia di gigabyte richiede comunque centinaia di gigabyte di memoria accessibile e comporta compromessi significativi in qualità e prestazioni.
Per lo sviluppo locale ordinario, Qwen3.8-27B è il target appropriato. Il modello completo da 2,4T va trattato come un modello da server/cluster anche quando quantizzazioni estreme della community lo rendono tecnicamente avviabile su hardware insolito.
Quale metodo di deployment dovresti scegliere?
Per NVIDIA Blackwell, un deployment NVFP4 su 8× B300 è attualmente il punto di partenza full-model più pulito. Per AMD, 8× MI355X con MXFP4 è la configurazione pratica corrispondente. Usa FP8 quando dai priorità alla provenienza del checkpoint e alla qualità rispetto alla dimensione dell’infrastruttura, e BF16 solo quando la massima fedeltà giustifica requisiti di memoria scala multi-rack.
Per una workstation, usa Qwen3.8-27B. Per i team applicativi che necessitano delle capacità Max senza operazioni su cluster GPU, usa il modello Qwen3.8-Max ospitato su CometAPI.
Conclusione
Qwen3.8-Max ha superato un confine importante dal suo lancio API iniziale: la famiglia Qwen di classe Max ora ha un checkpoint open da 2,4T che le organizzazioni possono operare interamente sulla propria infrastruttura.
Ma open weights non significa hardware consumer. Il footprint BF16 da 4,45 TiB, il checkpoint FP8 da 2,27 TiB e le varianti FP4 da 1,3–1,5 TiB rendono Qwen3.8-2.4T-A95B uno dei modelli open più intensivi in termini di infrastruttura disponibili. Il lato pratico è che vLLM e SGLang supportano già l’architettura, e FP4 rende praticabile un deployment su un nodo singolo 8× B300 o 8× MI355X.
Fai self-hosting quando controllo dei dati, utilizzo sostenuto e proprietà dell’infrastruttura giustificano il cluster. Altrimenti, usa la Max API gestita—oppure Qwen3.8-27B quando ciò che desideri davvero è un forte modello Qwen su una sola workstation.