
TLDR Claude Haiku 5.5 è definito il modello piccolo più economico, veloce e capace mai rilasciato. Progettato per carichi ad alto volume e sensibili alla latenza come classificazione, estrazione, instradamento, sintesi e compiti di sottoagenti, offre una finestra di contesto da 1 milione di token, fino a 128K token di output, ragionamento adattivo con livelli di sforzo regolabili.
In media costa circa il 75% in meno da eseguire rispetto a Haiku 4.5, registrando al contempo grandi miglioramenti nei benchmark di agenti e uso del computer. Gli sviluppatori possono accedervi tramite l’API ufficiale di Claude (claude-haiku-5-5), Amazon Bedrock, Google Cloud, Microsoft Foundry o gateway ottimizzati per i costi come CometAPI (a partire da $0.08 / $0.40).
Punti chiave
- Rilascio e posizionamento: Lanciato il 7 ottobre 2026 come il modello piccolo ad alto throughput nella famiglia Claude 5.5—ideale per supporto in tempo reale, elaborazione documentale e passaggi delegati di agenti.
- Specifiche principali: Contesto da 1M token, output massimo 128K (300K via Batch API beta), ragionamento adattivo (sforzo predefinito medio), input testo + immagini → output testo, limite di conoscenza giugno 2026.
- Vantaggio di prezzo: $0.10 input / $0.50 output per milione di token per prompt fino a 100K (≈90% più economico di Haiku 4.5 sulla maggior parte delle richieste); fascia superiore oltre 100K. Letture cache fino a $0.01. CometAPI offre tariffe Standard ≈20% inferiori.
- Salto prestazionale: Grandi miglioramenti rispetto a Haiku 4.5 (ad es., OSWorld 72.4% vs 15.7%, Terminal-Bench 39.2% vs 0%, GDPval-AA 1620 vs 735 Elo) restando competitivo o avanti rispetto a GPT-6 Luna in molti test.
- Funzionalità per sviluppatori: Parametro effort (
low–max), caching del prompt, Batch API (sconto 50%), uso di computer/browser (supporto SDK beta). Temperature/top_p/top_k devono essere omessi o si verifica un errore 400.
Che cos’è Claude Haiku 5.5 e perché è importante nel 2026
Claude Haiku 5.5 è l’ultima proposta di Anthropic nel segmento leggero della famiglia Claude. A differenza dei più costosi modelli Opus 5.5 e Sonnet 5.5 ottimizzati per ragionamento complesso e agenti a lungo orizzonte, Haiku 5.5 è progettato per carichi ad alto volume, sensibili ai costi e alla latenza. Anthropic lo descrive come “il modello piccolo più economico, veloce e capace che abbiamo mai rilasciato.”
Casi d’uso tipici in produzione includono:
- Classificazione dei ticket e instradamento nel supporto clienti
- Estrazione di campi e sintesi da documenti lunghi
- Compattazione della cronologia di conversazione per modelli più grandi
- Query in stile database e compiti su dati strutturati
- Sottoagenti veloci che gestiscono passaggi ristretti di coding, uso di strumenti o browser mentre un modello più potente orchestra
Poiché è drasticamente più economico e veloce del suo predecessore, pur colmando gran parte del divario di qualità su compiti agentici pratici, molti team stanno ri-progettando le pipeline in modo che Haiku 5.5 gestisca la maggior parte delle richieste ed effettui l’escalation solo dei casi difficili a Sonnet o Opus. I primi feedback dei clienti da Asana, HubSpot, Box e altri evidenziano riduzioni della latenza superiori al 30% e misurabili incrementi di accuratezza su valutazioni interne ad alto volume.
Specifiche tecniche di Claude Haiku 5.5
| Specifiche | Valore | Note |
|---|---|---|
| ID modello (Claude API) | claude-haiku-5-5 | Nessun suffisso data |
| Amazon Bedrock | anthropic.claude-haiku-5-5 (o profili global/us/eu/au/jp) | |
| Finestra di contesto | 1,000,000 token | ≈555k parole con il nuovo tokenizer |
| Output max (Messages API) | 128,000 token | 300K con Batch API + header beta |
| Modalità di input | Testo + immagini | |
| Modalità di output | Testo | |
| Ragionamento | Adattivo (attivo per default) | Controllato via effort |
| Sforzo predefinito | medium | Opzioni: low, medium, high, xhigh, max |
| Limite di conoscenza | Giugno 2026 | |
| Impegno di ritiro | Non prima del 7 ottobre 2027 | |
| Tokenizer | Più recente (stessa famiglia di Claude 4.7+) | Stesso testo ≈30% più token di Haiku 4.5 |
Fonte: panoramica del modello Anthropic e documentazione della piattaforma.
I limiti maggiori di contesto e output, combinati con il ragionamento adattivo, rendono Haiku 5.5 molto più utilizzabile per sistemi reali di produzione rispetto ai precedenti modelli piccoli che richiedevano troncamenti aggressivi o budget di ragionamento fissi.
Verifica delle risposte e dei completamenti
Leggere i blocchi di contenuto per tipo, invece di assumere che content[0] sia la risposta visibile. Ispezionare stop_reason prima di accettare l’output: max_tokens indica una generazione troncata e refusal richiede una risposta applicativa esplicita. Per richieste con strumenti abilitati, elaborare i blocchi di uso degli strumenti e restituire i risultati degli strumenti in formato nativo invece di trattarli come una risposta testuale completata.
Cosa è cambiato rispetto all’API Claude Haiku 4.5?
Cambiamenti di capacità, comportamento e prezzo
| Dimensione | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| Finestra di contesto | 200K | 1M | 1M |
| Output massimo | 64K | 128K | 128K |
| Sforzo adattivo | No | Sì | Sì |
| Input Anthropic / MTok | $1.00 | $0.10 | $2.00 |
| Output Anthropic / MTok | $5.00 | $0.50 | $10.00 |
| Posizionamento | Modello rapido legacy | Lavoro di routine su scala | Compiti complessi più ardui |
I prezzi di Haiku 5.5 in questo confronto si applicano a prompt fino a 100.000 token; i prompt più lunghi costano di più. Queste sono tariffe Standard Anthropic, non tariffe CometAPI. Il confronto è un punto di partenza per l’instradamento, non un’affermazione che i modelli performino in modo identico.
Per le integrazioni Haiku 4.5, i principali cambiamenti d’implementazione sono il ragionamento adattivo al posto di un budget manuale, i controlli di sforzo, l’analisi selettiva dei blocchi di contenuto e i conteggi di token aggiornati. Lo stesso testo può utilizzare circa il 30% di token in più in input. Ricontare prompt rappresentativi invece di riutilizzare stime di token di Haiku 4.5. La sezione di migrazione traduce questi cambiamenti in una checklist di deployment.
Miglioramenti riportati nei benchmark
| Benchmark | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| OSWorld 2.1 (subset offline; credito parziale) | 15.7% | 72.4% | 83.9% |
| Terminal-Bench 4.0 | 0.0% | 39.2% | 70.6% |
| Humanity’s Last Exam (senza strumenti) | 10.2% | 45.9% | 56.9% |
| Chartography (senza strumenti) | 6.4% | 46.4% | 61.6% |
| GDPval-AA v2.1 (Elo) | 735 | 1,620 | 1,840 |
Anthropic riporta i punteggi sopra nel suo riassunto dei benchmark di lancio. Si tratta di risultati di valutazioni riportate, non di test live degli esempi CometAPI in questa guida. Il 72.4% di OSWorld è credito parziale, non un tasso rigoroso di completamento del task.
La system card di Haiku 5.5 descrive le condizioni di valutazione. Le valutazioni standard di Haiku 5.5 utilizzano ragionamento adattivo al massimo sforzo e sampling predefinito, salvo diversa indicazione; il default di prodotto è medium. OSWorld usa 82 task offline, nessun accesso a internet, risoluzione 1080p e un limite di 500 azioni. Terminal-Bench 4.0 utilizza Claude Code in modalità bare, nessuna uscita a internet e 10 trial per task per Haiku 5.5; l’impostazione di Sonnet differisce. Le righe HLE e Chartography sopra sono senza strumenti. GDPval-AA riporta un rating Elo da valutazioni Artificial Analysis. Allineare l’harness, lo sforzo e le impostazioni degli strumenti pertinenti quando si confrontano i risultati.
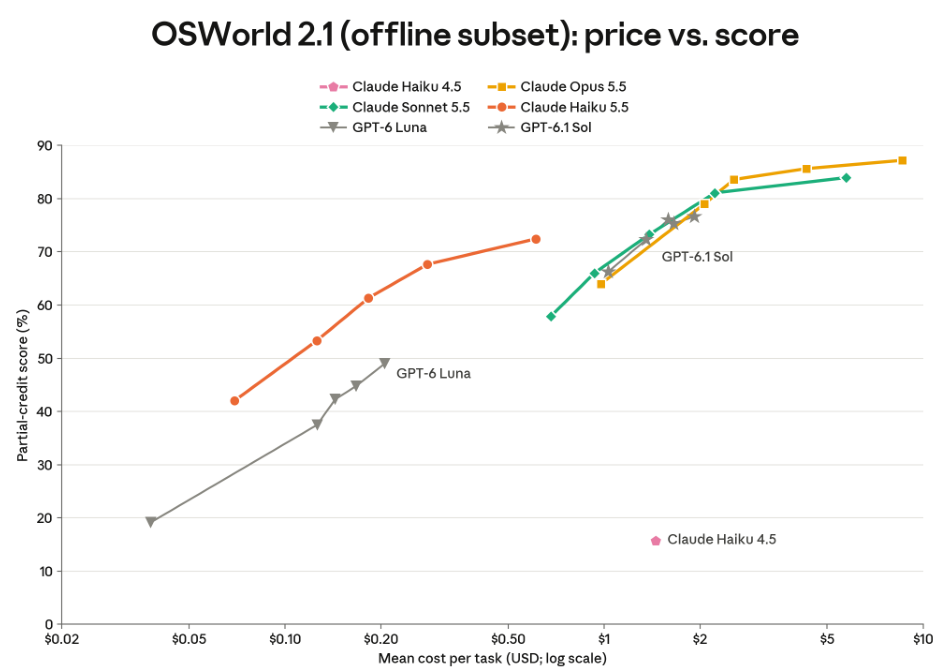
Il grafico OSWorld originale di Anthropic mostra la relazione tra sforzo, costo per task e punteggio a credito parziale. Non misura la latenza dell’API né garantisce la stessa performance nel vostro carico di lavoro.
I punteggi indicano prestazioni molto più solide nell’uso del computer e nei compiti generali rispetto a Haiku 4.5, ma non garantiscono gli stessi risultati nella vostra applicazione. Eseguire un set di valutazione rappresentativo prima di impegnare traffico in produzione.
La tabella dei benchmark e il grafico fornito sono mantenuti come confronti tra modelli. Sono valutazioni riportate piuttosto che test live degli esempi CometAPI. Usare la stessa distribuzione dei task, sforzo e impostazioni degli strumenti quando si valuta un’applicazione; un punteggio di benchmark non stabilisce la latenza del gateway né il vostro tasso di successo.
Come usare l’API Claude Haiku 5.5 tramite CometAPI
Crea una chiave e scegli il percorso nativo
Crea un account CometAPI, conferma l’accesso a claude-haiku-5-5 e genera una chiave API lato server. Imposta COMETAPI_KEY nel tuo ambiente. Tieni la chiave fuori dal controllo di versione e dal codice del browser. Le chiavi Anthropic e CometAPI appartengono a provider diversi; usa la chiave CometAPI per ogni esempio in questa guida aggiornata.
export COMETAPI_KEY="your_cometapi_api_key"
pip install --upgrade anthropic
$env:COMETAPI_KEY="your_cometapi_api_key"
| Integrazione | URL base SDK | Percorso richiesta | Credenziale |
|---|---|---|---|
| Messages compatibile con Anthropic | https://api.cometapi.com | /v1/messages | COMETAPI_KEY |
| Chat Completions compatibile con OpenAI | https://api.cometapi.com/v1 | /chat/completions | COMETAPI_KEY |
CometAPI supporta il formato nativo Messages e content-block di Claude. Usa l’SDK Anthropic con la root base URL di CometAPI. Messages nativo è il percorso preferito in questa guida per il ragionamento specifico di Claude e i blocchi di contenuto. La rotta compatibile Chat Completions è un’opzione per un’applicazione in stile OpenAI esistente. Confermare il supporto dei campi avanzati sulla rotta esatta del gateway.
Invia una richiesta minima e verifica il risultato
curl https://api.cometapi.com/v1/messages \
  -H "Content-Type: application/json" \
  -H "x-api-key: $COMETAPI_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -d '{
    "model": "claude-haiku-5-5",
    "max_tokens": 2048,
    "output_config": {"effort": "low"},
    "messages": [{"role": "user", "content": "Summarize three AI uses in customer support."}]
  }'
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",
    timeout=60.0,
    max_retries=2,
)

response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket: I cannot log in."}],
)
if response.stop_reason != "end_turn":
    raise RuntimeError(f"Unaccepted completion: {response.stop_reason}")
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
Salva l’esempio Python come example.py ed esegui python example.py. Un checkpoint riuscito è una risposta completata con testo visibile e campi di utilizzo. Un errore di autenticazione indica che la chiave va controllata; un errore di modello/percorso indica che l’ID modello, l’endpoint o l’accesso dell’account vanno verificati.
Usa lo stesso formato nativo da JavaScript
npm install @anthropic-ai/sdk
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com",
  timeout: 60_000,
  maxRetries: 2,
});
const response = await client.messages.create({
  model: "claude-haiku-5-5",
  max_tokens: 2048,
  output_config: {effort: "low"},
  messages: [{role: "user", content: "Extract product, quantity and price: 3 laptops at $900 each."}],
});
if (response.stop_reason !== "end_turn") {
  throw new Error("Unaccepted completion: " + response.stop_reason);
}
for (const block of response.content) {
  if (block.type === "text") console.log(block.text);
}
Usa una versione supportata di Node.js. Salva il file come example.mjs, imposta COMETAPI_KEY ed esegui node example.mjs. Registra la versione dell’SDK che validi per il deployment.
Adatta un’applicazione compatibile OpenAI esistente
Se la tua applicazione usa già Chat Completions, installa il pacchetto openai e configura il client separato qui sotto. Questo percorso restituisce choices invece dei blocchi di contenuto nativi. Mantieni separata l’analisi specifica della rotta e testa ragionamento, immagini e strumenti prima di affidarti alla traduzione del gateway.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    messages=[
        {"role": "system", "content": "Be concise and helpful."},
        {"role": "user", "content": "Explain API rate limits."},
    ],
)
print(response.choices[0].message.content)
Invio di immagini all’API Claude Haiku 5.5
Usa un’immagine insieme a un’istruzione che specifichi le evidenze e l’output di cui hai bisogno. L’interfaccia vision ufficiale accetta blocchi di contenuto immagine con dati base64, un URL di immagine o un riferimento a un file caricato supportato. Questo esempio legge un PNG locale, posiziona l’immagine prima della domanda e richiede valori che possano essere verificati rispetto alla fonte.
Analizza un PNG locale reale tramite l’API nativa Anthropic Messages.
import os
import base64
from pathlib import Path
import anthropic

# Replace dashboard.png with a real PNG file you are authorized to analyze.
image_data = base64.b64encode(Path("dashboard.png").read_bytes()).decode("ascii")
anthropic_client = anthropic.Anthropic(api_key=os.environ["ANTHROPIC_API_KEY"])
response = anthropic_client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    output_config={"effort": "low"},
    messages=[{
        "role": "user",
        "content": [
            {"type": "image", "source": {
                "type": "base64", "media_type": "image/png", "data": image_data
            }},
            {"type": "text", "text": (
                "Read the visible dashboard metrics. List anomalies with their "
                "labels and values, and state when text is unreadable."
            )},
        ],
    }],
)
for block in response.content:
    if block.type == "text":
        print(block.text)
Usa il MIME type che corrisponde al file effettivo. Verifica leggibilità, dimensioni dell’immagine e limiti di dimensione della richiesta prima dell’invio; evita di inviare media ad alta risoluzione che non aiutano il task. Per CometAPI, cambia la chiave e la root base URL come mostrato nell’esempio Messages, e verifica il supporto delle immagini sulla rotta esatta.
Controllo del ragionamento di Claude Haiku 5.5
Haiku 5.5 usa il ragionamento adattivo per impostazione predefinita. La configurazione ufficiale del thinking spiega quando “disabled” è accettato e come vengono restituiti i blocchi di thinking. Imposta lo sforzo tramite output_config.effort; non riutilizzare il legacy budget_tokens.
| Sforzo | Caso d’uso iniziale consigliato | Compromesso |
|---|---|---|
| low | Breve classificazione, estrazione semplice | Tipicamente minor uso di token e latenza |
| medium | Risposte di supporto, lavoro di routine degli agenti | Default bilanciato |
| high | Analisi documentale multi-step | Potenzialmente più ragionamento |
| xhigh | Valutazioni difficili | Più elaborazione e costo |
| max | Casi a forte intensità di ragionamento | Massima potenziale spesa di ragionamento |
Configura il ragionamento adattivo con sforzo low.
import osimport anthropicanthropic_client = anthropic.Anthropic( api_key=os.environ["ANTHROPIC_API_KEY"],)response = anthropic_client.messages.create( model="claude-haiku-5-5", max_tokens=4096, thinking={"type": "adaptive"}, output_config={"effort": "low"}, messages=[{"role": "user", "content": "Classify as billing, technical, or account: cannot log in."}],)for block in response.content: if block.type == "text": print(block.text)
Gli sviluppatori possono disabilitare il thinking a sforzo low, medium e high, ma non a xhigh o max. Il thinking consuma token di output fatturati e il budget max_tokens anche quando il suo testo è nascosto. Un campo thinking vuoto può comunque portare una firma; non prova che non sia avvenuto alcun ragionamento. Mantieni i blocchi di contenuto restituiti invariati quando continui conversazioni con strumenti.
Esempio di richiesta con thinking disabilitato
Invia un body nativo con thinking disabilitato.
{ "model": "claude-haiku-5-5", "max_tokens": 1024, "thinking": {"type": "disabled"}, "output_config": {"effort": "low"}, "messages": [ {"role": "user", "content": "Return sentiment only: positive, neutral, negative."} ]}
Streaming delle risposte di Claude Haiku 5.5
Lo streaming consegna testo visibile in modo incrementale e migliora la reattività nelle applicazioni interattive. Tratta il testo in streaming come provvisorio finché la richiesta non si completa con successo.
Esegui lo streaming del testo visibile con l’SDK Python di Anthropic.
import osimport anthropicanthropic_client = anthropic.Anthropic( api_key=os.environ["ANTHROPIC_API_KEY"],)with anthropic_client.messages.stream( model="claude-haiku-5-5", max_tokens=4096, output_config={"effort": "low"}, messages=[{"role": "user", "content": "Explain API caching."}],) as stream: for text in stream.text_stream: print(text, end="", flush=True)
Prezzi dell’API Claude Haiku 5.5
Confronta tariffe per token e bande di lunghezza dei prompt
Tariffe verificate l’8 ottobre 2026. La tabella confronta i prezzi Standard Anthropic con le tariffe pubblicate CometAPI, in USD per milione di token. La banda è determinata dalla lunghezza del prompt: fino a 100.000 token rispetto a più di 100.000. Le richieste più lunghe usano le tariffe della banda superiore applicabile, non semplicemente una maggiorazione sui token in eccesso. La fatturazione dell’account, l’uso della cache e gli strumenti opzionali devono essere riconciliati separatamente.
| Categoria token | Anthropic ≤100K | CometAPI ≤100K | Anthropic >100K | CometAPI >100K |
|---|---|---|---|---|
| Input | $0.10 | $0.08 | $0.50 | $0.40 |
| Output | $0.50 | $0.40 | $2.50 | $2.00 |
| Lettura cache | $0.01 | $0.008 | $0.05 | $0.04 |
| Scrittura cache 5-min | $0.125 | $0.10 | $0.625 | $0.50 |
| Scrittura cache 1-ora | $0.20 | $0.16 | $1.00 | $0.80 |
La fotografia delle tariffe originali dell’articolo è mantenuta sopra. Controlla la lista attuale di CometAPI e la fatturazione dell’account prima dell’acquisto o del deployment; la tariffa di input di partenza nella lista non è un preventivo completo per ogni banda di lunghezza del prompt, operazione di cache o strumento opzionale.
Esempio: costo di 100.000 richieste di supporto
Supponi 100.000 richieste mensili, ciascuna con 2.000 token di input e 300 token di output fatturati, inclusi eventuali thinking generati. Ogni prompt rientra nella banda fino a 100K. Escludere caching, addebiti degli strumenti e retry.
| Componente | Utilizzo | Anthropic | CometAPI |
|---|---|---|---|
| Input | 200M token | $20.00 | $16.00 |
| Output | 30M token | $15.00 | $12.00 |
| Totale | 100,000 richieste | $35.00 | $28.00 |
In base a queste ipotesi, la differenza illustrativa è di $7 al mese, ovvero il 20%. I costi di produzione dipendono da lunghezze delle richieste, ragionamento nascosto, caching e comportamento dei retry.
Usa i conteggi di token correnti del modello nel calcolo. Costo = token di input × tariffa di input applicabile / 1,000,000 + token di output fatturati × tariffa di output applicabile / 1,000,000, più eventuali addebiti separati per cache, strumenti e retry. I token di thinking fanno parte dell’output fatturato.
Riduci i costi senza perdere la qualità dei task accettati
| Ottimizzazione | Azione | Beneficio |
|---|---|---|
| Tuning dello sforzo | Usa low dove la qualità lo consente | Minor overhead di ragionamento |
| Riduzione del prompt | Rimuovi cronologia ridondante | Meno token di input |
| Caching del prompt | Mantieni stabile il contesto riutilizzato | Minore costo di input ripetuto |
| Streaming | Renderizza i token man mano che arrivano | Miglior responsività percepita |
| Validazione schema | Rifiuta record malformati in anticipo | Meno rielaborazioni a valle |
| Instradamento modelli | Escala i compiti complessi | Miglior equilibrio costo-qualità |
| Elaborazione batch | Raggruppa richieste offline idonee | Potenziali risparmi aggiuntivi |
Non selezionare automaticamente lo sforzo più basso. Una chiamata individuale più economica può aumentare i costi totali se produce più retry. Valuta accuratezza, latenza p50/p95, uso di token e costo per task riuscito.
Per il caching del prompt, riutilizza un prefisso stabile e ispeziona la creazione della cache e le letture della cache invece di assumere un hit. Haiku 5.5 ha un minimo di 512 token cacheable sul documento dell’API Claude. Cambiare lo sforzo può invalidare i prefissi in cache; mantieni impostazioni stabili all’interno di una conversazione. Una finestra di contesto da 1M è un limite di capacità, non una raccomandazione a inviare ogni documento a ogni turno.
Mantieni un prefisso riutilizzabile stabile per il caching, accorcia input non necessari e valuta i cambiamenti di sforzo. Lo streaming migliora la responsività percepita senza ridurre automaticamente l’uso fatturato. Confronta il costo per task accettato sull’intero workflow, inclusi retry e chiamate di strumenti.
Guida alla migrazione da Claude Haiku 4.5 a Haiku 5.5
Aggiorna l’integrazione e il formato della richiesta
| Area | Azione di migrazione |
|---|---|
| ID modello | Sostituisci con claude-haiku-5-5 |
| Thinking | Sostituisci il budget_tokens manuale con ragionamento adattivo |
| Sforzo | Usa output_config.effort se necessario |
| Campionamento | Ometti temperature, top_p e top_k; qualunque valore top_k non è supportato |
| Parser di risposta | Gestisci più tipi di content-block |
| Budget di output | Consenti margine sufficiente per thinking e output finale |
| Prefill | Rimuovi il prefilling assistant non supportato |
| Caching | Ritesta i prompt quando cambi lo sforzo |
| Integrazioni tool | Verifica le versioni degli strumenti supportate |
Per la rotta CometAPI usata qui, mantieni COMETAPI_KEY e la base URL nativa cambiando l’ID modello e la configurazione della richiesta. Sostituisci il thinking legacy abilitato con budget con thinking adattivo e effort. Rimuovi il prefilling dell’assistente e ometti i parametri di sampling. Preserva la distinzione tra l’array di contenuti nativo di Claude e la risposta choices della rotta compatibile.
Preserva lo stato e ricalcola i budget
La guida di migrazione ufficiale di Haiku 5.5 riporta circa il 30% in più di token di input per testo identico rispetto a Haiku 4.5. Ricontare i prompt rappresentativi e ritoccare i limiti prima di spostare traffico. I blocchi di thinking restituiti funzionano solo nell’account che li ha prodotti o in un account collegato; un cambio account può far cadere silenziosamente tali blocchi. Preserva un prefisso di conversazione in sola append piuttosto che modificare messaggi precedenti dopo la generazione. Ispeziona stop_reason, inclusi max_tokens e refusal, e gestiscili esplicitamente prima di accettare l’output.
Ricontare i prompt rappresentativi con il modello target e ritoccare max_tokens, limiti di latenza e stime dei costi della richiesta. Testa conversazioni memorizzate contro l’account e la rotta del gateway che le riprodurranno; non assumere che i blocchi di thinking firmati siano portabili tra account non correlati o prefissi di conversazione riscritti.
Conclusioni
Claude Haiku 5.5 rappresenta un vero punto di svolta per un’IA efficiente in termini di costi e ad alto throughput. Offrendo prestazioni agentiche e di uso del computer nettamente migliori a circa un decimo del prezzo del precedente Haiku sulla maggior parte delle richieste, Anthropic ha reso pratico il deployment su larga scala di modelli piccoli ma capaci. Che si chiami l’API ufficiale, si passi da Amazon Bedrock o si usi un gateway unificato come CometAPI per ulteriori risparmi e semplicità operativa, la combinazione di velocità, capacità e prezzo apre nuove possibilità di prodotto prima antieconomiche.