Specifiche tecniche di MiniMax M3.1-Flash-Preview
| Voce | MiniMax M3.1-Flash-Preview |
|---|---|
| ID modello | MiniMax-M3.1-Flash-Preview |
| Famiglia del modello | Serie MiniMax M3.1, modello di codice in anteprima |
| Stato di rilascio | Anteprima; annunciato il 27 settembre 2026 |
| Focus principale | Sviluppo software quotidiano, dalle correzioni di bug alla realizzazione completa di funzionalità |
| Finestra di contesto | 1,000,000 token |
| Modalità di input | Testo, immagini e video |
| Modalità di output | Testo |
| Controllo del ragionamento | reasoning_effort: low, medium, high, xhigh, max |
| Comportamento del pensiero | È richiesto un pensiero adattivo; la documentazione pubblica esaminata non prevede la disattivazione del pensiero |
| Output massimo | Non pubblicato separatamente nei materiali pubblici esaminati |
| Numero di parametri | Non divulgato pubblicamente |
| Pesi aperti | Nessun checkpoint/repository pubblico del modello identificato |
MiniMax ha annunciato M3.1-Flash-Preview per MiniMax Code il 27 settembre 2026, posizionandolo per attività di sviluppo quotidiane quali correzione di bug e consegna completa di funzionalità. La copertura pubblica attuale identifica costantemente una finestra di contesto da 1M token e uno sforzo di ragionamento regolabile, pur notando che non sono stati pubblicati una tabella di benchmark autonoma né un prezzo per token.
Che cos'è MiniMax M3.1-Flash?
MiniMax M3.1-Flash-Preview è un modello testuale in anteprima orientato al coding, progettato per flussi di lavoro di sviluppo software iterativi piuttosto che per la sola generazione di codice. MiniMax descrive il flusso di lavoro come comprendente comprensione dei requisiti, localizzazione dei problemi, implementazione, test di regressione e verifica delle modifiche rispetto alla funzionalità esistente.
I suoi controlli distintivi documentati sono il lungo contesto e una scala di sforzo di ragionamento a cinque livelli. I livelli disponibili sono low, medium, high, xhigh e max, consentendo agli sviluppatori di bilanciare profondità di ragionamento e latenza in base alla complessità del compito.
Caratteristiche principali di MiniMax M3.1-Flash-Preview
- Contesto da 1M token: La descrizione pubblicata del modello attribuisce al modello in anteprima una finestra di contesto da un milione di token, rendendolo adatto a repository di grandi dimensioni, specifiche lunghe e sessioni estese di agent di coding.
- Input multimodale nativo: Le descrizioni pubbliche del modello elencano testo, immagini e video come input, mentre il modello restituisce testo.
- Cinque livelli di sforzo di ragionamento:
low,medium,high,xhighemaxoffrono un controllo più fine sulla profondità di ragionamento rispetto a un semplice interruttore on/off. - Flusso di lavoro di sviluppo end-to-end: MiniMax posiziona specificamente il modello per localizzazione dei bug, implementazione, gestione dei casi limite, completamento dei test di regressione e validazione delle modifiche.
- Distribuzione orientata all’anteprima: Il rollout pubblico iniziale avviene tramite MiniMax Code e Token Plan, invece di un’offerta autonoma a consumo completamente documentata.
- Adatto agli agent di coding: Il modello è pensato per interazioni di sviluppo ripetute in cui il contesto del repository, l’output degli strumenti, i test e le correzioni iterative contano più della generazione di codice one-shot.
MiniMax M3.1-Flash-Preview vs altri modelli di coding MiniMax
| Modello | Focus | Contesto | Dati di benchmark pubblici | Accesso/stato |
|---|---|---|---|---|
| M3.1-Flash-Preview | Coding quotidiano, sviluppo iterativo | 1M | Non ancora pubblicati | Anteprima; MiniMax Code / Token Plan |
| M3 | Coding d’avanguardia + lavoro agentico, multimodalità nativa | Fino a 1M | Pubblicati da MiniMax | API, Token Plan, MiniMax Code |
| M2.7 | Ingegneria del software + ampio lavoro di agent/produttività | Non utilizzato qui in quanto copia della specifica M3.1 | Pubblicati da MiniMax | API, Token Plan, Agent |
M3 è il punto di riferimento più ampiamente documentato: MiniMax pubblica la sua architettura, la metodologia di valutazione per coding/agent e la disponibilità API. M2.7 dispone allo stesso modo di un record pubblico di benchmark e integrazione API. M3.1-Flash-Preview è più recente e attualmente ha un’impronta documentale pubblica più ristretta, quindi i confronti dovrebbero concentrarsi sul posizionamento documentato invece di proclamare un vincitore nei benchmark. 4
Casi d’uso rappresentativi
- Correzione di bug a livello di repository: Fornire al modello una grande base di codice, descrizione del problema, log e test e utilizzare il lungo contesto per preservare il contesto di progetto rilevante.
- Implementazione di funzionalità: Usare il modello per passare da un requisito in linguaggio naturale alle modifiche al codice e ai test di regressione.
- Revisione del codice e interventi correttivi: Chiedergli di identificare i casi limite, proporre patch e verificare che le modifiche non compromettano il comportamento esistente.
- Debug multimodale: Fornire screenshot, diagrammi o video insieme ai requisiti testuali quando il contesto visivo fa parte del problema ingegneristico.
- Sessioni di agent di coding di lunga durata: Usare l’ampia finestra di contesto per specifiche, file di repository, output del terminale e risultati di test iterativi.
- Sviluppo sensibile alla velocità: Selezionare un livello di sforzo di ragionamento inferiore per modifiche routinarie e aumentarlo per cambiamenti multi-step più complessi.
Come accedere all’API di MiniMax M3.1-Flash-Preview
Passaggio 1: Registrarsi per ottenere la chiave API
Accedi a cometapi.com. Se non sei ancora nostro utente, registrati prima. Accedi alla tua console CometAPI. Ottieni la chiave API delle credenziali di accesso dell’interfaccia. Fai clic su “Add Token” alla voce API token nel centro personale, ottieni la chiave del token: sk-xxxxx e invia.
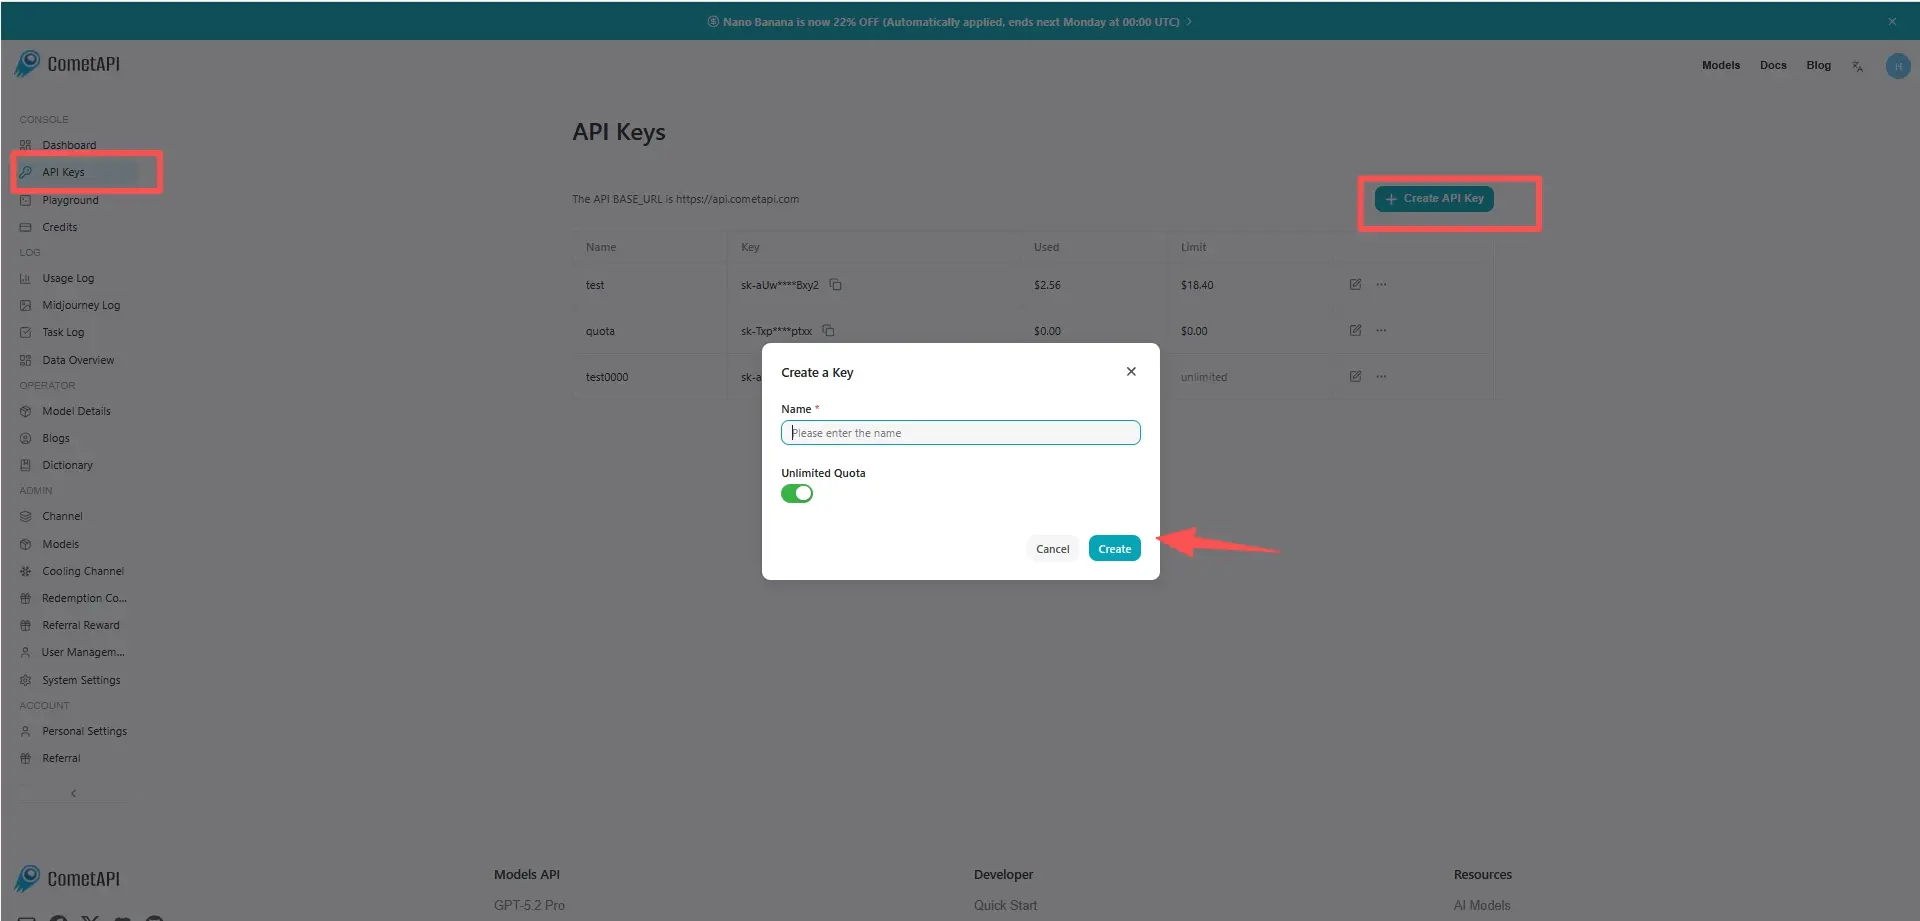
Passaggio 2: Inviare richieste all’API MiniMax M3.1-Flash-Preview
Seleziona l’endpoint “minimax-m3.1-flash-preview” per inviare la richiesta API e imposta il corpo della richiesta. Il metodo e il corpo della richiesta sono disponibili nella documentazione API sul nostro sito web. Il nostro sito fornisce anche test Apifox per tua comodità. Sostituisci <YOUR_API_KEY> con la tua chiave CometAPI effettiva del tuo account. la base URL è Chat Completions .
Inserisci la tua domanda o richiesta nel campo content—è a questo che il modello risponderà . Elabora la risposta dell’API per ottenere la risposta generata.
Passaggio 3: Recuperare e verificare i risultati
Elabora la risposta dell’API per ottenere la risposta generata. Dopo l’elaborazione, l’API risponde con lo stato dell’attività e i dati di output.