
In sintesi
Kimi K3.1 Pro è l’aggiornamento del 24 ottobre 2026 di Moonshot AI per Kimi K3. Ulteriore post-training migliora il coding autonomo, la ricerca finanziaria e i workflow estesi di uso degli strumenti, mantenendo la stessa capacità di contesto di circa un milione di token.
Valutazioni indipendenti mostrano prestazioni complessive più solide e le tariffe standard ufficiali per token in input/output si riducono di un terzo. L’aggiornamento richiede comunque test sui carichi di lavoro: un ragionamento più profondo può aumentare la latenza dei task e la spesa totale, mentre K3 mantiene un piccolo vantaggio su AA-LCR e al momento ha pesi disponibili per il self-hosting.
Punti chiave
- I guadagni più netti sono nell’esecuzione agentica. Artificial Analysis riporta punteggi Terminal-Bench 4.0 di circa 67% per K3.1 Pro contro 13% per K3; nei test interni di Moonshot, i punteggi di Financial Research salgono da 58,8 a 70,4.
- Prezzi per token più bassi non garantiscono costi per task più bassi. Le tariffe standard ufficiali input/output scendono da $3/$15 a $2/$10 per milione di token, ma ulteriore ragionamento, chiamate a strumenti e retry possono annullare il risparmio.
- La finestra di contesto resta la stessa. Entrambi i modelli supportano fino a 1.048.576 token. K3 resta leggermente avanti nella valutazione AA-LCR v1.1 citata, quindi testate l’accuratezza su contesti lunghi con i vostri documenti.
- La disponibilità dei pesi può determinare la scelta. Al 24 ottobre 2026, i pesi di K3 sono disponibili; i pesi di K3.1 Pro sono programmati per il rilascio entro il 4 novembre. I team che necessitano di self-hosting immediato dovrebbero considerare questa differenza.
Kimi K3.1 Pro vs Kimi K3: panoramica e specifiche
Kimi K3.1 Pro si basa su K3 tramite ulteriore post-training, con miglioramenti focalizzati su coding, ricerca finanziaria e workflow agentici estesi. Entrambi mantengono circa un milione di token di contesto. Le principali differenze riguardano prestazioni sui task, prezzi per token, opzioni di serving e disponibilità dei pesi.
| Specifica | Kimi K3.1 Pro | Kimi K3 |
|---|---|---|
| Developer | Moonshot AI | Moonshot AI |
| Release date | 24 ottobre 2026 | 16 luglio 2026 |
| Architecture | MoE derivato da K3, ulteriore post-training | MoE con KDA, AttnRes |
| Model size | classe 3T e 104B parametri attivi | 2.8T totali e 104B parametri attivi |
| Context window | Fino a 1.048.576 token | Fino a 1.048.576 token |
| Standard API input / output price | $2 / $10 per milione di token | $3 / $15 per milione di token |
| Highspeed version | Disponibile | Non è elencata una variante Highspeed separata per K3 |
| Weight availability | Rilascio previsto entro il 4 novembre 2026 | Disponibili con la Kimi K3 License |
La disponibilità dei pesi riflette le informazioni disponibili al 24 ottobre 2026. I prezzi API sono in USD per input e output regolari, esclusi addebiti per cache-write, tasse e altre tariffe applicabili.
Architettura e post-training
K3 ha introdotto un’architettura da 2,8 trilioni di parametri che combina Kimi Delta Attention, Attention Residuals e Stable LatentMoE. Attiva circa 104 miliardi di parametri per token.
Moonshot descrive K3.1 Pro come una versione post-trainata di K3 sviluppata con una potenza di post-training sostanzialmente maggiore. L’aggiornamento si concentra sull’applicazione delle capacità del modello in task multi-step, inclusi l’uso di strumenti, il debugging e la verifica dei risultati. L’annuncio non introduce un’architettura base con nome separato.
Capacità condivise e requisiti API
Entrambi i modelli supportano input multimodali, chiamata di strumenti, output strutturati e context caching. I formati di input immagine e video dipendono dalla route API selezionata. Entrambi ragionano sempre e supportano livelli di sforzo di ragionamento low, high e max, con max come default.
Per conversazioni multi-turn e chiamate a strumenti, le integrazioni devono preservare i messaggi completi dell’assistente, compresi contenuti di ragionamento e chiamate agli strumenti, come richiesto dall’API. I limiti effettivi di contesto e la disponibilità delle funzionalità vanno verificati per il provider, il prodotto e il piano di abbonamento selezionati.
Kimi K3.1 Pro vs Kimi K3: prestazioni
Le evidenze provengono dai test interni di Moonshot e da confronti riportati, insieme a valutazioni indipendenti di terze parti.
Queste dovrebbero essere interpretate separatamente perché i framework di benchmark, i set di test, le impostazioni di ragionamento e i criteri di scoring possono differire.
La valutazione di lancio di Artificial Analysis riporta un aumento di 11 punti nel suo Indice di Intelligenza composito, con miglioramenti particolarmente ampi nel coding basato su terminale e nei workflow agentici.
| Benchmark indipendente (Artificial Analysis) | Kimi K3 | Kimi K3.1 Pro | Differenza |
|---|---|---|---|
| Intelligence Index | 44 | 55 | +11 |
| Terminal-Bench 4.0 | ~13% | ~67% | +54 punti percentuali |
| AutomationBench-AA | 58% | 73% | +15 pp |
| GDPval-AA Elo | 1.534 | 1.846 | +312 |
| AA-Omniscience Index | 20 | 30 | +10 |
| Humanity's Last Exam | ~47% | ~52% | +5 pp |
| AA-Omniscience hallucination rate | 53% | 44% | −9 pp |
| AA-LCR v1.1 | 88,7% | 86,3% | −2,4 pp |
Questi sono risultati di valutazioni indipendenti. Si usano valori arrotondati dove il valutatore riporta punteggi arrotondati. Tassi di allucinazione più bassi sono migliori.
Il miglioramento più grande si verifica nel coding basato su terminale. K3.1 Pro si comporta sostanzialmente meglio in task che richiedono esecuzione di comandi, interazione con l’ambiente, debugging e validazione ripetuta.
Anche AutomationBench-AA mostra un guadagno significativo, suggerendo una più forte esecuzione in workflow SaaS.
I benchmark di rilascio di Moonshot si concentrano su coding, scienza, ricostruzione 3D, finanza, lavoro della conoscenza e agenti autonomi.
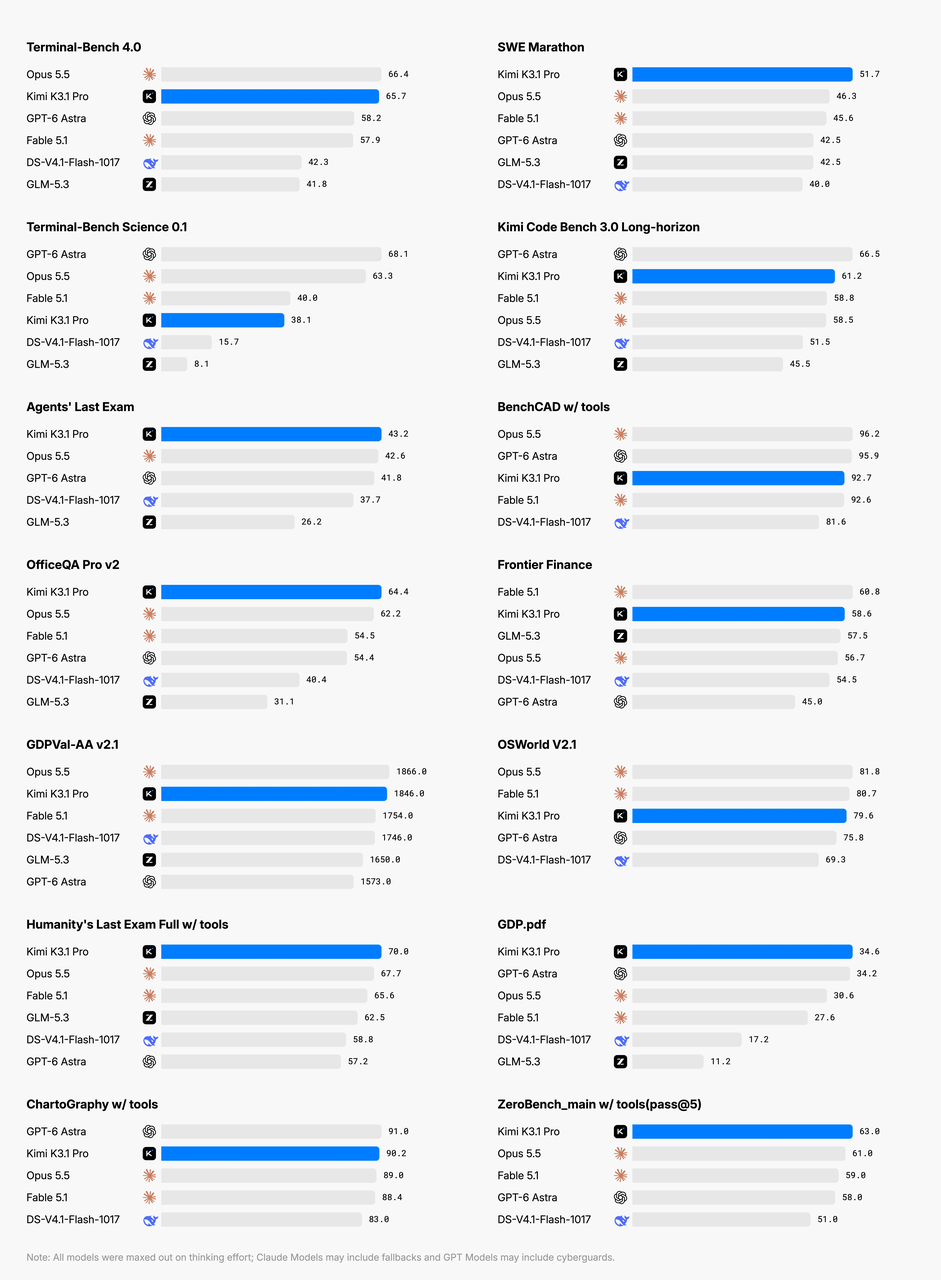
I confronti selezionati includono Claude Opus 5.5 e GPT-6 Astra. Confrontate ogni risultato all’interno del benchmark nominato e della configurazione indicata.
| Benchmark (Moonshot AI) | Kimi K3.1 Pro | Altro modello | Punteggio del modello di confronto |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | Claude Opus 5.5 | 66,4% |
| Terminal-Bench 4.0 | 65,7% | GPT-6 Astra | 58,2% |
| SWE-Marathon | 51,7% | Claude Opus 5.5 | 46,3% |
| Kimi Code Bench 3.0 | 61,2% | GPT-6 Astra | 66,5% |
| BenchCAD con strumenti | 92,7% | Claude Opus 5.5 | 96,2% |
| OfficeQA Pro v2 | 64,4 | Claude Opus 5.5 | 62,2 |
| Frontier Finance | 58,6 | Claude Opus 5.5 | 56,7 |
| OSWorld 2.1 | 79,6% | Claude Opus 5.5 | 81,8% |
K3.1 Pro si avvicina o supera diversi modelli proprietari leader in task selezionati. Ma non domina ogni categoria.
Per esempio, resta dietro a Claude Opus 5.5 nei confronti vendor-reported di BenchCAD e OSWorld, e il grafico ufficiale mostra una debolezza più marcata in Terminal-Bench Science.
Le configurazioni di valutazione differiscono: Artificial Analysis usa l’harness mini-swe-agent per Terminal-Bench 4.0, mentre Moonshot usa Claude Code. Confrontate i punteggi all’interno dello stesso setup di test; harness, sforzo di ragionamento e limiti di runtime possono influenzare i risultati.
Coding e ingegneria del software
Per il coding autonomo complesso, K3.1 Pro è generalmente la scelta più forte.
Nei risultati interni di Moonshot per Kimi Code Bench 3.0 Long-horizon, si passa da 55,95% per K3 a 61,2% per K3.1 Pro, un guadagno di circa 5,25 punti percentuali.
Anche i risultati indipendenti di Terminal-Bench mostrano un guadagno sostanziale. Questi test valutano l’esecuzione multi-step: comprendere un repository, modificare file, eseguire comandi, diagnosticare errori e verificare il risultato.
K3.1 Pro è il candidato più forte per sviluppo multi-file, lavoro autonomo su terminale e debugging esteso. Per la generazione di codice semplice, confrontate entrambi i modelli sui vostri task; K3 resta l’opzione immediata quando è richiesto il self-hosting.
Una distinzione importante è che i punteggi di benchmark per il coding dipendono fortemente dal framework agentico. Strumenti, prompt, limiti di runtime e ambienti di test influenzano l’esito.
Per lo sviluppo software in produzione, la migliore valutazione resta un confronto a parità di condizioni sui vostri repository.
Ricerca finanziaria e operazioni di business
La modellazione finanziaria fornisce alcuni dei confronti più diretti tra i due modelli.
Moonshot ha testato K3 e K3.1 Pro in valutazioni interne che coprono costruzione di fogli di calcolo, qualità della ricerca e operazioni di business simulate.
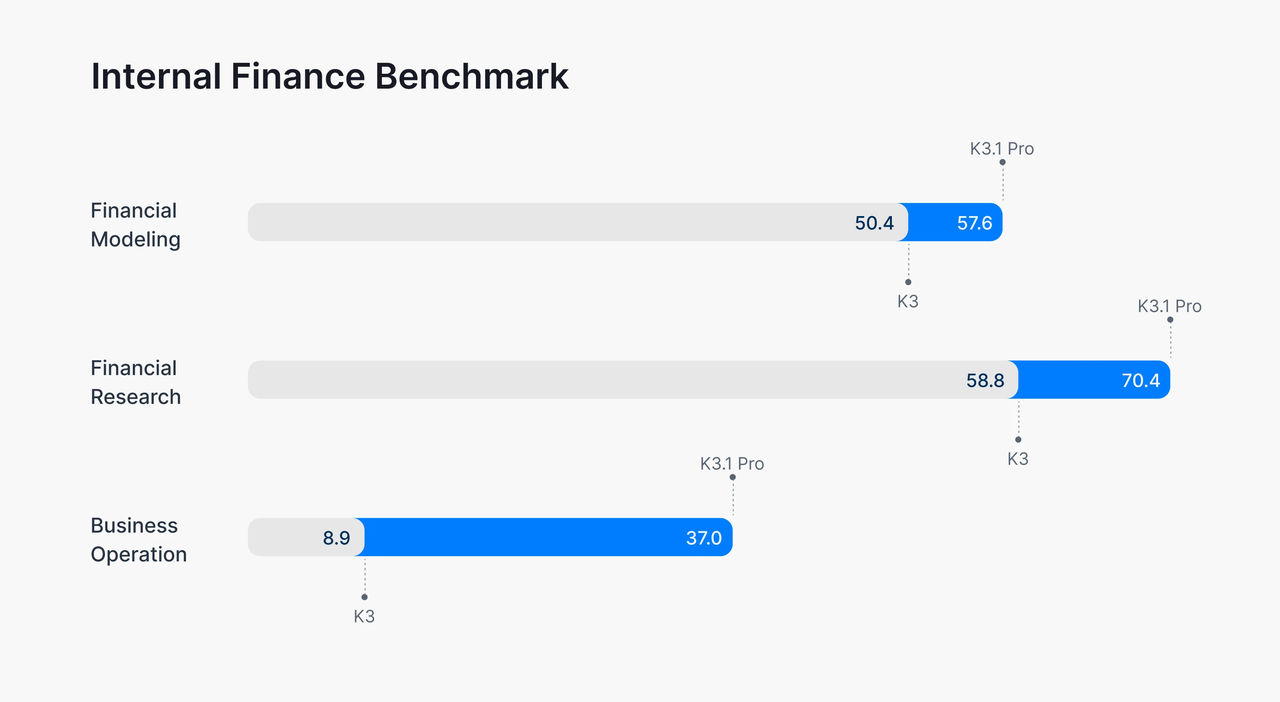
I risultati finanziari interni di Moonshot coprono modellazione finanziaria, ricerca e operazioni di business simulate. Questi punteggi di task riportati dal vendor non misurano i rendimenti degli investimenti. Le impostazioni per singolo task non devono essere considerate identiche a benchmark non correlati.
Nei test interni di Moonshot, Financial Modeling sale da 50,4 a 57,6, un guadagno di 7,2 punti, e Financial Research sale da 58,8 a 70,4, un guadagno di 11,6 punti. Business Operation aumenta da 8,9 a 37,0, circa 4,2 volte il punteggio di K3.
Questo benchmark valuta gestione e decision-making a lungo orizzonte in un ambiente di business simulato. È quindi più vicino alla pianificazione agentica che al semplice Q&A finanziario.
Financial Research misura la capacità di produrre ricerca basata su evidenze rispettando i requisiti delle fonti e i cutoff informativi. Financial Modeling si concentra su relazioni matematiche, logica dei fogli di calcolo e qualità dei workbook.
Il pattern suggerisce che K3.1 Pro è particolarmente prezioso quando i task finanziari richiedono ragionamento sostenuto, verifica e deliverable strutturati.
Per investitori, analisti e utenti business, il vantaggio pratico è la gestione potenzialmente migliore di workflow multi-documento. Nessuno dei due modelli dovrebbe essere usato come autorità indiscussa per decisioni finanziarie.
Ragionamento su contesti lunghi e affidabilità fattuale
Tuttavia, i risultati AA-LCR su contesto lungo mostrano un leggero vantaggio per K3. È un utile promemoria del fatto che un modello più recente può migliorare sostanzialmente nel complesso senza vincere ogni task specializzato.
Le valutazioni riportate mostrano meno errori fattuali sui rispettivi set di test.
Su Kimi Hallu Bench Hard con strumenti, Moonshot riporta che il tasso di errore a livello di affermazione è sceso dal 23,4% per K3 all’8,3% per K3.1 Pro.
Si tratta di una riduzione relativa di circa il 65% sullo stress test volutamente difficile di Moonshot, non di una stima dei tassi di errore quotidiani. Separatamente, Artificial Analysis riporta un calo del tasso di allucinazioni AA-Omniscience dal 53% al 44%. Le due valutazioni usano metodi diversi, quindi le percentuali non sono direttamente comparabili.
La lezione pratica è che K3.1 Pro appare più affidabile sui task valutati, ma i miglioramenti fattuali non eliminano la necessità di retrieval, citazioni, verifiche di calcolo e revisione umana in workflow consequenziali.
Analisi dei dati: evidenze dalla valutazione di Plotly
Plotly ha valutato K3.1 Pro standard tramite OpenRouter utilizzando un test privato di 43 domande su un data warehouse sintetico di energia eolica. Non è stata testata la versione Highspeed. I risultati illustrano il trade-off tra qualità della risposta, tempo di completamento e costo in quello specifico workflow analitico basato su SQL.
| Misura di Data Analytics (Plotly) | Kimi K3 | Kimi K3.1 Pro |
|---|---|---|
| Risposte corrette | 35/43 | 42/43 |
| Accuratezza | 81,4% | 97,7% |
| Pattern nascosti scoperti | 0/5 | 5/5 |
| Problemi di qualità dati trovati | 1/3 | 3/3 |
| Costo della valutazione completa | $5,01 | $13,47 |
| Tempo mediano per domanda | 43 s | 2,5 minuti |
In questa valutazione, K3.1 Pro ha risposto correttamente a più domande e ha identificato più pattern nascosti e problemi di qualità dei dati, ma con costi più elevati e tempi mediani più lunghi.
Gli addebiti riportati sono i costi osservati della valutazione, non stime calcolate dai prezzi API standard di Moonshot. La configurazione pubblicata non dimostra che tutte le impostazioni del provider fossero identiche tra le due esecuzioni, quindi le differenze non possono essere attribuite al solo modello.
Questi risultati supportano la valutazione di K3.1 Pro per task analitici in cui ulteriori riscontri potrebbero giustificare più tempo e spesa. Non stabiliscono lo stesso livello di accuratezza o un vantaggio di costo nelle stesse condizioni.
Kimi K3.1 Pro è più veloce di Kimi K3?
Distinguete la velocità di emissione dei token di output dalla latenza end-to-end del task.
Artificial Analysis riporta 73,5 token di output al secondo per K3.1 Pro, rispetto a 38,5 per K3 con sforzo di ragionamento massimo, utilizzando l’API di Kimi. Si tratta di misure di generazione dei token, verificate il 24 ottobre 2026; la latenza totale del task dipende anche dalla lunghezza del ragionamento e dall’esecuzione degli strumenti.
Tuttavia, una generazione di token più veloce non garantisce un completamento del task più rapido.
Moonshot offre anche K3.1 Pro Highspeed, pubblicizzato come in grado di fornire una velocità di output circa due o tre volte superiore alla variante standard. Si tratta di un miglioramento della velocità di serving, non di un incremento di intelligenza separatamente verificato.
K3.1 Pro ha una velocità di emissione dei token di output più alta, ma non necessariamente completa i task più velocemente. Distinguete la velocità di generazione dei token dal tempo richiesto per ragionare, chiamare strumenti e portare a termine il lavoro.
Velocità di output vs tempo di completamento del task
Artificial Analysis riporta velocità di output di 73,5 token al secondo per K3.1 Pro e 38,5 per K3 con sforzo di ragionamento massimo, utilizzando l’API di Kimi. Queste misure sono state verificate il 24 ottobre 2026 e descrivono il throughput di generazione dei token, non la latenza end-to-end del task.
Un modello può generare token più rapidamente pur impiegando più tempo complessivo se produce più token di ragionamento o effettua ulteriori chiamate a strumenti. Nella valutazione di Plotly discussa sopra, il tempo mediano di completamento di K3.1 Pro è stato di 2,5 minuti per domanda, contro 43 secondi per K3, insieme a un’accuratezza più alta.
Per applicazioni interattive, misurate il tempo al primo token e il tempo totale di completamento del task sulla route effettiva del provider. Il solo throughput di output non è sufficiente a prevedere la reattività.
Considerare K3.1 Pro Highspeed
Moonshot pubblicizza K3.1 Pro Highspeed come capace di fornire una velocità di output circa due o tre volte superiore rispetto a K3.1 Pro standard. Tale affermazione riguarda la velocità di serving; non va interpretata come una riduzione di due o tre volte del tempo totale di completamento del task.
Considerate Highspeed per coding interattivo o assistenti in cui gli utenti attendono le risposte. Confrontate latenza end-to-end, successo del task e costo totale fatturato rispetto all’endpoint standard prima di sceglierlo. Highspeed ha prezzi più alti per token di input regolari e di output, mentre la tariffa per input in cache è la stessa.
Kimi K3.1 Pro vs Kimi K3: costi
Tariffe ufficiali API e CometAPI
Le tariffe ufficiali standard di K3.1 Pro per input, output e cache-hit sono inferiori di un terzo rispetto a quelle di K3. Le tariffe CometAPI elencate sono ulteriormente inferiori del 20% rispetto alle corrispondenti tariffe ufficiali.
| Modello | Official Input / 1M | Official Output / 1M | Official Cached Input / 1M | CometAPI Input / 1M | CometAPI Output / 1M |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $1.60 | $8.00 |
| Kimi K3 | $3.00 | $15.00 | $0.30 | $2.40 | $12.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | Check current quote | Check current quote |
USD per milione di token; tariffe verificate il 24 ottobre 2026. Le colonne Input mostrano le tariffe regolari per input non in cache. Tasse e addebiti separati sono esclusi.
Il pricing ufficiale di Kimi elenca anche gli addebiti per cache-write: $2/$4 per milione di token per Pro standard con retention di 5 minuti/1 ora, e $4/$8 per Highspeed. Cache hit, cache write e input regolare sono categorie di fatturazione separate e mutuamente esclusive.
Kimi ufficiale e CometAPI sono route di provider separate. Confermate prezzi attuali e supporto della cache per la route selezionata, inclusa la disponibilità di Highspeed. Confrontate il costo totale per task fatturato oltre alle tariffe per token.
Esempio a token fissi
Si consideri un carico che consuma 100.000 token di input non in cache e 20.000 token di output.
Per questo carico fisso, il costo API ufficiale è $0,60 con K3 e $0,40 con K3.1 Pro. Alle tariffe CometAPI elencate, gli stessi conteggi di token costano $0,48 e $0,32, rispettivamente. Questi totali includono solo i token di input e di output indicati.
Ma si tratta di un confronto a token fissi. Workflow agentici complessi possono consumare quantità diverse di token di ragionamento e chiamate a strumenti a seconda del modello.
Il risparmio sui token scompare
Siano I il conteggio identico dei token di input non in cache, O il conteggio dei token di output fatturati di Kimi K3 e P il conteggio dei token di output fatturati di Kimi K3.1 Pro, tutti misurati in milioni. Alle tariffe standard ufficiali nella tabella dei prezzi, gli addebiti sono 3I + 15O e 2I + 10P dollari. Sono uguali quando P = 1.5O + 0.1I.
Per richieste con output pesante, K3.1 Pro può quindi usare circa il 50% in più di token di output fatturati prima di perdere il suo vantaggio di prezzo. Questo calcolo presume tariffe invariate ed esclude caching, costi degli strumenti e altri utilizzi fatturati separatamente. Usate le categorie di token effettivamente fatturate piuttosto che la sola lunghezza visibile della risposta.
Costo per task completato con successo
Calcolate il costo per task riuscito come il costo totale fatturato di tutti i tentativi di valutazione diviso per il numero di task unici che soddisfano un criterio di accettazione predefinito. Includete gli addebiti per tentativi non riusciti, retry e timeout quando il provider li fattura; dividere solo il costo delle esecuzioni riuscite per il loro numero può sottostimare il costo per task riuscito.
Mantenete fissi tra Kimi K3 e K3.1 Pro il set di task, i criteri di accettazione, il limite di retry e la policy di timeout. Riportate il tasso di successo insieme al costo per successo, così che escludere i task difficili non possa far apparire un modello artificialmente economico. Se nessun task riesce, il costo per successo è indefinito, non zero.
Kimi K3.1 Pro vs Kimi K3: confronto e selezione
Per la maggior parte dei workload agentici in hosting, K3.1 Pro è il punto di partenza più forte. Tuttavia, la decisione dovrebbe riflettere la complessità del task e i requisiti di deployment.
| Caso d’uso | Modello consigliato | Motivo |
|---|---|---|
| Coding autonomo | Kimi K3.1 Pro | Valutate modifiche multi-file, lavoro su terminale, debugging e risultati dei test finali. |
| Ricerca finanziaria multi-documento | Kimi K3.1 Pro | Miglioramenti in benchmark di ricerca e operazioni di business |
| Analisi dati complesse | Kimi K3.1 Pro | Migliore scoperta di problemi e testing della qualità dei dati |
| Workflow 3D e CAD | Kimi K3.1 Pro | Forti capacità specializzate con strumenti |
| Task testuali semplici | Confrontare entrambi | Confrontate task di routine e coding semplice su entrambi; ulteriore ragionamento può aggiungere latenza senza migliorare il risultato accettabile. |
| Accuratezza su contesti lunghi | Confrontare entrambi | K3 è leggermente avanti su AA-LCR |
| Self-hosting immediato | Kimi K3 | Pesi scaricabili già disponibili |
| Agenti interattivi ad alta capacità | K3.1 Pro Highspeed | Serving più veloce, soggetto a validazione dei costi |
| Workflow di produzione sensibili ai costi | Confrontare entrambi | Prezzi per token più bassi potrebbero non implicare costi per task più bassi |
Automazione in hosting e workflow professionali
Per agenti di coding in hosting e workflow analitici, valutate K3.1 Pro sulle parti difficili del lavoro: modifiche multi-file, raccolta di evidenze, controlli di calcolo e recupero dopo una chiamata a strumento fallita. Preferite riduzioni misurate dei task falliti o del lavoro correttivo rispetto a un punteggio aggregato più alto da solo.
Per applicazioni K3 consolidate, mantenete la route esistente come baseline di confronto. I task di routine possono già soddisfare la soglia di accettazione, mentre i task specializzati a contesto lungo possono comportarsi diversamente dai benchmark aggregati. Prioritizzate i segmenti di workload in cui un upgrade ha un beneficio misurabile.
Self-hosting e vincoli di deployment
Al 24 ottobre 2026, i pesi completi di K3 sono disponibili per il deployment, soggetti alla licenza del modello e ai requisiti hardware. I pesi completi di K3.1 Pro non sono ancora stati pubblicati.
Moonshot prevede di rilasciare i pesi di K3.1 Pro entro il 4 novembre 2026. Si tratta di un piano di rilascio annunciato, non di un checkpoint disponibile; confermate i pesi pubblicati e i termini applicabili prima di programmare il self-hosting.
Criteri di valutazione per la produzione
Confrontate K3 e K3.1 Pro su task rappresentativi usando gli stessi prompt, strumenti, criteri di accettazione, limiti di retry e timeout. Registrate le impostazioni del provider e del ragionamento, e preservate i messaggi completi dell’assistente come richiesto dall’API.
Misurate successo del task, latenza, uso di token e costo per task riuscito, includendo esecuzioni fallite e retry fatturati. Rivedete i casi in cui K3 riesce e K3.1 Pro fallisce. Per la valutazione umana, nascondete le etichette del modello e randomizzate l’ordine degli output.
Se K3.1 Pro soddisfa le vostre soglie di qualità, latenza e costo, distribuitelo gradualmente con un fallback K3 testato.
Migrazione controllata e fallback
Un approccio pratico è iniziare con una piccola percentuale di traffico di produzione su K3.1 Pro.
Mantenete K3 disponibile come fallback durante la validazione. Confrontate qualità dei task, latenza, tassi di fallimento e spesa prima di aumentare l’uso di K3.1 Pro.
Prestate particolare attenzione agli schemi di chiamata agli strumenti, ai campi dei messaggi legati al ragionamento, agli input multimodali e al parsing dell’output. La compatibilità dell’API non garantisce automaticamente un comportamento applicativo identico.
Progressi e regressioni nei benchmark
Se entrambi i modelli hanno risposto alle stesse 43 domande con punteggi 35 e 42, K3.1 Pro potrebbe aver corretto sette fallimenti di K3 senza regressioni, oppure otto fallimenti perdendo però una risposta precedentemente corretta. Il punteggio totale da solo non distingue questi esiti.
Ispezionate le risposte accoppiate e classificatele come entrambe corrette, solo K3 corretto, solo K3.1 Pro corretto o entrambe errate. Rivedete i successi esclusivi di K3 rispetto ai vostri task a maggior impatto prima della migrazione. Il risultato 42/43 descrive quel set di test; non garantisce un tasso di successo del 97,7% su un workload diverso.
Valutazione cieca degli output del modello
Nascondete le etichette del modello e randomizzate l’ordine in cui i revisori vedono gli output. Definite il rubric di accettazione prima della revisione: per il codice, usate test eseguibili e controlli di regressione; per la ricerca, verificate il supporto delle fonti, i calcoli e la completezza del deliverable richiesto. Valutate la correttezza prima di considerare la presentazione o lo stile.
Rivelate identità del modello, latenza e costo fatturato solo dopo aver registrato la valutazione di qualità. Questo separa la qualità dell’output dalle aspettative sul modello più recente. Risolvete i disaccordi dei revisori usando gli stessi test o le stesse fonti, e conservate le decisioni così che un successivo cambio di modello o prompt possa essere valutato in modo coerente.
Dove potete accedere a Kimi K3.1 Pro e Kimi K3?
Accesso tramite provider ufficiale
Usate la Kimi K3 API o la Kimi K3.1 Pro API documentate da Moonshot per un’integrazione diretta con il provider. Verificate l’identificatore del modello dell’endpoint selezionato, i campi di richiesta supportati e i limiti dell’account. L’accesso pubblico all’API e i pesi del modello scaricabili sono opzioni di deployment separate.
Accesso tramite CometAPI
Gli sviluppatori possono accedere alla Kimi K3.1 Pro API e alla Kimi K3 API tramite l’interfaccia unificata di CometAPI e confrontare entrambe le route con lo stesso workload applicativo.
Questo rende la migrazione da K3 a K3.1 Pro relativamente semplice, soprattutto per applicazioni che già usano un’interfaccia chat compatibile con OpenAI.
Per usare CometAPI, create un account e una chiave API, quindi configurate la vostra applicazione con endpoint e identificatore del modello secondo la documentazione di integrazione. Selezionate kimi-k3 per K3, kimi-k3.1-pro per K3.1 Pro standard o kimi-k3.1-pro-highspeed per la route Highspeed quando supportata. Iniziate con una richiesta piccola, quindi confrontate lo stesso workload tra i modelli verificando risultati restituiti, latenza e utilizzo fatturato.
Conclusione
Kimi K3.1 Pro è il candidato più forte per coding autonomo impegnativo, ricerca finanziaria e workflow agentici estesi nelle valutazioni qui esaminate. Kimi K3 resta rilevante per il self-hosting immediato e i workload in cui il suo profilo di accuratezza o latenza soddisfa già i requisiti.
Scegliete usando task rappresentativi e la route del provider effettiva. Confrontate esiti riusciti, latenza e spesa totale, quindi migrate gradualmente. Prezzi per token più bassi e punteggi aggregati di benchmark più alti sono un buon punto di partenza, ma non definiscono la migliore configurazione per ogni applicazione.