Che cos’è l’API GPT-5.2
L’API GPT-5.2 è la stessa di GPT-5.2 Thinking in ChatGPT. GPT-5.2 Thinking è la versione di fascia media della famiglia GPT-5.2 di OpenAI, pensata per il lavoro più approfondito: ragionamento multi-step, sintesi di documenti lunghi, generazione di codice di qualità e lavoro professionale basato sulla conoscenza, dove accuratezza e struttura utilizzabile contano più del throughput grezzo. Nell’API è esposta come modello gpt-5.2 (Responses API / Chat Completions) e si colloca tra la variante Instant a bassa latenza e la variante Pro di qualità superiore ma più costosa.
Caratteristiche principali
- Contesto molto esteso e compattazione: finestra effettiva da 400K e strumenti di compattazione per gestire la rilevanza in conversazioni e documenti lunghi.
- Sforzo di ragionamento configurabile:
none | medium | high | xhigh(xhigh abilita il massimo calcolo interno per ragionamenti difficili).xhighè esposto alle varianti Thinking/Pro. - Supporto più solido per strumenti e funzioni: tool calling di prima classe, grammatiche (CFG/Lark) per vincolare output strutturati e comportamenti agentici migliorati che semplificano automazioni complesse multi-step.
- Comprensione multimodale: comprensione più ricca di immagini + testo e integrazione in attività multi-step.
- Sicurezza migliorata / gestione di contenuti sensibili: interventi mirati per ridurre risposte indesiderate in aree come l’autolesionismo e altri contesti sensibili.
Capacità tecniche e specifiche (vista sviluppatore)
- Endpoint API e ID modello:
gpt-5.2per Thinking (Responses API),gpt-5.2-chat-latestper flussi di lavoro chat/instant egpt-5.2-proper il tier Pro; disponibili tramite Responses API e Chat Completions dove indicato. - Token di ragionamento e gestione dello sforzo: l’API supporta parametri espliciti per allocare il calcolo (reasoning effort) per richiesta; uno sforzo più alto aumenta latenza e costo ma migliora la qualità dell’output per compiti complessi.
- Strumenti per output strutturati: supporto per grammatiche (Lark / CFG) per vincolare l’output del modello a un DSL o a una sintassi esatta (utile per SQL, JSON, generazione di DSL).
- Chiamata parallela di strumenti e coordinamento agentico: parallelismo migliorato e un’orchestrazione degli strumenti più pulita riducono la necessità di prompt di sistema elaborati e impalcature multi-agente.
Prestazioni nei benchmark e dati di supporto
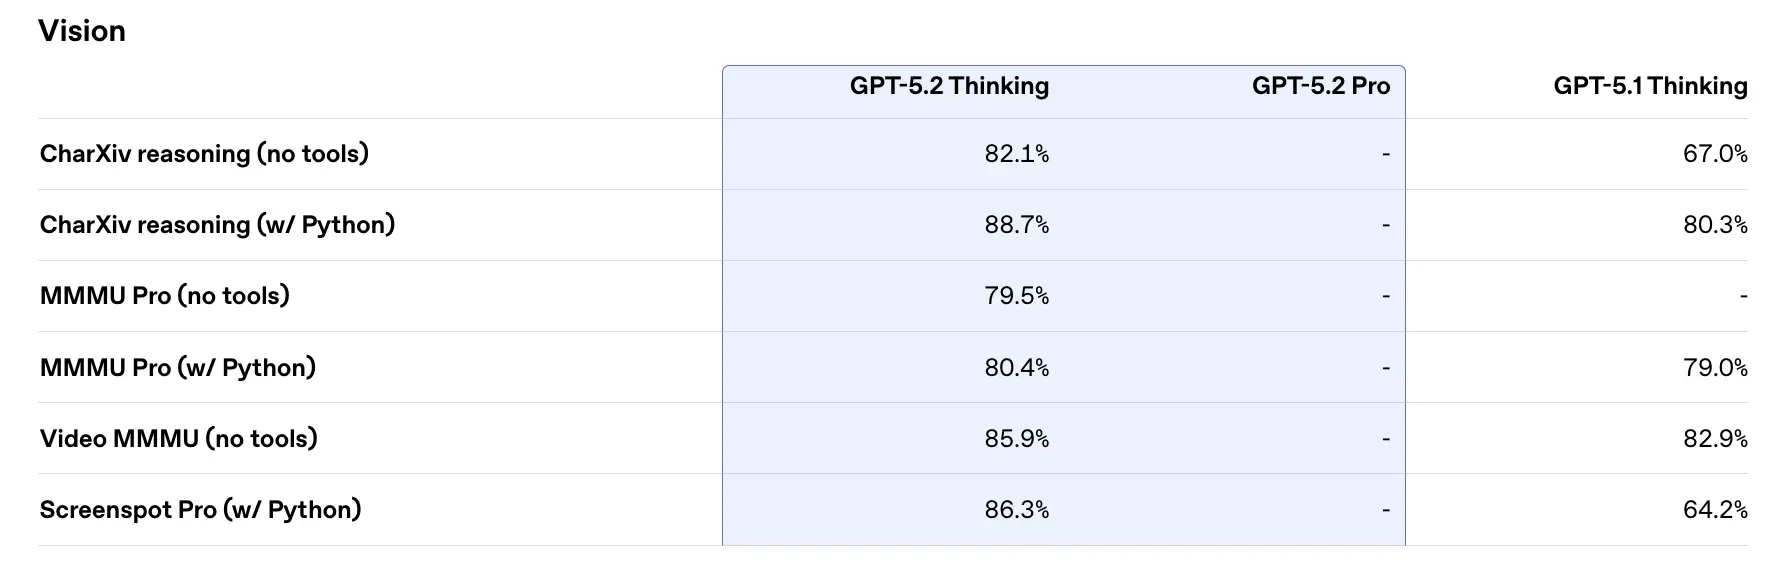
OpenAI ha pubblicato una varietà di risultati interni ed esterni per GPT-5.2. Alcuni punti salienti (numeri riportati da OpenAI):
- GDPval (44 professioni, lavoro di conoscenza) — GPT-5.2 Thinking “supera o eguaglia i migliori professionisti del settore nel 70,9% dei confronti”; OpenAI riporta che gli output sono stati prodotti a >11× la velocità e a <1% del costo dei professionisti esperti nei loro task GDPval (stime di velocità e costo basate su dati storici). Questi task includono modelli di fogli di calcolo, presentazioni e video brevi.
- SWE-Bench Pro (coding) — GPT-5.2 Thinking ottiene ≈55,6% su SWE-Bench Pro e ~80% su SWE-Bench Verified (solo Python) secondo OpenAI, stabilendo un nuovo stato dell’arte per la valutazione di generazione di codice/ingegneria nei loro test. Questo si traduce in debugging più affidabile e correzioni end-to-end nella pratica, secondo gli esempi di OpenAI.
- GPQA Diamond (Q&A scientifico a livello graduate) — GPT-5.2 Pro: 93,2%, GPT-5.2 Thinking: 92,4% su GPQA Diamond (senza strumenti, ragionamento massimo).
- Serie ARC-AGI — Su ARC-AGI-2 (un benchmark di ragionamento fluido più difficile), GPT-5.2 Thinking ha ottenuto 52,9% e GPT-5.2 Pro 54,2% (OpenAI afferma che sono nuovi valori all’avanguardia per modelli in stile chain-of-thought).
- Long-context (OpenAI MRCRv2) — GPT-5.2 Thinking mostra un’accuratezza prossima al 100% sulla variante MRCR a 4 needle fino a 256k token e punteggi sostanzialmente migliorati rispetto a GPT-5.1 su impostazioni di contesto lungo. (OpenAI ha pubblicato grafici e tabelle MRCRv2.)
Confronto con i contemporanei
- vs Google Gemini 3 (Gemini 3 Pro / Deep Think): Gemini 3 Pro è stato pubblicizzato con una finestra di contesto ~1.048.576 (≈1M) token e ampi input multimodali (testo, immagini, audio, video, PDF) e forti integrazioni agentiche tramite Vertex AI / AI Studio. Sulla carta, la finestra di contesto più ampia di Gemini 3 è un elemento distintivo per carichi di lavoro monoseduta estremamente grandi; i compromessi includono la superficie di tooling e l’aderenza all’ecosistema.
- vs Anthropic Claude Opus 4.5: Opus 4.5 di Anthropic enfatizza flussi di lavoro di coding/agent aziendali e riporta risultati SWE-bench solidi e robustezza per sessioni agentiche lunghe; Anthropic posiziona Opus per automazione e generazione di codice con una finestra di contesto da 200k e integrazioni agent/Excel specializzate. Opus 4.5 è un forte concorrente in ambito automazione enterprise e attività di codice.
Conclusione pratica: GPT-5.2 punta a un set bilanciato di miglioramenti (contesto 400k, output di token elevati, ragionamento/codifica migliorati). Gemini 3 punta ai contesti monoseduta assolutamente più grandi (≈1M), mentre Claude Opus si concentra su robustezza agentica e ingegneria enterprise. Scegli in base alla dimensione del contesto, bisogni di modalità, aderenza a feature/tooling e compromessi tra costo/latenza.
Come accedere e utilizzare l’API GPT-5.2
Passaggio 1: Registrati per ottenere la chiave API
Accedi a cometapi.com. Se non sei ancora nostro utente, registrati prima. Entra nella tua console CometAPI. Ottieni la chiave API di accesso per l’interfaccia. Fai clic su “Add Token” nella sezione API token del centro personale, ottieni la chiave token: sk-xxxxx e inviala.
Passaggio 2: Invia richieste all’API GPT-5.2
Seleziona l’endpoint “gpt-5.2” per inviare la richiesta API e imposta il corpo della richiesta. Il metodo e il corpo della richiesta sono disponibili nella documentazione API sul nostro sito. Il nostro sito offre anche test con Apifox per tua comodità. Sostituisci <YOUR_API_KEY> con la tua chiave CometAPI effettiva dal tuo account. Gli sviluppatori chiamano questi tramite gli endpoint Responses API / Chat.
Inserisci la tua domanda o richiesta nel campo content—è a questo che il modello risponderà. Elabora la risposta API per ottenere l’output generato.
Passaggio 3: Recupera e verifica i risultati
Elabora la risposta API per ottenere l’output generato. Dopo l’elaborazione, l’API risponde con lo stato del task e i dati di output.
Vedi anche Gemini 3 Pro Preview API