Crea con CometAPITi serve una sola API per più modelli?Testa il flusso di lavoro in Playground, poi crea una chiave API quando modello e costo sono adatti al tuo caso d'uso.
Che cos'è la memorizzazione nella cache dei prompt? OpenAI vs Claude vs Gemini nel 2026
Scopri come funziona la cache dei prompt nel 2026. Confronta i metodi di caching, i TTL, i prezzi, le prestazioni, gli esempi in Python e l'accesso a CometAPI per OpenAI, Claude e Gemini.
Il prompt caching consente ai modelli linguistici di riutilizzare prefissi di prompt già elaborati invece di ripetere la stessa computazione dell’input. Può ridurre i costi dei token di input e migliorare la latenza, soprattutto per workflow di agenti, assistenza clienti, RAG e analisi di documenti di grandi dimensioni. Nel 2026, OpenAI offre caching automatico e nuovi controlli espliciti della cache, Claude supporta caching automatico e breakpoint a livello di blocco, e Gemini enfatizza il caching implicito per i suoi modelli più recenti. I provider applicano tariffe diverse per scritture, letture e, ove previsto, archiviazione della cache. La scadenza può innescare una nuova scrittura o un addebito completo dell’input, quindi i risparmi reali dipendono dalla frequenza di riuso e dai cache hit misurati.
Questa guida confronta il prompt caching in GPT-6.1 Sol, Claude Opus 5.5 e Gemini 4 Argon per sviluppatori che costruiscono applicazioni con input ripetuti. Si concentra su controlli della cache, prezzi e su come verificare il riuso.
Punti chiave
Il prompt caching riutilizza l’input elaborato, non la risposta precedente del modello.
Revisionato per chiarezza, attribuzione delle fonti e terminologia API aggiornata.
Il prompt caching di OpenAI dipende da un prefisso stabile, dalle funzionalità supportate dal modello e da minimi e impostazioni di retention specifici del modello.
Il prompt caching di Claude offre TTL di 5 minuti e opzionale di 1 ora con controlli automatici ed espliciti della cache.
Il context caching di Gemini è implicito sui modelli moderni; le risorse di cache esplicite restano dipendenti dal modello.
I risparmi del prompt caching dipendono da scritture, letture, archiviazione e hit effettivi; verifica il supporto dell’endpoint e la fatturazione dei token in cache quando usi CometAPI.
Che cos’è il prompt caching negli LLM?
Il prompt caching è un’ottimizzazione di inferenza che consente di riutilizzare lo stato computazionale derivato da un prefisso già elaborato. Un prompt spesso include istruzioni stabili, definizioni di tool o documenti, seguiti da una domanda dell’utente che cambia. Se una richiesta successiva ripete l’identico prefisso idoneo, il provider può riutilizzare gli stati key-value (KV) in cache ed elaborare solo la parte rimanente non in cache. A differenza del response caching, questo non riproduce una risposta precedente: il modello genera una nuova risposta per la richiesta corrente.
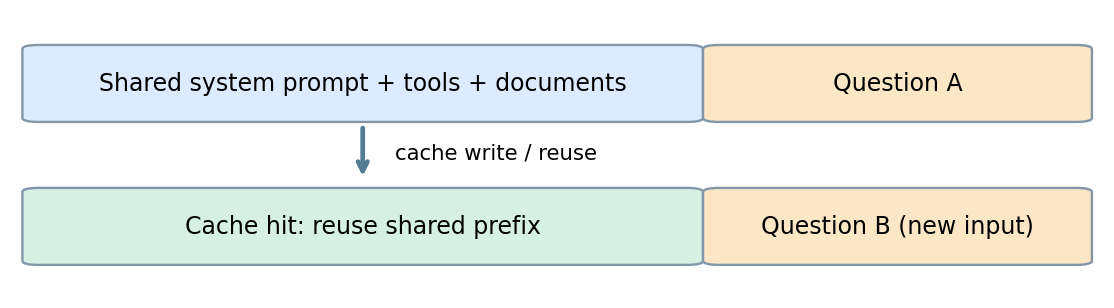
Flusso di lavoro del prompt caching:
Prima richiesta: invia un prefisso ampio e ripetibile e una domanda specifica.
Creazione della cache: il provider memorizza lo stato computazionale intermedio idoneo.
Richiesta successiva: riutilizza l’identico prefisso e sostituisce la domanda.
Lettura dalla cache: i token già elaborati vengono riutilizzati mentre i nuovi token sono elaborati normalmente.
Illustrazione concettuale fornita con la bozza originale: materiale di prompt ripetuto precede una domanda variabile. Non è un diagramma ufficiale dell’architettura del provider.
Il principio di progettazione comune è la stabilità del prefisso. I contratti API, le famiglie di modelli idonee, la durata della cache e le tariffe non sono intercambiabili.
Panoramica del caching per OpenAI, Claude e Gemini
Lo stesso principio del prefisso stabile si applica a tutti i provider, ma i controlli sotto sono specifici per i modelli usati in questa guida. Verifica insieme modello ed endpoint prima di copiare un’impostazione.
Opt-in con cache_control a livello di richiesta o di blocco di contenuto
Caching implicito abilitato per impostazione predefinita
Prefisso minimo
1,024 token di input visibili
512 token prima del confine della cache
4,096 token di input
Controlli della durata
Responses API: prompt_cache_options.ttl; predefinito 30m o 12h
Predefinito 5 minuti; opzione TTL di 1 ora
Durata implicita gestita dal provider
Dove collocare il contenuto stabile
Istruzioni iniziali, tool e materiale di riferimento
Definizioni di tool stabili, contenuto di sistema o blocchi messaggio prima del breakpoint
Ampio contenuto condiviso all’inizio del prompt
Metriche d’uso da verificare
input_tokens_details.cached_tokens e uso di creazione della cache riportato
cache_creation_input_tokens e cache_read_input_tokens
cached_content_token_count in usage_metadata, quando presente
Distinzione importante
prompt_cache_key può separare la rendicontazione; non è richiesto per il routing automatico di Sol
Il breakpoint deve terminare su contenuto che resta invariato
Nessuna risorsa di cache esplicita per Argon; i modelli precedenti supportati espongono un’interfaccia separata
Controlli di prompt caching ed esempi in Python
Ogni esempio invia lo stesso materiale di riferimento con due domande diverse. Mantieni invariato il contenuto condiviso, esegui le richieste in sequenza e ispeziona l’uso per vedere se la seconda richiesta ha effettivamente riutilizzato l’input in cache.
OpenAI: controlli della cache ed esempio in Python
OpenAI abbina automaticamente i prefissi di prompt idonei alla cache e, sui modelli più recenti supportati, consente la configurazione esplicita di breakpoint e retention. Il riuso della cache è particolarmente utile quando ricorrono lunghe istruzioni di sistema, schemi di tool o contesto di repository. La lunghezza minima del prefisso e i moltiplicatori di prezzo dei token dipendono dalla generazione del modello e dal livello di retention selezionato.
L’esempio usa la Responses API con prompt_cache_options impostato in modalità implicita e durata di 30 minuti. Le generazioni di modelli precedenti usano parametri di retention diversi; segui le impostazioni per il tuo modello esatto.
Installa l’SDK openai e imposta OPENAI_API_KEY. Usa almeno 1,024 token visibili nel prefisso stabile. Esegui entrambe le richieste in sequenza e ispeziona input_tokens_details.cached_tokens e cache_write_tokens nell’uso. Un conteggio positivo dei token in cache conferma una lettura fatturata dalla cache; non garantisce una latenza più bassa in ogni richiesta.
Per eseguire gli esempi, installa l’SDK Python pertinente, imposta la chiave API del provider e crea un file UTF-8 reference.txt contenente abbastanza contenuto stabile per soddisfare il minimo di caching di quel modello.
from pathlib import Path
from openai import OpenAI

client = OpenAI()  # Reads OPENAI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
questions = ["Summarize the architecture.", "Identify the main technical risks."]
for question in questions:
    response = client.responses.create(
        model="gpt-6.1-sol",
        instructions="Use the following reference material.\n" + shared,
        input=question,
        prompt_cache_key="docs-assistant-v1",
        prompt_cache_options={"mode": "implicit", "ttl": "30m"},
    )
    print(response.output_text)
    print(response.usage)
Claude: controlli della cache ed esempio in Python
Nella Claude Messages API, il prompt caching è opt-in. Aggiungi cache_control a livello di richiesta per il posizionamento automatico del breakpoint oppure allegalo a un blocco di contenuto per contrassegnare un breakpoint esplicito. Gli sviluppatori possono contrassegnare istruzioni stabili, documenti e blocchi di prompt selezionati, variando l’input utente successivo. La cache standard a breve durata è di cinque minuti, con un’opzione di un’ora per carichi di lavoro adatti.
Installa l’SDK anthropic e imposta ANTHROPIC_API_KEY. Per Claude Opus 5.5, fornisci almeno 512 token prima del confine della cache. Mantieni il blocco di sistema identico tra le richieste. Una voce di cache diventa disponibile quando inizia la prima risposta; questo esempio attende la risposta completa per semplificare la dimostrazione. Ispeziona i conteggi di creazione e lettura della cache; un prefisso corto può restituire zero per entrambi senza generare un errore.
from pathlib import Path
import anthropic

client = anthropic.Anthropic()  # Reads ANTHROPIC_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.messages.create(
        model="claude-opus-5-5",
        max_tokens=1024,
        system=[{
            "type": "text",
            "text": shared,
            "cache_control": {"type": "ephemeral"},
        }],
        messages=[{"role": "user", "content": question}],
    )
    print(response.content)
    print(response.usage.cache_creation_input_tokens)
    print(response.usage.cache_read_input_tokens)
Gemini: caching implicito ed esempio in Python
Google chiama la sua implementazione context caching. Gemini 4 Argon usa caching implicito e non supporta risorse di cache esplicite. Alcune famiglie di modelli precedenti supportano cache esplicite con TTL configurabile. Scegli l’interfaccia di caching in base al contratto del singolo modello, invece di presumere che tutti i modelli Gemini espongano gli stessi controlli.
Installa google-genai e imposta GEMINI_API_KEY. Usa almeno 4,096 token di contenuto condiviso iniziale per Gemini 4 Argon e invia la seconda richiesta poco dopo la prima. Ispeziona cached_content_token_count in usage_metadata quando presente. Il caching implicito può non attivarsi anche quando il prefisso è idoneo.
from pathlib import Path
from google import genai

client = genai.Client()  # Reads GEMINI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.models.generate_content(
        model="gemini-4-argon",
        contents=shared + "\nQuestion: " + question,
    )
    print(response.text)
    print(response.usage_metadata)
Quanto costa il prompt caching tra OpenAI, Claude e Gemini?
I costi del caching vanno valutati come combinazione di scritture, letture e—su alcuni sistemi con cache esplicita—retention o archiviazione. I seguenti moltiplicatori illustrano schemi comuni e non sono promesse di prezzo universali tra versioni di modello.
Categoria di costo
OpenAI
Claude
Gemini
Input non in cache
Tariffa normale dei token di input
Tariffa normale dei token di input
Tariffa normale dei token di input
Scrittura in cache
Possibili premi di scrittura sui modelli più recenti
Premi per 5m/1h
Implicita o esplicita, specifica per modello
Lettura dalla cache
Tariffa ridotta specifica per modello
Tariffa ridotta specifica per modello
Tariffa ridotta specifica per modello
Durata della cache
Specifica per modello
5m / 1h
Gestita implicitamente / esplicita configurabile
Archiviazione aggiuntiva
Dipende dal modello
Di solito riflessa nel livello di scrittura
Possono applicarsi addebiti di archiviazione esplicita
Esempio illustrativo: un prefisso da 10.000 token viene riutilizzato in N richieste, la scrittura iniziale della cache costa 1,25 volte l’input ordinario e le letture successive costano 0,1 volte l’input ordinario. Supponi un prezzo base di input di $2 per milione di token e hit perfetti dopo la prima richiesta.
Numero di richieste
Senza caching
Con caching
Risparmio sul prefisso riutilizzato
10
$0.200
$0.043
78.50%
100
$2.000
$0.223
88.85%
Formula: costo del prefisso in cache = 1.25P + (N − 1) × 0.1P, dove P è il costo ordinario di elaborazione una volta del prefisso condiviso. Questo esempio esclude input dinamico, output, scadenze, miss, archiviazione e altri servizi.
L’esempio sopra usa un tasso di lettura illustrativo del 10%, non l’aliquota attuale di GPT-6.1 Sol. La tariffazione standard short-context di Sol è $2 per milione di token di input non in cache, $0.10 per milione di token di input in cache e $2.50 per milione di token scritti con la durata predefinita. Ricalcola l’esempio usando il tuo modello, livello ed endpoint effettivi.
Una durata più lunga vale la pena solo quando evita abbastanza scritture ripetute o richieste non in cache da compensarne il prezzo. Le scritture di Claude a 5 minuti e 1 ora sono addebitate rispettivamente a 1,25× e 2× l’input base. Le cache esplicite di Gemini su modelli precedenti supportati possono anche comportare costi di archiviazione. Misura il riuso su intervalli di inattività reali, non solo su un burst di chiamate consecutive.
Considera miss, scadenza e generazione dell’output come parte del conto. Se un prefisso scade prima di essere riutilizzato, la richiesta successiva può richiedere un’altra scrittura o l’elaborazione completa dell’input. I prompt brevi potrebbero non qualificarsi affatto, mentre risposte lunghe possono rendere i token di output la spesa maggiore anche con un forte riuso della cache. Confronta il costo totale per attività completata prima di aggiungere ulteriore complessità di caching.
Quale API di prompt caching è migliore per carichi di lavoro diversi?
Per agenti di coding e assistenza clienti, inserisci prima della parte variabile le definizioni stabili dei tool, il contesto del repository, le policy e la knowledge. OpenAI e Claude offrono controlli sui breakpoint che aiutano a definire confini riutilizzabili; valuta le effettive letture dalla cache dell’endpoint invece di presumere che testo ripetuto sia stato messo in cache.
Per analisi di documenti e lavoro multimodale, mantieni il documento sorgente o i media supportati prima della domanda. L’approccio implicito di Gemini riduce il lavoro di gestione della cache, mentre Claude permette di marcare direttamente il blocco stabile. Verifica il supporto per il tipo di media e modello specifici prima di fare affidamento sul riuso.
Per conversazioni lunghe, aggiungi nuove turnazioni anziché riscrivere ripetutamente l’inizio, e scegli una durata disponibile che copra gli intervalli tra i turni. Se la tua applicazione ha bisogno di una risorsa di cache nominata che possa creare e referenziare in modo esplicito, valuta un modello Gemini che supporti tale interfaccia; Argon no.
Non esiste un vincitore universale: confronta il tasso di hit della cache, il costo per attività completata e la latenza sotto il tuo effettivo pattern di traffico.
In che modo il prompt caching influisce su latenza e prestazioni?
Un cache hit riduce l’elaborazione di input ripetuti e può accorciare il tempo alla prima token. Non migliora intrinsecamente la qualità della risposta né accelera la generazione dell’output, e l’input in cache occupa comunque la finestra di contesto. Misura sia la latenza al primo token sia il tempo totale di risposta su richieste comparabili; un hit di cache da solo non è prova che l’utente abbia ricevuto prima la risposta finale.
Come ottimizzare il prompt caching e risolvere i miss
Inizia con un prefisso stabile e utile
Inserisci per primi istruzioni riutilizzabili, definizioni di tool, policy e documenti; posiziona dopo timestamp, ID richiesta, contesto variabile e la domanda dell’utente. Mantieni stabili l’ordine dei tool e gli schemi. Con cache esplicita, termina il breakpoint sull’ultimo blocco invariato. Aggiungi materiale di riferimento utile quando aiuta il task; non gonfiare ogni richiesta solo per inseguire una metrica di cache.
Se i token in cache restano a zero
Verifica l’idoneità prima di modificare il prompt: conferma modello esatto, endpoint, lunghezza minima dei token e impostazioni di controllo della cache richieste. Quindi invia due richieste sequenziali con contenuto condiviso identico. Ispeziona separatamente creazione e letture della cache; la prima richiesta può creare la voce che una richiesta successiva potrà riutilizzare. Una cache implicita è idonea a fare hit, non garantita a farlo.
Per Claude, una richiesta sotto il minimo può restituire zero token di creazione e lettura della cache senza errore. La voce di cache diventa disponibile quando inizia la prima risposta. La guida al caching di Claude spiega anche come il posizionamento del breakpoint e le impostazioni di richiesta variabili influenzano il riuso.
Se gli hit scompaiono tra le richieste
Confronta i payload effettivi, non solo il template del prompt. Cerca testo del documento cambiato, tool riordinati, schemi alterati, turni iniziali di conversazione riscritti o campi dinamici inseriti prima del confine riutilizzabile. Controlla il tempo trascorso dalla richiesta precedente e se la durata scelta lo copre. Cambia una variabile alla volta e registra l’uso risultante.
Se gli hit non producono risparmi
Separa input in cache, scritture, input non in cache, output e qualsiasi costo di archiviazione. Scritture ripetute dopo intervalli di inattività, basso riuso o risposte lunghe possono annullare gli sconti sull’input. Usa il calcolo dei costi sopra con uso misurato e tariffe reali dell’endpoint. Mantieni un’ottimizzazione solo se migliora il costo totale dell’attività o la latenza percepibile dall’utente.
Verifica supporto dell’endpoint e confini dei dati
Un endpoint di compatibilità può accettare una richiesta senza esporre gli stessi controlli di caching o campi di uso dell’API nativa. Conferma il supporto dei parametri e confronta l’uso restituito con la fatturazione dell’account prima di considerare il riuso come un risparmio. Mantieni l’isolamento dei tenant e i controlli di accesso, e segui le policy di retention e trattamento dati del provider. Il caching non sostituisce tali controlli.
Come usare il prompt caching con CometAPI?
CometAPI offre un punto d’integrazione unico per testare richieste tra famiglie di modelli. Per il caching, verifica quali controlli specifici del provider accetta l’endpoint selezionato e come l’input in cache appare in uso e fatturazione. Gli sviluppatori possono centralizzare i test di modello mantenendo convalide separate per comportamento di caching e rendicontazione, poiché le opzioni native del provider non sono garantite identiche attraverso proxy o endpoint di compatibilità.
Per la configurazione specifica del modello, vedi le pagine di CometAPI per GPT-6.1 Sol, Claude Opus 5.5 e Gemini 4 Argon. Conferma che l’endpoint scelto supporti il comportamento di caching di cui hai bisogno.
Installa l’SDK openai e imposta COMETAPI_KEY. Questo esempio invia richieste con prefisso ripetuto tramite l’interfaccia Chat Completions compatibile con OpenAI di CometAPI. Conferma la disponibilità del modello, quindi ispeziona uso restituito e fatturazione dell’account per evidenza di riuso della cache. Non copiare i parametri di cache della Responses API in questo endpoint senza verificarne il supporto.
import os
from pathlib import Path
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.chat.completions.create(
        model="gpt-6.1-sol",
        messages=[
            {"role": "system", "content": shared},
            {"role": "user", "content": question},
        ],
    )
    print(response.choices[0].message.content)
    print(response.usage)
Conclusione
Per applicazioni AI con molte ripetizioni, il prompt caching può incidere in modo significativo sull’economia dell’inferenza. OpenAI offre controlli sempre più dettagliati su prompt e retention; Claude fornisce controlli comodi automatici e a livello di blocco; Gemini rende semplice il riuso implicito nei modelli moderni. L’implementazione giusta dipende dal volume del prompt stabile, dal tasso di hit, dalla scadenza e dal costo totale. Inizia con un prefisso condiviso chiaro, verifica la telemetria d’uso, quindi ottimizza retention e scelta del provider usando misurazioni realistiche di produzione.
FAQ
Come posso confrontare in modo equo i provider di caching?
Riproduci gli stessi documenti sorgente utili e domande equivalenti, ma usa i conteggi di token e le tariffe reali di fatturazione di ciascun provider. Mantieni comparabili i requisiti di output e segnala sia richieste riuscite sia non riuscite. Un numero fisso di caratteri non implica lo stesso numero di token, quindi confronta il costo per attività completata insieme alle misurazioni di cache hit.
Dovrei mettere in cache ogni documento in una knowledge base che cambia?
Raggruppa i documenti in base alla frequenza con cui cambiano e a quanto spesso vengono riutilizzati. Un documento aggiornato frequentemente può invalidare ripetutamente un prefisso condiviso ampio; collocare prima materiale di policy stabile e più tardi materiale variabile può ridurre tale esposizione. Versiona deliberatamente il materiale sorgente e aggiornalo quando la correttezza lo richiede, anche se ciò riduce il riuso della cache.