Crea con CometAPITi serve una sola API per più modelli?Testa il flusso di lavoro in Playground, poi crea una chiave API quando modello e costo sono adatti al tuo caso d'uso.
Tencent Hyra 2.0: Architettura di Harness, Benchmark & risultati
Esplora Tencent Hunyuan Hyra 2.0, il suo Harness per agenti a tre livelli, i modelli scientifici, i benchmark, i progressi della ricerca e le differenze rispetto a Hyra 1.0.
Tencent Hunyuan ha presentato Hyra 2.0 il 2 novembre 2026 come un Harness di ricerca per sviluppare modelli scientifici, strumenti software e workflow riutilizzabili. La sua caratteristica distintiva è il coordinamento persistente su esperimenti che durano più giorni o settimane.
Il rilascio pubblico al momento consiste in selezionati artifact di ricerca—modelli, codice, pesi e report—piuttosto che in un servizio Hyra 2.0 ospitato e generalmente disponibile. Al 4 novembre 2026, i materiali pubblici di Tencent non documentano un’API di orchestrazione generica né un piano in abbonamento.
Punti chiave
Obiettivo di ricerca: Hyra 2.0 sviluppa modelli e strumenti scientifici riutilizzabili che possono supportare più di un progetto di ricerca.
Coordinamento persistente: gli agenti Overall, Mission e Worker si dividono le responsabilità, mentre code e registri di ricerca preservano l’avanzamento negli esperimenti lunghi.
Conoscenza riutilizzabile: la memoria degli agenti, i Books e le skill di ricerca conservano i risultati insieme alle prove di supporto e alle condizioni d’uso.
Revisionato per chiarezza, attribuzione delle fonti e terminologia API aggiornata.
Risultati specifici per task: i modelli rilasciati per proteine, campi di forze e cellule rispondono a carichi scientifici diversi; velocità e qualità vanno valutate insieme.
Accesso pratico: inizia dagli artifact di ricerca disponibili. Il completo Hyra Harness e le API dei modelli Hunyuan ospitate sono offerte distinte.
Che cos’è Tencent Hunyuan Hyra 2.0?
Hyra 2.0 sta per Hunyuan Research Agent 2.0, un sistema multi‑agente progettato per automatizzare workflow complessi di ricerca scientifica e ingegneristica.
Tencent presenta Hyra 2.0 come un passaggio dalla soluzione di problemi isolati allo sviluppo dei modelli, dei metodi e dell’infrastruttura usati per indagare una classe più ampia di domande.
Hyra 2.0 non è un foundation model stand‑alone con un numero di parametri o una finestra di contesto fissi. È un sistema di orchestrazione che può usare modelli di IA diversi, eseguire codice, gestire esperimenti scientifici e coordinare agenti di ricerca specializzati.
La ricerca scientifica richiede più del solo ragionamento. Un progetto completo può richiedere progettazione degli esperimenti, implementazione, training, debug, valutazione e revisioni ripetute. Queste attività possono durare diversi giorni o settimane, spesso con esperimenti in parallelo e risorse di calcolo condivise.
Hyra 2.0 affronta questa sfida operativa combinando l’intelligenza dei modelli con esecuzione persistente, collaborazione strutturata e verifica basata su evidenze.
Specifiche tecniche di Hyra 2.0
Specifiche
Hyra 2.0
Sviluppatore
Tencent Hunyuan
Annuncio pubblico
2 novembre 2026
Categoria di sistema
Agente autonomo per la ricerca scientifica
Architettura core
Harness multi‑agente gerarchico
Ruoli degli agenti
Overall, Mission, Worker
Esecuzione di ricerca
Workflow di lunga durata e concorrenti
Gestione dei task
Coda di attività persistente
Collaborazione
Research Board e messaggistica tra agenti
Verifica
Risultati supportati da evidenze e Review Worker indipendenti
Memoria
Stato di progetto, memoria stratificata degli agenti, Books condivisi
Riutilizzo della conoscenza
Risultati convalidati e competenze riutilizzabili
Flessibilità dei modelli
Worker diversi possono usare modelli sottostanti diversi
Ambienti di ricerca
WeCom, piattaforme di calcolo, repository di codice
Supervisione umana
Checkpoint di approvazione per operazioni con impatto rilevante
Le specifiche del sistema descrivono le sue capacità di orchestrazione e di ricerca. I singoli modelli scientifici creati da Hyra 2.0 hanno architetture, conteggi di parametri e benchmark di performance separati.
Perché Hyra 2.0 costruisce strumenti
Il passaggio da Hyra 1.0 a Hyra 2.0 affronta un limite fondamentale nella ricerca automatizzata: risolvere con successo un problema non migliora necessariamente la capacità del sistema di risolvere il successivo.
Hyra 1.0 utilizzava un loop agente relativamente semplice per generare soluzioni, eseguire valutazioni e migliorare i risultati tramite tentativi ripetuti. Alimentato dal modello open‑source Hy3 di Tencent, Hyra 1.0 ha contribuito a determinare l’esponente ottimale che lega insiemi somma e insiemi differenza, con una dimostrazione verificata automaticamente rilasciata insieme al risultato. La distinzione è importante: un risultato matematico valutato è un output concreto, mentre un miglioramento del processo di ricerca può essere riutilizzato in problemi successivi.
La prossima sfida è far sì che il progresso di ricerca si accumuli.
Dalle risposte alle capacità riutilizzabili
Considera tre livelli di automazione matematica:
Un agente risolve un singolo problema matematico.
Un agente sviluppa un workflow di dimostrazione che può risolvere problemi simili.
Un agente migliora i modelli di ragionamento e gli strumenti di verifica usati dai sistemi di ricerca futuri.
Il primo produce una risposta. Il secondo produce un metodo riutilizzabile. Il terzo può migliorare la capacità di ricerca sottostante.
Hyra 2.0 mira al secondo e al terzo livello.
Tencent descrive due ampie categorie di strumenti riutilizzabili. Gli strumenti in forma simbolica esprimono capacità tramite codice, algoritmi, regole e workflow. Esempi includono sistemi di verifica automatizzata, algoritmi di ricerca scientifica e pipeline di gestione degli esperimenti. Gli strumenti parametrici conservano capacità apprese nei pesi dei modelli, inclusi modelli di progettazione proteica e foundation model scientifici.
Migliorare una delle due categorie può giovare a molteplici task a valle senza richiedere che ogni progetto di ricerca parta dallo stesso punto.
La direzione verso l’auto‑miglioramento ricorsivo
Hyra 2.0 crea anche un percorso verso l’auto‑miglioramento ricorsivo. La ricerca sui foundation model dipende da infrastruttura di addestramento, pipeline di dati sintetici, algoritmi di ottimizzazione e sistemi di inferenza.
Se gli agenti di IA migliorano questi strumenti, possono contribuire a sviluppare modelli più forti. Modelli più forti possono poi partecipare a turni successivi di sviluppo degli strumenti.
Strumenti di ricerca migliori → modelli di IA più forti → agenti di ricerca più capaci → strumenti di ricerca migliori.
Tencent descrive l’applicazione di Hyra all’infrastruttura di pre‑addestramento, alla generazione di dati post‑addestramento e all’ottimizzazione dell’inferenza. Questo crea un plausibile ciclo di feedback tra sviluppo degli strumenti e sviluppo dei modelli. Non stabilisce di per sé un miglioramento ricorsivo illimitato o pienamente autonomo; ogni guadagno proposto richiede comunque un esperimento che ne isoli l’effetto.
Come funziona l’architettura dell’Harness di Hyra 2.0?
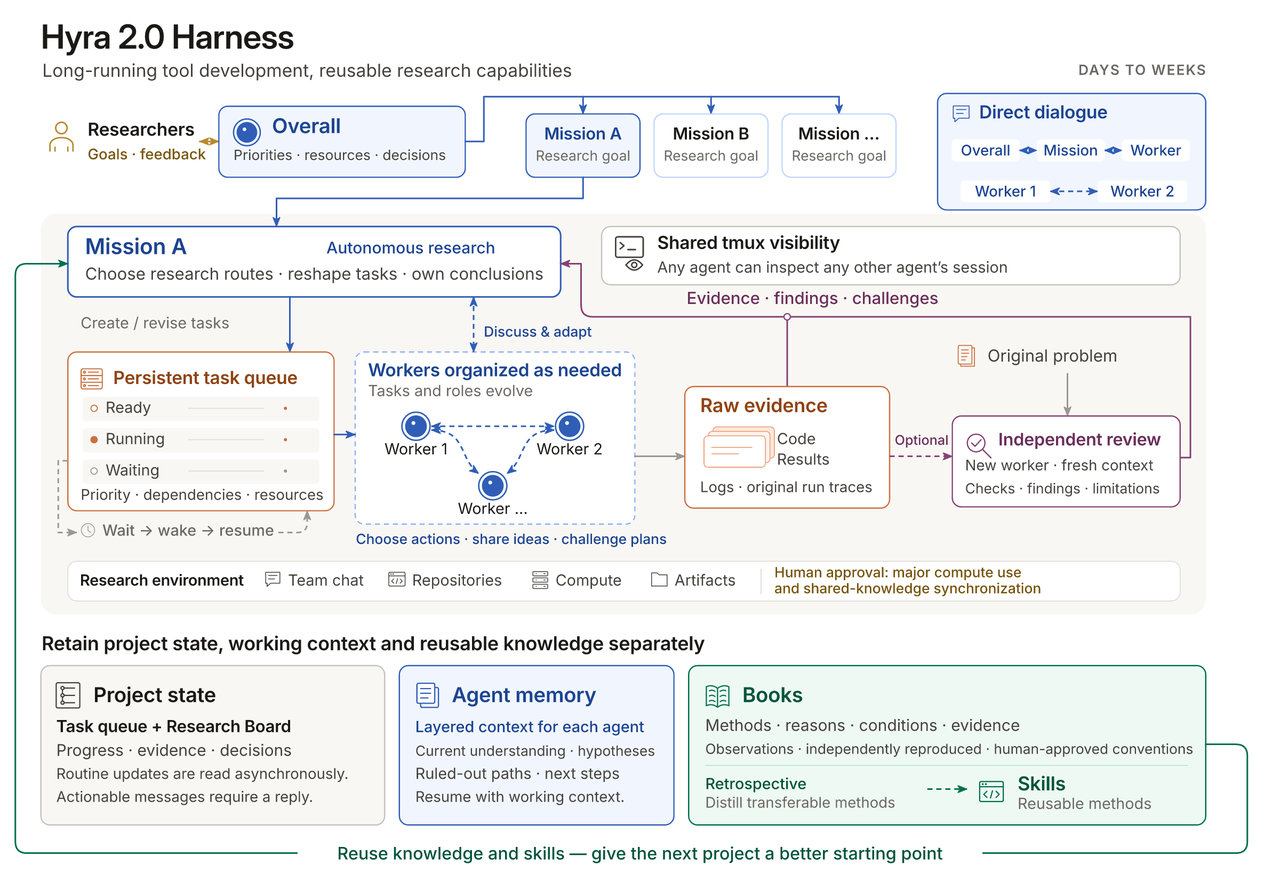
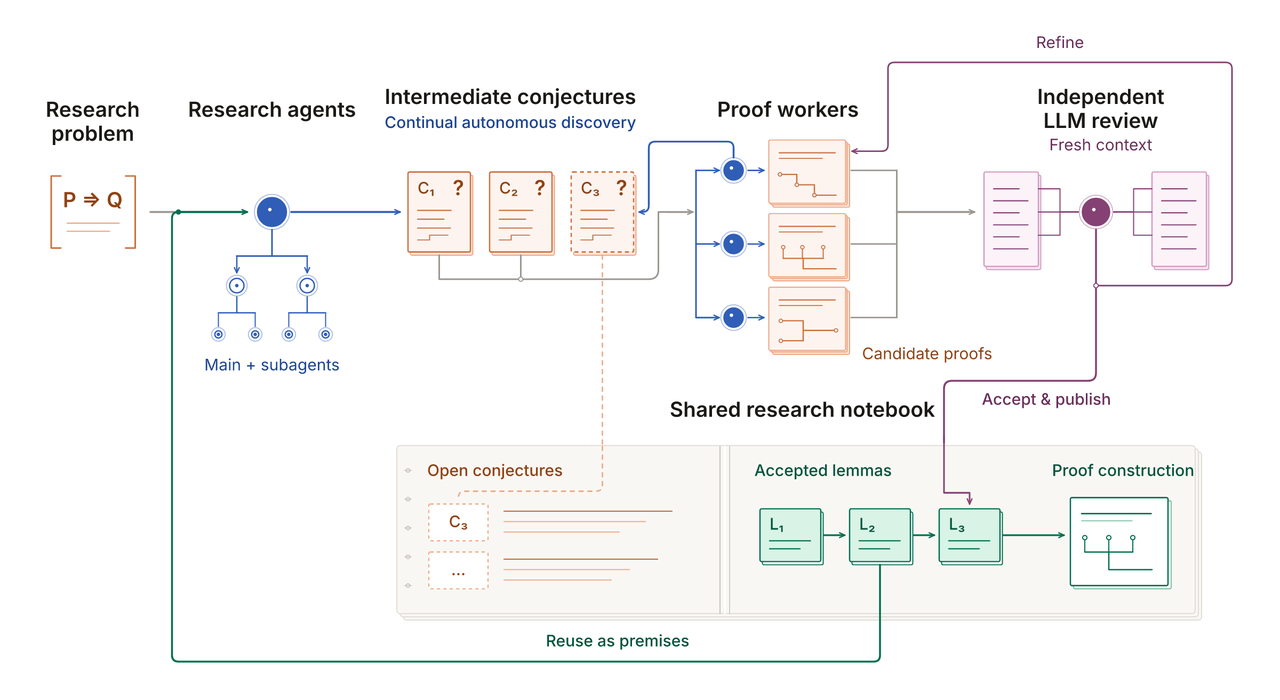
L’Harness è l’innovazione ingegneristica centrale di Hyra 2.0. Un loop agente convenzionale può eseguire strumenti, ispezionare i risultati e continuare a ragionare all’interno di una sessione. Lo sviluppo di modelli scientifici richiede un ambiente di esecuzione più sofisticato.
Gli esperimenti possono durare ore, i job di training giorni, e direzioni di ricerca separate possono richiedere risorse di calcolo e metodi di validazione diversi. Hyra 2.0 risponde a questi requisiti con tre livelli di agenti, scheduling persistente dei task, registri di ricerca strutturati e verifica indipendente.
Overall: coordinamento della ricerca e gestione delle risorse
Overall è il livello di coordinamento più alto. Comunica con i ricercatori umani, mantiene l’allineamento con gli obiettivi di ricerca, gestisce le priorità e coordina le risorse di calcolo.
Le sue responsabilità includono determinare quali progetti dovrebbero ricevere risorse aggiuntive e identificare le decisioni che richiedono approvazione umana. Overall funge quindi da livello di coordinamento tra attività di ricerca autonome e gestione umana della ricerca.
Mission: pianificazione di ricerca a lungo termine
Ogni Mission è responsabile di uno specifico problema di ricerca. Una Mission mantiene la direzione di ricerca attraverso esperimenti multipli, organizza i Worker, interpreta i risultati e decide se un’ipotesi merita ulteriori indagini.
Determina anche quando un approccio di ricerca deve essere rivisto o abbandonato. Questo crea continuità in un progetto di lunga durata senza richiedere che una singola sessione di agente conservi ogni azione intermedia.
Worker: esecuzione degli esperimenti ed esplorazione indipendente
I Worker svolgono compiti di ricerca specializzati. Le loro responsabilità includono leggere codice, implementare algoritmi, eseguire esperimenti, diagnosticare fallimenti e proporre approcci alternativi.
I Worker possono mettere in discussione le decisioni di una Mission e Worker diversi possono utilizzare modelli di IA sottostanti differenti. Questa struttura supporta l’esplorazione in parallelo e riduce la dipendenza dal percorso di ragionamento di un singolo agente.
Pianificazione persistente e Research Board
Hyra 2.0 inserisce i task di ricerca in una coda persistente. Lo scheduler considera priorità dei task, dipendenze e risorse disponibili quando avvia i Worker.
Quando un esperimento è in attesa di risultati di training o approvazione umana, altri task possono proseguire. Gli agenti possono anche pianificare la loro successiva attivazione al termine di un esperimento.
Il Research Board registra ipotesi, risultati, evidenze e decisioni principali. Ciò separa lo stato persistente del progetto di ricerca dalle conversazioni dei singoli agenti.
Verifica indipendente e approvazione umana
Le conclusioni dei Worker devono essere supportate da evidenze sperimentali, come versioni del codice, log di esecuzione, risultati di valutazione o tracce originali.
Quando un risultato richiede un esame aggiuntivo, un Review Worker separato può ispezionare in modo indipendente il problema originale e le evidenze. Questo processo aiuta a identificare conclusioni non supportate ed errori di implementazione prima che influenzino ricerche successive.
Operazioni ad alto costo computazionale e modifiche alla conoscenza condivisa del team rimangono soggette ad approvazione umana. L’architettura combina quindi esecuzione autonoma con checkpoint espliciti per decisioni rilevanti.
Books: trasformare l’esperienza di ricerca in competenze
Hyra 2.0 separa le informazioni in tre categorie di archiviazione:
Project state: code delle attività, registri di collaborazione e avanzamento della ricerca.
Agent memory: comprensione attuale, ipotesi, approcci scartati e piani futuri.
Books: conoscenza riutilizzabile condivisa tra progetti di ricerca.
Books categorizza le informazioni in osservazioni, risultati verificati e convenzioni. Un singolo esperimento può produrre un’osservazione. Risultati riprodotti in modo indipendente possono diventare conoscenza verificata. Le convenzioni che influenzano il comportamento del team richiedono conferma umana.
Durante le revisioni di progetto, i metodi riutilizzabili possono essere convertiti in competenze. Una procedura di verifica numerica riuscita o un metodo per diagnosticare instabilità di training possono diventare componenti riutilizzabili di futuri workflow di ricerca.
Questo meccanismo consente al sistema di preservare miglioramenti operativi oltre le singole sessioni.
Quali risultati di ricerca ha ottenuto Hyra 2.0?
I risultati iniziali di Hyra 2.0 coprono modelli scientifici, ricerca matematica, calcolo quantistico, robotica, analisi a singola cellula e ingegneria hardware.
Il repository ufficiale della ricerca contiene implementazioni selezionate, pesi, report e artifact di verifica. La panoramica seguente riassume i risultati riportati da Tencent; le sezioni successive spiegano le condizioni di test e la disponibilità. Si tratta di task scientifici diversi, non di una singola classifica dell’abilità generale dell’agente.
Output di ricerca
Scala tecnica o metrica
Risultato riportato
HyInv
1,96M di parametri
Generazione di sequenze proteiche 57× più veloce rispetto a ProteinMPNN
HyPLM-Flash
650M di parametri; 726B token di training
130,000 residui/s su un H20; qualità competitiva su 32 task
HyFF
Cinque modelli; 2,3M–1,2B parametri
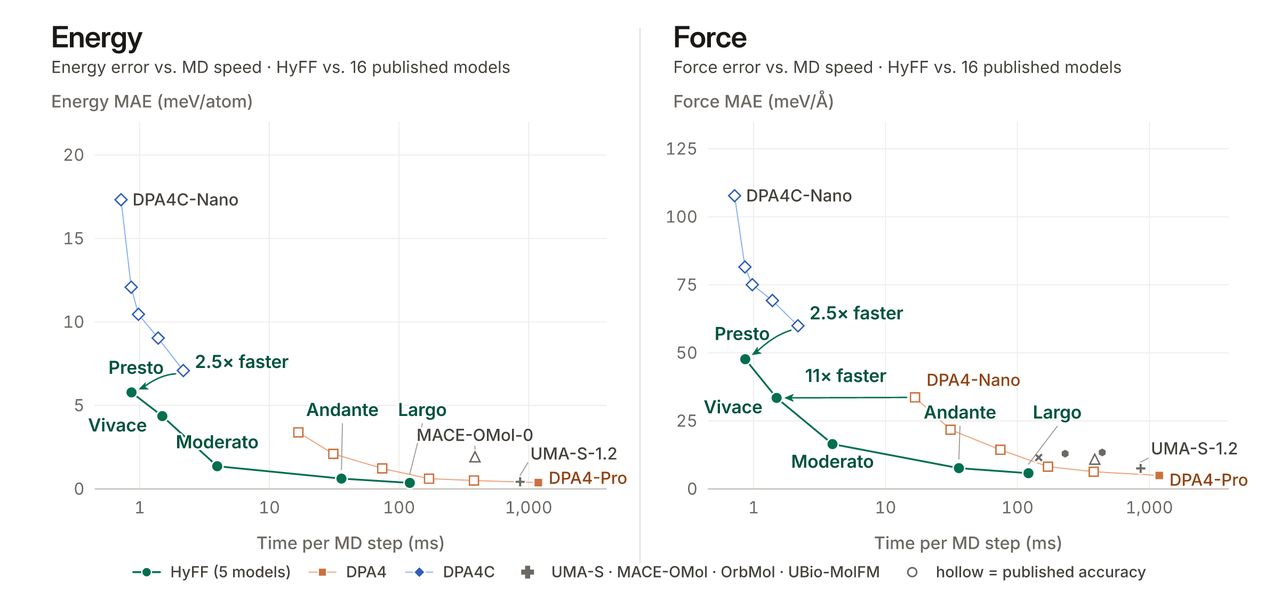
Frontiera Pareto accuratezza‑velocità contro 16 modelli pubblici
HyCell
16,1M di parametri; embedding a 512 dim.
Punteggio complessivo 0.735 su sette atlas cellulari held‑out
HyProver
Workflow di dimostrazione matematica
Risultati sulla congettura dell’insieme equilatero di Petty e sull’azione di cerchio di Yau
HyQEC
Codice quantistico [[488,123,22]]
Metrica di efficienza 122.0; circa il 48% sopra il precedente leader
Spiral Hand
Design robotico a cinque dita
Rotazione degli oggetti più veloce del 28,6% nella simulazione DR5
XiangShan RISC-V
Performance SPEC CPU2006
Punteggio per GHz superiore del 5,79% con aumento dell’area dello 0,3%
Questi risultati dimostrano molteplici tipi di output di ricerca, non un unico punteggio generale dell’agente.
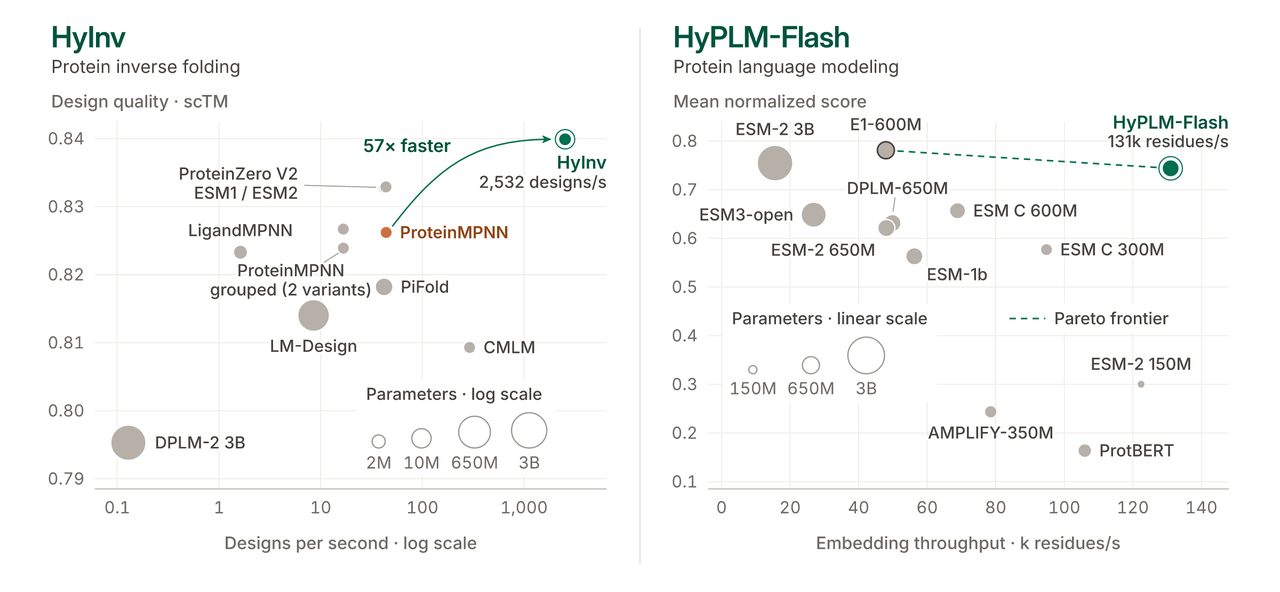
HyInv: inverse folding proteico 57× più veloce
HyInv genera sequenze proteiche per un backbone target. Il suo modello da 1,96M di parametri risulta, a quanto riferito, 57× più veloce di ProteinMPNN. I 50,6 ms riportati per 128 design usano un backbone da 402 residui, un H20 e BF16, escludendo compilazione e cattura CUDA graph. Trattalo come velocità di generazione a caldo; lo screening strutturale contribuisce ancora al ciclo di progettazione completo.
HyPLM-Flash: modellazione linguistica proteica ad alto throughput
HyPLM-Flash è un modello linguistico proteico da 650M di parametri addestrato su 726B token. Nella valutazione rilasciata con 28 checkpoint e 32 task, il suo punteggio su ProteinGym è stato statisticamente alla pari con encoder comparabili. L’inferenza INT8 raggiunge circa 130,000 residui/s su un H20; BF16 è preferibile quando piccole differenze di rappresentazione influenzano l’analisi a valle. La figura di lancio sottostante usa uno scope di valutazione diverso.
HyFF: simulazione molecolare più veloce con cinque dimensioni di modello
HyFF predice energie molecolari e forze atomiche, con cinque dimensioni di modello tra 2,3M e 1,2B parametri. Nel confronto OMol25 riportato, Andante combina un errore di forza simile a UMA-S-1.2 (7.65 contro 7.55 meV/Å) con una dinamica molecolare 29× più veloce. Largo riporta un errore di energia inferiore a DPA4-Pro (0.364 contro 0.380 meV/atom) e una velocità 9,7× maggiore. Scegli una dimensione testando sia accuratezza sia runtime sulle molecole che intendi simulare.
HyCell: un modello di embedding per singola cellula
HyCell mappa conteggi di espressione genica di cellule umane in embedding a 512 dimensioni con un modello da 16,1M parametri. Su sette atlas cellulari held‑out, il suo punteggio composito è 0.735, vicino a 0.736 di Stack. Quel punteggio combina conservazione biologica, correzione dei batch e trasferimento di annotazioni; non è una accuracy di classificazione. Verifica le metriche componenti rilevanti per il tuo studio.
HyProver: workflow riutilizzabili per la ricerca matematica
HyProver organizza il lavoro matematico in esplorazione, sviluppo della dimostrazione e revisione. I risultati riportati stabiliscono il caso in cinque dimensioni della congettura dell’insieme equilatero di Petty e forniscono un controesempio alla forma non ristretta della congettura dell’azione di cerchio di Yau. Questi risultati hanno confini specifici: la congettura di Petty non è risolta in ogni dimensione e la formulazione semplicemente connessa della congettura di Yau rimane aperta.
HyQEC: un miglioramento del 48% nell’efficienza del codice quantistico
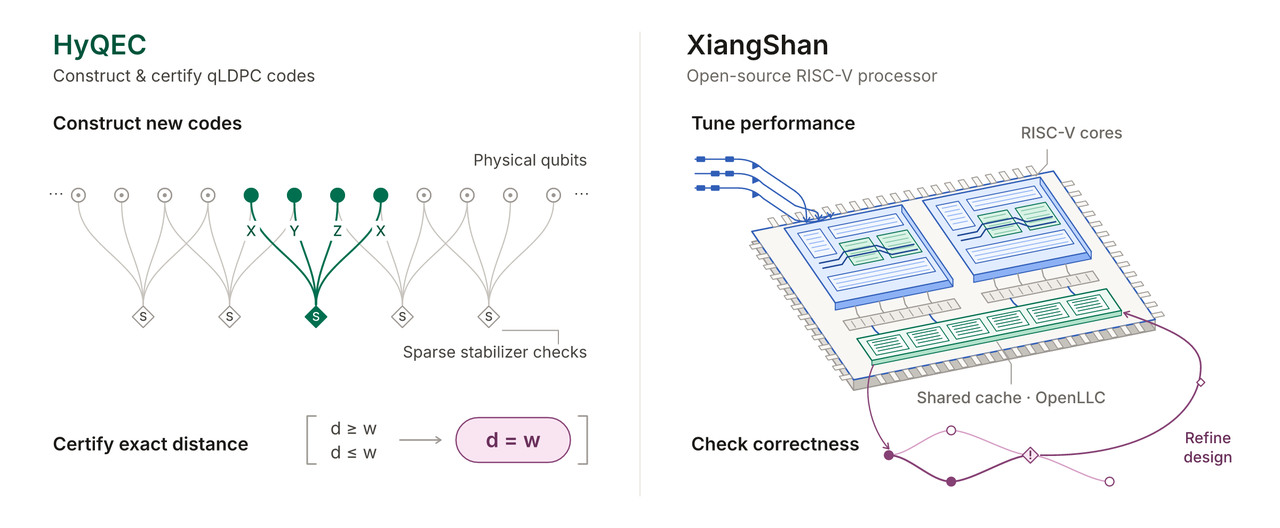
HyQEC cerca codici di correzione d’errore quantistici e ne controlla le distanze. Tencent riporta una costruzione [[488,123,22]] con una metrica di efficienza kd²/n pari a 122.0, circa il 48% sopra il precedente leader della challenge sotto i vincoli dichiarati. Questo misura l’efficienza del codice, non la performance dell’hardware quantistico. Verificato al 5 novembre 2026, il rilascio ufficiale include gli strumenti hyqec-verify e hyqec-check, ma indica ancora il file di codice e il certificato di questa specifica costruzione come evidenze da rilasciare. Strumenti pubblici ed evidenze pubblicamente riproducibili per un risultato specifico sono traguardi separati.
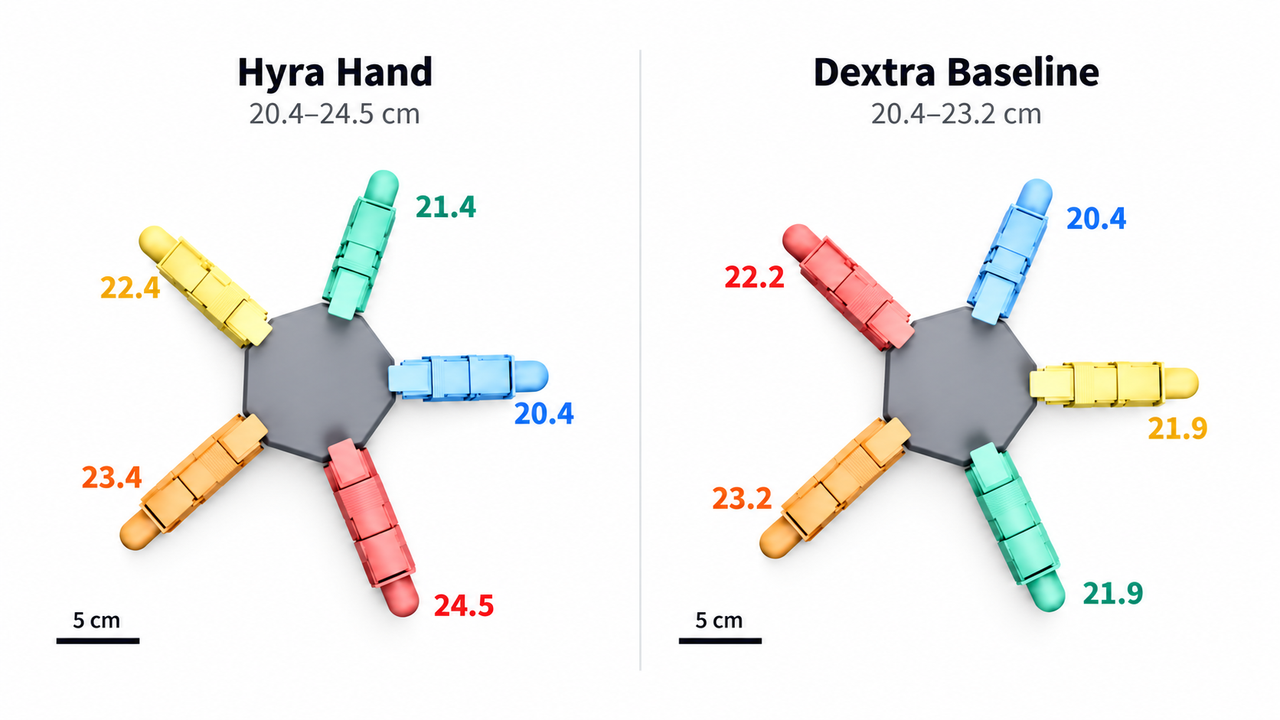
La Spiral Staircase Hand di Hyra utilizza dita progressivamente più lunghe attorno al palmo. Tencent riporta una rotazione degli oggetti più veloce del 28,6% e il 21% di target completati in più rispetto al baseline Dextra nella simulazione DR5 dopo budget di fine‑tuning della policy equivalenti. La validazione su hardware fisico resta in sospeso.
XiangShan: ottimizzazione del processore e verifica formale
Per il processore RISC‑V XiangShan, Tencent riporta un miglioramento del 5,79% nel punteggio SPEC CPU2006 per GHz, frequenza di core invariata e un aumento dell’area dello 0,3%. Il lavoro ha anche individuato dieci bug prima non riportati e un controesempio di coerenza della cache. Questi esiti si applicano al design e ai carichi valutati, non a tutti i sistemi RISC‑V.
Come dovrebbero interpretare i ricercatori i benchmark di Hyra 2.0?
Leggi ogni benchmark nel proprio workload. Confronta gli stessi input, hardware, precisione e confine di timing, quindi valuta qualità dell’output e runtime insieme. Per le affermazioni scientifiche, ispeziona codice, dati, dimostrazione o certificato di supporto: un risultato riportato e un risultato riprodotto in modo indipendente forniscono livelli di evidenza diversi.
Gli sviluppatori possono usare Hyra 2.0 tramite un’API?
Al 4 novembre 2026, i materiali pubblici su Hyra descrivono output di ricerca e rilasci selezionati. Non documentano un’API di orchestrazione Hyra 2.0 generalmente disponibile, un prezzo di abbonamento o un pacchetto di deployment completo. Un annuncio di ricerca e artifact scaricabili vanno quindi distinti dall’accesso ospitato al sistema completo.
I materiali pubblici disponibili si concentrano su risultati di ricerca e artifact selezionati. Gli sviluppatori possono accedere a determinati modelli creati con Hyra, inclusi HyInv, HyPLM-Flash, HyFF e HyCell, attraverso i repository di ricerca associati.
Il completo Hyra 2.0 Harness va distinto da quegli output scaricabili.
Hyra 2.0 e API Hunyuan ospitate
Gli sviluppatori possono accedere a Tencent Hy4 tramite CometAPI usando l’ID modello hy4. Questo fornisce inferenza di modelli ospitati per applicazioni come coding, analisi e workflow di agenti. Non fornisce il completo Harness di ricerca Hyra 2.0; i modelli scientifici sviluppati tramite Hyra sono disponibili separatamente tramite i repository di ricerca di Tencent.
Cosa renderebbe utile Hyra 2.0 in un team di ricerca?
Inizia con un artifact rilasciato e un piccolo workload di riferimento. Una volta che funziona, testa dati locali rappresentativi con una soglia di qualità fissata e un budget di calcolo definito. Mantieni insieme revisione del repository, pesi, ambiente, input e output affinché i colleghi possano riprodurre il risultato. Aggiungi coordinamento multi‑agente persistente quando attese lunghe, esperimenti dipendenti o ipotesi concorrenti lo rendono utile.
Conclusione
Hyra 2.0 porta pianificazione della ricerca, esecuzione degli esperimenti e conoscenza riutilizzabile in un unico workflow persistente. I suoi output scientifici sono punti di partenza promettenti per lavori successivi. Per un team di ricerca, il test pratico è se un artifact rilasciato migliora un esperimento reale e produce evidenze che altri possono ispezionare e riprodurre.
FAQ
Come dovrebbe un laboratorio pianificare il budget per la sua prima prova con un artefatto di Hyra?
Metti a budget tre fasi: configurare un ambiente riproducibile, eseguire un piccolo caso di riferimento e valutare un workload locale rappresentativo. Includi tempo di preparazione e revisione oltre all’uso degli acceleratori. Scegli un criterio di accettazione prima di iniziare, ad esempio mantenere un livello di qualità richiesto riducendo il tempo di consegna. Una prova iniziale dovrebbe essere abbastanza piccola da diagnosticare i fallimenti senza impegnare le risorse richieste per una campagna di ricerca completa.
Cosa dovrebbe contenere un pacchetto di riproducibilità?
Tieni insieme revisione del repository, identificativi dei pesi del modello, versioni dell’ambiente, provenienza dei dati di input, configurazione, semi casuali quando rilevanti e output di valutazione. Registra eventuali modifiche all’esempio pubblicato. Quando un risultato si basa su una dimostrazione o un certificato, conserva anche la versione del checker e il suo output. Il pacchetto dovrebbe permettere a un altro ricercatore di distinguere un problema software, un input cambiato e una reale differenza nel risultato scientifico.
Come possono i ricercatori evitare la contaminazione dei benchmark?
Separa i dati usati per scegliere modelli o regolare impostazioni dai dati usati per la valutazione finale. Congela il protocollo finale prima di confrontare i candidati e documenta qualsiasi sovrapposizione con dati di pre‑training o sviluppo che possa essere stabilita. Per nuovi dataset scientifici, usa split che riflettano l’impostazione di deployment prevista, come uno studio tenuto da parte o una condizione sperimentale. Un punteggio forte è meno informativo se gli esempi di valutazione hanno ripetutamente plasmato il sistema testato.
Come dovrebbero i team gestire conclusioni contrastanti tra agenti?
Confronta gli esperimenti sottostanti piuttosto che combinare le conclusioni per voto di maggioranza. Verifica se gli agenti hanno usato la stessa versione del dataset, le stesse assunzioni, metriche e configurazione software. Conserva entrambi i risultati finché la differenza non è spiegata, poi esegui un esperimento mirato che discrimini tra le spiegazioni concorrenti. L’accordo tra agenti è utile, ma non sostituisce misure esterne o un argomento verificabile.
Quando è preferibile un workflow di ricerca più semplice?
Un task breve, deterministico, con uno script maturo e un valutatore chiaro può non beneficiare del coordinamento multi‑agente persistente. L’aggiunta di scheduling, tenuta dei registri e revisione può costare più di quanto faccia risparmiare. Introduci l’orchestrazione quando gli esperimenti hanno dipendenze significative, attese lunghe, ipotesi concorrenti o output riutilizzabili che richiedono manutenzione continua. La decisione dovrebbe seguire la struttura del workload e il costo di coordinamento osservato.